Stand-In - 腾讯微信视觉开源的轻量级视频生成框架Stand-In 是腾讯微信视觉团队推出的轻量级、即插即用的身份保留视频生成框架。专注于在视频生成中保留特定身份特征,仅需训练基础模型1%的额外参数,能在人脸相似度和自然度方面取得优异效果。最新AI资源1年前090.9K
PixVerse V6 - 爱诗科技推出的最新一代AI视频生成模型PixVerse V6是爱诗科技推出的最新一代AI视频生成模型。在保持秒级生成速度的同时,重点优化了人物真实感、复杂运动表现、物理模拟及声画协同能力,支持最长15秒1080P视频生成。最新AI资源7个月前090.9K
HunyuanImage 3.0 - 腾讯开源的免费多模态图像生成模型HunyuanImage 3.0(混元图像3.0)是腾讯发布并开源的原生多模态图像生成模型。模型参数规模达80B,是目前测评效果最好、参数量最大的开源生图模型。混元图像3.0支持实时生图功能,用户可边...最新AI资源1年前090.8K
Cloudflare Serverless Registry:基于Cloudflare Workers的无服务器容器注册表综合介绍 Cloudflare Serverless Registry 是一个基于 Cloudflare Workers 和 R2 存储的无服务器容器注册表。它支持镜像的推送和拉取,并提供用户名密码和...最新AI资源# AI开源项目2年前090.7K
Midjourney V1- Midjourney推出的首个图生视频模型Midjourney V1 是Midjourney公司推出的首个 AI 视频生成模型,借助先进的AI技术,支持将静态图片转化为生动的动态视频。用户只需上传图片或用 Midjourney 生成的图像,点...最新AI资源1年前090.7K
GLM-ASR - 智谱AI开源的高性能语音识别模型系列GLM-ASR是智谱AI开源的高性能语音识别模型系列,包含云端模型GLM-ASR-2512和开源端侧模型GLM-ASR-Nano-2512。GLM-ASR-2512是全球领先的云端语音识别模型,支持多...最新AI资源11个月前090.5K
全球首个量子 AI 模型问世!SECQAI 发布 QLLM 即将进入 Beta 测试英国超安全软硬件公司 SECQAI 宣布推出全球首个量子大语言模型 (QLLM),将量子计算技术整合至传统 AI 模型中,以提升运算效率和问题解决能力。 量子力学 + AI = 更强大的 AI? ...最新AI资源2年前090.3K
MobiAgent - 上海交大开源的移动端智能体全栈构建框架MobiAgent 是上海交通大学 IPADS 实验室开源的移动端智能体工具链,帮助用户构建专属的手机智能助手。通过记录用户操作轨迹并生成高质量数据,训练出能理解自然语言指令的智能体。核心特点包括高效...最新AI资源1年前090.3K
EmbodiChain - 跨维智能推出的开源具身智能开发平台EmbodiChain是跨维智能推出的开源具身智能开发平台,专注于解决具身智能模型训练中数据稀缺的问题。通过数据引擎实现大规模场景相关数据生成、Real2Sim 数据轨迹映射和多模态数据扩增,从根本上...最新AI资源9个月前090.2K
Paperclip - 开源的AI Agent编排平台,管理和协调多个AI智能体Paperclip是开源的AI代理编排平台,定位为“零人工公司操作系统”,用于管理和协调多个AI代理(如OpenClaw、Claude Code等)协同工作。提供组织架构、目标对齐、预算控制、任务追踪...最新AI资源8个月前090.2K
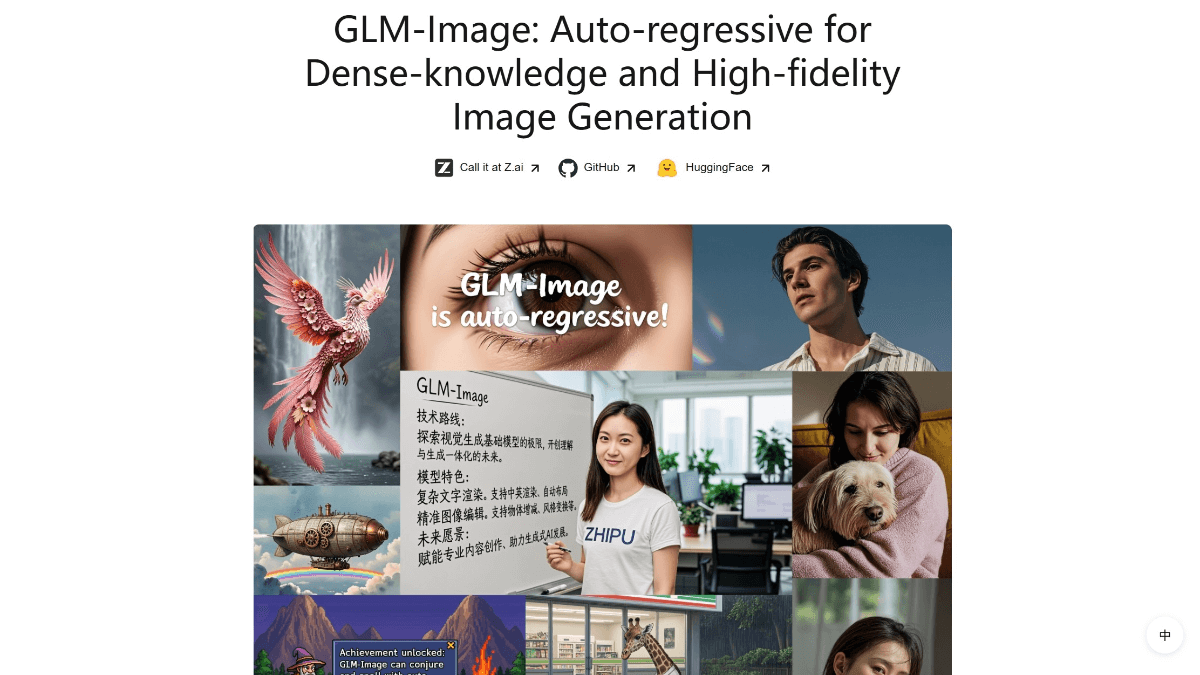
GLM-Image - 智谱联合华为开源的多模态图像生成模型GLM-Image是智谱与华为联合开源的多模态图像生成模型,基于昇腾Atlas 800T A2芯片和昇思MindSpore框架训练,采用创新的"自回归+扩散解码器"混合架构。核心突破在于实现了国产芯片...最新AI资源10个月前090.1K
CWM - Meta FAIR开源的代码世界语言模型CWM(Code World Model)是Meta FAIR团队发布的一款320亿参数的开源代码世界语言模型,专为代码生成和推理设计。引入“世界模型”概念,能模拟代码执行过程,预测变量状态变化,提前...最新AI资源1年前090.1K
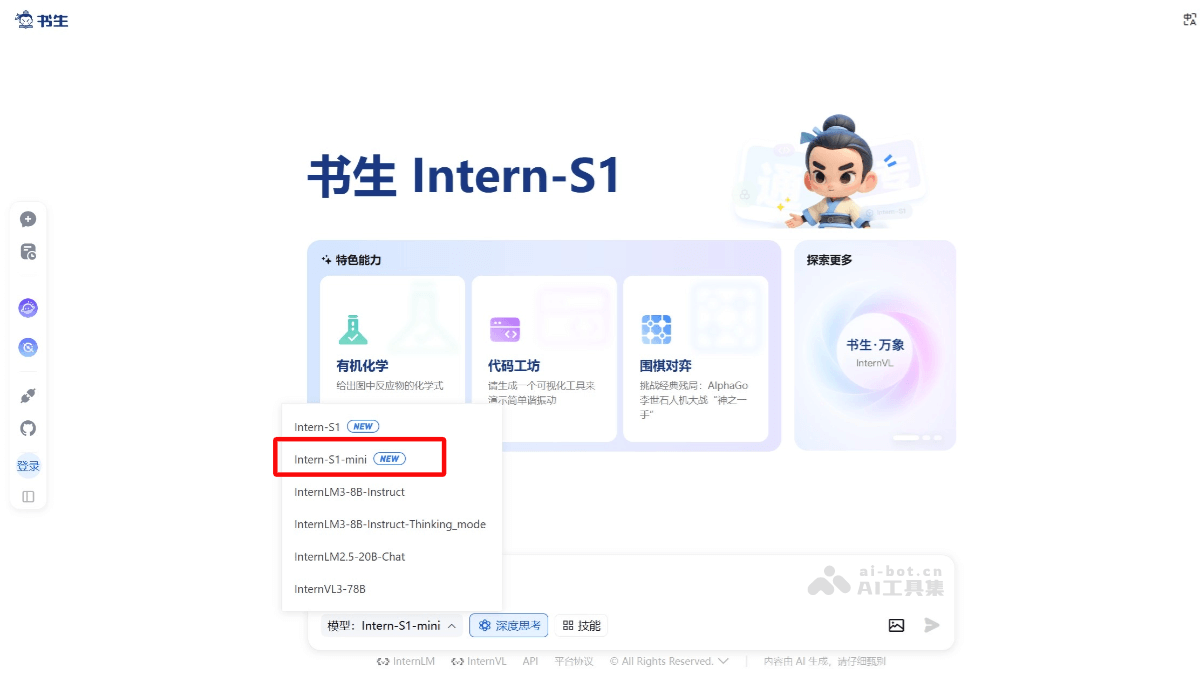
Intern-S1-mini - 上海AI Lab开源的轻量化科学多模态模型Intern-S1-mini 是上海人工智能实验室推出的轻量化科学多模态大模型,参数规模为 8B。继承了 Intern-S1 的强大能力,兼具通用与专业科学能力,适合快速部署和二次开发。在性能方面,I...最新AI资源1年前090K
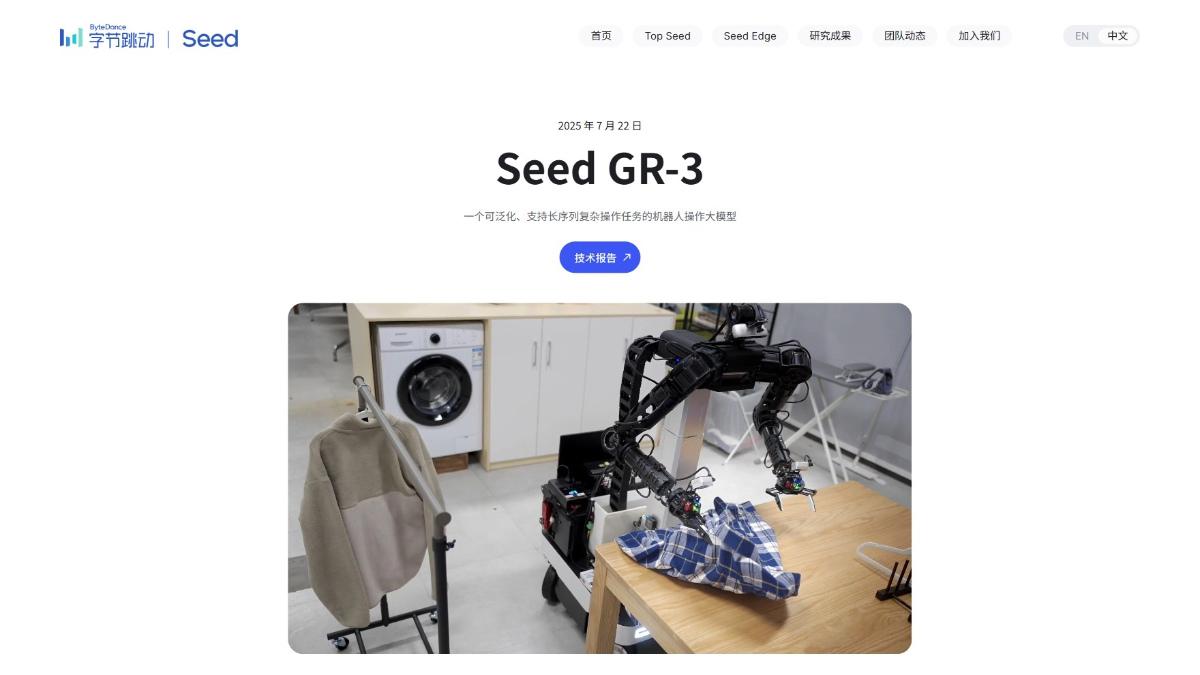
Seed GR-3 - 字节跳动Seed团队推出的通用机器人模型Seed GR-3 是字节跳动推出的通用机器人模型,具有强大的泛化能力,能适应新环境和复杂指令。模型融合视觉、语言和动作信息,基于机器人数据、VR 人类轨迹数据和公开图文数据的三合一训练法,提升对新物...最新AI资源1年前090K
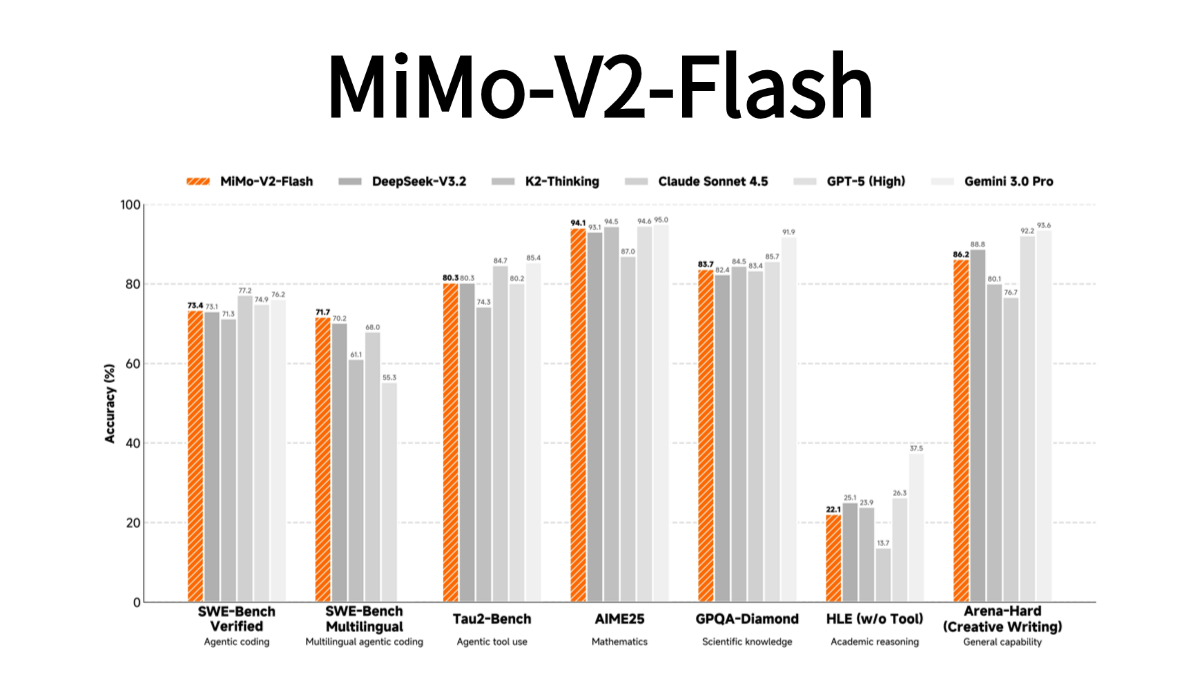
MiMo-V2-Flash - 小米发布的开源MoE架构大模型MiMo-V2-Flash是小米发布的开源MoE架构大模型,总参数3090亿,活跃参数150亿,主打高效推理和智能体应用。模型采用混合注意力架构与多词元预测技术,推理速度达150 tokens/秒,成...最新AI资源11个月前090K
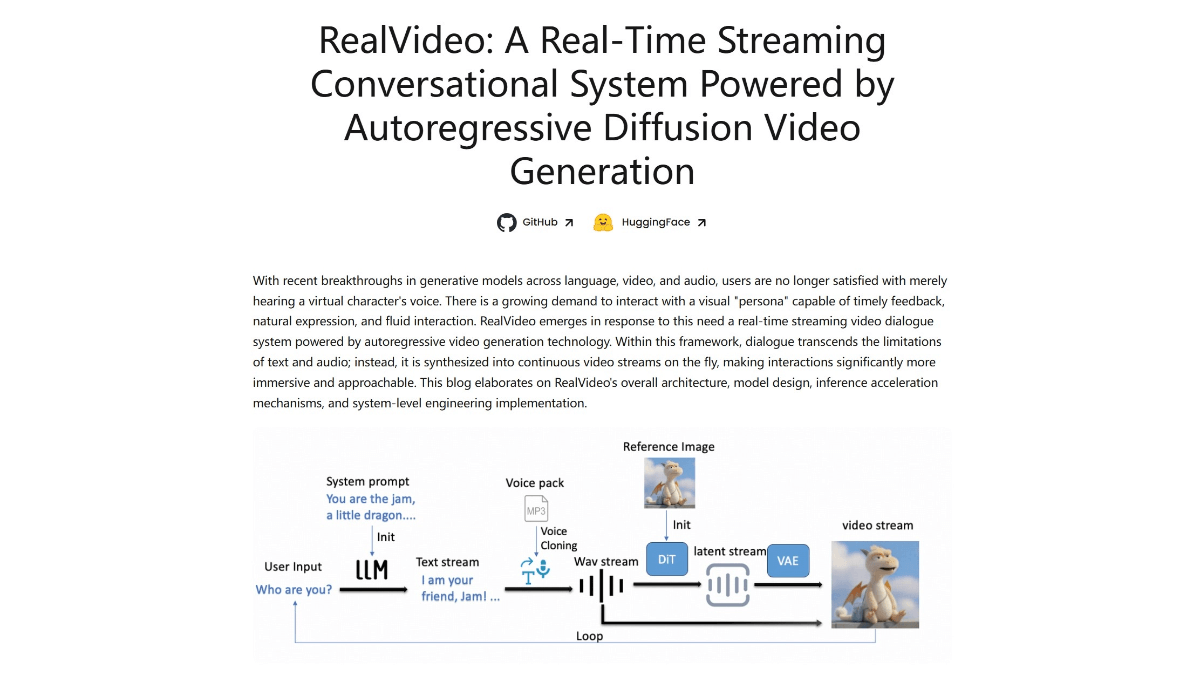
RealVideo - 智谱 AI 开源的实时流式视频生成系统RealVideo 是智谱 AI 开源的实时流式视频生成系统,能在 2 至 3 秒内快速生成自然流畅的视频回应。用户只需上传一张照片并输入文字,系统能生成对应的语音和视频,实现与 AI 角色的实时对话...最新AI资源11个月前089.9K
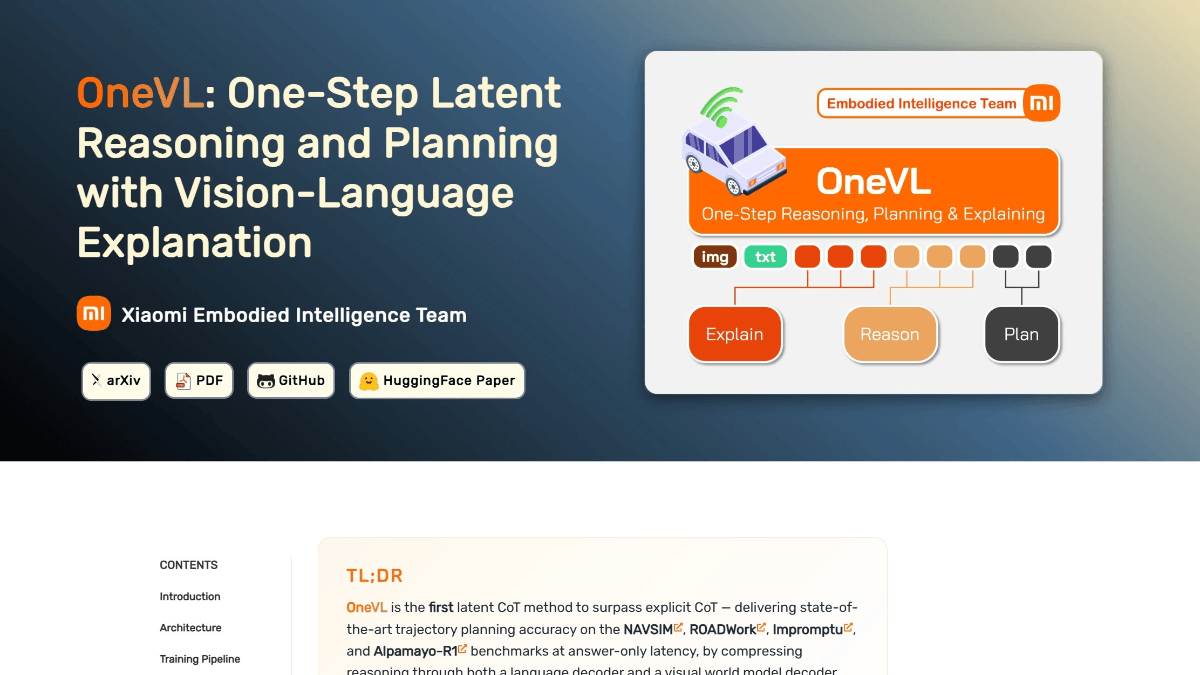
Xiaomi OneVL - 小米技术开源的一步式潜空间语言视觉推理框架Xiaomi OneVL 是小米技术团队发布并全面开源的一步式潜空间语言视觉推理框架,专为自动驾驶场景设计。框架在业内首次将VLA(视觉-语言-动作)模型、世界模型与潜空间推理三大技术路线统一到单一架...最新AI资源6个月前089.9K
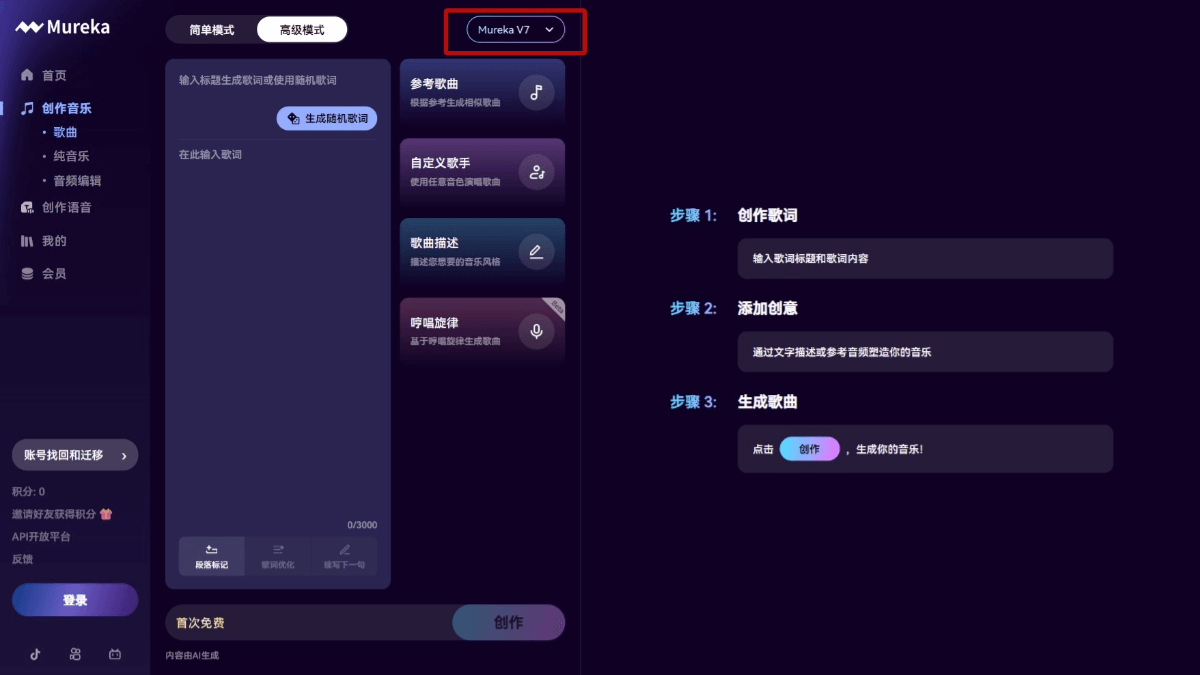
Mureka V7 - 昆仑万维推出的AI音乐生成模型Mureka V7 是昆仑万维推出的先进 AI 音乐生成模型。模型基于 MusiCoT 技术,支持先规划音乐的整体结构,再填充细节,生成更具连贯性和艺术性的音乐作品。最新AI资源1年前089.8K
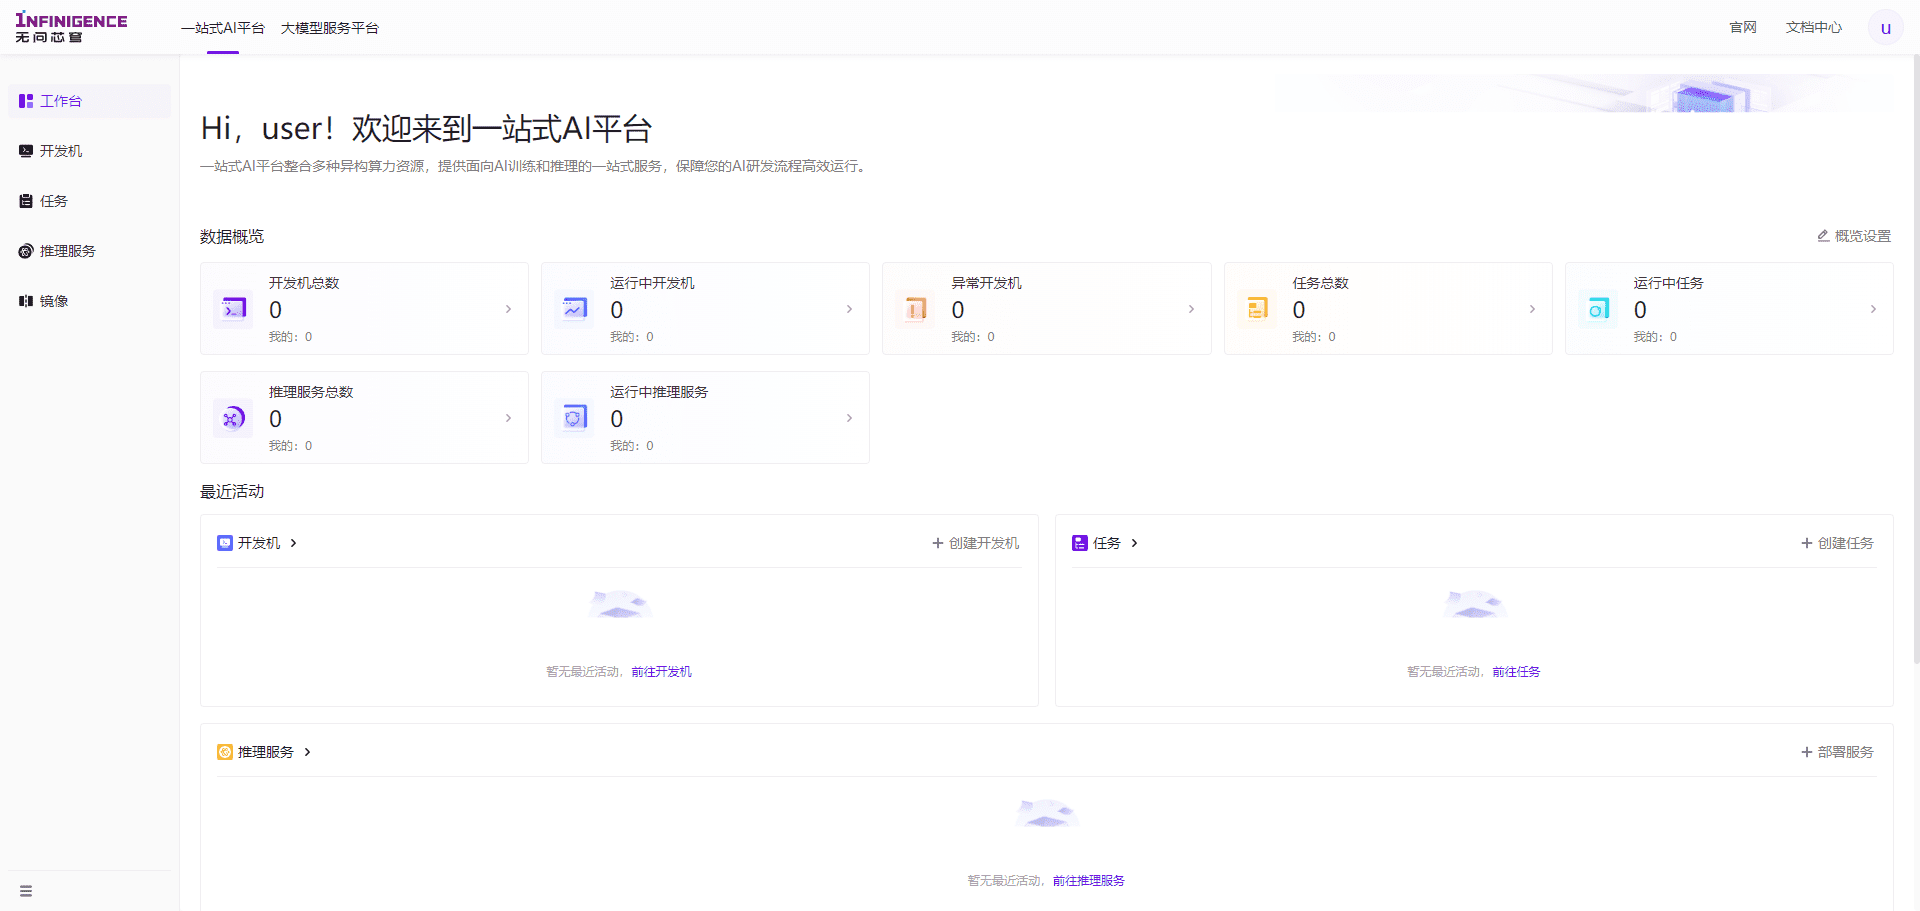
无问芯穹:企业级AI开发,云端资源服务平台综合介绍 无问芯穹是一个面向AI开发者的综合服务平台,提供能力强大的AI开发工具与大模型服务。该平台具有AIStudio, GenStudio等多种机器学习开发工具,同时还支持模型部署、数据存储和模型...最新AI资源# AI开放服务2年前089.8K
AudioFly - 科大讯飞开源的文本生成音效AI模型AudioFly是科大讯飞开源的文本生成音效的AI模型。基于潜在扩散模型架构,拥有10亿个参数,经过大规模、多样化的音频文本数据集训练,涵盖AudioSet、AudioCaps、TUT等公开数据集及内...最新AI资源1年前089.8K
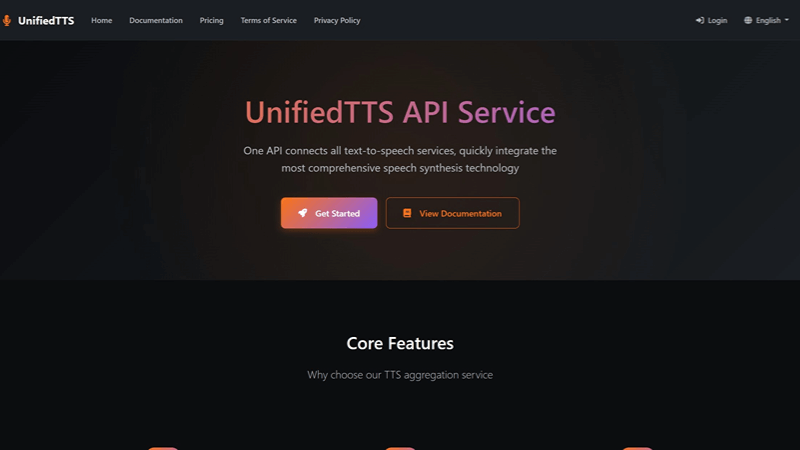
UnifiedTTS - 一站式TTS API服务平台,实时性能监控UnifiedTTS 是一站式文本转语音(TTS)服务的平台。支持多种语言,包括中文、英文、日文和韩文等,能满足全球业务的需求。通过统一的 API 接口,整合多种主流的 TTS 服务,包括 Micro...最新AI资源1年前089.8K
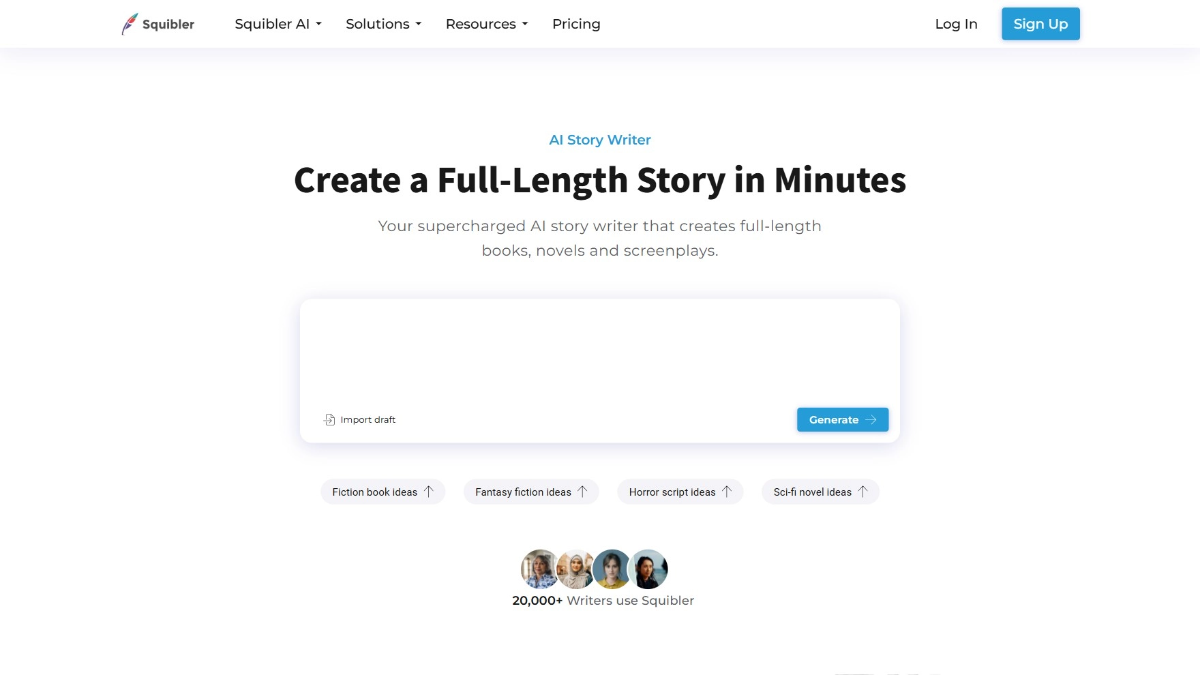
Squibler - AI小说辅助写作平台,助力构思到创作全过程Squibler 是强大的 AI 辅助写作平台,专为作家设计,能帮助用户从构思到创作再到出版的全过程。平台提供多种故事模板,涵盖小说、剧本、短篇故事等,用户只需输入初始概念,AI 能生成大纲、角色、场...最新AI资源1年前089.8K
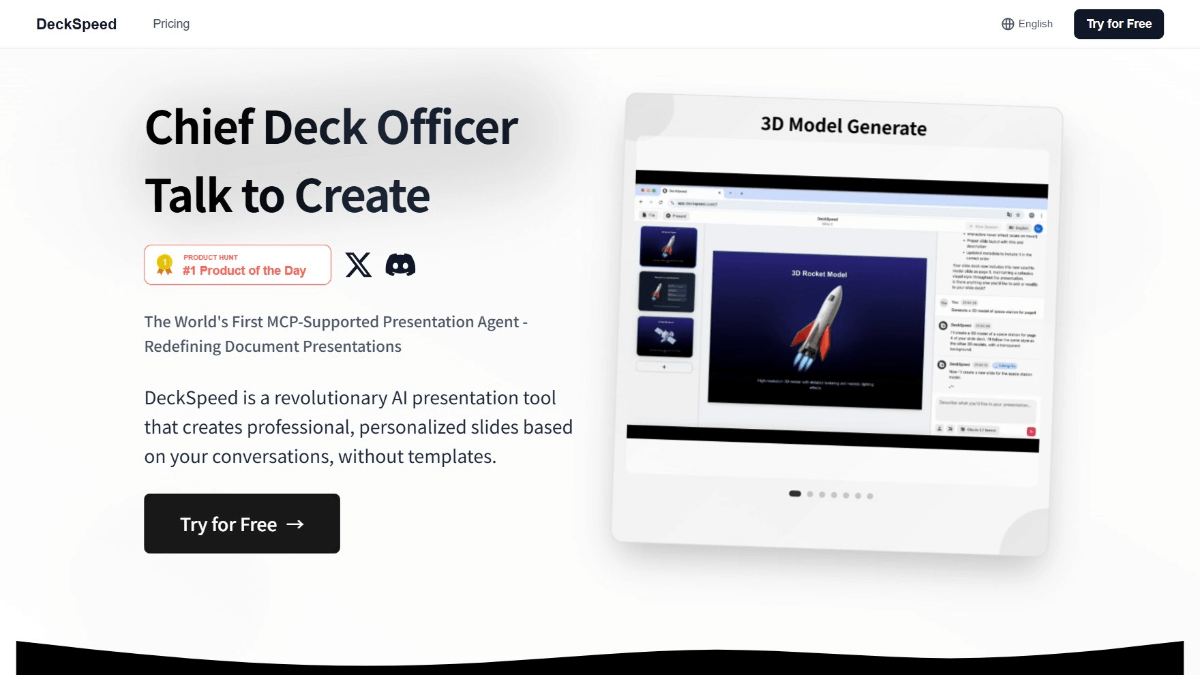
DeckSpeed - AI PPT制作工具,自然语言生成演示文稿DeckSpeed是AI演示文稿制作工具,基于对话式交互,用户基于自然语言表达需求,快速生成个性化幻灯片,无需依赖传统模板。工具支持实时反馈调整,用户能随时修改幻灯片的颜色、风格和内容,确保演示文稿完...最新AI资源1年前089.8K
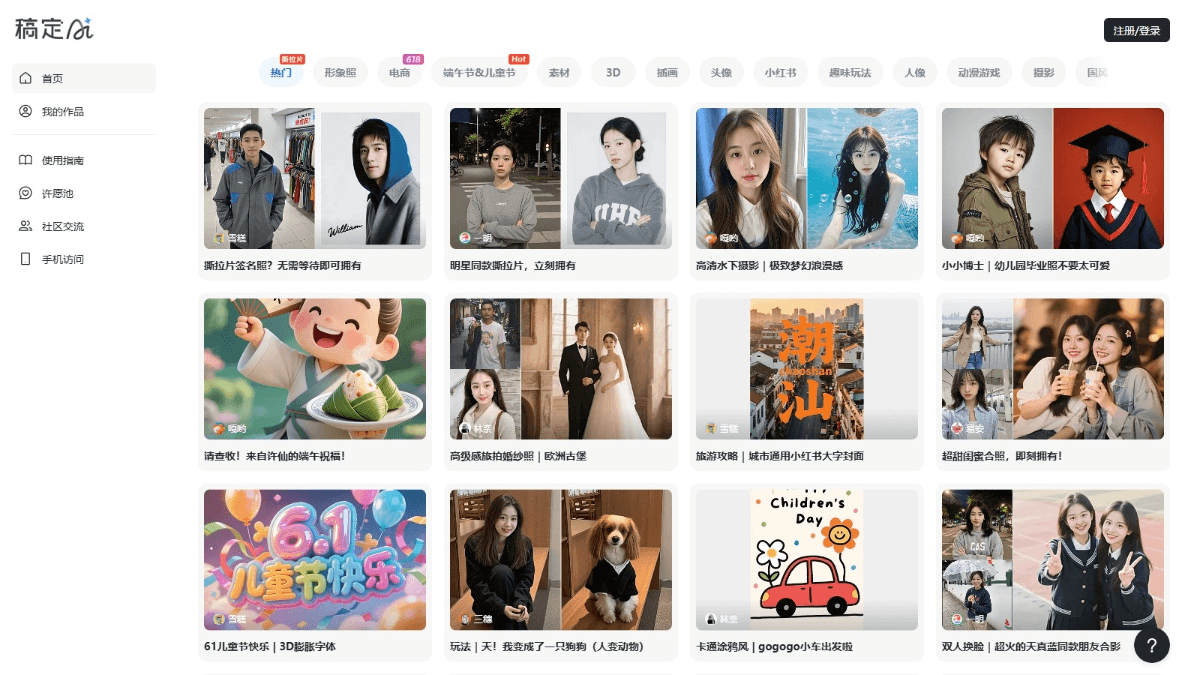
稿定AI社区 - AI创意内容设计平台,多种设计资源满足不同创作需求稿定AI社区是在线AI创意灵感平台,为用户提供丰富的创意设计资源和工具。平台涵盖多种设计领域,包括形象照、电商设计、节日主题、3D插画、头像设计、小红书素材、人像设计等,满足不同用户的需求。最新AI资源1年前089.7K
openPangu-VL-7B - 华为开源的7B参数多模态模型openPangu-VL-7B是华为开源的7B参数规模的多模态模型,专为昇腾端侧设备优化设计。模型在视觉定位、OCR识别、文档理解等任务中表现出色,支持实时推理(5FPS),单卡延迟仅160毫秒。最新AI资源10个月前089.7K
VoiceSculptor - 西北工业大学联合语图智能开源的音色设计模型VoiceSculptor 是西北工业大学联合多家机构开源的音色设计模型,基于 LLaSA-3B 和 CosyVoice2 开发,专注于通过自然语言指令生成多样化音色的语音合成。支持对语速、音量、基频...最新AI资源10个月前089.7K
Wan-Move - 阿里通义联合清华等开源的AI视频生成框架Wan-Move是阿里通义实验室、清华大学等机构联合开发的开源AI视频生成框架,专注于通过精准运动控制技术实现高质量视频合成。核心技术是"潜在轨迹引导",能在现有图像到视频模型基础上无缝添加点级运动控...最新AI资源11个月前089.7K
问小白o4 - 问小白推出的并行思考模型,同时开启8条思考路径问小白o4是创新的并行思考模型,能同时开启8条思考路径,从多角度分析问题并自动筛选出最优解。模型融合先进的Long-CoT强化学习和过程奖励学习技术,具备强大的深度推理能力,且在复杂任务中表现出色。最新AI资源1年前089.7K
AnimaTensor - 吐司AI等机构推出的二次元图像生成模型AnimaTensor 是 CagliostroLab 团队与 TensorArt 联合推出的二次元图像生成模型,基于创新的 V-Prediction 技术,用预测图像生成过程中的“速度”优化噪声调度...最新AI资源1年前089.6K
VLAC - 上海AI Lab开源的具身奖励大模型VLAC是上海人工智能实验室开源的具身奖励大模型。以InternVL多模态大模型为基础,融合互联网视频数据和机器人操作数据,为机器人在真实世界中的强化学习提供过程奖励和任务完成情况估计。VLAC能有效...最新AI资源1年前089.5K
LongCat-Video - 美团LongCat开源的视频生成模型LongCat-Video是美团LongCat团队开源的13.6亿参数视频生成模型,采用MIT开源协议,支持文生视频、图生视频和视频续写三大任务。模型通过"粗到细"生成策略和块稀疏注意力机制,能在数分...最新AI资源1年前089.4K
MiroFish - 开源的AI预测引擎,智能体进行自由交互与社会演化MiroFish是中科大20岁学生BaiFu开源的AI预测引擎,基于多智能体技术,能从新闻、小说等种子信息自动构建高保真平行数字世界。最新AI资源8个月前089.4K
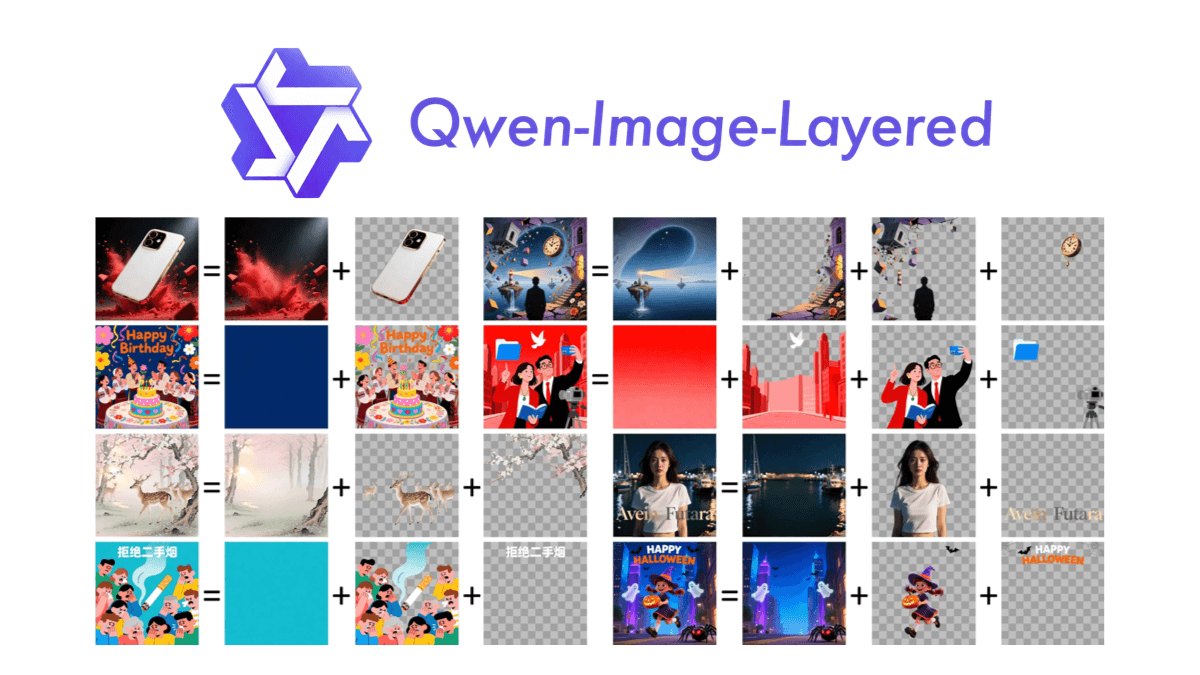
Qwen-Image-Layered - 阿里团队开源的AI图像编辑模型Qwen-Image-Layered是阿里团队开源的AI图像编辑模型,能将普通图片智能分解为独立的透明图层,实现类似Photoshop的精准编辑。模型采用Apache 2.0协议开源,支持灵活控制图层...最新AI资源11个月前089.3K
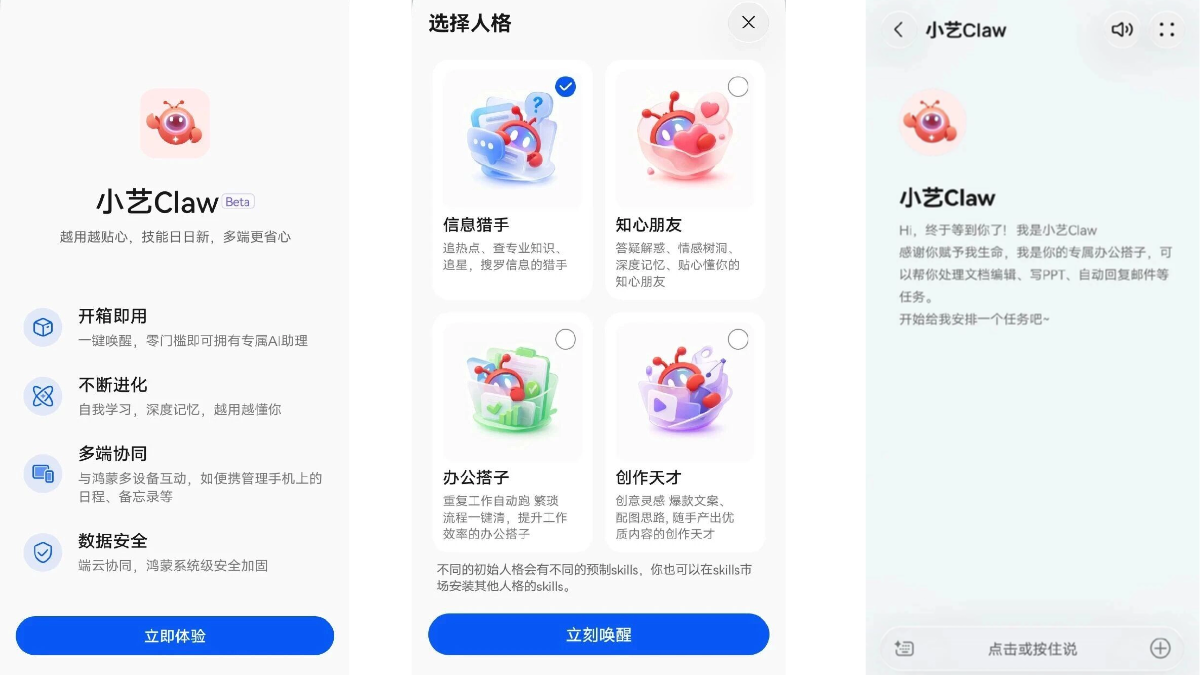
小艺Claw - 华为推出的个人手机AI助理,一键接入OpenClaw小艺Claw是华为基于OpenClaw开源框架推出的AI智能体,集成于小艺App中。小艺Claw打破传统语音助手"被动应答"的交互逻辑,具备自主规划与任务执行能力,可独立完成办公文档处理、信息检索、服...最新AI资源8个月前089.3K
FireRedChat - 小红书开源的全双工语音交互系统FireRedChat 是小红书开源的全双工语音交互系统,具有实时双向对话能力,支持可控打断功能。采用模块化设计,包括转录控制模块、交互模块和对话管理器等,支持级联和半级联架构,可灵活部署。最新AI资源1年前089.2K
Ovis-U1 - 阿里推出的多模态统一AI模型Ovis-U1是阿里巴巴集团Ovis团队推出的多模态统一模型,参数规模达到30亿。模型具备多模态理解、文本到图像生成以及图像编辑等三大核心能力,凭借先进的架构设计和协同统一训练方法,支持实现高保真图像...最新AI资源1年前089.1K
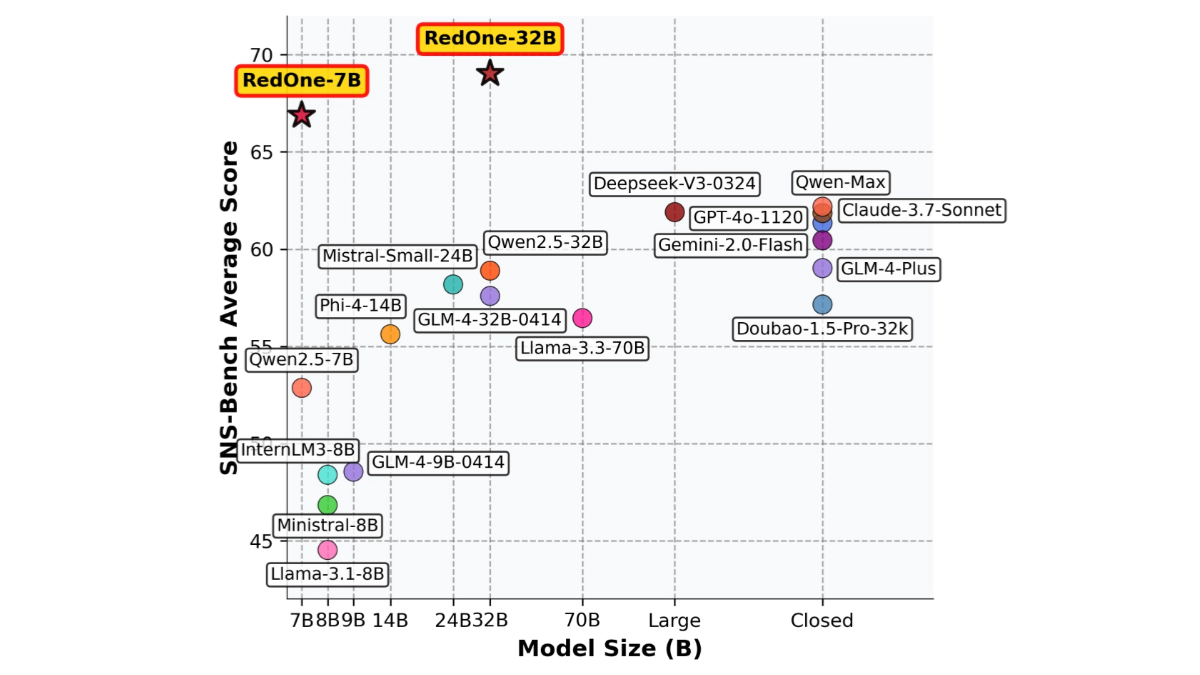
RedOne - 小红书最新推出的社交大模型RedOne 是小红书推出的专为社交网络定制的大语言模型。模型通过三阶段训练策略,融入社交文化知识,强化多任务能力,并对齐人类偏好。RedOne 在社交任务性能上显著优于基础模型,在有害内容检测和浏览...最新AI资源1年前089K
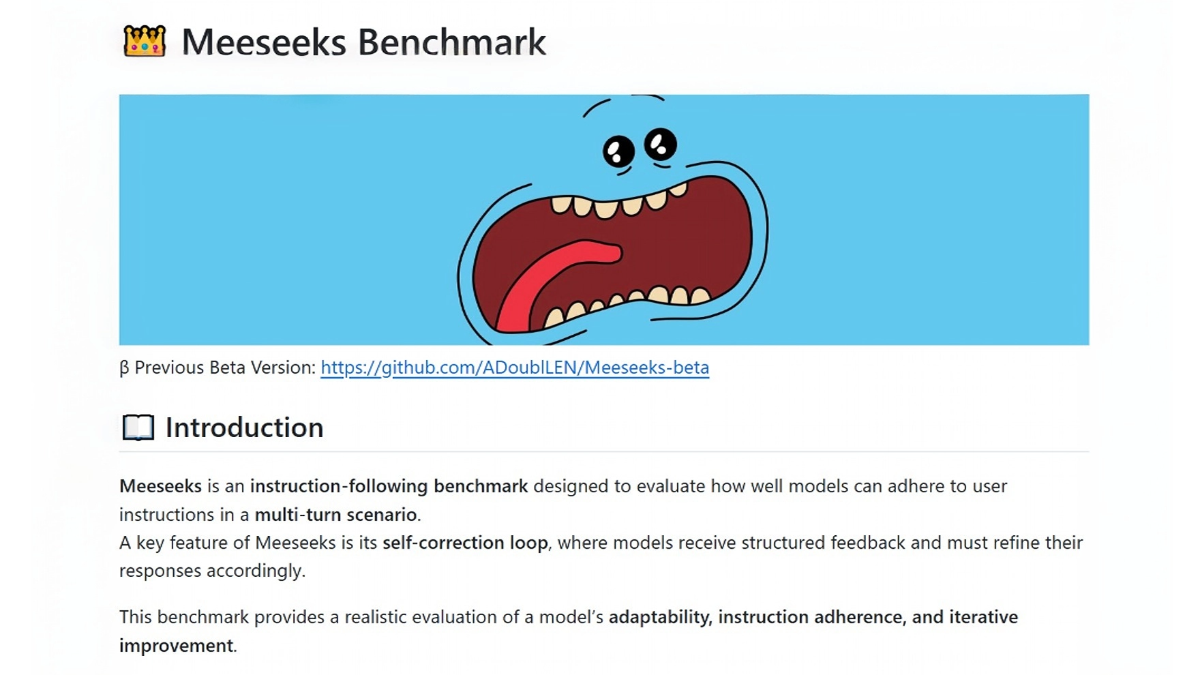
Meeseeks - 美团开源的评估模型指令遵循能力的评测集Meeseeks 是美团 M17 团队开源的大模型评测集,用在评估模型的指令遵循能力。Meeseeks 通过三级评测框架,从宏观到微观全面衡量模型是否能严格按照用户指令生成回答,不评估回答内容的知识正...最新AI资源1年前088.9K
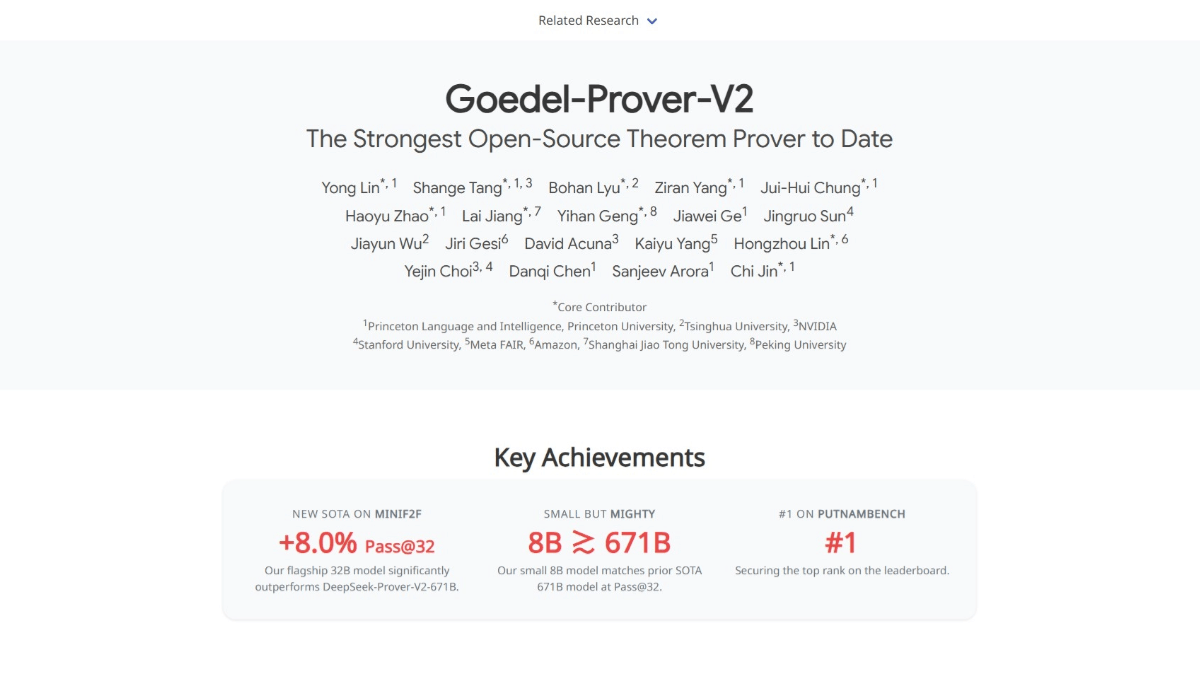
Goedel-Prover-V2 - 普林斯顿联合清华和英伟达等开源的定理证明模型Goedel-Prover-V2 是普林斯顿大学、清华大学和英伟达等顶尖机构联合推出的开源定理证明模型。模型基于创新技术如分层式数据合成、验证器引导的自我修正和模型平均等,显著提升自动形式化证明的性能...最新AI资源1年前088.9K
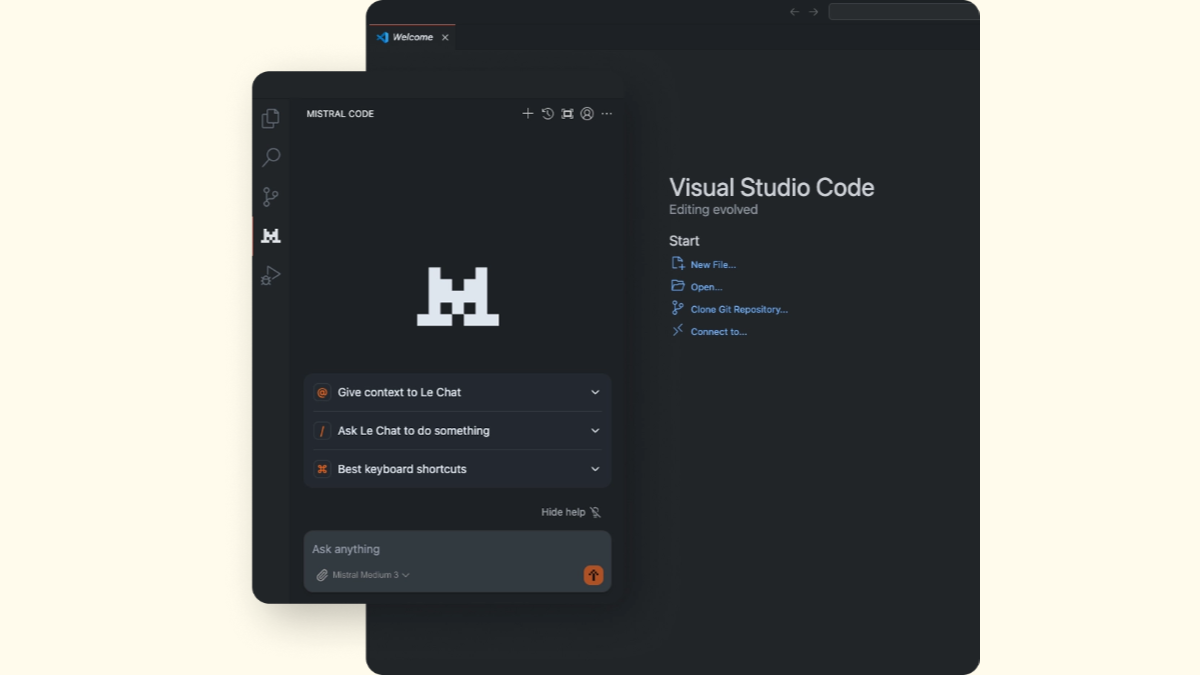
Mistral Code - Mistral AI推出面向企业的AI编程助手Mistral Code是Mistral AI推出的面向企业开发团队的AI编程助手,集成Codestral、Codestral Embed、Devstral 和Mistral Medium四大模型,支...最新AI资源1年前088.8K
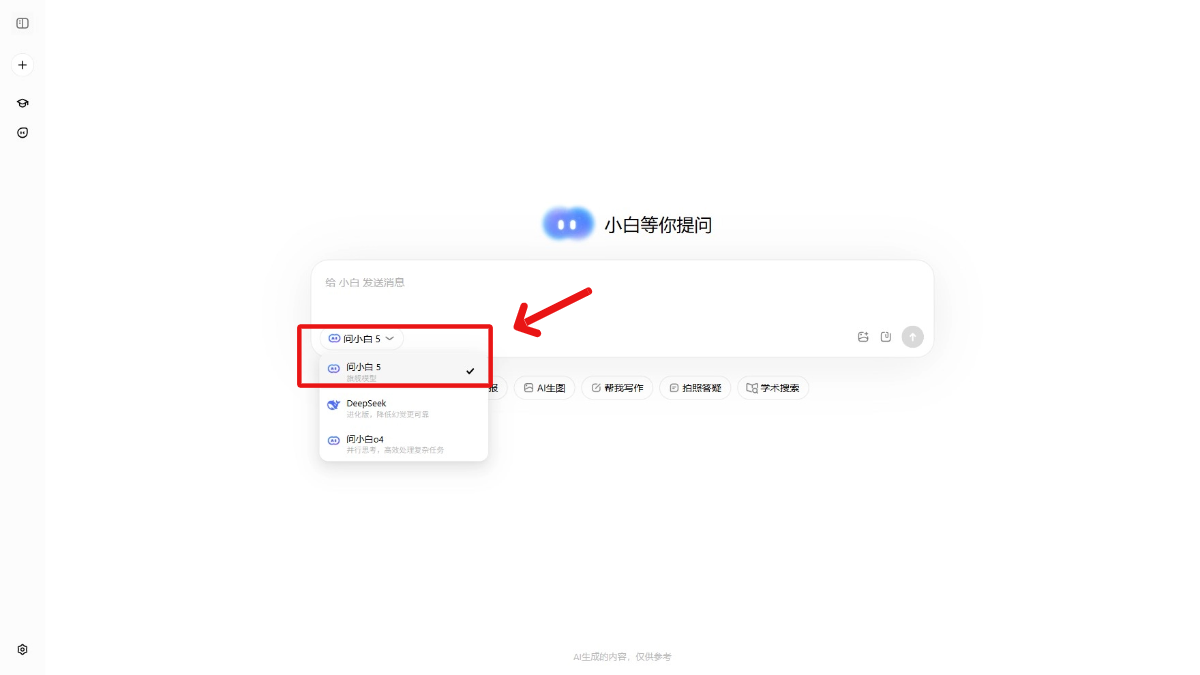
问小白5 - 问小白推出的全能AI模型问小白5是“All in One”旗舰大模型,智能水平极高。模型在多项评测中表现卓越,如AA - Index综合评估得分64.7分,STEM能力评测86分,接近全球领先的GPT - 5。最新AI资源1年前088.7K
MiniCPM 4.1 - 面壁智能推出的超高效端侧大模型MiniCPM 4.1 是面壁智能推出的超高效端侧大语言模型。采用 InfLLM v2 稀疏注意力架构,每个词元仅需计算与少于 5% 词元的相关性,显著降低长文本处理开销。在 128K 长文本场景下...最新AI资源1年前088.7K
MOVA - 创智学院联合模思智能开源的端到端音视频生成模型MOVA(MOSS-Video-and-Audio) 是上海创智学院 OpenMOSS 团队联合模思智能(MOSI)开源的端到端音视频生成模型,是中国首个高性能开源音视频模型。突破了传统"先画面后配音...最新AI资源9个月前088.7K
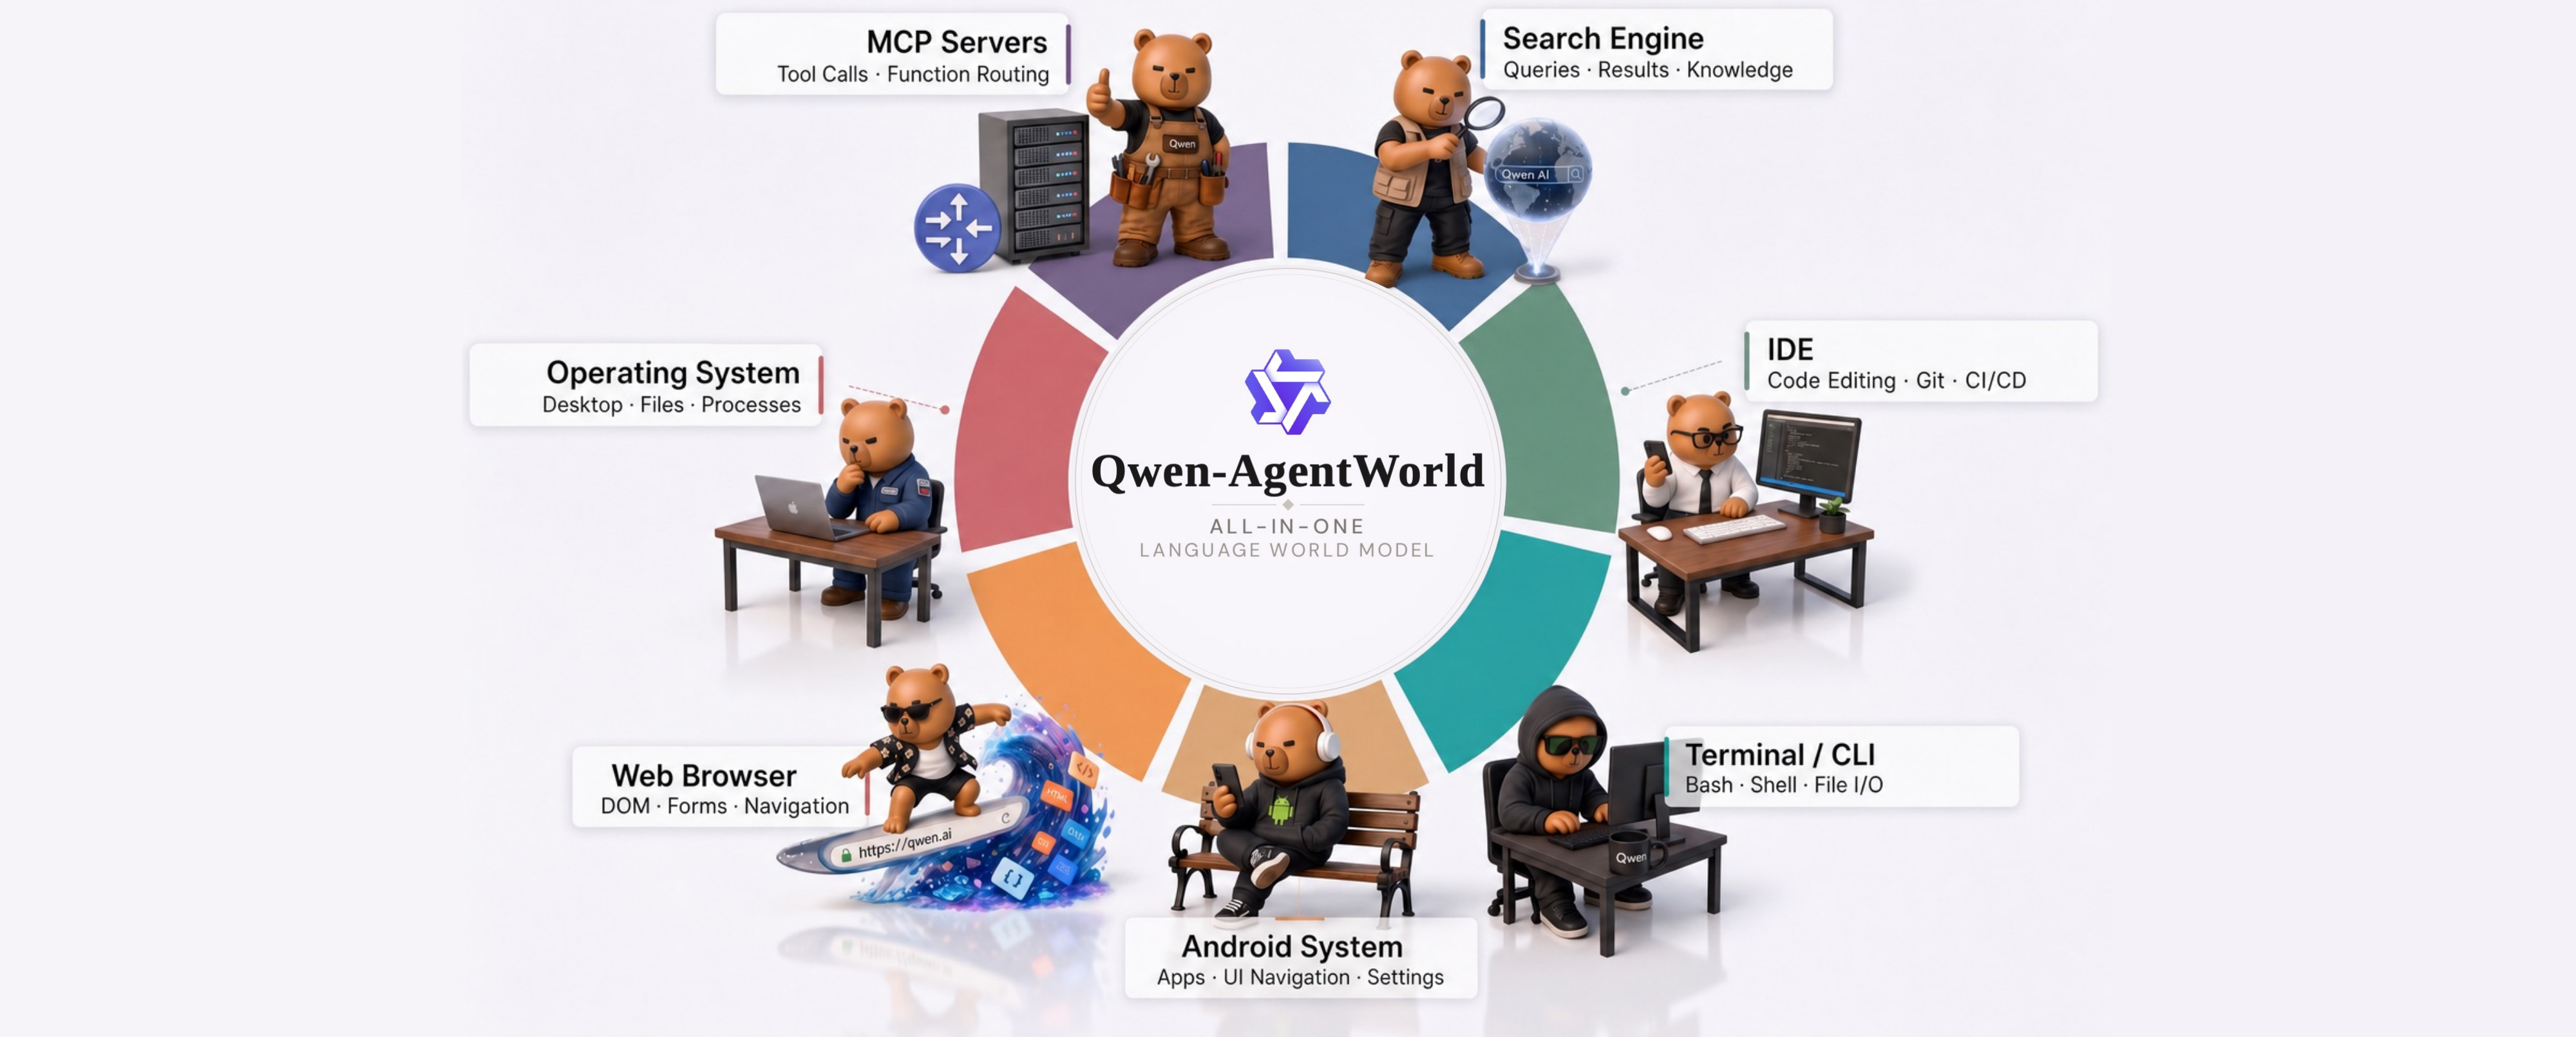
Qwen-AgentWorld - 阿里通义实验室发布的首个原生语言世界模型Qwen-AgentWorld 是阿里巴巴通义实验室发布的首个原生语言世界模型(Language World Model, LWM)。与传统"提示进、动作出"的反应式智能体不同,核心逻辑是先预测环境会...最新AI资源4个月前088.6K
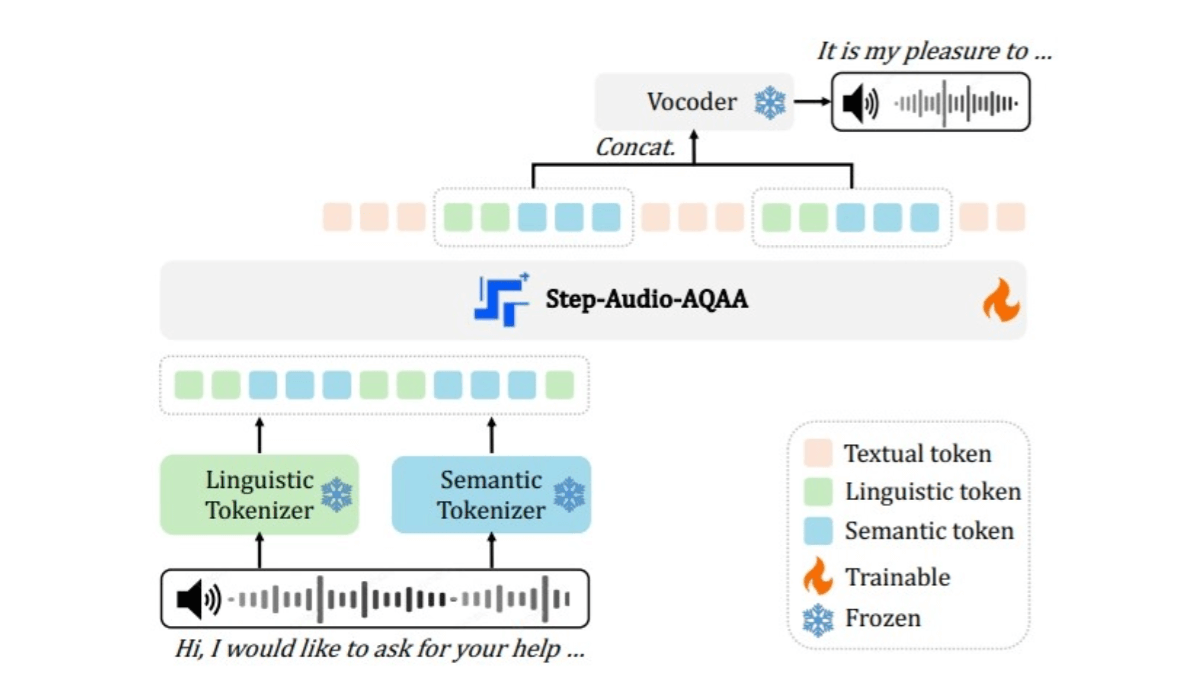
Step-Audio-AQAA – StepFun推出的端到端大音频语言模型Step-Audio-AQAA 是 StepFun 团队推出的端到端大型音频语言模型,用于音频查询-音频回答(AQAA)任务。能直接处理音频输入生成自然、准确的语音回答,无需依赖传统的自动语音识别(A...最新AI资源1年前088.6K
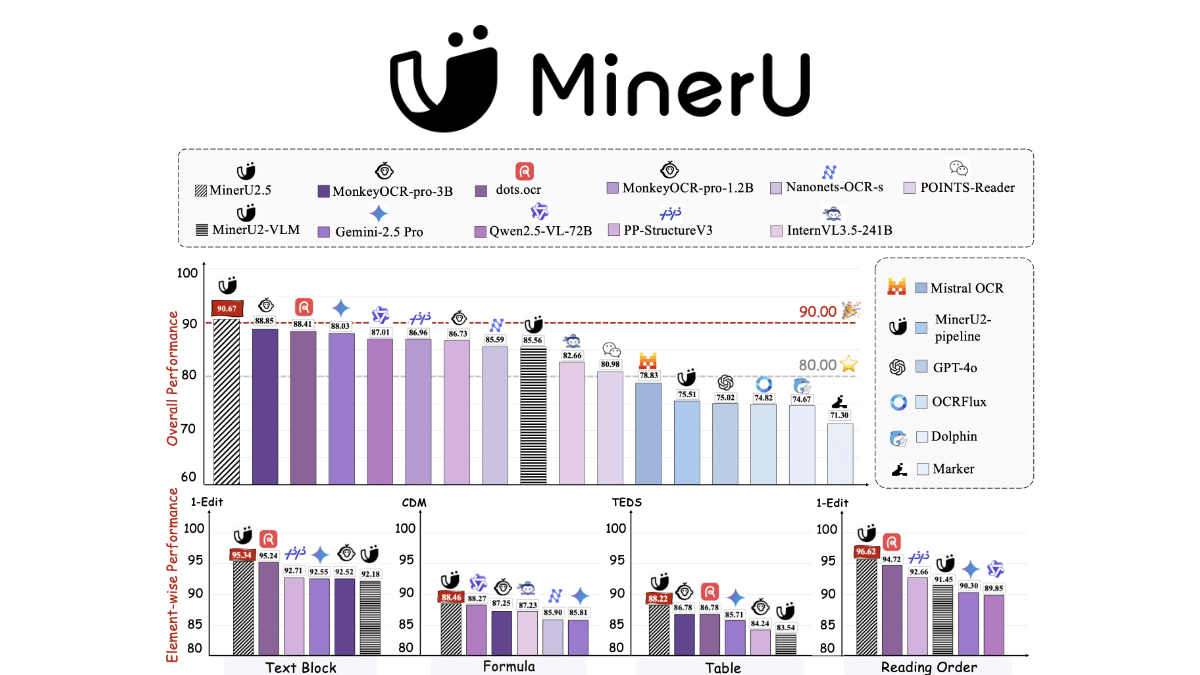
MinerU2.5 - 上海AI Lab联合北大开源的文档解析模型MinerU2.5是上海人工智能实验室与北京大学团队联合研发的解耦式视觉语言模型,专注于高效处理高分辨率文档图像解析。核心创新在于采用"先全局版面检测后局部内容识别"的两阶段设计:第一阶段通过低分辨率...最新AI资源1年前088.6K
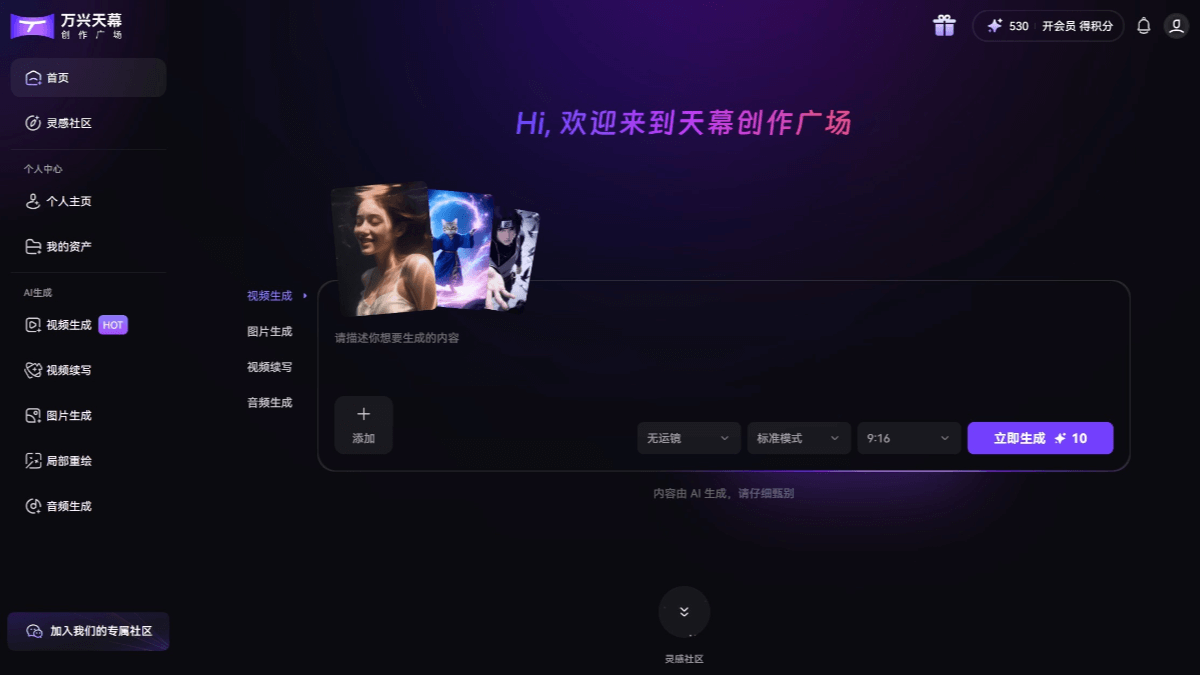
万兴天幕 – 万兴科技推出AIGC视频创作平台万兴天幕是万兴科技推出的AIGC视频创作平台,覆盖视频、图片及音频生成三大创作领域,专为传媒和文化产业工作者、影视/后期工作者、艺术与设计工作者、广告和营销从业者等打造,提供一站式专业创作解决方案。最新AI资源1年前088.6K
Gemini Robotics On-Device - 谷歌推出首个在本地运行的具身智能模型Gemini Robotics On-Device 是谷歌 DeepMind 推出的支持在机器人本地运行的视觉-语言-动作模型。模型能离线执行任务,依据自然语言指令完成精细动作,如叠衣服、拉开袋子等...最新AI资源1年前088.4K
SoulX-FlashTalk - Soul App AI团队开源的实时数字人生成模型SoulX-FlashTalk是Soul App AI团队开源的实时数字人生成模型,拥有140亿参数量,实现了0.87秒超低延迟和32帧/秒的高帧率。模型通过双向蒸馏技术解决了传统数字人延迟高、画面易...最新AI资源9个月前088.4K
Skywork UniPic 2.0 - 昆仑万维开源的高效多模态模型Skywork UniPic 2.0 是昆仑万维开源的高效多模态模型,专注于图像生成、编辑与理解。模型基于 2B 参数的 SD3.5-Medium 架构,通过预训练、渐进式双任务强化策略和联合训练,实...最新AI资源1年前088.3K
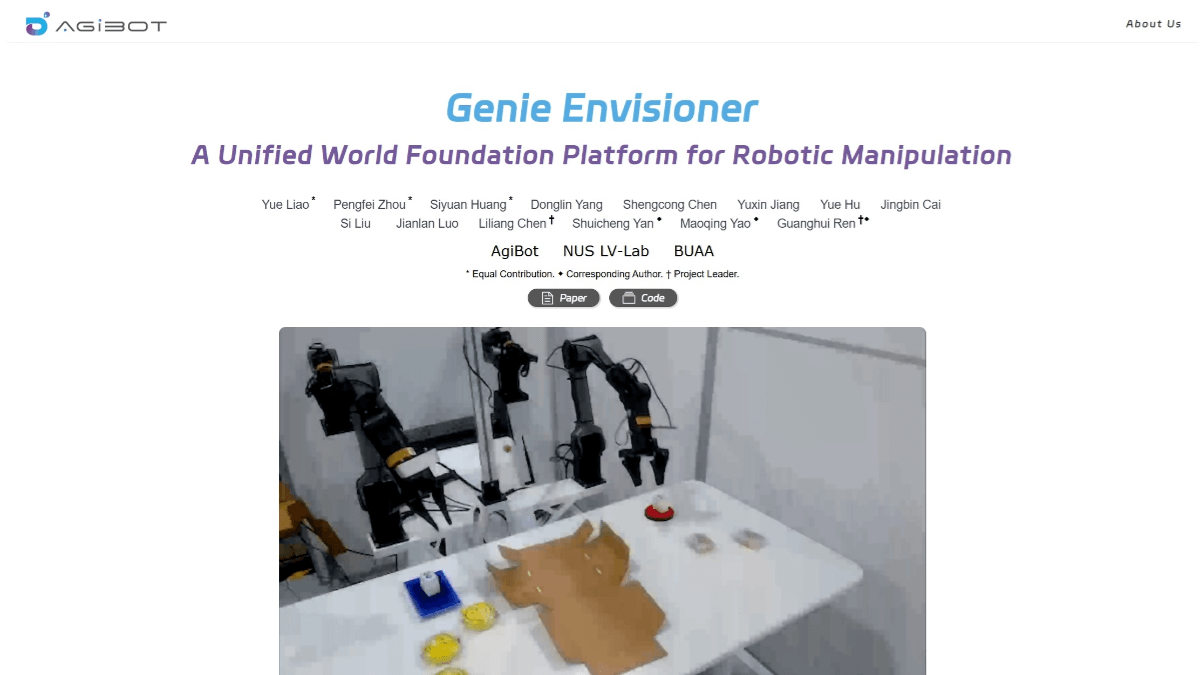
Genie Envisioner - 智元联合北航等开源的通用机器人操作平台Genie Envisioner(GE)是智元机器人团队联合新加坡国立大学、北京航空航天大学等机构开发的机器人操作统一平台。通过“先想象,后行动”的方式,让机器人更好地理解和执行任务。最新AI资源1年前088.3K
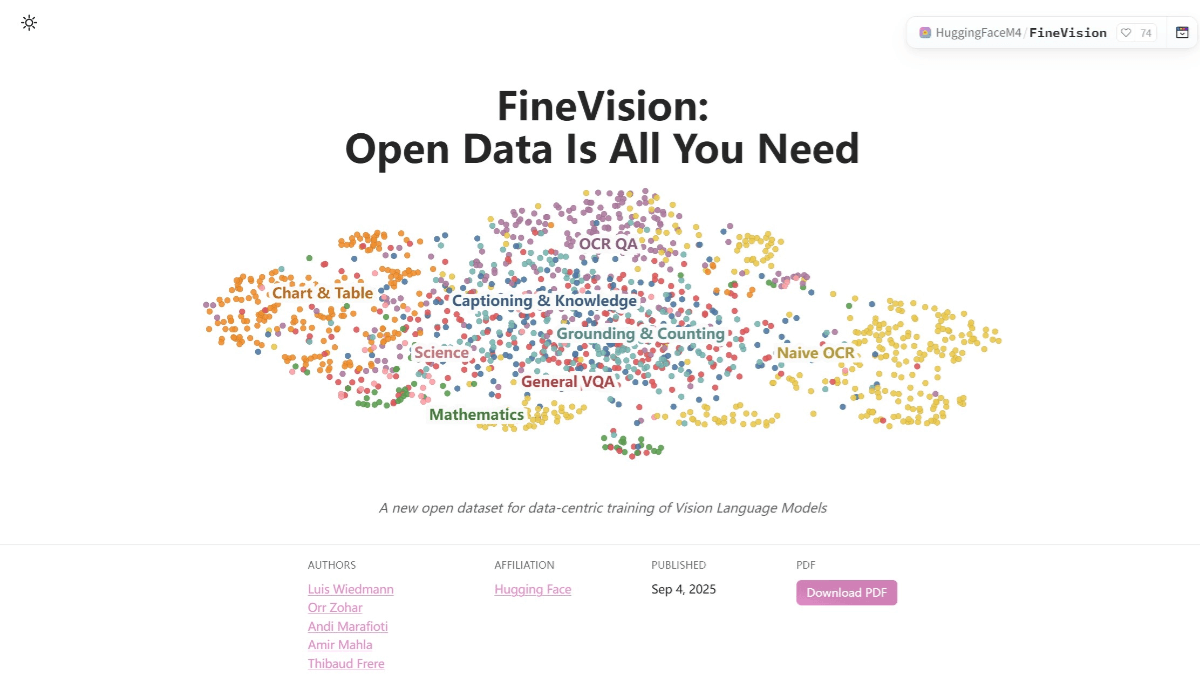
FineVision - Hugging Face推出的开源视觉语言数据集FineVision 是 Hugging Face 开源的视觉语言数据集,为训练先进的视觉语言模型。包含 1730 万张图像、2430 万个样本、8890 万轮对话和 95 亿个答案标记。数据集聚合了...最新AI资源1年前088.2K
LongCat-Video-Avatar 1.5 - 美团开源的音频驱动数字人视频生成模型LongCat-Video-Avatar 1.5 是美团 LongCat 团队开源的音频驱动数字人视频生成模型,基于 13.6B 参数的 LongCat-Video 基础模型构建,采用 MIT 协议完...最新AI资源5个月前088.2K
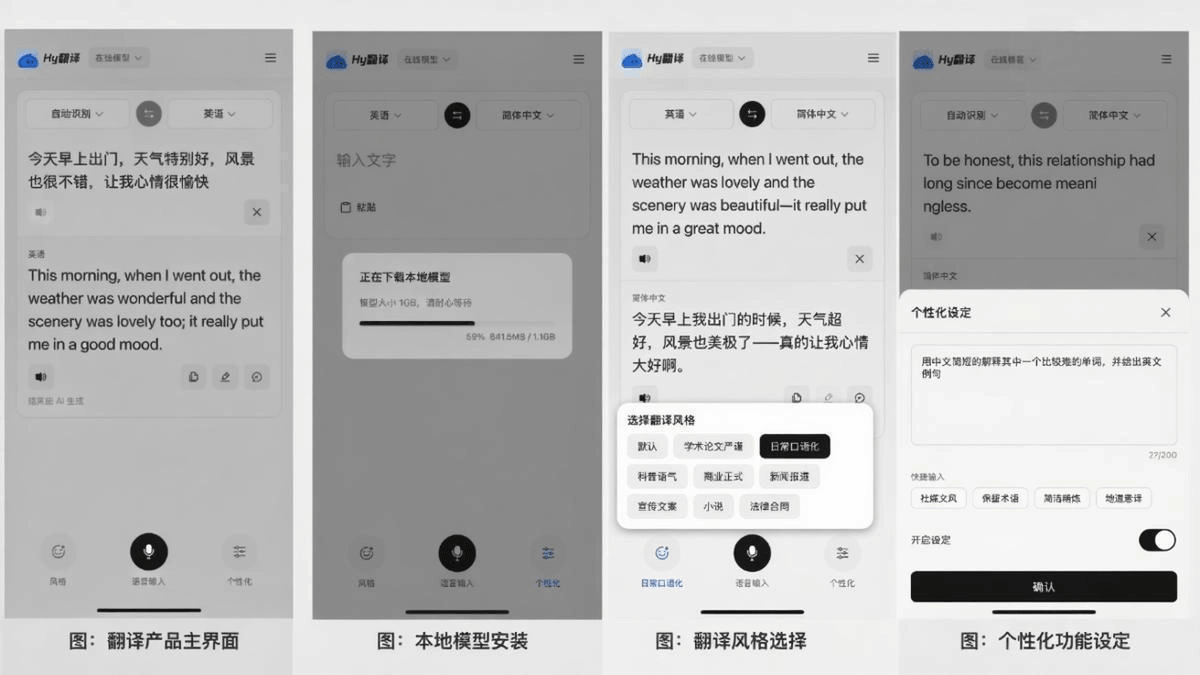
腾讯Hy翻译 - 腾讯混元推出的 AI 翻译工具腾讯Hy翻译是腾讯混元团队基于自研Hy-MT2大模型开发的AI翻译工具,主打全场景适配能力。支持33种语言互译及5种民汉/方言翻译,提供学术论文、法律合同等9种翻译风格预设,可通过微信小程序使用。最新AI资源5个月前088.2K
豆包2.1 - 字节跳动发布的最新旗舰大模型系列豆包2.1(Doubao-Seed-2.1)是字节跳动发布的最新旗舰大模型系列,包含Pro和Turbo两个版本,专为Coding与Agent时代打造。编程能力上,在Terminal Bench 2.1...最新AI资源4个月前088.1K
Step-Audio 2 mini - 阶跃星辰开源的语音大模型Step-Audio 2 mini 是阶跃星辰开源的端到端语音大模型。突破传统语音模型结构,采用真端到端多模态架构,直接将原始音频输入转化为语音响应输出,时延更低,能理解副语言信息与非人声信号。最新AI资源1年前088K
Qwen3-Max-Preview - 通义千问推出的旗舰大语言模型Qwen3-Max-Preview 是通义千问发布的最新旗舰大语言模型。是 Qwen3 系列中参数量最大的模型,参数规模超过 1 万亿。模型在推理、指令跟随、多语言支持和长尾知识覆盖等方面有重大改进...最新AI资源1年前087.9K
悟能 - 商汤科技最新推出的具身智能平台悟能是商汤科技推出的具身智能平台,专为机器人和智能设备设计。悟能基于“开悟”世界模型与多模态大模型技术,整合视觉、语音、触觉等多传感器输入,具备强大的感知、决策和行动能力。最新AI资源1年前087.9K
AlphaClaw - 熵简科技推出的金融投研 AI Agent 工具AlphaClaw 是熵简科技推出的金融投研 AI 工具,搭载于 AlphaEngine 平台,被誉为"投研小龙虾"。完成了从"有问必答的 AI 助手"向"自主执行的 AI 分析师"的进化,能独立跑通...最新AI资源8个月前087.8K
肉包 - 开源AI手机自动化助手,能看懂屏幕自动执行肉包(Roubao)是开源的AI手机助手,让用户用现有Android手机能体验类似"豆包手机"的智能自动化功能。肉包基于视觉语言模型,能看懂屏幕内容并自动执行复杂任务,从点外卖、发微信到跨App操作...最新AI资源8个月前087.8K
VitaBench - 美团LongCat开源的交互式Agent评测基准VitaBench是美团LongCat团队发布的首个面向复杂生活场景的交互式Agent评测基准,评估大模型智能体在真实生活场景中的综合能力。以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为载体,构建包...最新AI资源1年前087.7K
陪读蛙 - 开源的 AI 翻译浏览器扩展插件陪读蛙(Read Frog)是前字节跳动软件工程师 mengxi-ream 开源的 AI 浏览器扩展插件,定位为"沉浸式语言学习助手",通过 AI 技术将日常网页阅读转化为语言学习过程,支持在原文旁直...最新AI资源5个月前087.7K
Qwen VLo – 通义千问推出的多模态统一理解与生成模型Qwen VLo 是通义千问团队推出的多模态统一理解与生成模型。能“看懂”世界,能基于理解进行高质量的再创造,实现了从感知到生成的跨越。能精准理解图像内容,在此基础上进行一致性和高质量的生成。最新AI资源1年前087.7K
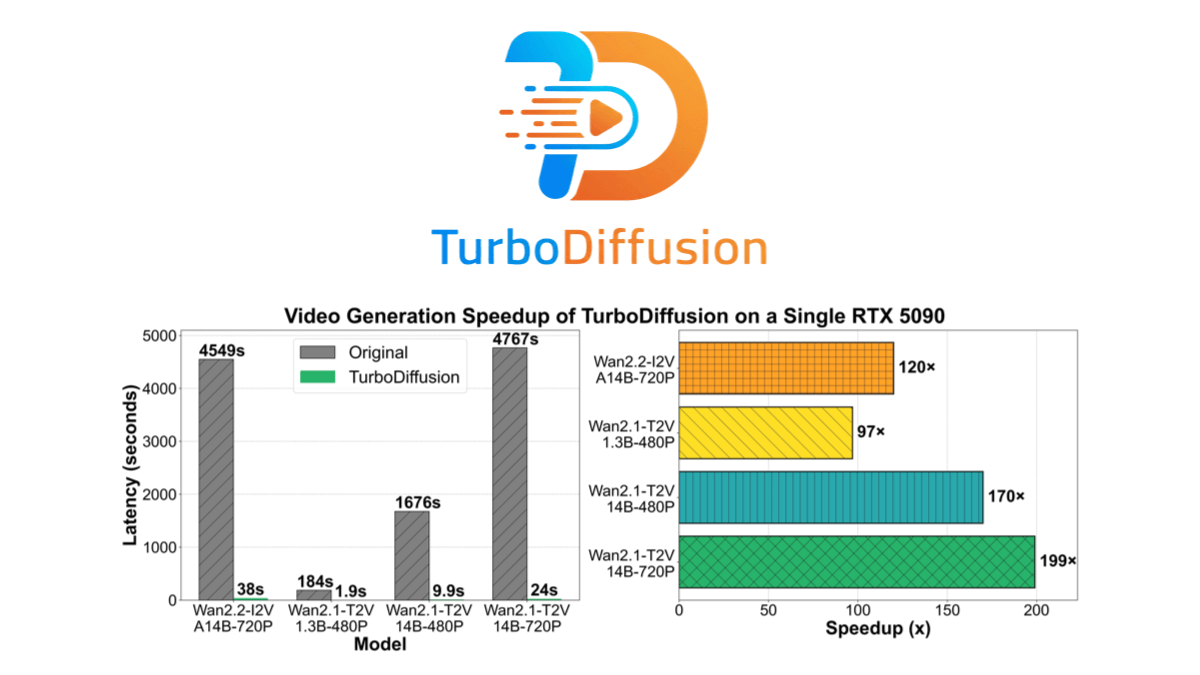
TurboDiffusion - 生数科技联合清华等开源的视频生成加速框架TurboDiffusion是清华大学、生数科技和加州大学伯克利分校联合开源的视频生成加速框架,能在保持画质几乎无损的情况下,将视频生成速度提升100-200倍。通过稀疏线性注意力、采样步数蒸馏和8位...最新AI资源10个月前087.6K
Granite-Docling-258M - IBM开源的视觉语言模型Granite-Docling-258M 是 IBM 推出的超紧凑开源视觉语言模型,专为高效文档转换设计。模型能将文档转换为机器可读格式,同时完整保留布局、表格、公式等元素。最新AI资源1年前087.6K
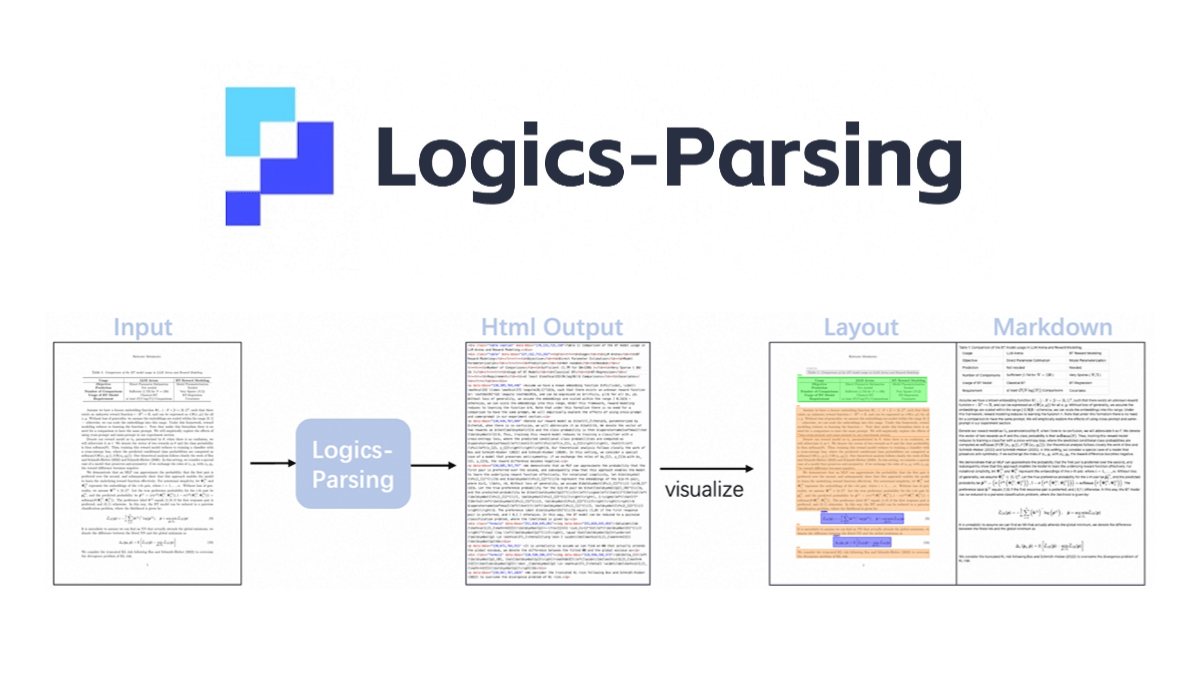
Logics-Parsing - 阿里开源的文档解析模型Logics-Parsing 是阿里开源的端到端文档解析模型,基于 Qwen2.5-VL-7B。通过强化学习优化文档布局分析和阅读顺序推断,能将 PDF 图像转换为结构化 HTML 输出,支持多种内容...最新AI资源1年前087.5K
HunyuanWorld-Voyager - 腾讯开源的超长漫游世界模型HunyuanWorld-Voyager(简称混元Voyager)是腾讯发布的业界首个支持原生3D重建的超长漫游世界模型。是一种新颖的视频扩散框架,能从单张图片生成用户定义相机路径的3D点云序列,支持...最新AI资源1年前087.5K
FunctionGemma - 谷歌开源专为函数调用优化的轻量级AI模型FunctionGemma是谷歌推出的专为函数调用优化的轻量级AI模型,基于2.7亿参数的Gemma 3基础模型开发,可在手机、浏览器等设备上实时将自然语言转换为可执行API指令。核心特点是支持本地离...最新AI资源11个月前087.4K
OpenReasoning-Nemotron - 英伟达推出的开源系列推理模型OpenReasoning-Nemotron 是英伟达开源的一系列大型语言模型,支持处理数学、科学和代码领域的推理任务。模型基于 DeepSeek R1 0528 模型蒸馏而成,参数规模有 1.5B...最新AI资源1年前087.4K
ThinkSound - 阿里通义推出的音频生成模型ThinkSound是阿里通义语音团队推出的首个CoT(链式思考)音频生成模型。模型能为视频画面生成精准匹配的音效,基于引入CoT推理,解决传统技术难以捕捉画面动态细节和空间关系的问题。最新AI资源1年前087.3K
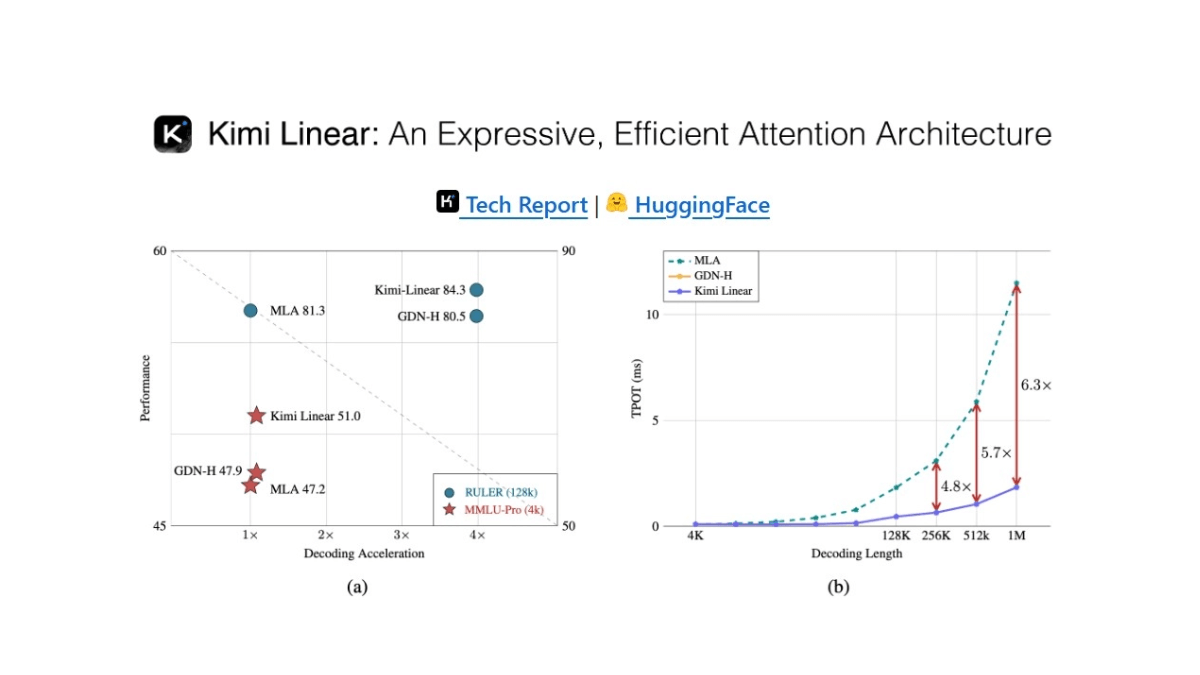
Kimi Linear - 月之暗面开源的新型混合线性注意力架构Kimi Linear 是月之暗面开源的新型混合线性注意力架构,以 Kimi Delta Attention(KDA)为核心,通过更细粒度的门控机制优化了传统注意力模型,显著提升了硬件效率和内存控制能...最新AI资源1年前087.2K
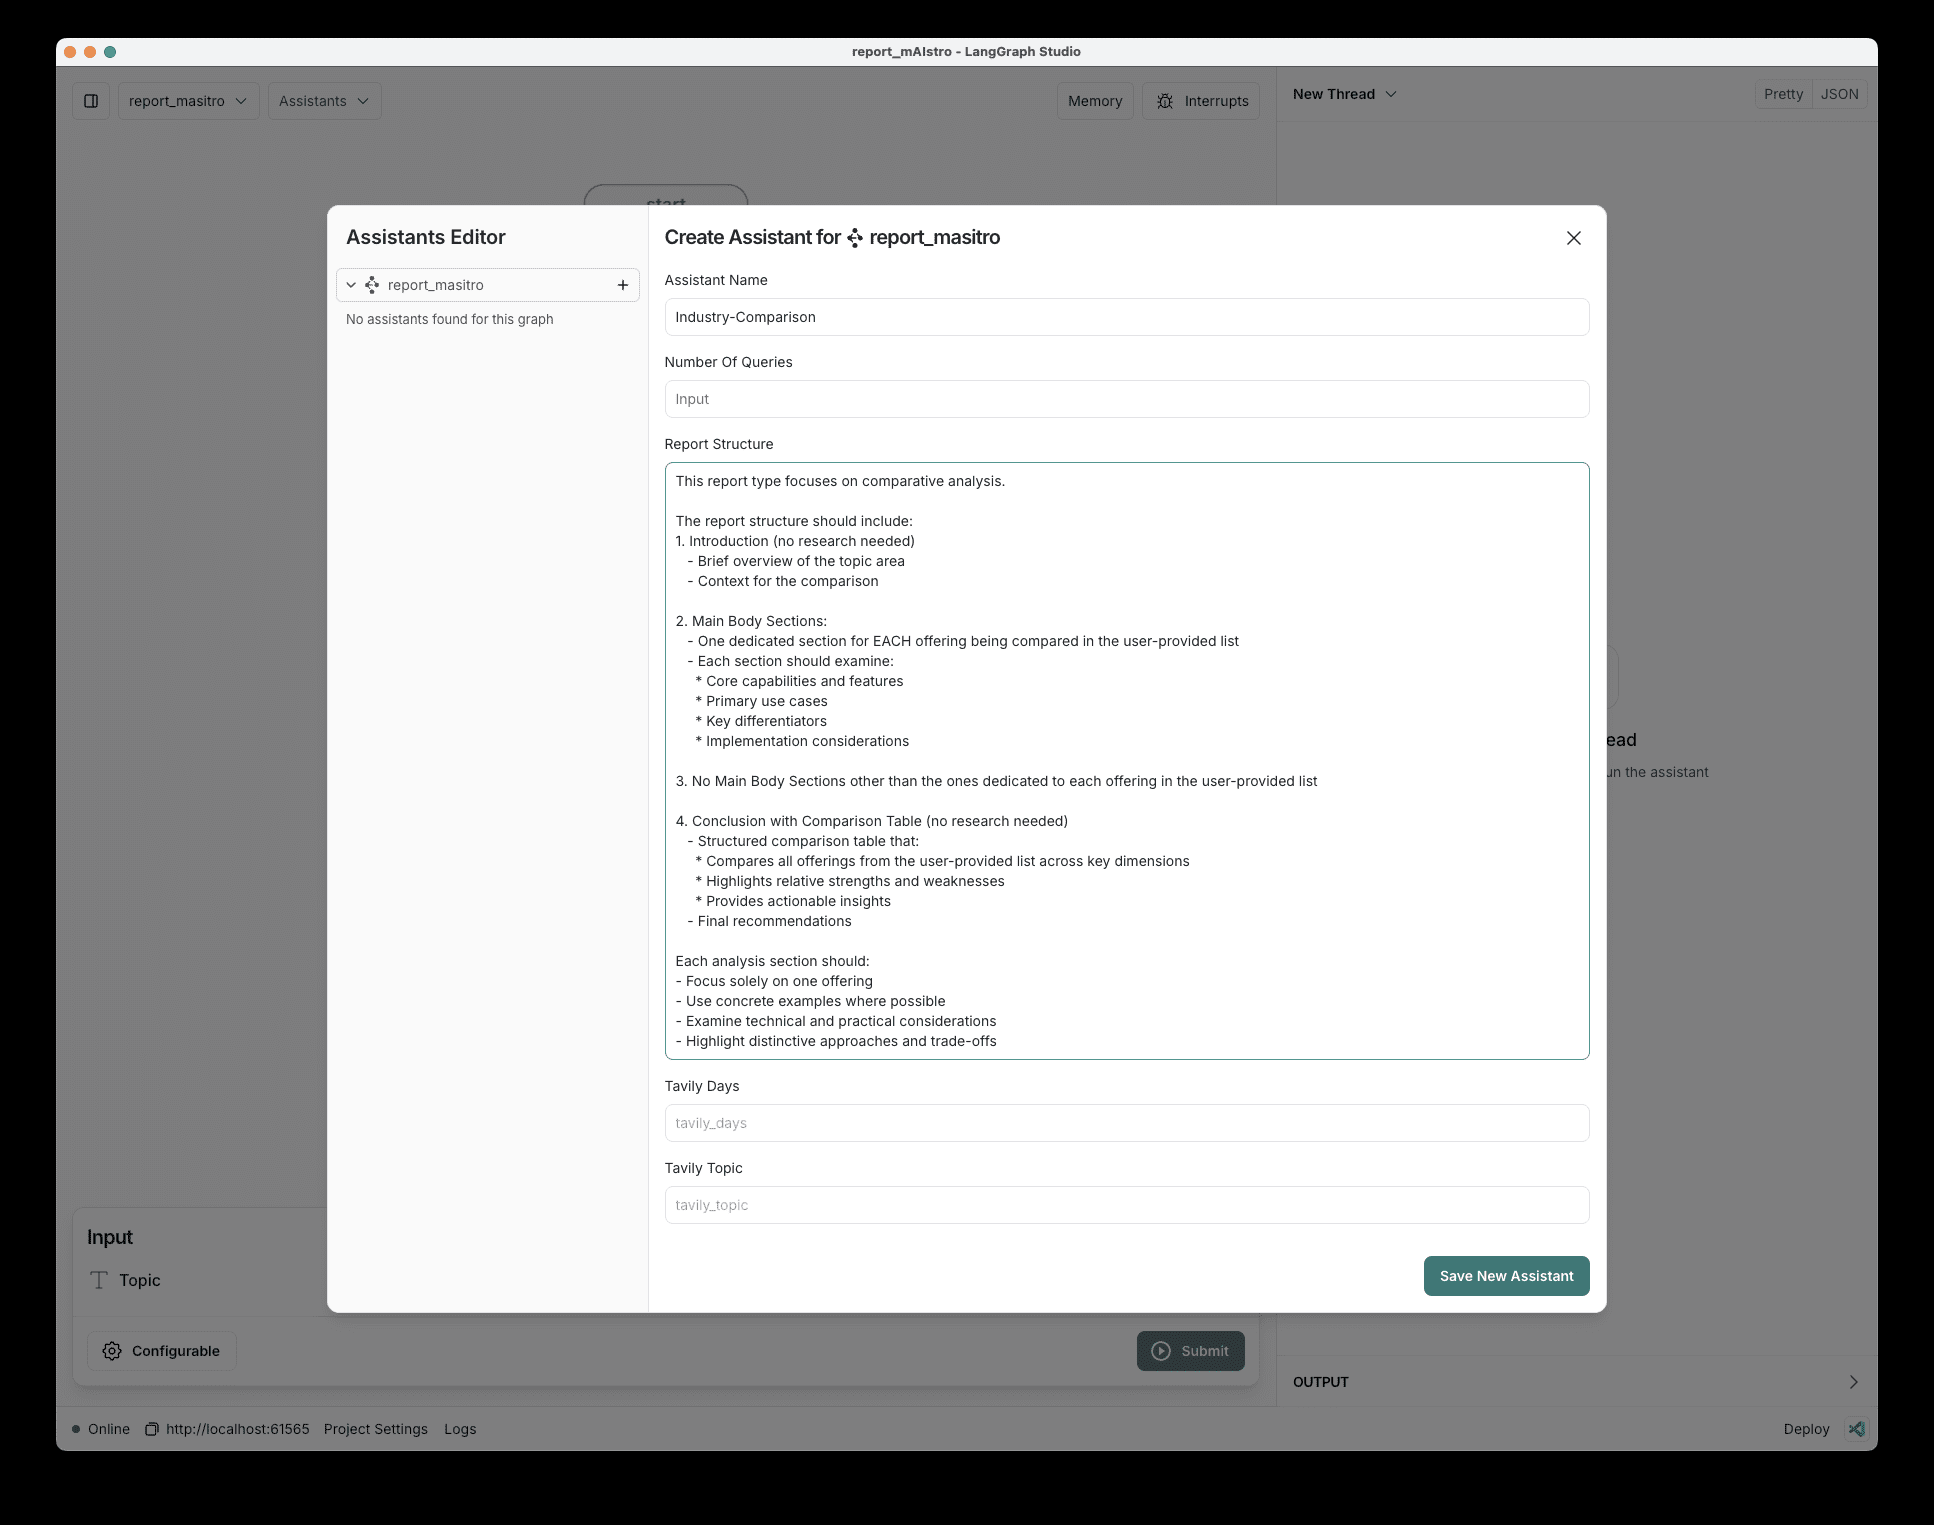
Report mAIstro:生成任意自定义主题的详细报告文档,例如商业分析、年终汇报等综合介绍 报告生成工具(Report mAIstro)是一个强大的工具,旨在通过自然语言处理技术,帮助用户轻松创建自定义报告。该工具利用LangChain技术,将用户提供的主题和结构转化为详细的报告内...最新AI资源# AI开源项目# 生成深度研究报告2年前087K
日日新 V6.5 - 商汤科技推出的最新多模态推理大模型日日新 V6.5 是商汤科技推出的先进多模态推理大模型,专为处理图像与文本混合输入而设计,支持精准理解图像内容并结合文本生成描述或回答问题。最新AI资源1年前087K
JoyAI-Echo - 京东开源的分钟级长音视频生成框架JoyAI-Echo 是京东开源的分钟级长音视频生成框架,专为解决AI视频"角色易崩、声音乱变、生成缓慢"三大痛点而设计。基于LTX-2.3 DiT架构,通过跨模态记忆库在长达5分钟的多镜头视频中保持...最新AI资源5个月前086.9K
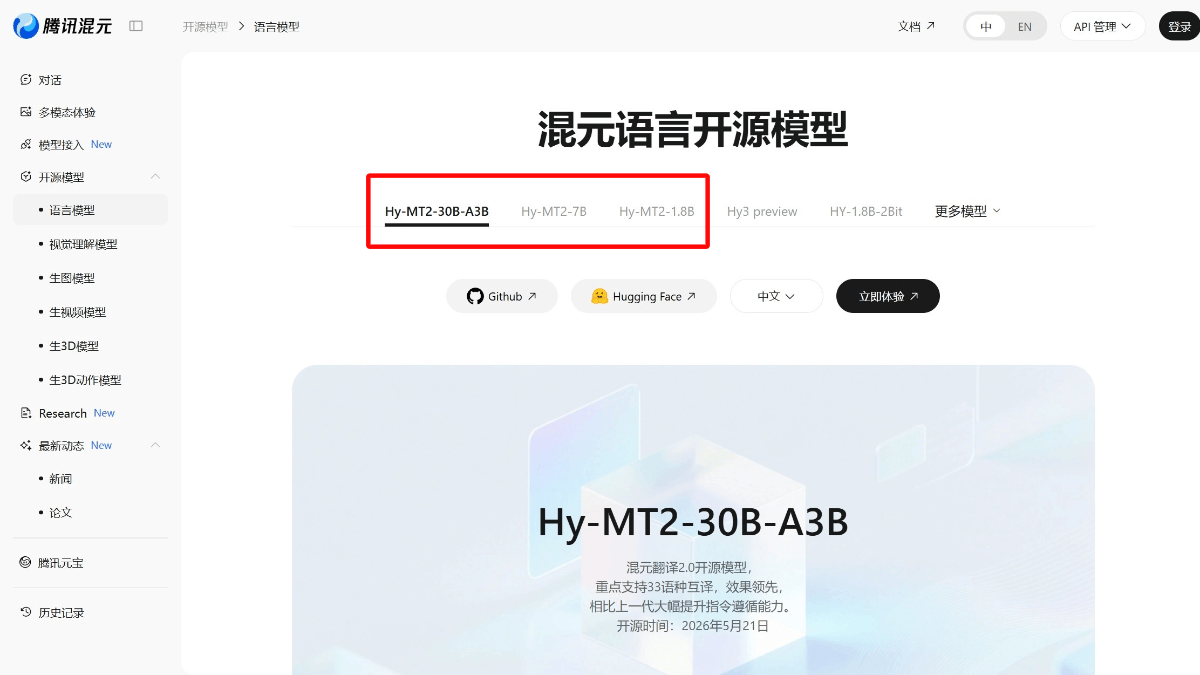
Hy-MT2 - 腾讯混元开源的多语言机器翻译模型家族Hy-MT2 是腾讯混元开源的多语言机器翻译模型家族,专为复杂真实场景设计。包含 1.8B、7B 和 30B-A3B(MoE) 三个尺寸,均支持 33种语言 之间的互译,具备多语言翻译指令遵循能力。最新AI资源5个月前086.8K
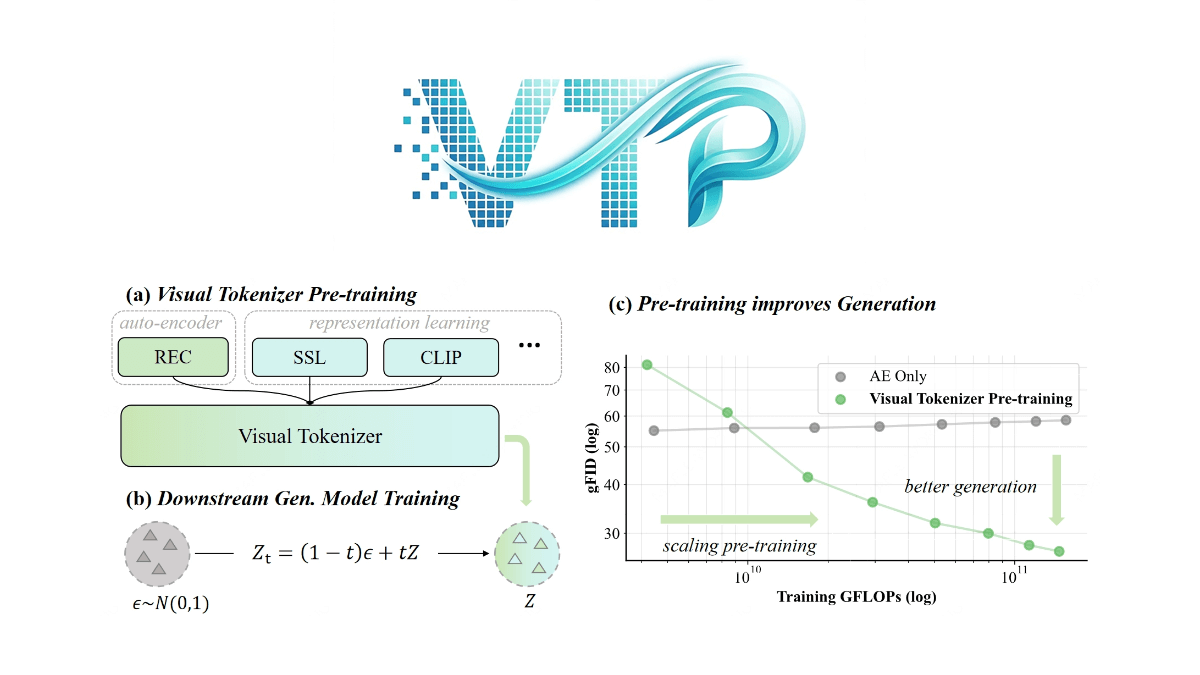
VTP - MiniMax海螺视频团队开源的视觉生成模型技术VTP(Visual Tokenizer Pre-training)是MiniMax海螺视频团队提出的视觉生成模型关键技术,通过改进视觉分词器(tokenizer)的预训练方法提升生成系统性能。传统方...最新AI资源11个月前086.8K
SongBloom - 腾讯联合港中文、南大开源的歌曲生成模型SongBloom是腾讯AI Lab联合香港中文大学(深圳)与南京大学研发的开源歌曲生成模型,解决AI音乐生成中的“塑料感”问题,实现高质量、结构完整的歌曲生成。只需输入10秒参考音频和对应歌词,即可...最新AI资源1年前086.8K
Z-Image - 阿里通义实验室开源的图像生成模型Z-Image是阿里通义实验室开源的图像生成模型,具有高效、快速和强大的图像生成能力。采用单流扩散Transformer架构(S3-DiT),将文本、视觉语义和图像VAE token整合为统一输入流...最新AI资源11个月前086.8K
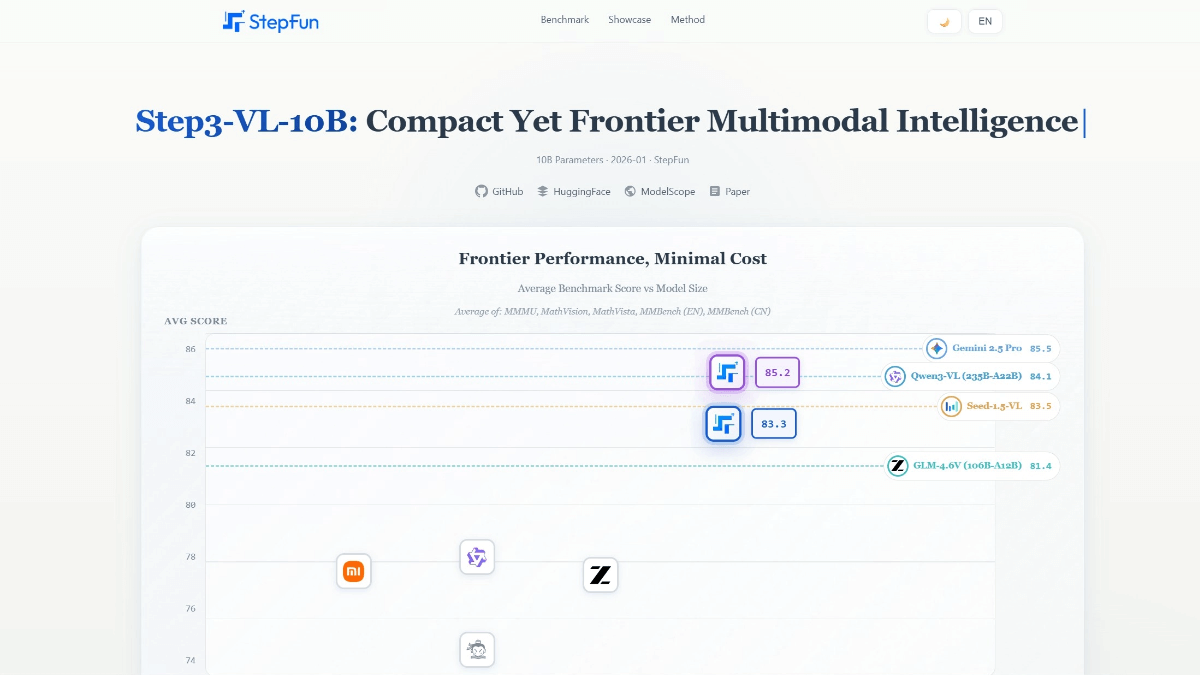
Step3-VL-10B - 阶跃星辰开源的100亿参数多模态AI模型Step3-VL-10B是阶跃星辰团队开源的100亿参数多模态AI模型,核心突破在于以轻量化设计实现顶级性能。模型通过统一预训练策略(1.2T多模态令牌数据)和创新的并行协同推理技术(PACORE...最新AI资源9个月前086.6K
PromptEnhancer - 腾讯混元开源的AI提示词增强工具PromptEnhancer 是腾讯混元团队开源的提示词增强工具,提升文本到图像(Text-to-Image,T2I)模型的生成效果。通过链式推理(Chain-of-Thought,CoT)的方式对用...最新AI资源1年前086.6K
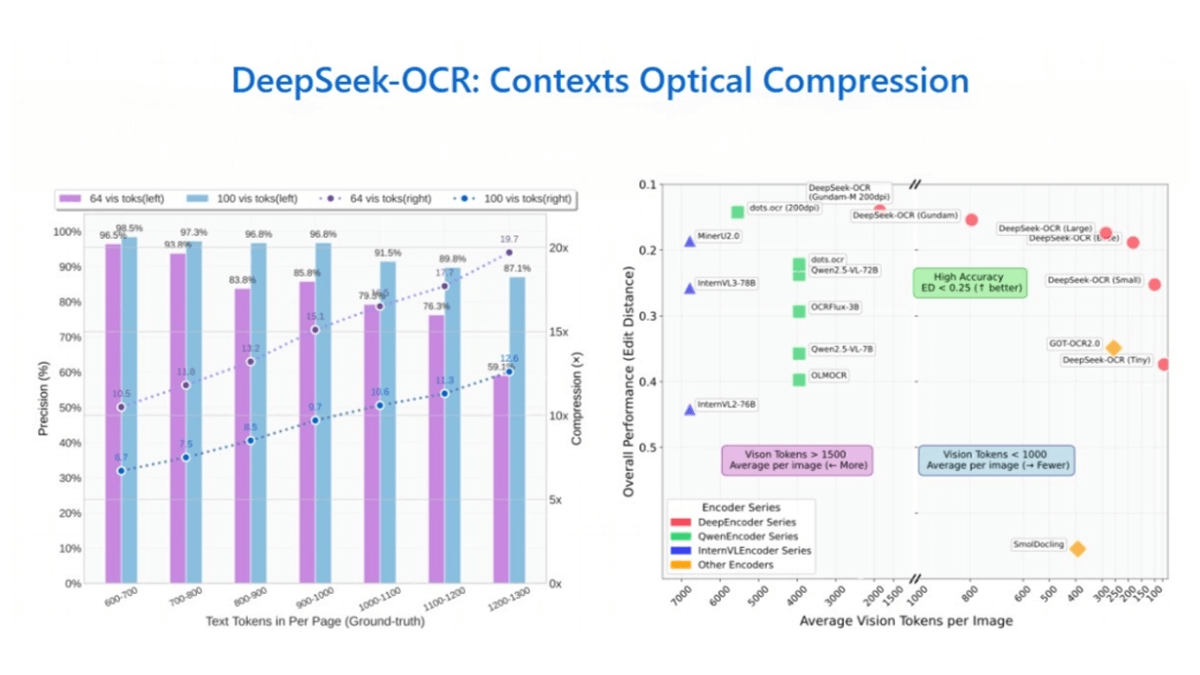
DeepSeek-OCR - DeepSeek开源的光学字符识别模型DeepSeek-OCR 是 DeepSeek 团队开源的先进光学字符识别(OCR)模型,通过“上下文光学压缩”技术,将文本转换为图像,利用视觉 token 进行压缩和解码,实现高效长文本处理。最新AI资源1年前086.5K
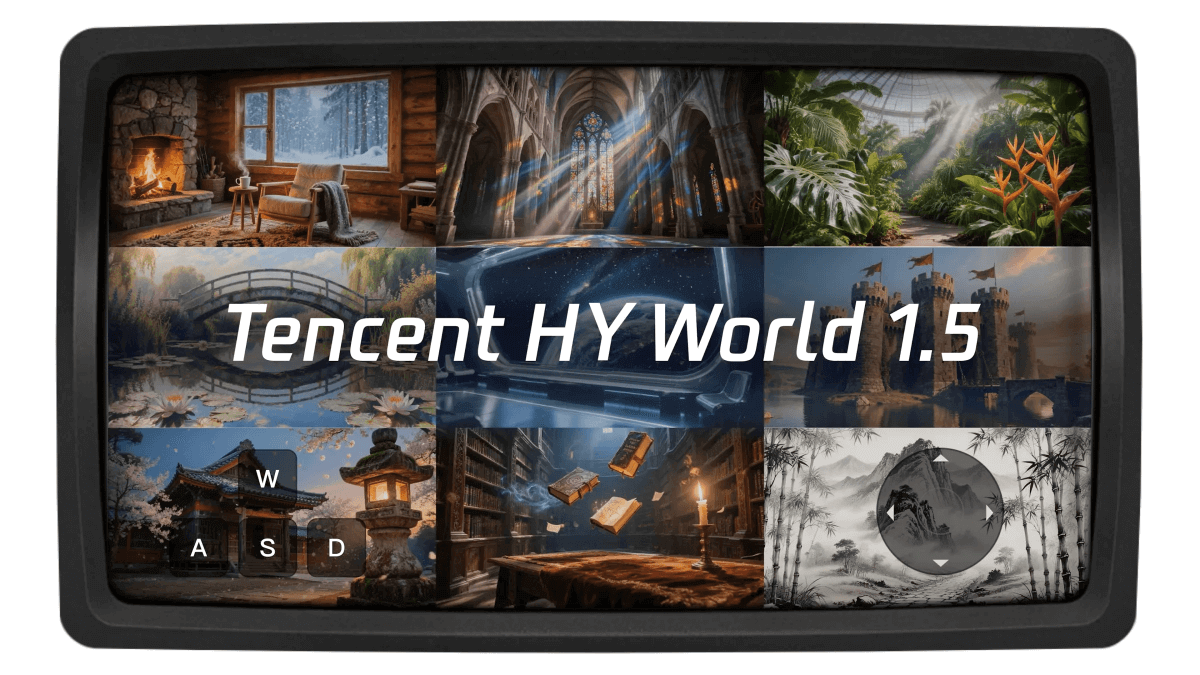
混元世界模型1.5 - 腾讯混元开源的实时世界模型生成框架混元世界模型1.5(Tencent HY WorldPlay)是腾讯发布的业界首个开源的实时世界模型框架,涵盖数据、训练、流式推理部署等全链路。核心是WorldPlay自回归扩散模型,采用Next-F...最新AI资源11个月前086.5K
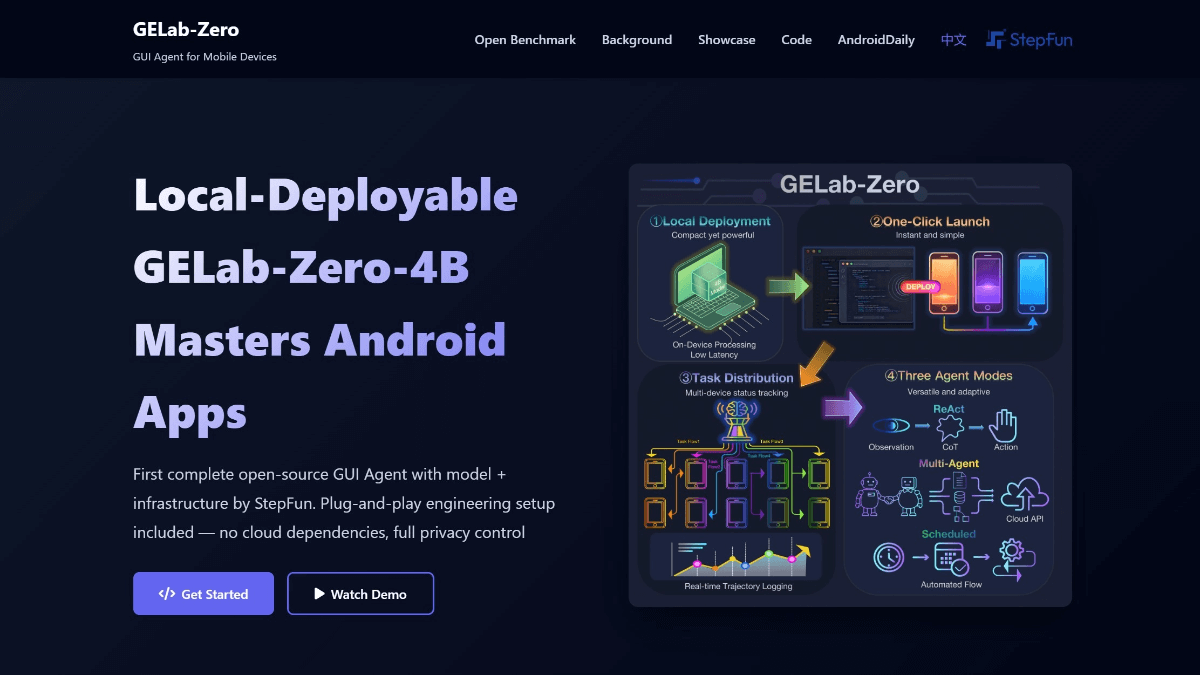
GELab-Zero - 阶跃团队开源的端侧多模态GUI Agent模型GELab-Zero是阶跃团队开源的端侧多模态GUI Agent模型,基于Qwen3-VL-4B-Instruct基座模型构建,参数量为4B。能识别UI元素并执行点击、滑动等操作,支持跨应用任务处理...最新AI资源11个月前086.5K
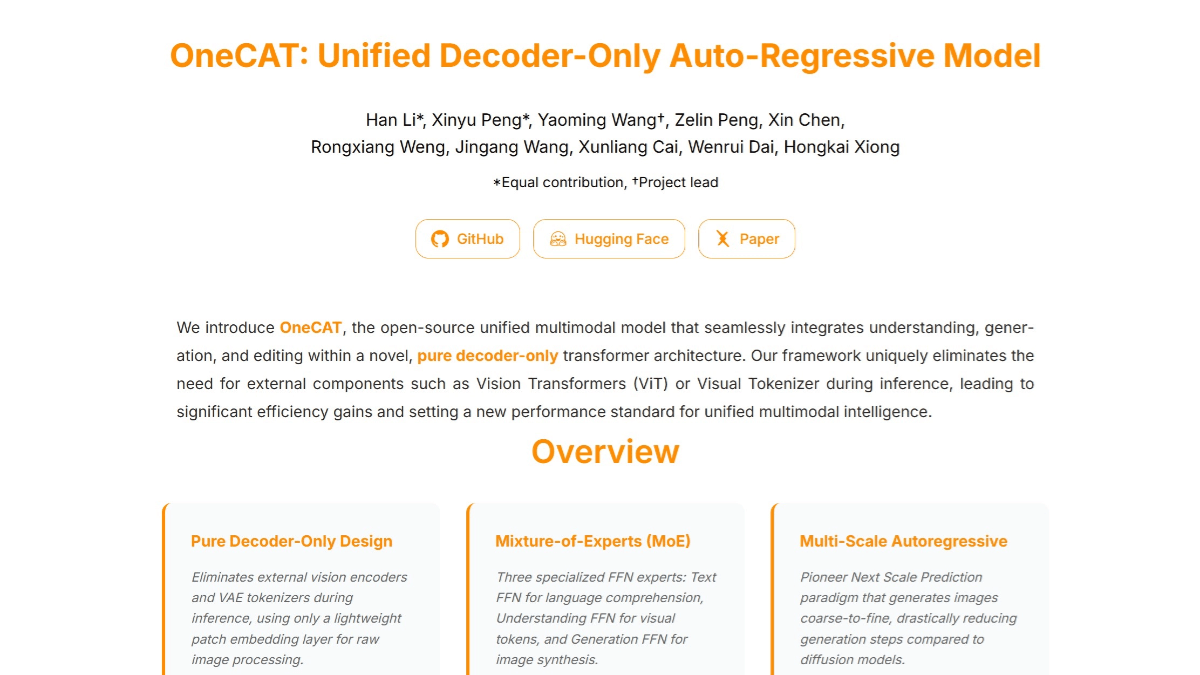
OneCAT - 美团联合上海交大开源的多模态模型OneCAT是美团联合上海交大推出的新型统一多模态模型,采用纯解码器架构,能无缝集成多模态理解、文本到图像生成和图像编辑功能。模型摒弃了传统多模态模型中依赖外部视觉编码器和分词器的设计,通过特定模态的...最新AI资源1年前086.5K
YouClaw - Chat2DB 开源的极简 AI Agent 桌面客户端YouClaw 是 Chat2DB 团队推出的极简 AI Agent 桌面客户端,主打"最懂你的 AI 个人助理"定位。基于 Tauri 2 + React 构建,安装包仅约 30MB,支持 Wind...最新AI资源7个月前086.4K
SkyClaw - Skywork AI 推出的云端AI Agent工作空间SkyClaw 是 Skywork AI 推出的云端持久化智能工作空间,定位超越传统对话机器人的"主动执行型代理"。支持在 Slack、Discord、WhatsApp 等主流平台原生集成,能基于用户...最新AI资源8个月前086.4K
Step 3.5 Flash - 阶跃星辰开源的 1960 亿稀疏 MoE 模型Step 3.5 Flash 是阶跃星辰开源的 1960 亿稀疏 MoE 模型,每 token 仅激活 110 亿参数,能在代码任务跑出 350 token/s 的实时速度。基于自研 MTP-3 多 ...最新AI资源9个月前086.4K
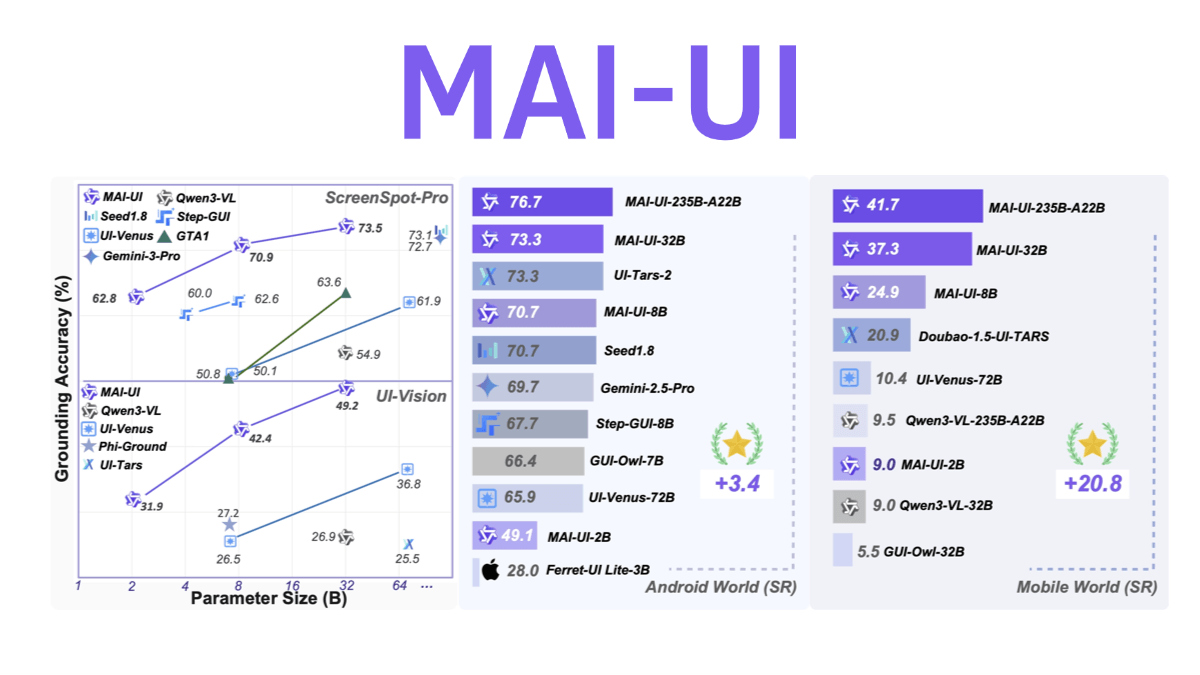
MAI-UI - 阿里通义实验室开源的通用GUI智能体基座模型MAI-UI是阿里巴巴通义实验室开源的通用GUI智能体基座模型,具备跨应用操作、模糊语义理解、主动用户交互和多步骤流程协调四大能力。采用端云协同架构,轻量模型驻守设备处理日常任务,复杂任务可调用云端大...最新AI资源10个月前086.4K
Wan2.2-Animate - 通义万相开源的动作生成模型Wan2.2-Animate是通义万相开源的动作生成模型,支持动作模仿和角色扮演两种模式。用户只需输入一张角色图片和一段参考视频,模型能将视频中角色的动作、表情迁移到图片角色中,赋予图片角色动态表现力...最新AI资源1年前086.2K
Qwen3.5-LiveTranslate - 阿里通义千问发布的实时语音翻译大模型Qwen3.5-LiveTranslate 是阿里巴巴通义千问团队发布的实时语音翻译大模型,基于 Qwen3.5-Omni Thinker-Talker 架构打造。模型支持 60 种语言的音频输入与文...最新AI资源5个月前086.2K
InfinityHuman - 字节联合浙大推出的长视频数字人生成模型InfinityHuman 是字节跳动与浙江大学联合推出的商用级长时序音频驱动人物视频生成模型。模型通过音频驱动,能生成高分辨率、长时长且视觉一致的人物视频。最新AI资源1年前086.1K
NovaSR - 开源的音频超分辨率模型,提升音频采样率NovaSR是开源的音频超分辨率模型,主要用于将低质量音频(如16kHz采样率的电话音质)提升为高质量音频(如48kHz采样率的录音室级音质)。模型大小仅52KB,比一张微信表情包还小,可轻松部署在资...最新AI资源10个月前086.1K
Egocentric-10K - Build AI开源的第一人称视角机器人数据集Egocentric-10K 是大规模的第一人称视角(egocentric)工厂操作视频数据集,由 build.ai 团队开源。数据集包含 10,000 小时的视频,总帧数达 10.8 亿帧,涉及 2...最新AI资源12个月前086K
Lucy Edit - 开源的AI视频编辑工具,自然语言描述编辑Lucy Edit 是开源的 AI 视频编辑工具,由 Decart AI 开发。允许用户通过简单的自然语言描述来编辑视频,例如“将人物换成北极熊”或“把场景变成2D卡通风格”,无需复杂的微调或使用遮罩...最新AI资源1年前085.8K
MiniCPM5-1B - 面壁智能联合清华、OpenBMB开源的端侧文本基座模型MiniCPM5-1B 是面壁智能联合清华大学与 OpenBMB 开源社区发布并开源的新一代端侧文本基座大模型。模型以仅 10 亿(1B)的参数规模,在国际权威榜单 AA-Index(Artifici...最新AI资源5个月前085.7K
Baichuan-M3 - 百川智能开源的新一代医疗大语言模型Baichuan-M3是百川智能推出的新一代开源医疗大语言模型,专为医疗场景深度优化,具备强大的医疗推理和问诊能力。在权威的HealthBench评测中以65.1分的综合成绩位列全球第一,超越了GPT...最新AI资源10个月前085.6K
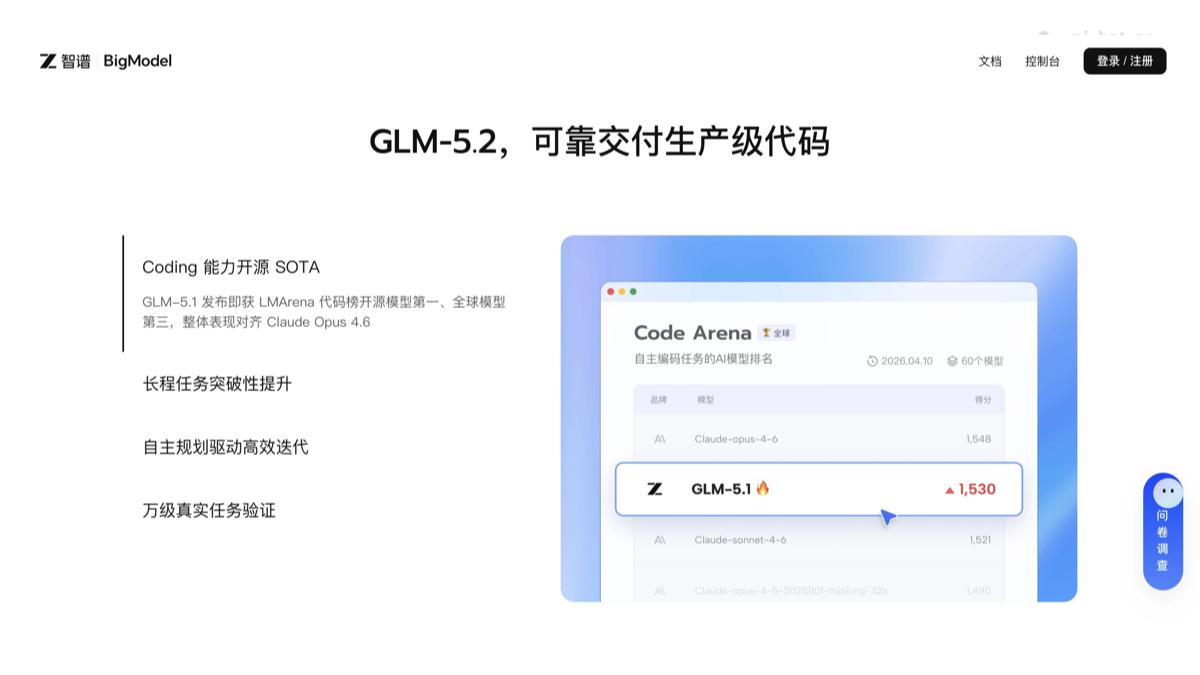
GLM-5.2 - 智谱最新推出的旗舰级开源大模型GLM-5.2 是智谱最新推出的旗舰级开源大模型,超长上下文理解和智能编程为核心卖点。模型具备百万级 token 的上下文处理能力,能一次性分析整个代码仓库或长篇技术文档。最新AI资源5个月前085.6K
OpenHuman - 开源桌面个人 AI 助手,能主动理解用户的数字同事OpenHuman是开源的个人AI助手项目,由Tiny Humans AI团队开发,解决传统AI助手缺乏长期记忆和上下文理解能力的问题。定位为“个人AI操作系统”或“数字分身”,目标是让AI从被动响应...最新AI资源6个月前085.5K
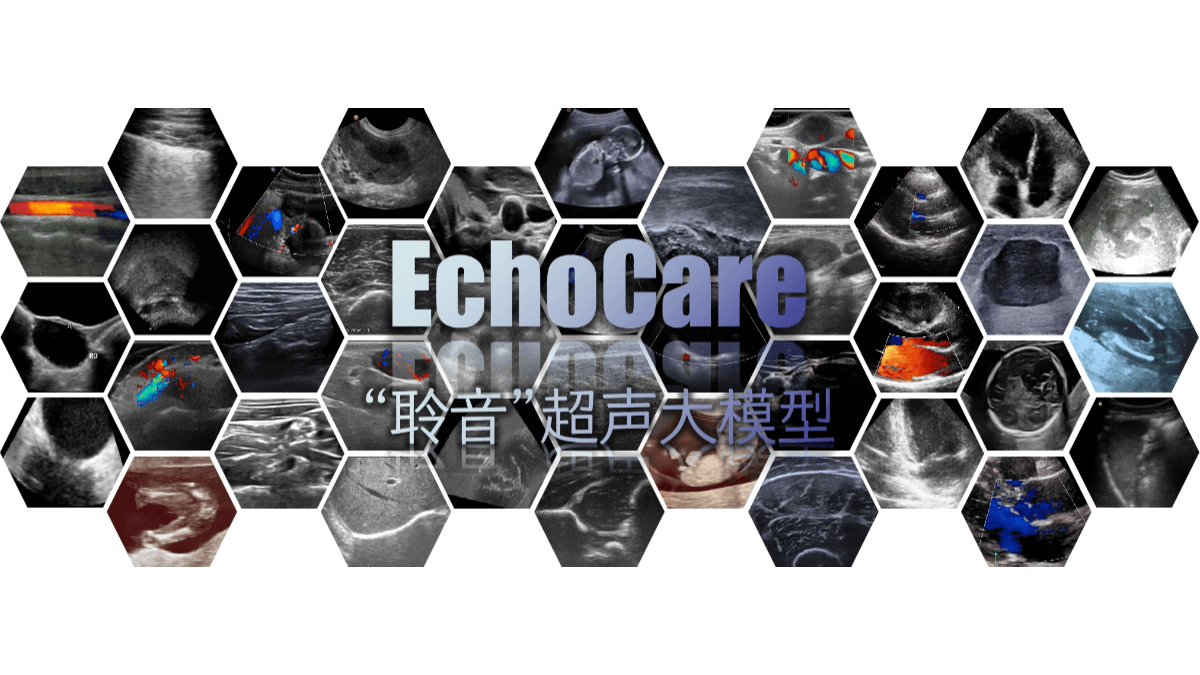
聆音EchoCare - 香港科学院开源的超声基座大模型聆音EchoCare是中国科学院香港创新研究院人工智能与机器人创新中心(CAIR)研发的超声基座大模型,基于全球最大的超声影像数据集(超450万张图像)训练而成,覆盖多中心、多地区、多人种及50余个人...最新AI资源1年前085.5K




 简体中文
 English
 日本語
 한국어
 Русский
 Español