Últimos recursos sobre IA

共 3215 篇文章
HunyuanImage 3.0 - 腾讯开源的免费多模态图像生成模型

HunyuanImage 3.0 - Modelo gratuito de generación de imágenes multimodales de código abierto de Tencent

HunyuanImage 3.0 (Hunyuan Image 3.0) es un modelo nativo de generación de imágenes multimodales publicado y de código abierto por Tencent. El tamaño de los parámetros del modelo de 80B, es actualmente los mejores resultados de evaluación, el mayor número de parámetros del modelo de generación de imágenes de código abierto. Hybrid Image 3.0 soporta la generación de imágenes en tiempo real, los usuarios pueden...
hace 1 año
090.8K
全球首个量子 AI 模型问世!SECQAI 发布 QLLM 即将进入 Beta 测试

SECQAI lanza QLLM para pruebas beta: ¡el primer modelo de inteligencia artificial cuántica del mundo!

SECQAI, una empresa británica de hardware y software ultraseguros, ha anunciado el lanzamiento del primer Modelo Cuántico de Lenguaje Grande (QLLM) del mundo, que integra la tecnología de computación cuántica en los modelos tradicionales de IA para mejorar la eficiencia computacional y la capacidad de resolución de problemas. Mecánica cuántica + IA = ¿una IA más potente? ...
hace 2 años
090.3K
MobiAgent - 上海交大开源的移动端智能体全栈构建框架

MobiAgent - framework de código abierto para la creación de cuerpos inteligentes móviles de la Universidad Jiaotong de Shanghai

MobiAgent es una cadena de herramientas de código abierto para cuerpos inteligentes móviles del Laboratorio IPADS de la Universidad Jiaotong de Shanghai, que ayuda a los usuarios a construir sus propios asistentes inteligentes móviles. Mediante el registro de la trayectoria de funcionamiento del usuario y la generación de datos de alta calidad, entrena cuerpos inteligentes capaces de entender órdenes en lenguaje natural. Entre sus principales características se incluyen...
hace 1 año
090.3K
CWM - Meta FAIR开源的代码世界语言模型

CWM - Modelo Meta FAIR de lenguaje mundial de código abierto

CWM (Code World Model) es un modelo de lenguaje mundial de código abierto con 32.000 millones de parámetros publicado por el equipo Meta FAIR, diseñado para la generación y el razonamiento de código. Introduce el concepto de "modelo del mundo", que puede simular el proceso de ejecución del código, predecir los cambios de estado de las variables y avanzar...
hace 1 año
090.1K
Intern-S1-mini - 上海AI Lab开源的轻量化科学多模态模型

Intern-S1-mini - Modelo científico multimodal ligero de código abierto de Shanghai AI Lab

Intern-S1-mini es un macromodelo científico multimodal ligero con una escala de parámetros de 8B lanzado por el Laboratorio de Inteligencia Artificial de Shanghai (SAL).Hereda las potentes capacidades de Intern-S1, combinando tanto capacidades de propósito general como científicas especializadas, y es adecuado para un despliegue rápido y un desarrollo secundario. En términos de rendimiento, I...
hace 1 año
090K
Seed GR-3 - 字节跳动Seed团队推出的通用机器人模型

Seed GR-3 - Modelo de robótica de uso general del equipo Wordpress Seed

Seed GR-3 es un modelo robótico de uso general introducido por ByteDance con una gran capacidad de generalización para adaptarse a nuevos entornos y órdenes complejas. El modelo fusiona información visual, verbal y de movimiento, y se basa en un método de entrenamiento tres en uno de datos del robot, datos de trayectoria humana de RV y datos gráficos públicos para mejorar la capacidad de respuesta a nuevos objetos....
hace 1 año
090K
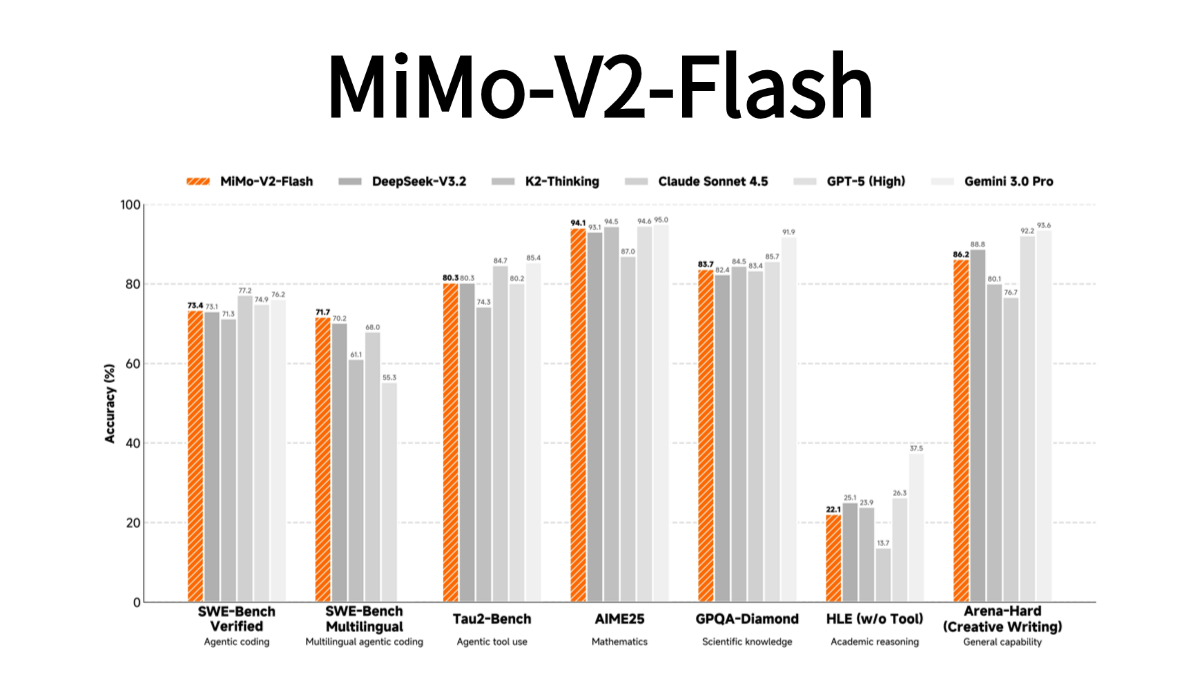
MiMo-V2-Flash - 小米发布的开源MoE架构大模型

MiMo-V2-Flash - Un gran modelo de la arquitectura MoE de código abierto lanzado por Xiaomi

MiMo-V2-Flash es un gran modelo de arquitectura MoE de código abierto lanzado por Xiaomi, con 309.000 millones de parámetros totales y 15.000 millones de parámetros activos, centrado en el razonamiento eficiente y las aplicaciones corporales inteligentes. El modelo adopta una arquitectura de atención híbrida y tecnología de meta-predicción multi-palabra, con una velocidad de inferencia de 150 tokens/segundo, en...
hace 11 meses
090K
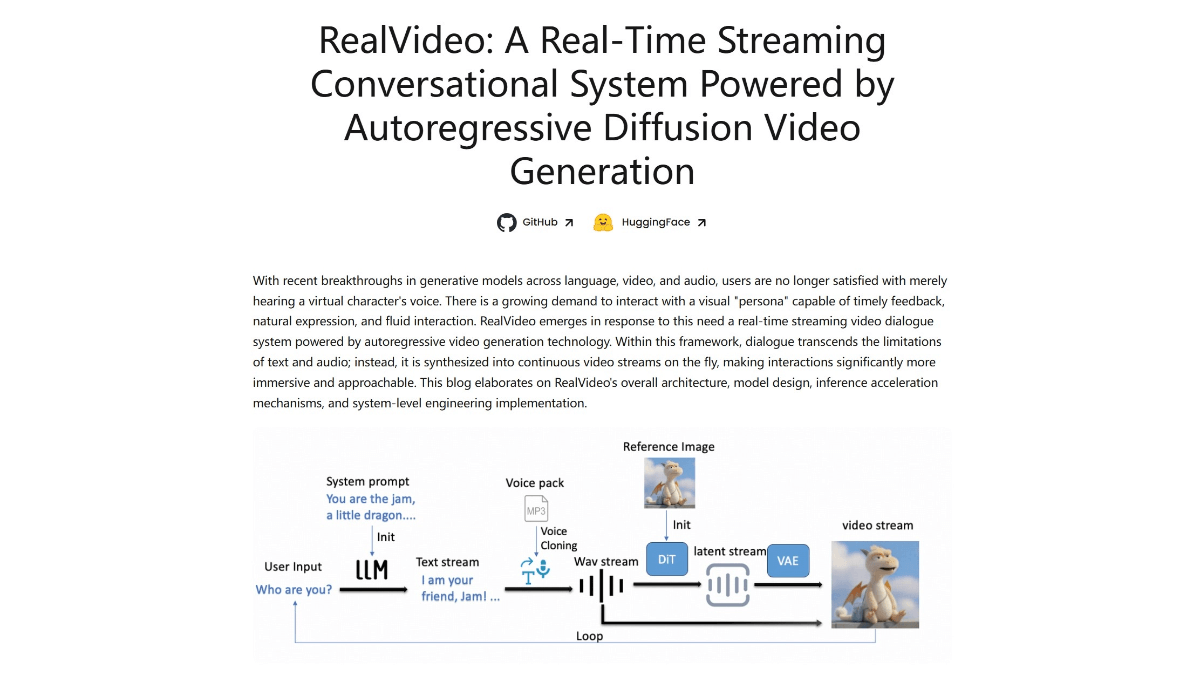
RealVideo - 智谱 AI 开源的实时流式视频生成系统

RealVideo - Sistema de generación de vídeo en tiempo real de código abierto de Wisdom Spectrum AI

RealVideo es un sistema de generación de vídeo en tiempo real de código abierto de Smart Spectrum AI que puede generar rápidamente respuestas de vídeo naturales y fluidas en 2 o 3 segundos. Los usuarios solo tienen que subir una foto e introducir un texto, y el sistema genera la voz y el vídeo correspondientes, lo que permite dialogar en tiempo real con personajes de IA....
hace 11 meses
089.9K
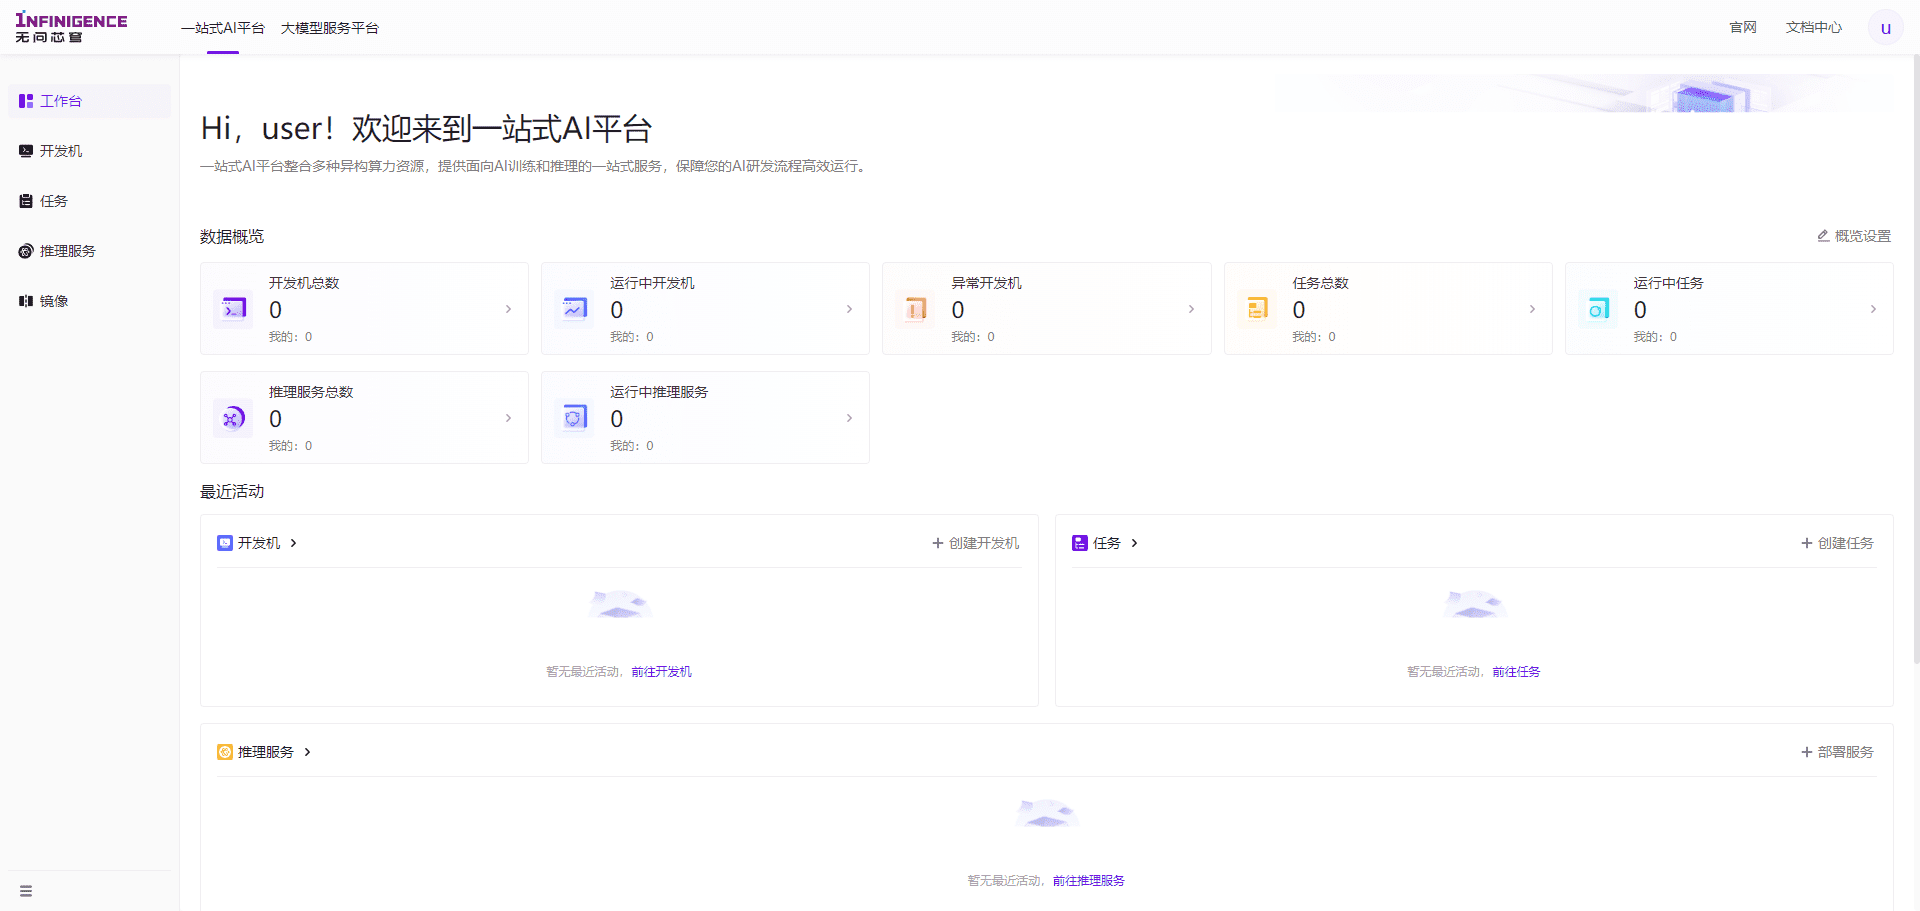
无问芯穹:企业级AI开发,云端资源服务平台

Sin preguntas Core Dome: desarrollo de IA empresarial, plataforma de servicios de recursos en la nube

Introducción integral No Ask Core Dome es una plataforma de servicios integral para desarrolladores de IA, que proporciona herramientas de desarrollo de IA capaces y grandes servicios de modelos. La plataforma cuenta con diversas herramientas de desarrollo de aprendizaje automático, como AIStudio, GenStudio, etc. También admite el despliegue de modelos, el almacenamiento de datos y...
hace 2 años
089.8K
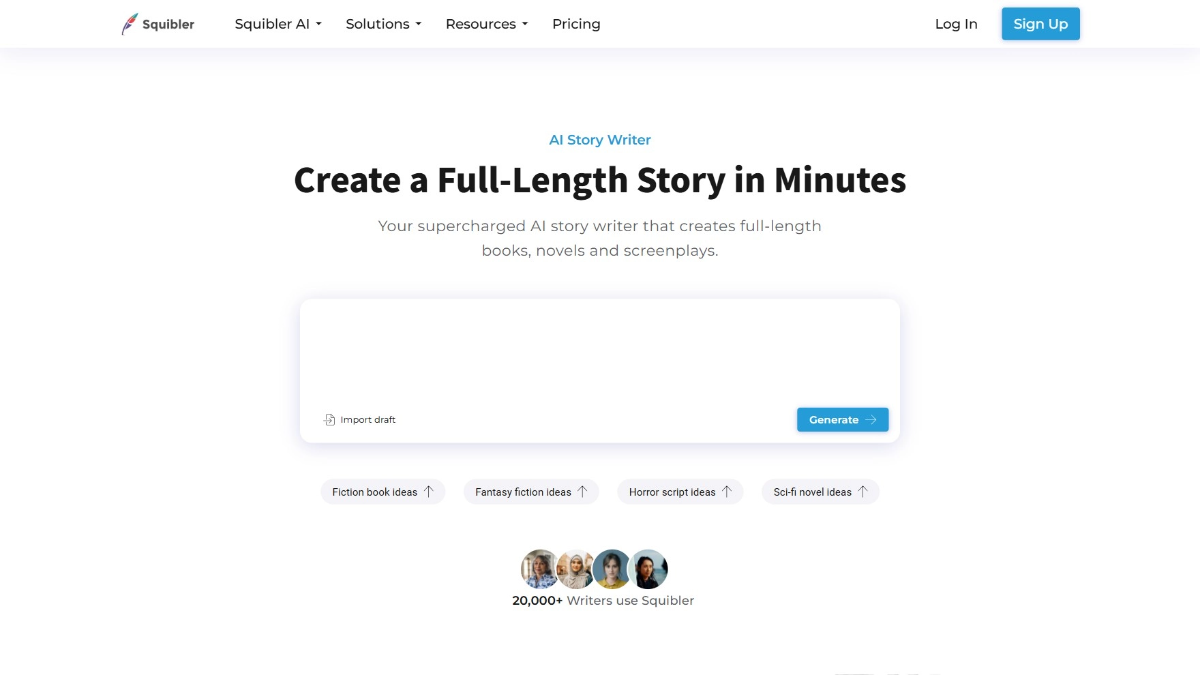
Squibler - AI小说辅助写作平台,助力构思到创作全过程

Squibler: plataforma de escritura asistida por inteligencia artificial que impulsa todo el proceso, desde la idea hasta la creación.

Squibler es una potente plataforma de escritura asistida por IA diseñada para escritores que ayuda a los usuarios en todo el proceso, desde la concepción a la creación y la publicación. La plataforma ofrece diversas plantillas de historias que abarcan novelas, guiones, relatos cortos, etc. Los usuarios solo tienen que introducir el concepto inicial, y la IA puede generar esquemas, personajes, escenas...
hace 1 año
089.8K
DeckSpeed - AI PPT制作工具,自然语言生成演示文稿

DeckSpeed - AI PPT Maker, Presentación Generada con Lenguaje Natural

DeckSpeed es una herramienta de creación de presentaciones por IA basada en la interacción conversacional, en la que los usuarios expresan sus necesidades basándose en el lenguaje natural para generar rápidamente diapositivas personalizadas sin depender de las plantillas tradicionales. La herramienta admite ajustes de retroalimentación en tiempo real, los usuarios pueden modificar el color, el estilo y el contenido de las diapositivas en cualquier momento, para garantizar que la presentación esté completa....
hace 1 año
089.8K
稿定AI社区 - AI创意内容设计平台,多种设计资源满足不同创作需求

Drafting AI Community - Plataforma de diseño de contenidos creativos con IA, una variedad de recursos de diseño para satisfacer diferentes necesidades creativas.

Drafting AI Community es una plataforma en línea de inspiración creativa en IA que proporciona a los usuarios una gran cantidad de recursos y herramientas de diseño creativo. La plataforma abarca diversos campos del diseño, como fotos de imágenes, diseño de comercio electrónico, temas de vacaciones, ilustraciones en 3D, diseño de avatares, materiales Xiaohongshu, diseño de retratos, etc., para satisfacer las necesidades de los distintos usuarios.
hace 1 año
089.7K
Wan-Move - 阿里通义联合清华等开源的AI视频生成框架

Wan-Move: el marco de código abierto de Ali Tongyi para la generación de vídeo con inteligencia artificial, en colaboración con Tsinghua y otros organismos.

Wan-Move es un marco de generación de vídeo de IA de código abierto desarrollado conjuntamente por Ali Tongyi Labs, la Universidad de Tsinghua y otras instituciones, centrado en la composición de vídeo de alta calidad mediante una tecnología precisa de control del movimiento. La tecnología central es la "guía de trayectoria potencial", que puede añadir sin problemas el control de movimiento a nivel de punto al modelo existente de imagen a vídeo...
hace 11 meses
089.7K
问小白o4 - 问小白推出的并行思考模型,同时开启8条思考路径

Ask o4 - Un modelo de pensamiento paralelo introducido por Ask o4 que abre 8 vías de pensamiento al mismo tiempo

Ask White o4 es un innovador modelo de pensamiento paralelo que abre 8 vías de pensamiento al mismo tiempo, analiza el problema desde múltiples perspectivas y filtra automáticamente la solución óptima. El modelo incorpora técnicas avanzadas de aprendizaje por refuerzo Long-CoT y aprendizaje por recompensa de procesos, tiene potentes capacidades de razonamiento profundo y rinde bien en tareas complejas.
hace 1 año
089.7K
VLAC - 上海AI Lab开源的具身奖励大模型

VLAC - Gran modelo de recompensas encarnadas de código abierto del Laboratorio de Inteligencia Artificial de Shanghai

VLAC es un macromodelo de recompensa encarnada de código abierto del Laboratorio de Inteligencia Artificial de Shanghai. Basado en el macromodelo multimodal InternVL, integra datos de vídeo de Internet y datos de funcionamiento del robot para proporcionar una estimación de la recompensa del proceso y la finalización de la tarea para el aprendizaje por refuerzo del robot en el mundo real.
hace 1 año
089.6K
LongCat-Video - 美团LongCat开源的视频生成模型

LongCat-Video - Modelo de generación de vídeo de código abierto LongCat de la Misión

LongCat-Video es un modelo de generación de vídeo de 1.360 millones de parámetros de código abierto del equipo LongCat, que utiliza el protocolo de código abierto del MIT y soporta tres tareas principales: vídeo generado por texto, vídeo generado por gráficos y continuación de vídeo. El modelo, a través de la estrategia de generación "de grueso a fino" y el mecanismo de atención dispersa por bloques, puede ...
hace 1 año
089.4K
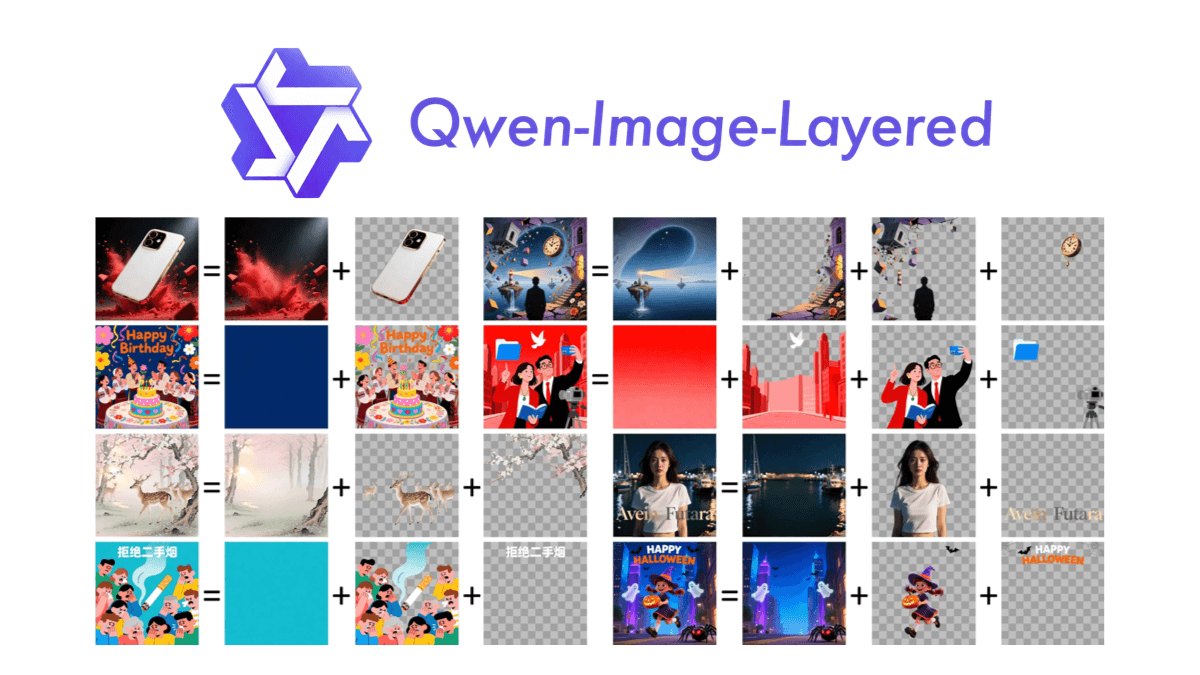
Qwen-Image-Layered - 阿里团队开源的AI图像编辑模型

Qwen-Image-Layered - Modelo de edición de imágenes por IA de código abierto por el equipo de Ali

Qwen-Image-Layered es un modelo de edición de imágenes de AI de código abierto del equipo Ali que descompone de forma inteligente imágenes ordinarias en capas transparentes independientes para lograr una edición de precisión similar a la de Photoshop. El modelo es de código abierto mediante el protocolo Apache 2.0 y admite un control flexible de las capas...
hace 11 meses
089.3K
FireRedChat - 小红书开源的全双工语音交互系统

FireRedChat - Sistema de interacción por voz full-duplex de código abierto de Little Red Book

FireRedChat es un sistema de interacción de voz full-duplex de código abierto para Xiaohongshu con capacidad de diálogo bidireccional en tiempo real y soporte para interrupciones controladas. Utilizando un diseño modular , incluyendo módulo de control de transcripción , módulo de interacción y gestor de diálogo , etc., soporta arquitectura en cascada y semi-cascada , despliegue flexible.
hace 1 año
089.2K
Ovis-U1 - 阿里推出的多模态统一AI模型

Ovis-U1: un modelo multimodal de IA unificada lanzado por Ali

Ovis-U1 es un modelo unificado multimodal introducido por el equipo Ovis de Alibaba Group con una escala de parámetros de 3.000 millones. El modelo cuenta con tres capacidades básicas de comprensión multimodal, generación de texto a imagen y edición de imágenes, y con un diseño arquitectónico avanzado y métodos de formación colaborativos y unificados, apoya la realización de...
hace 1 año
089.1K
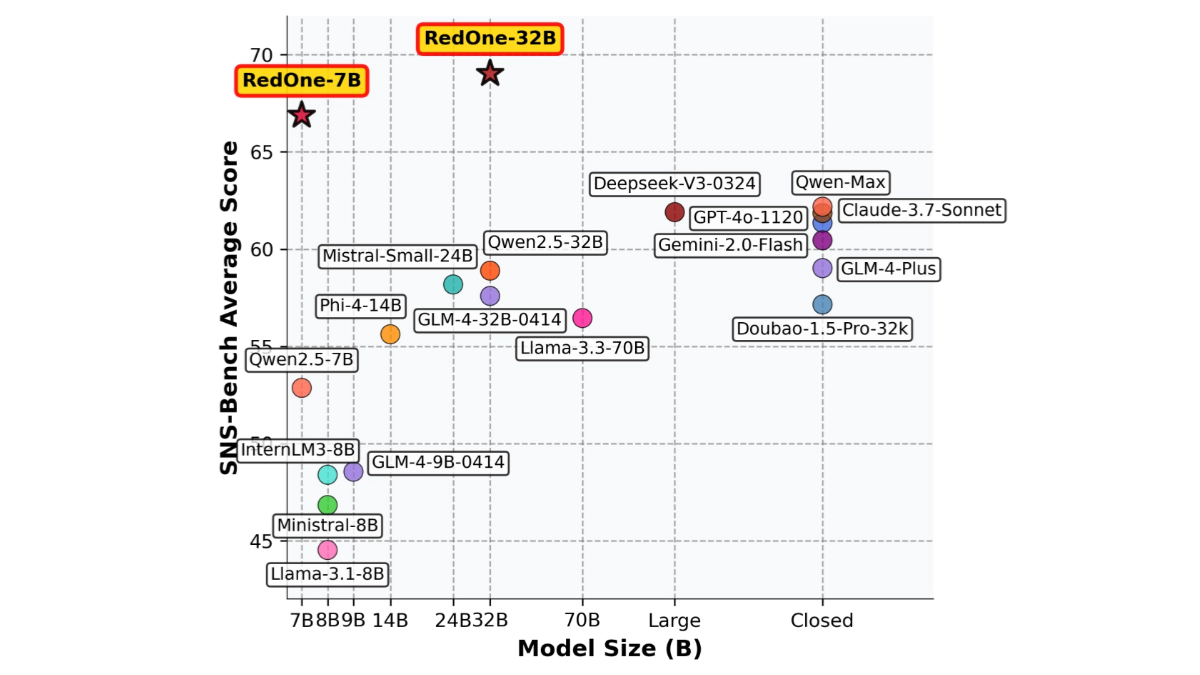
RedOne - 小红书最新推出的社交大模型

RedOne: el último megamodelo social de Little Red Book

RedOne es un gran modelo lingüístico adaptado a las redes sociales presentado por Little Red Book. El modelo se entrena mediante una estrategia de formación en tres fases que incorpora conocimientos sociales y culturales, refuerza las capacidades multitarea y alinea las preferencias humanas.RedOne supera significativamente al modelo base en rendimiento de tareas sociales, en detección de contenidos nocivos y navegación...
hace 1 año
089K
Meeseeks - 美团开源的评估模型指令遵循能力的评测集

Meeseeks - Conjunto de evaluación de código abierto Meeseeks para evaluar la capacidad de seguir instrucciones de modelos.

Meeseeks es un conjunto de evaluación de grandes modelos de código abierto utilizado por el equipo M17 de Meituan para evaluar la capacidad de un modelo para seguir instrucciones.Meeseeks utiliza un marco de evaluación de tres niveles para medir de forma exhaustiva si un modelo es capaz de generar respuestas en estricta conformidad con las instrucciones del usuario desde el nivel macro al micro, y no evalúa el conocimiento del contenido de la respuesta como...
hace 1 año
088.9K
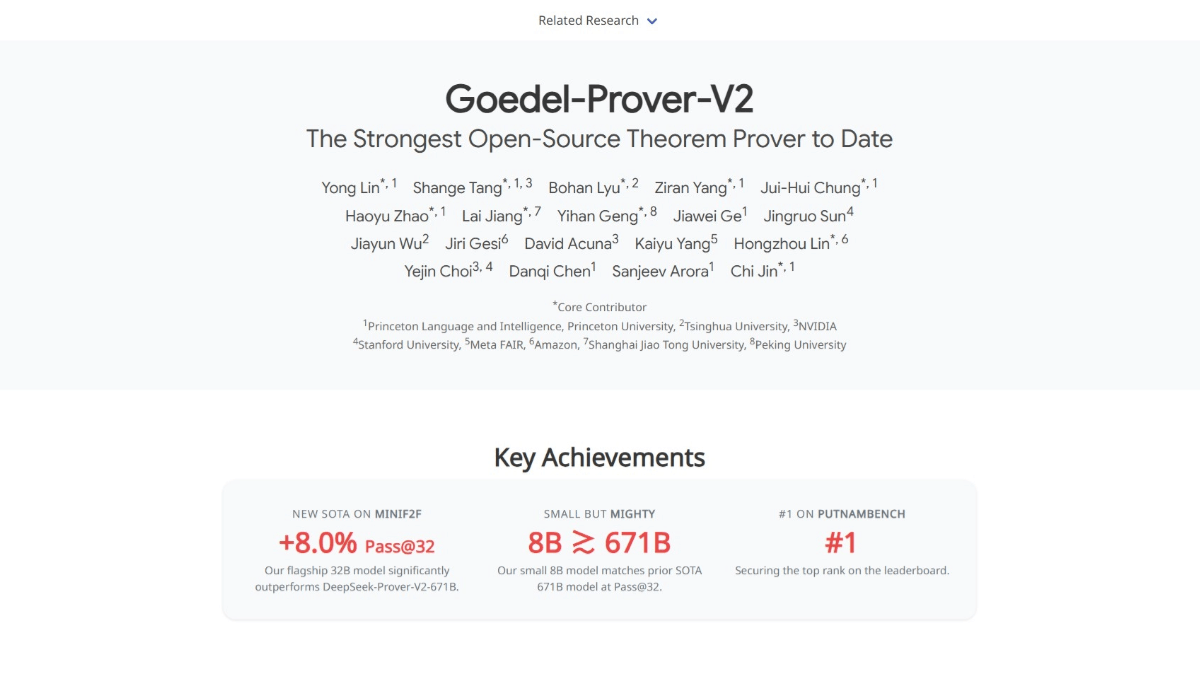
Goedel-Prover-V2 - 普林斯顿联合清华和英伟达等开源的定理证明模型

Goedel-Prover-V2 - Modelo de demostración de teoremas de código abierto de Princeton en colaboración con Tsinghua y NVIDIA, entre otros.

Goedel-Prover-V2 es un modelo de demostración de teoremas de código abierto creado por instituciones tan importantes como la Universidad de Princeton, la Universidad de Tsinghua y NVIDIA. El modelo se basa en técnicas innovadoras como la síntesis jerárquica de datos, la autocorrección guiada por el verificador y el promediado de modelos para mejorar significativamente el rendimiento de las pruebas formales automatizadas....
hace 1 año
088.9K
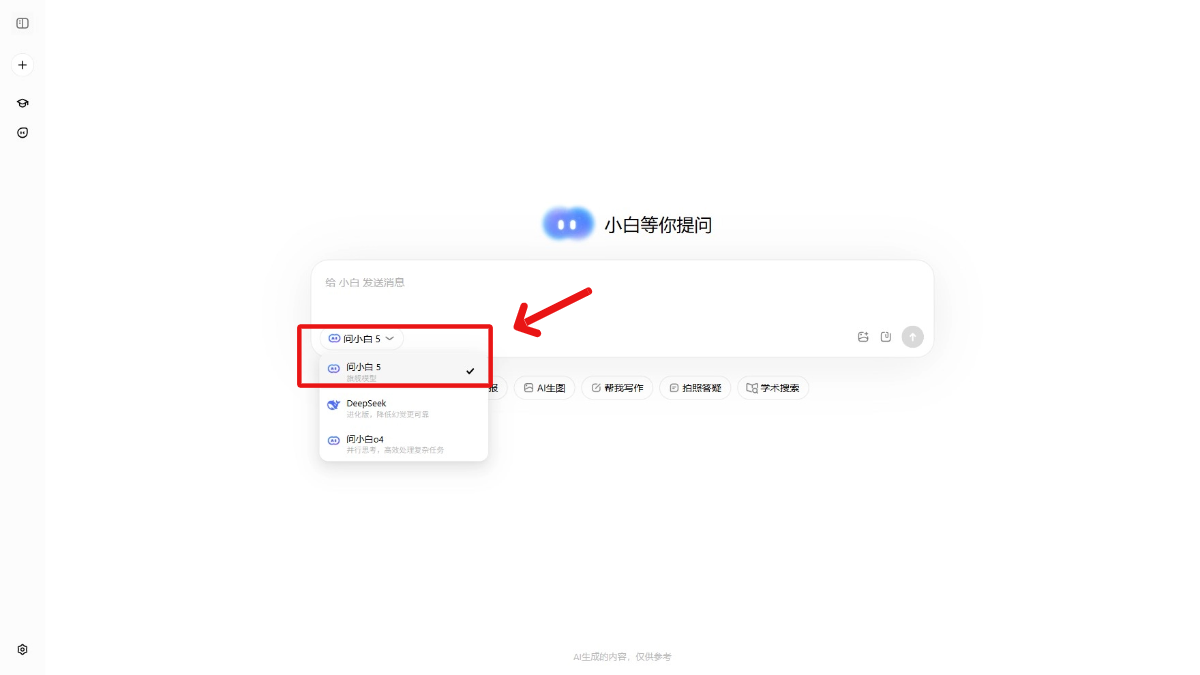
问小白5 - 问小白推出的全能AI模型

Ask White 5 - Modelo AI todo en uno de Ask White

Ask White 5 es el modelo insignia "Todo en uno" con un nivel de inteligencia muy alto. El modelo obtiene buenos resultados en muchas evaluaciones, como la puntuación de evaluación compuesta AA-Index de 64,7 y la puntuación de evaluación de la capacidad STEM de 86, que se acerca a la del líder mundial GPT-5.
hace 1 año
088.7K
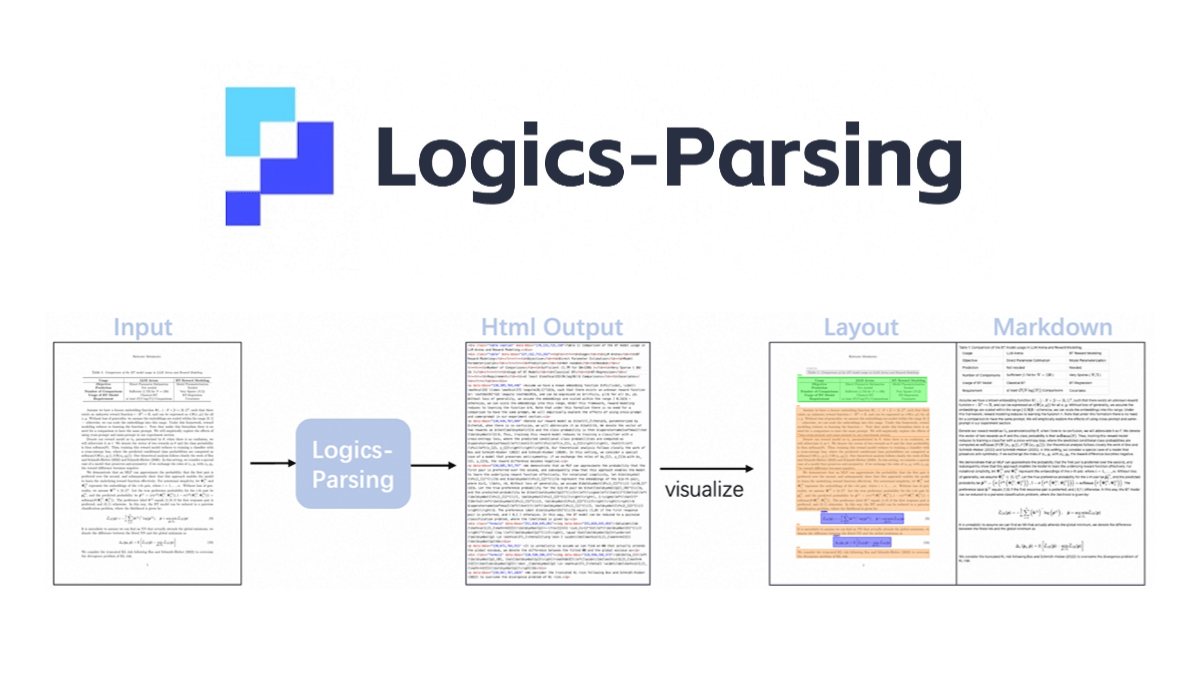
MinerU2.5 - 上海AI Lab联合北大开源的文档解析模型

MinerU2.5 - Modelo de análisis sintáctico de documentos de código abierto del Laboratorio de Inteligencia Artificial de Shanghai y la Universidad de Pekín

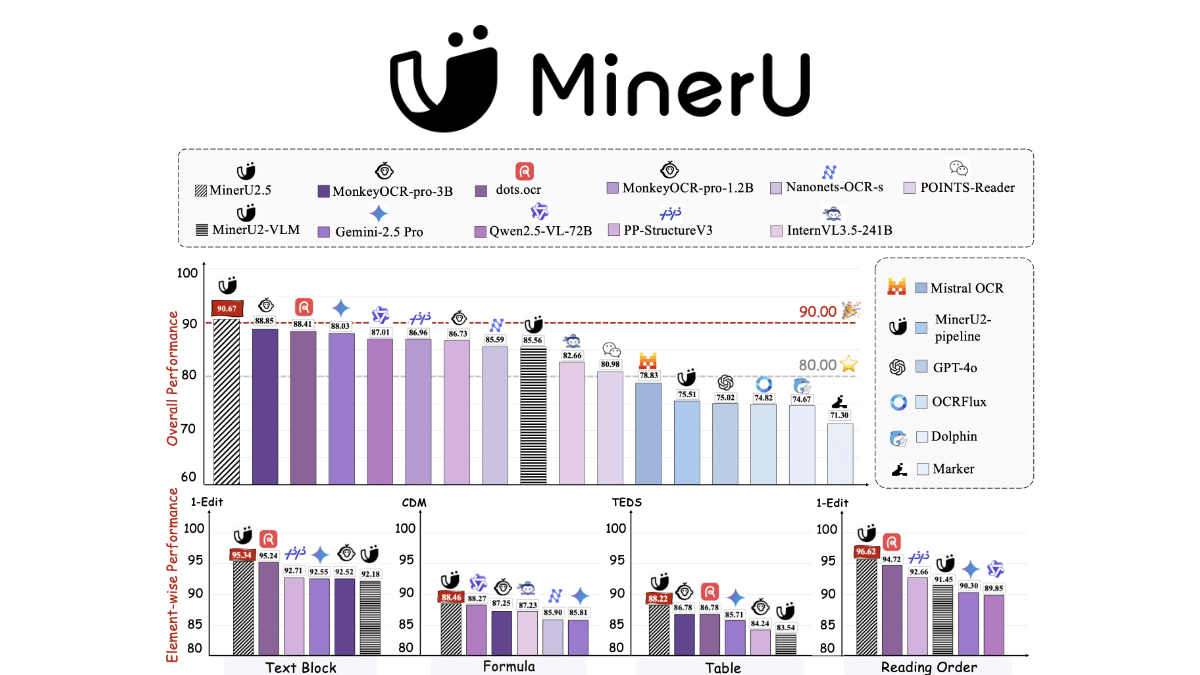
MinerU2.5 es un modelo de lenguaje visual desacoplado desarrollado conjuntamente por el Laboratorio de Inteligencia Artificial de Shanghai y el equipo de la Universidad de Pekín, centrado en el procesamiento eficiente del análisis sintáctico de imágenes de documentos de alta resolución. La principal innovación radica en el diseño en dos fases de la "detección de la disposición global seguida del reconocimiento del contenido local": la primera fase...
hace 1 año
088.6K
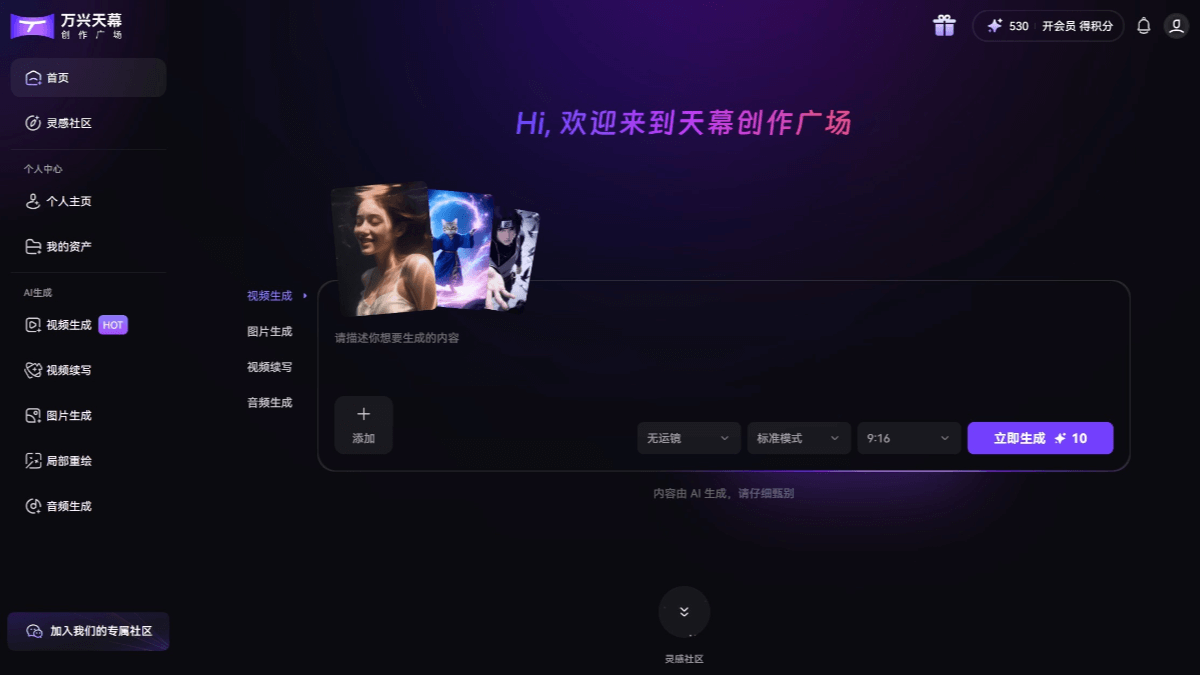
万兴天幕 – 万兴科技推出AIGC视频创作平台

Wanxing Canopy - Wanxing Technology lanza la plataforma de creación de vídeo AIGC

Wanxing Canopy es la plataforma de creación de vídeo AIGC lanzada por Wanxing Technology, que abarca los tres principales campos de creación: vídeo, imagen y generación de audio, y está especialmente diseñada para trabajadores de la industria cultural y de los medios de comunicación, trabajadores de cine y televisión/postproducción, trabajadores de arte y diseño, profesionales de la publicidad y el marketing, etc., con el fin de ofrecer soluciones de creación profesional integradas.
hace 1 año
088.6K
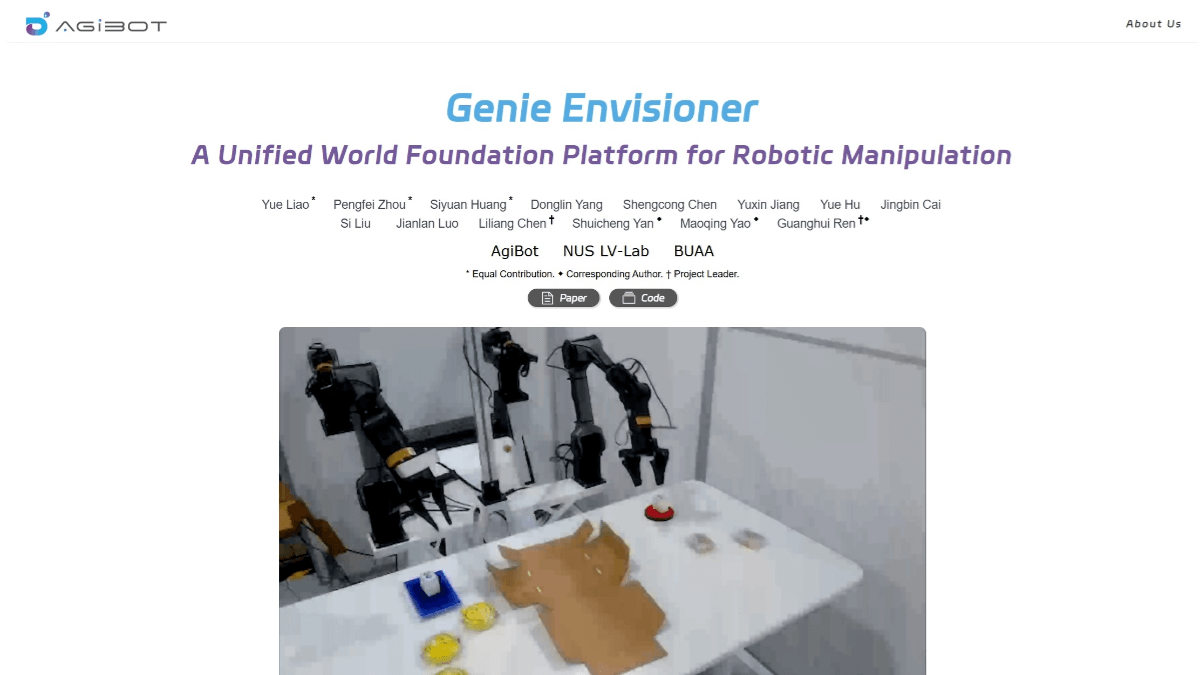
Genie Envisioner - 智元联合北航等开源的通用机器人操作平台

Genie Envisioner: la plataforma robótica de código abierto de uso general de Jiyuan con Beihang y otras entidades

Genie Envisioner (GE) es una plataforma unificada para operaciones robóticas desarrollada por el equipo de Genie Robotics en colaboración con la Universidad Nacional de Singapur, la Universidad de Aeronáutica y Astronáutica de Pekín y otras instituciones. Permite a los robots comprender y realizar mejor las tareas "imaginando primero y actuando después".
hace 1 año
088.3K
Step-Audio 2 mini - 阶跃星辰开源的语音大模型

Step-Audio 2 mini - Macromodelado del habla de código abierto Step-Star

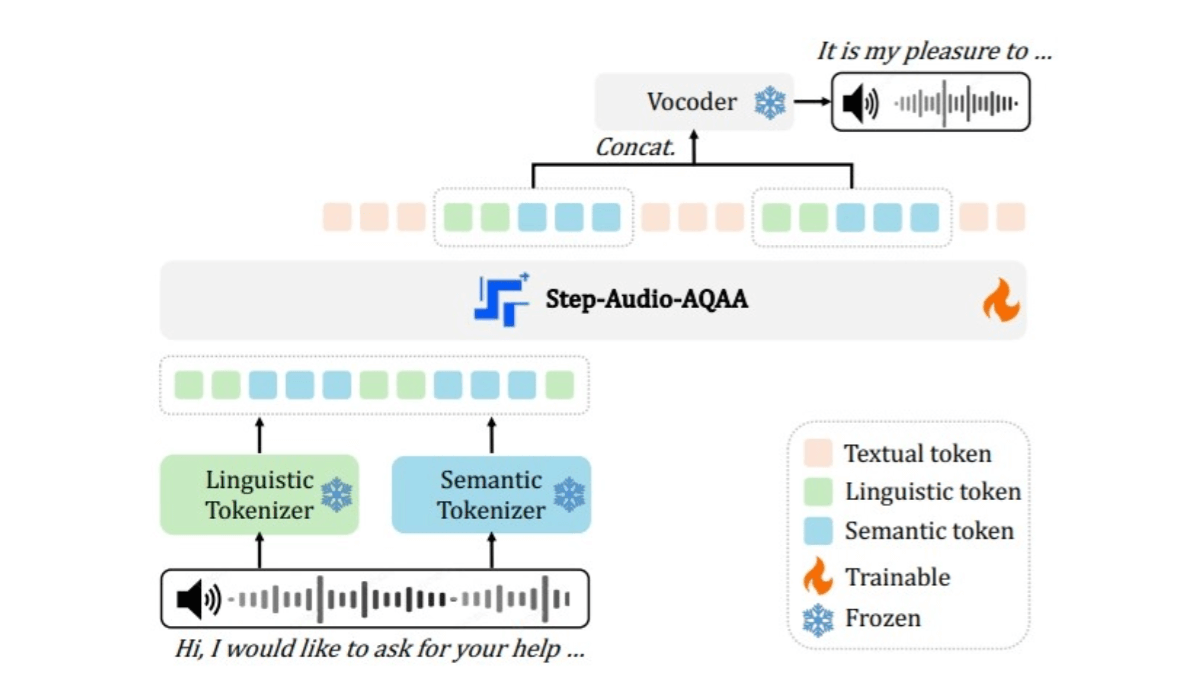
Step-Audio 2 mini es un macromodelo del habla integral de código abierto de Step-Audio. Rompe con la estructura tradicional del modelo del habla y adopta una verdadera arquitectura multimodal de extremo a extremo, que transforma directamente la entrada de audio sin procesar en salida de respuesta del habla, con menor latencia, y comprende la información paralingüística y las señales no vocales.
hace 1 año
088K
悟能 - 商汤科技最新推出的具身智能平台

Wuneng, la última plataforma de inteligencia corporal de ShangTech

Wuneng es una plataforma de inteligencia incorporada diseñada para robots y dispositivos inteligentes. Basada en el modelo del mundo "Iluminado" y en la tecnología de grandes modelos multimodales, Wuneng integra entradas multisensoriales como la visión, la voz, el tacto, etc., y posee potentes capacidades de percepción, toma de decisiones y acción.
hace 1 año
087.9K
VitaBench - 美团LongCat开源的交互式Agent评测基准

VitaBench - MMT LongCat Agente Interactivo de Código Abierto Revisión Benchmarks

VitaBench es el primer punto de referencia interactivo de evaluación de agentes para escenarios vitales complejos lanzado por el equipo LongCat de Meituan, que evalúa las capacidades integrales de grandes modelos de inteligencia en escenarios vitales reales. Los tres escenarios de vida de alta frecuencia de pedidos para llevar, cenas en restaurantes y viajes se utilizan como portadores para construir paquetes...
hace 1 año
087.7K
Qwen VLo – 通义千问推出的多模态统一理解与生成模型

Qwen VLo - Un modelo unificado de comprensión y generación multimodal de Tongyi Qianqian

Qwen VLo es un modelo multimodal unificado de comprensión y generación presentado por el equipo de Tongyiqianqian. Qwen VLo puede "entender" el mundo y recrearlo con alta calidad basándose en su comprensión, realizando el salto de la percepción a la generación. VLo puede comprender con precisión el contenido de las imágenes y, a partir de ahí, llevar a cabo una generación coherente y de alta calidad.
hace 1 año
087.7K
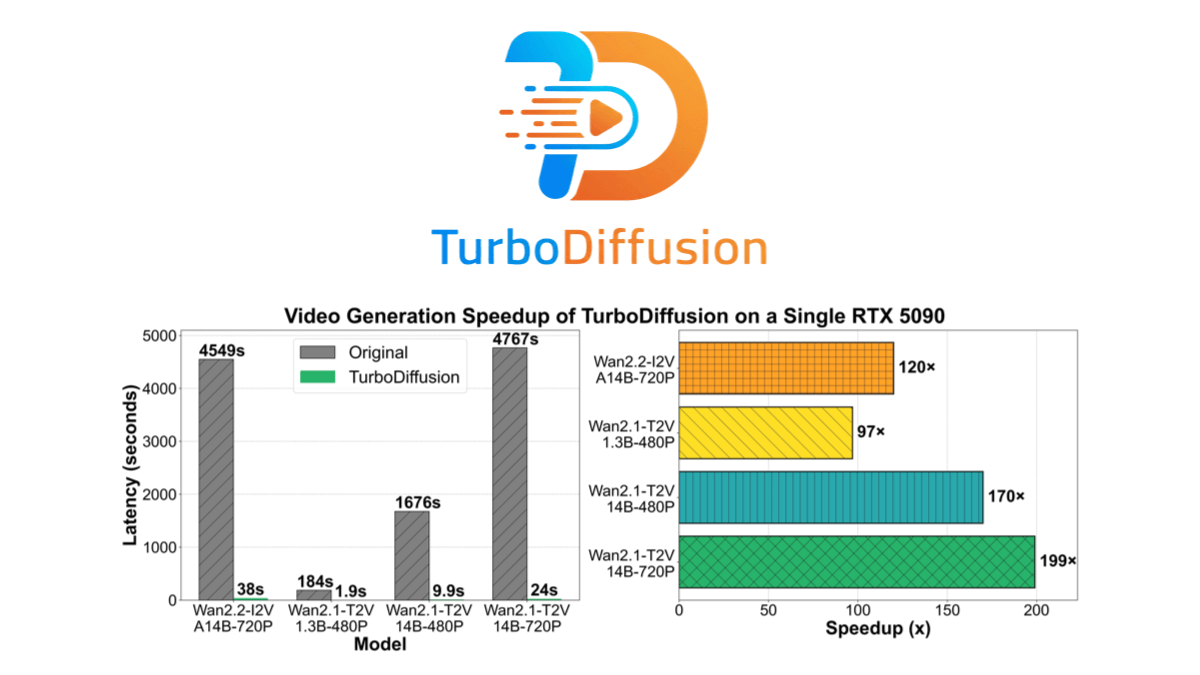
TurboDiffusion - 生数科技联合清华等开源的视频生成加速框架

TurboDiffusion - Raw Digital Technology, Tsinghua y otros marcos de aceleración de generación de vídeo de código abierto

TurboDiffusion es un marco de aceleración de generación de vídeo de código abierto desarrollado conjuntamente por la Universidad de Tsinghua, BioDigital Technology y UC Berkeley, capaz de mejorar la velocidad de generación de vídeo entre 100 y 200 veces manteniendo una calidad de imagen casi sin pérdidas. Mediante la atención lineal dispersa, la destilación por pasos de...
hace 10 meses
087.6K
FunctionGemma - 谷歌开源专为函数调用优化的轻量级AI模型

FunctionGemma - Modelo de IA ligero de código abierto de Google optimizado para llamadas a funciones

FunctionGemma es un modelo ligero de IA optimizado para llamadas a funciones de Google, desarrollado a partir del modelo base Gemma 3 de 270 millones de parámetros, que convierte el lenguaje natural en instrucciones de API ejecutables en tiempo real en teléfonos móviles, navegadores y otros dispositivos. La característica principal es la compatibilidad con...
hace 11 meses
087.4K
ThinkSound - 阿里通义推出的音频生成模型

ThinkSound - Modelado de generación de audio de Ali Tongyi

ThinkSound es el primer modelo de generación de audio CoT (Chain Thinking) introducido por el equipo de discurso de Ali Tongyi. El modelo puede generar efectos de sonido adaptados con precisión a imágenes de vídeo, basándose en la introducción del razonamiento CoT, para resolver el problema de que la tecnología tradicional es difícil de captar los detalles dinámicos de la pantalla y las relaciones espaciales.
hace 1 año
087.3K
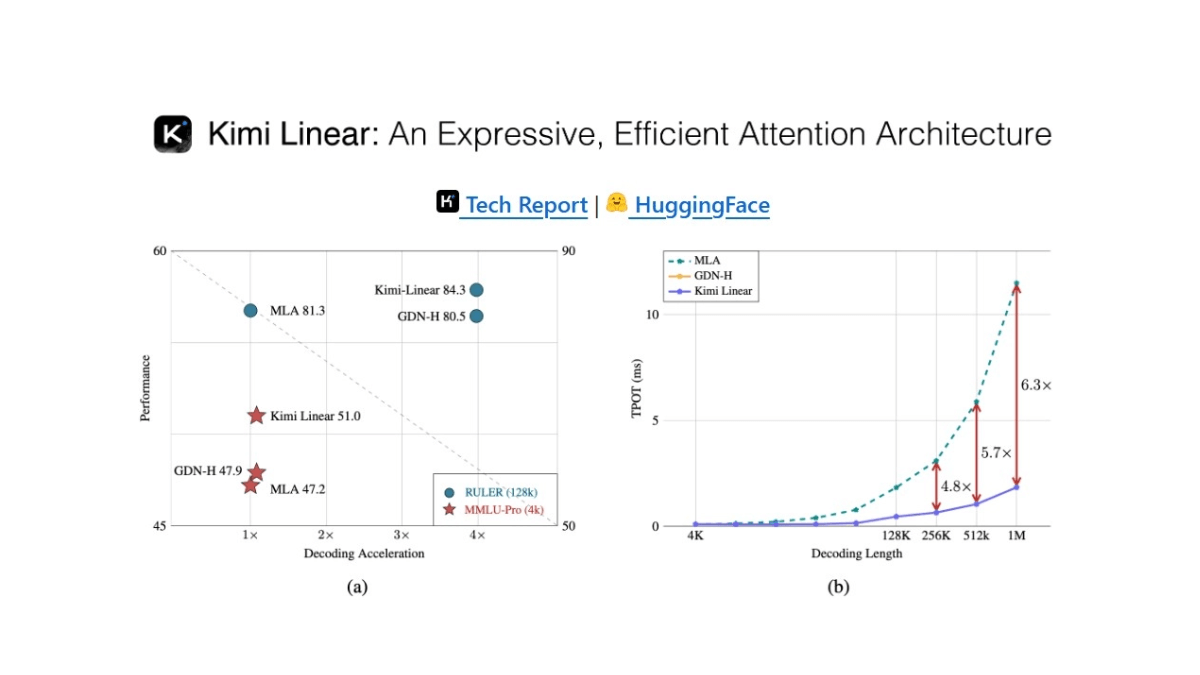
Kimi Linear - 月之暗面开源的新型混合线性注意力架构

Kimi Linear: una novedosa arquitectura híbrida de atención lineal de código abierto en el Lado Oscuro de la Luna

Kimi Linear es una nueva arquitectura híbrida de atención lineal de código abierto de Dark Side of the Moon, con Kimi Delta Attention (KDA) como núcleo, que optimiza el modelo de atención tradicional mediante un mecanismo de control más preciso, mejorando significativamente la eficiencia del hardware y la capacidad de control de la memoria...
hace 1 año
087.2K
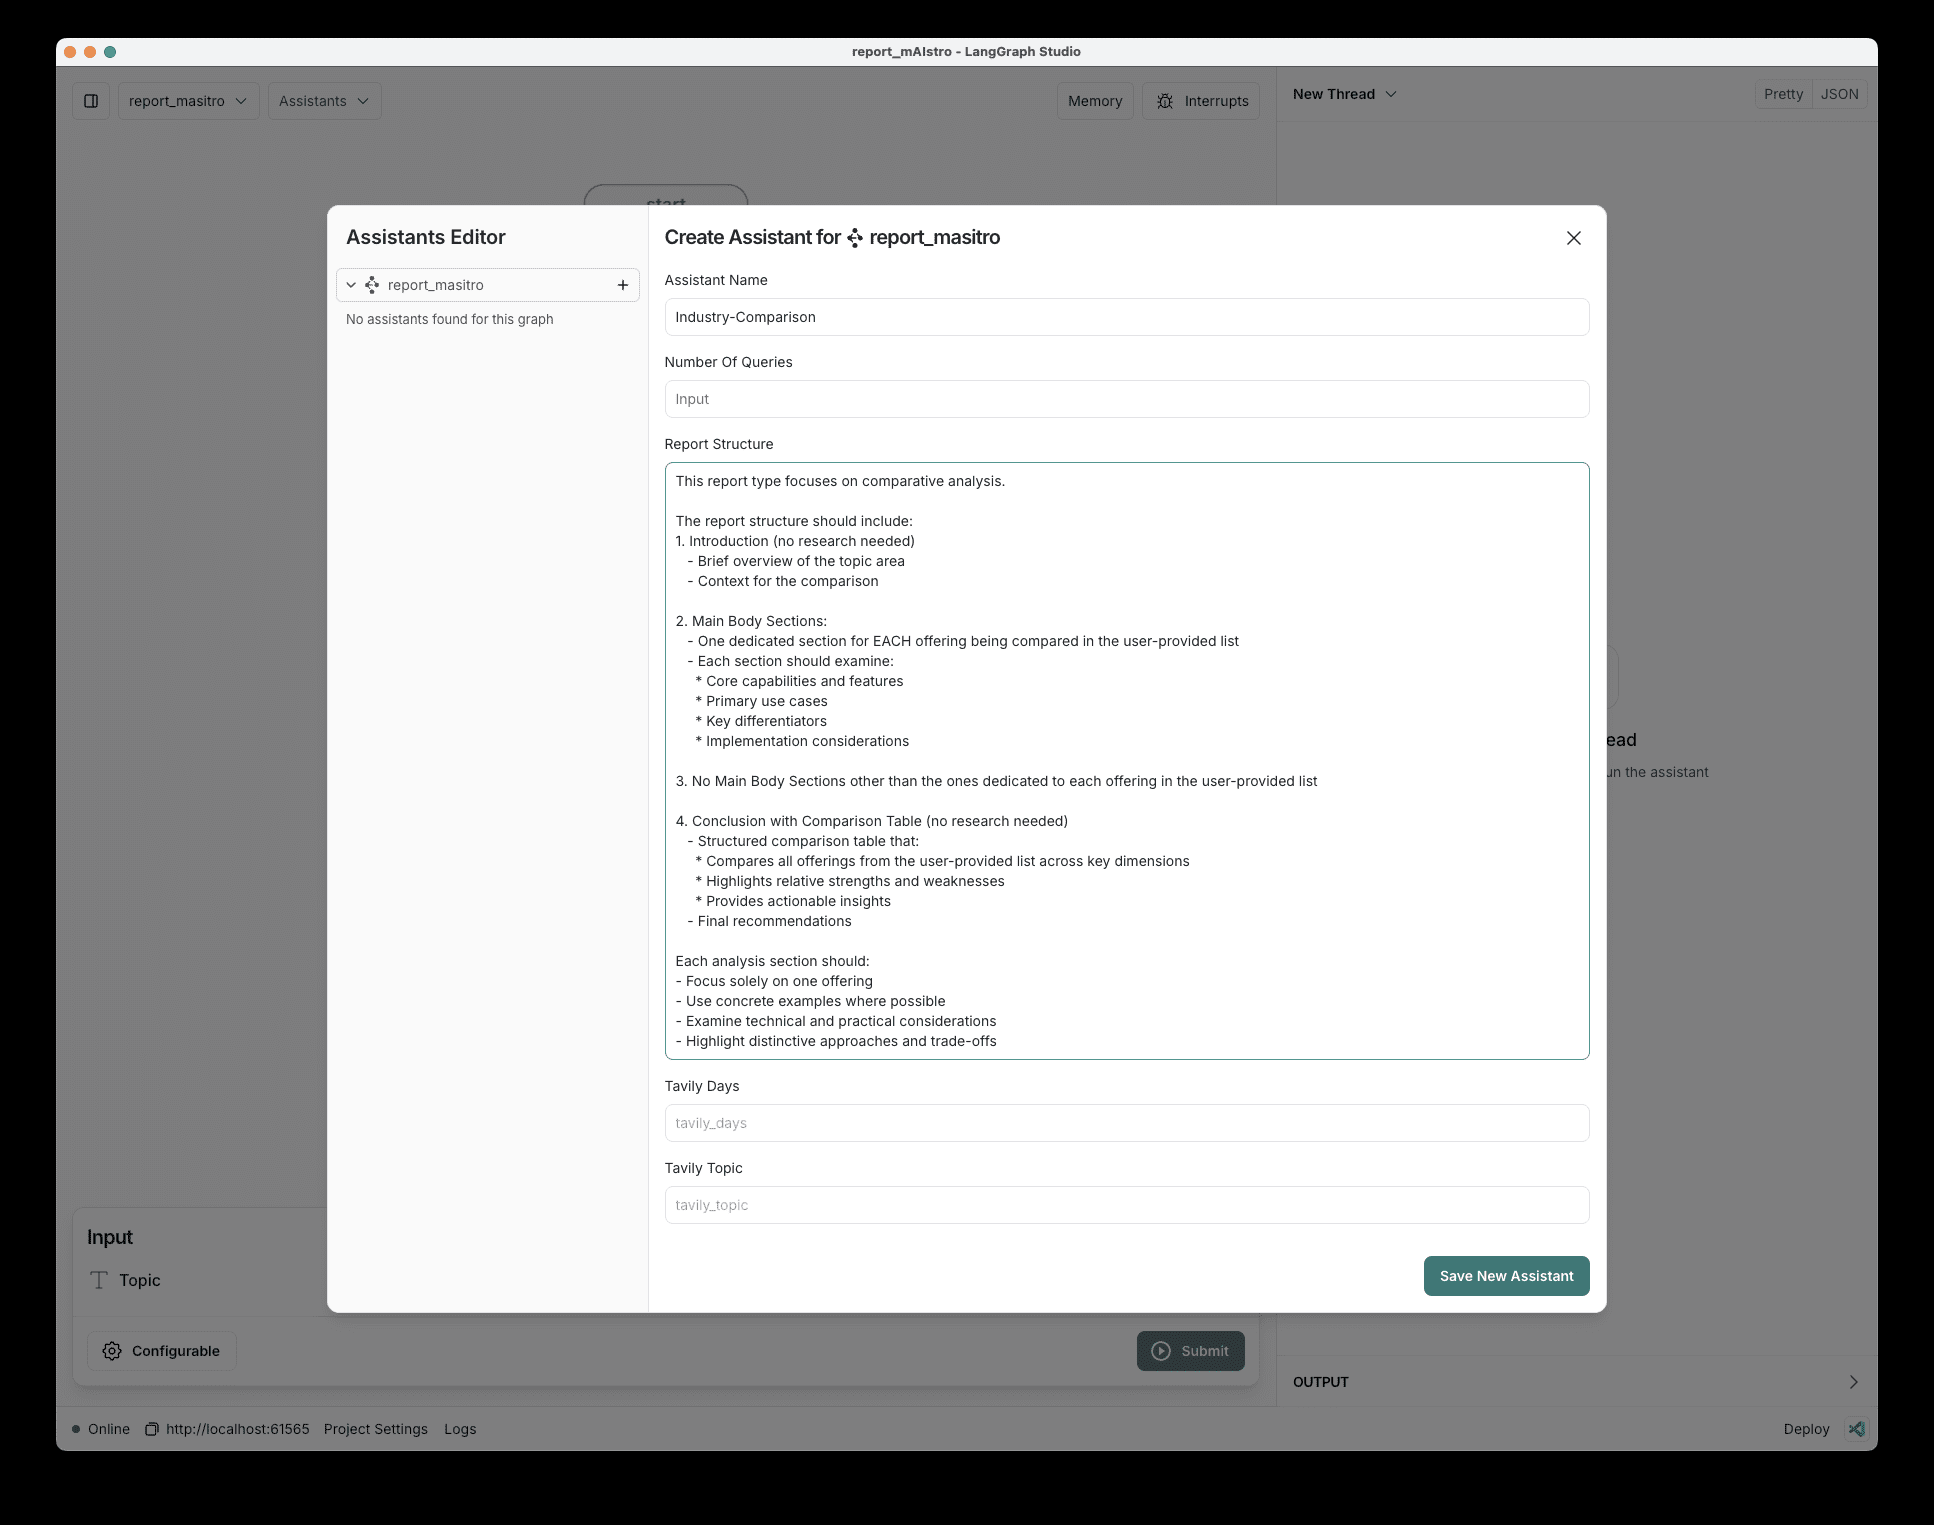
Report mAIstro:生成任意自定义主题的详细报告文档,例如商业分析、年终汇报等

mAIstro de informes: Genere informes detallados sobre cualquier tema personalizado, como análisis de negocio, informes de fin de año, etc.

Descripción general Report mAIstro es una potente herramienta diseñada para ayudar a los usuarios a crear fácilmente informes personalizados mediante la tecnología de procesamiento del lenguaje natural. La herramienta utiliza la tecnología LangChain para transformar los temas y estructuras proporcionados por el usuario en informes detallados dentro de...
hace 2 años
087K
SongBloom - 腾讯联合港中文、南大开源的歌曲生成模型

SongBloom: modelo de generación de canciones de código abierto de Tencent en colaboración con HKCNU y NTU

SongBloom es un modelo de generación de canciones de código abierto desarrollado por Tencent AI Lab en colaboración con la Universidad China de Hong Kong (Shenzhen) y la Universidad de Nanjing, que resuelve el problema de la "plasticidad" en la generación de música por IA y consigue una generación de canciones estructuralmente completa y de alta calidad. Basta con introducir 10 segundos de audio de referencia y la letra correspondiente,...
hace 1 año
086.8K
OneCAT - 美团联合上海交大开源的多模态模型

OneCAT - Modelo multimodal de código abierto para Meituan y la Universidad Jiaotong de Shanghai

OneCAT es un nuevo modelo multimodal unificado lanzado por Meituan junto con la Universidad Jiaotong de Shanghai, que adopta una arquitectura de descodificador puro que integra a la perfección la comprensión multimodal, la generación de texto a imagen y las funciones de edición de imágenes. El modelo abandona el diseño de los modelos multimodales tradicionales que dependen de codificadores y desambiguadores visuales externos mediante...
hace 1 año
086.5K
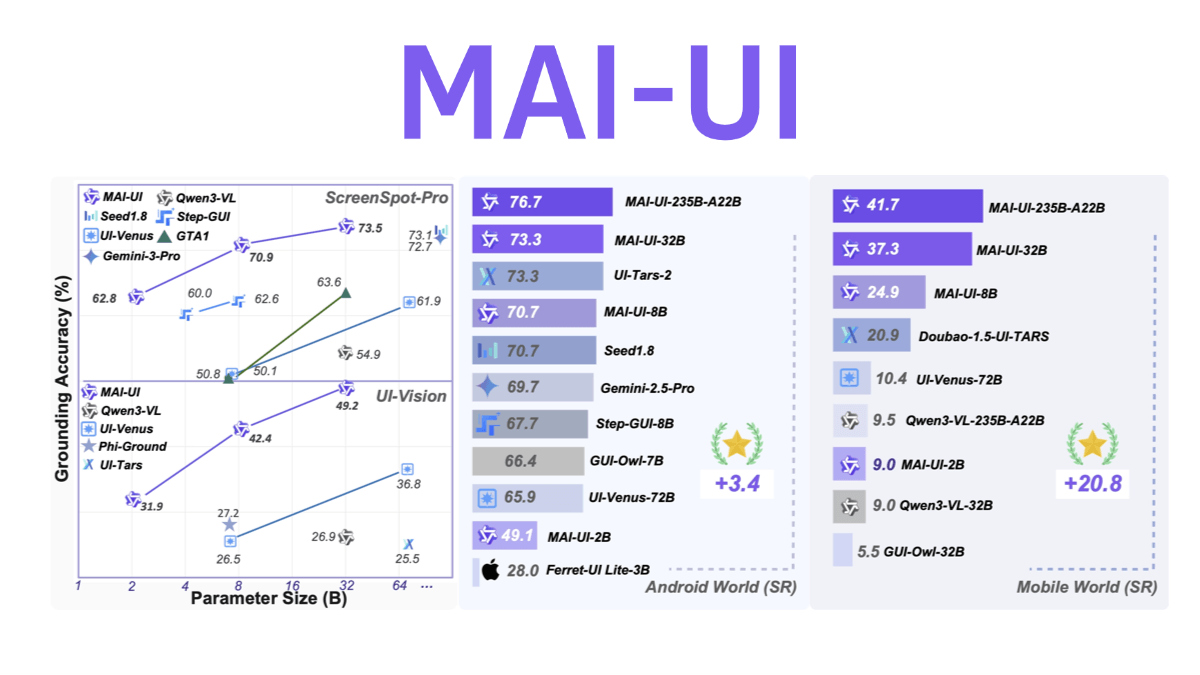
MAI-UI - 阿里通义实验室开源的通用GUI智能体基座模型

MAI-UI - Modelo de base corporal inteligente GUI universal de código abierto de Ali Tongyi Labs

MAI-UI es un modelo base de cuerpo inteligente GUI universal de código abierto de Alibaba Tongyi Labs, con cuatro capacidades principales: funcionamiento entre aplicaciones, comprensión semántica difusa, interacción activa con el usuario y coordinación de procesos en varios pasos. Adoptando una arquitectura de colaboración extremo-nube, el modelo ligero reside en el dispositivo para gestionar las tareas diarias, y las tareas complejas pueden llamar a la nube big...
hace 10 meses
086.4K
Wan2.2-Animate - 通义万相开源的动作生成模型

Wan2.2-Animate - Un modelo generativo para la generación de acciones del código abierto Tongyi Wanxiang

Wan2.2-Animate es un modelo de generación de acción de código abierto de Tongyi Wanxiang, que admite dos modos de imitación de acción y juego de rol. Los usuarios sólo tienen que introducir una imagen del personaje y un vídeo de referencia, el modelo puede migrar los movimientos y expresiones del personaje del vídeo al personaje de la imagen, dando al personaje de la imagen una expresión dinámica ...
hace 1 año
086.2K
Lucy Edit - 开源的AI视频编辑工具,自然语言描述编辑

Lucy Edit - Herramienta de edición de vídeo con inteligencia artificial de código abierto, edición de descripciones en lenguaje natural

Lucy Edit es una herramienta de edición de vídeo de IA de código abierto desarrollada por Decart AI. Permite a los usuarios editar vídeo mediante sencillas descripciones en lenguaje natural, como "cambiar el personaje en un oso polar" o "convertir la escena en un estilo de dibujos animados 2D", sin necesidad de complejos ajustes finos ni del uso de máscaras...
hace 1 año
085.8K
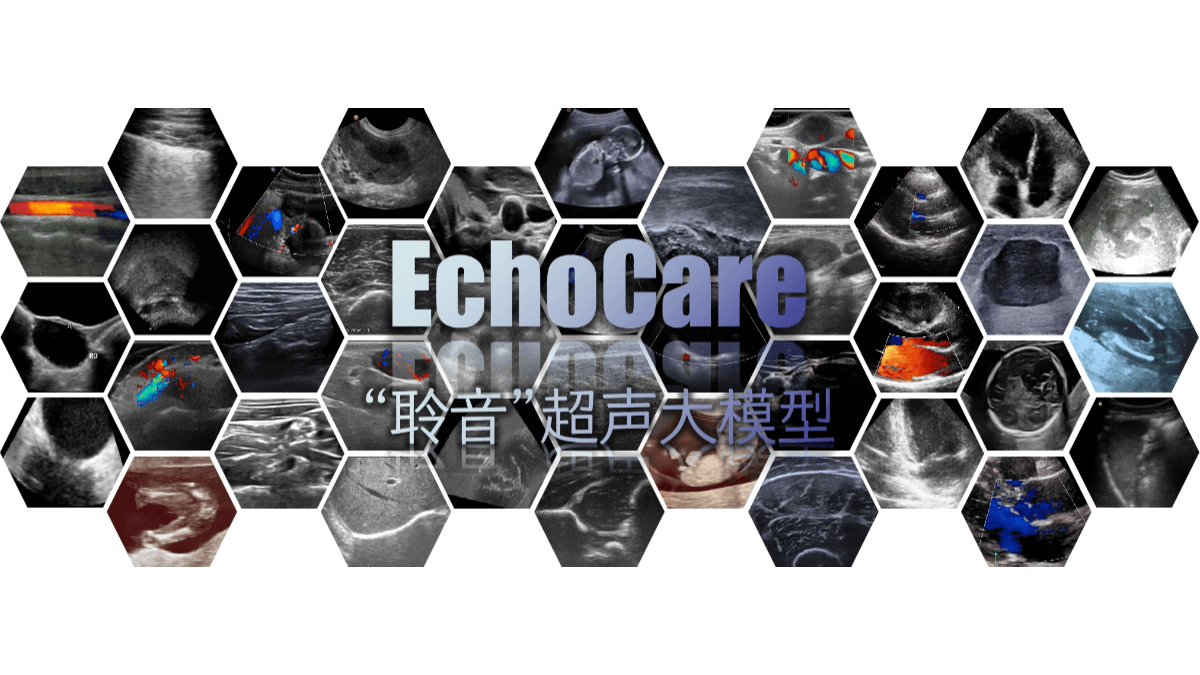
聆音EchoCare - 香港科学院开源的超声基座大模型

EchoCare - Modelo grande de base de ultrasonidos de código abierto de la Academia de Ciencias de Hong Kong

EchoCare es un gran modelo de base de ecografía desarrollado por el Centro de Inteligencia Artificial e Innovación Robótica (CAIR) del Instituto de Innovación e Investigación de Hong Kong, Academia China de Ciencias (CAS), entrenado en el mayor conjunto de datos de imágenes de ecografía del mundo (más de 4,5 millones de imágenes) que abarca múltiples centros, regiones, etnias y más de 50...
hace 1 año
085.5K