스텝오디오 2 미니는 스텝오디오의 오픈 소스 엔드투엔드 음성 매크로 모델입니다. 기존의 음성 모델 구조를 깨고 진정한 엔드투엔드 멀티모달 아키텍처를 채택하여 원시 오디오 입력을 짧은 지연 시간으로 음성 응답 출력으로 직접 변환하고 언어학적 정보 및 비음성 신호를 이해합니다.
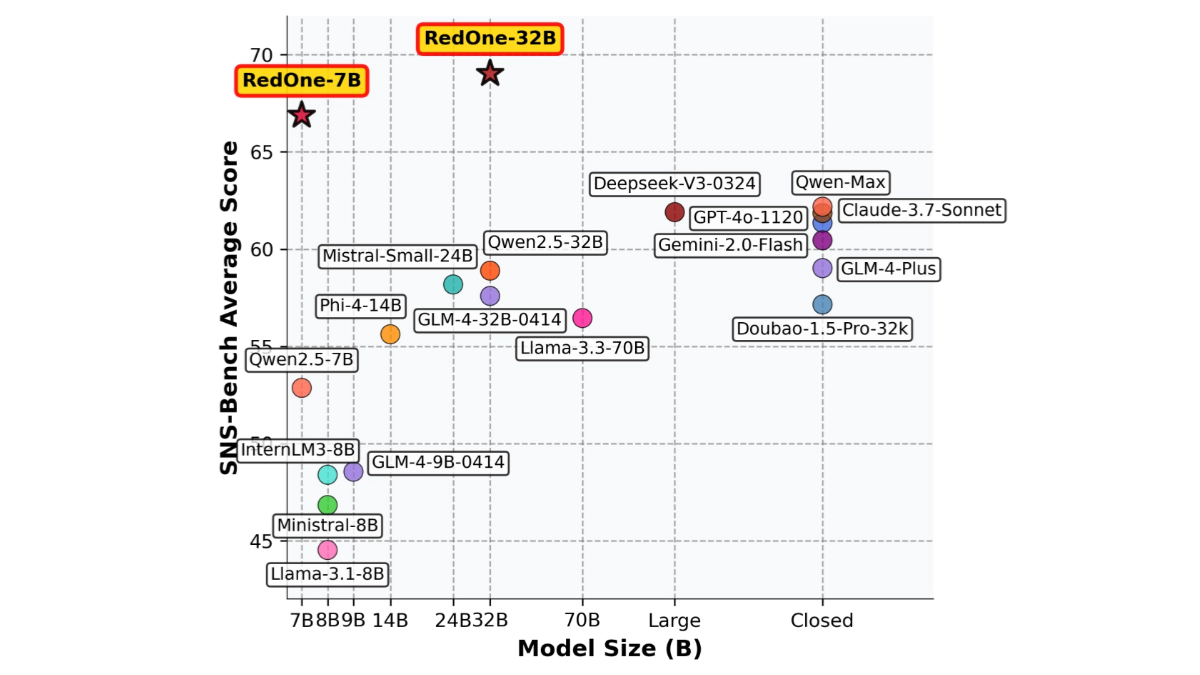
레드원은 리틀 레드북에서 도입한 소셜 네트워크에 특화된 대규모 언어 모델입니다. 이 모델은 사회 및 문화적 지식을 통합하고, 멀티태스킹 기능을 강화하며, 인간의 선호도를 조정하는 3단계 훈련 전략을 통해 훈련되며, RedOne은 소셜 작업 성능, 유해 콘텐츠 탐지 및 검색에서 기본 모델보다 훨씬 뛰어난 성능을 발휘합니다....
스탠드인(Stand-In)은 텐센트 WeChat 비전 팀이 개발한 가벼운 플러그 앤 플레이 방식의 신원 보존 동영상 생성 프레임워크입니다. 동영상 생성 시 특정 신원 특징을 보존하는 데 초점을 맞춘 이 프레임워크는 기본 모델 1%의 추가 파라미터만 학습하면 얼굴 유사성과 자연스러움에서 탁월한 결과를 얻을 수 있습니다.
Qwen3Guard는 보안 탐지를 위해 설계된 Qwen3 기본 모델을 기반으로 미세 조정된 보안 보호 모델입니다. 프롬프트 및 응답에 대한 정확한 보안 분류를 제공하고 위험 수준을 제공하며 영어, 중국어 및 다국어 환경을 지원합니다.Qwen3Guard는 두 가지 프로 버전으로 제공됩니다.
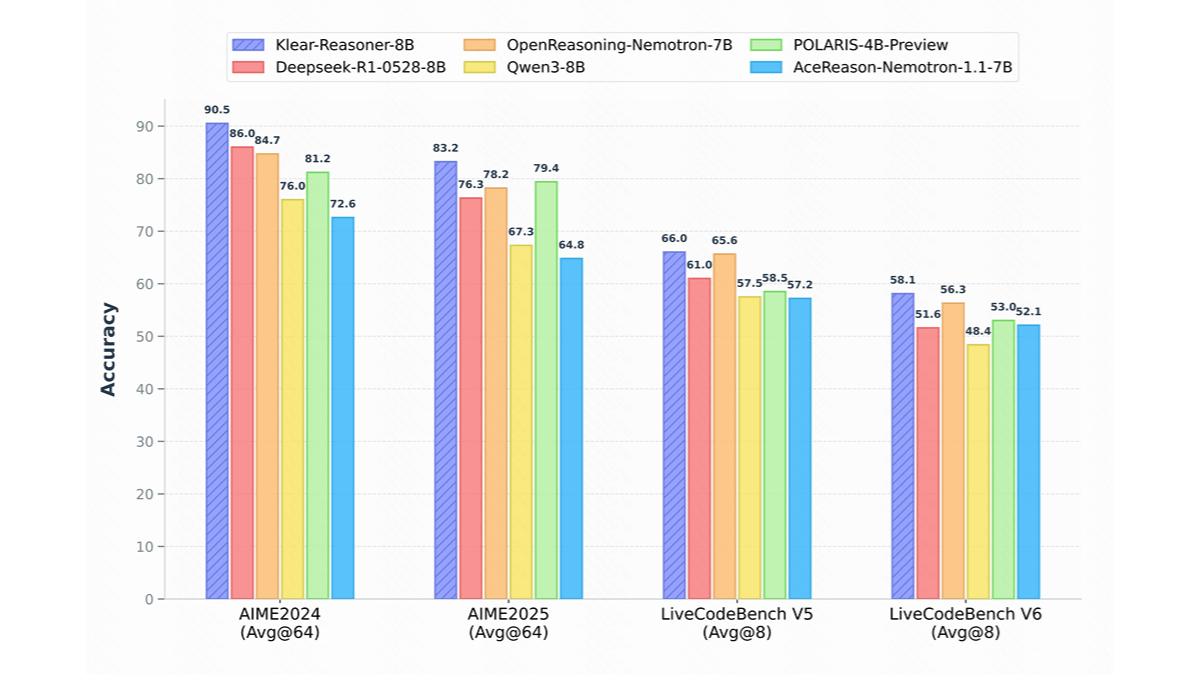
OpenReasoning-Nemotron은 수학, 과학 및 코드에서 추론 작업의 처리를 지원하기 위해 NVIDIA에서 오픈 소스화한 일련의 대규모 언어 모델입니다. 이 모델은 15억 개의 매개변수 스케일을 가진 DeepSeek R1 0528 모델을 기반으로 증류되었습니다....
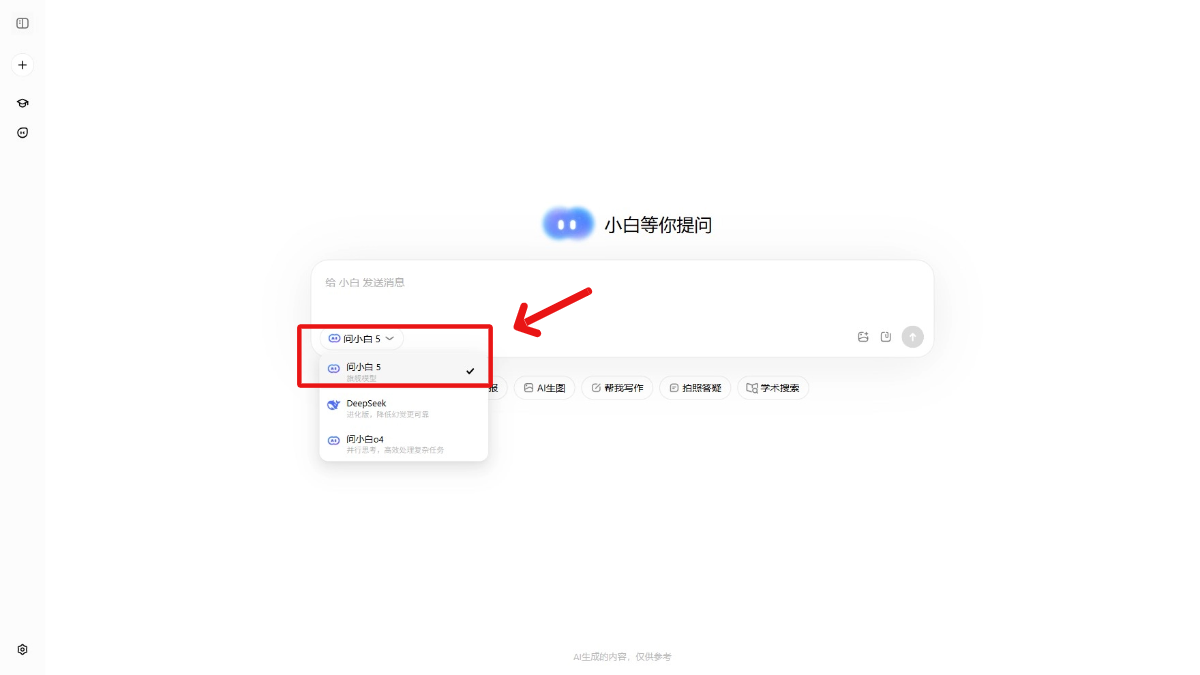
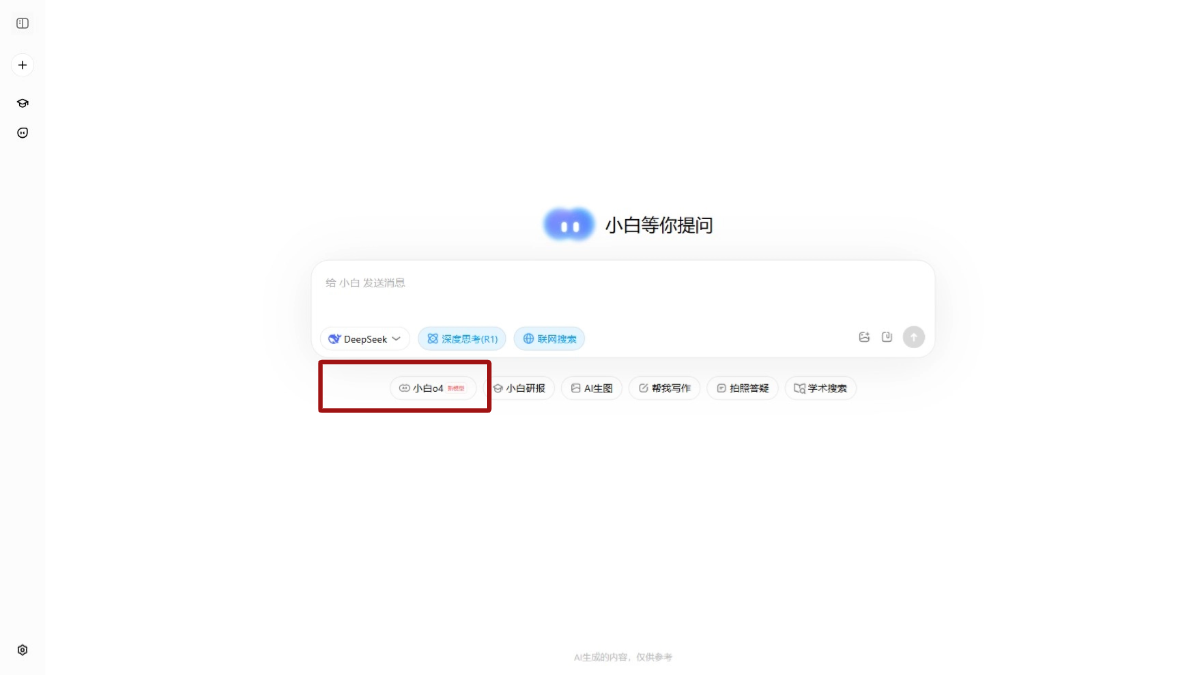
Ask White o4는 8개의 사고 경로를 동시에 열어 여러 관점에서 문제를 분석하고 최적의 해결책을 자동으로 필터링하는 혁신적인 병렬 사고 모델입니다. 이 모델은 고급 Long-CoT 강화 학습 및 프로세스 보상 학습 기법을 통합하고 강력한 심층 추론 기능을 갖추고 있으며 복잡한 작업에서 뛰어난 성능을 발휘합니다.
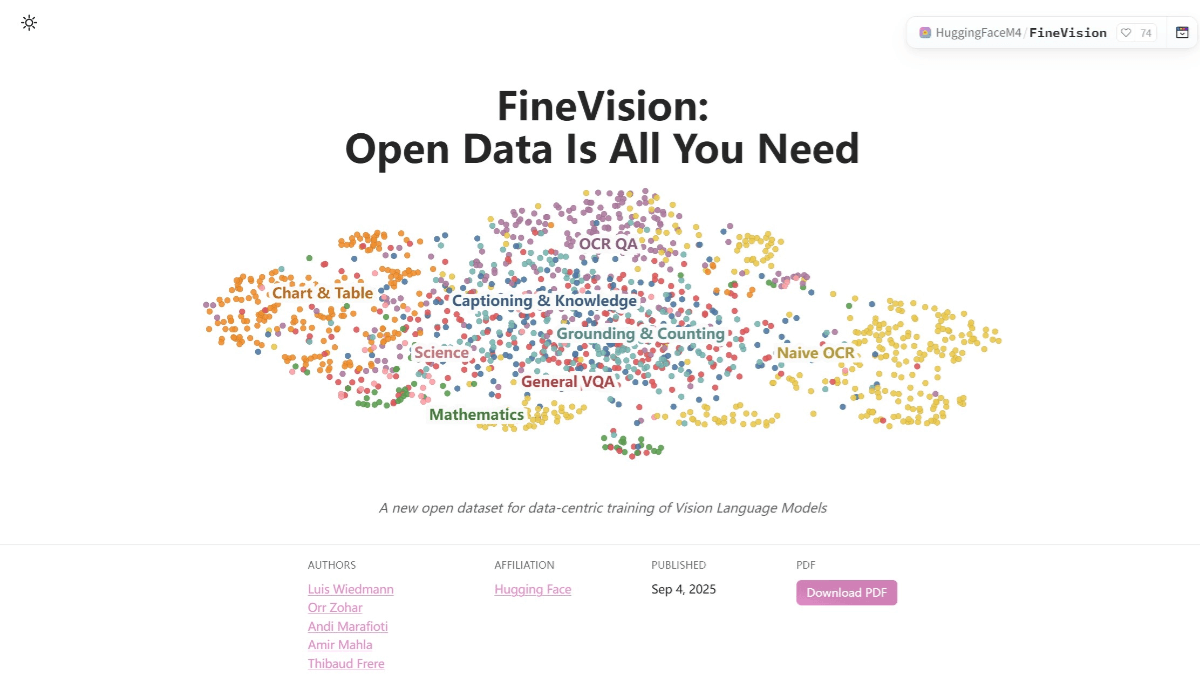
FineVision은 고급 시각 언어 모델 학습을 위한 허깅 페이스의 오픈 소스 시각 언어 데이터 세트입니다. 여기에는 1,730만 개의 이미지, 2,430만 개의 샘플, 8,890만 건의 대화, 95억 개의 답변 토큰이 포함되어 있습니다. 데이터 세트는 다음과 같이 집계됩니다...
GLM-ASR은 스마트 스펙트럼 AI가 오픈소스화한 고성능 음성 인식 모델 제품군으로, 클라우드 기반 모델인 GLM-ASR-2512와 오픈소스 엔드사이드 모델인 GLM-ASR-Nano-2512를 포함합니다.GLM-ASR-2512는 세계 최고의 클라우드 기반 음성 인식 모델로, 여러 개의 ...
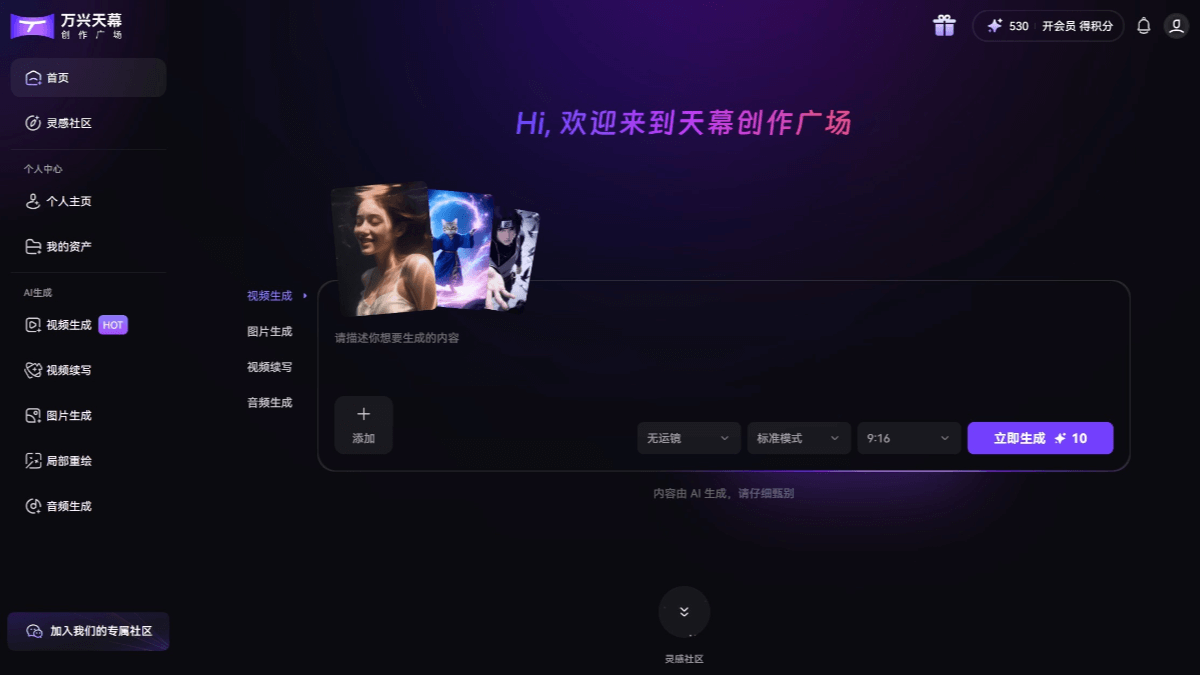
완싱 캐노피는 완싱 테크놀로지가 출시한 AIGC 동영상 제작 플랫폼으로, 동영상, 사진, 오디오 생성의 3대 창작 분야를 다루며 미디어 및 문화 산업 종사자, 영화 및 텔레비전/포스트 프로덕션 종사자, 예술 및 디자인 종사자, 광고 및 마케팅 실무자 등을 위해 특별히 설계되어 원스톱 전문 창작 솔루션을 제공합니다.
모비에이전트는 상하이교통대학교 IPADS 연구소의 오픈 소스 모바일 지능형 바디 툴 체인으로, 사용자가 자신만의 모바일 지능형 비서를 구축할 수 있도록 도와줍니다. 사용자의 동작 궤적을 기록하고 고품질 데이터를 생성하여 자연어 명령을 이해할 수 있는 지능형 바디를 훈련시킵니다. 핵심 기능에는 효율적인...
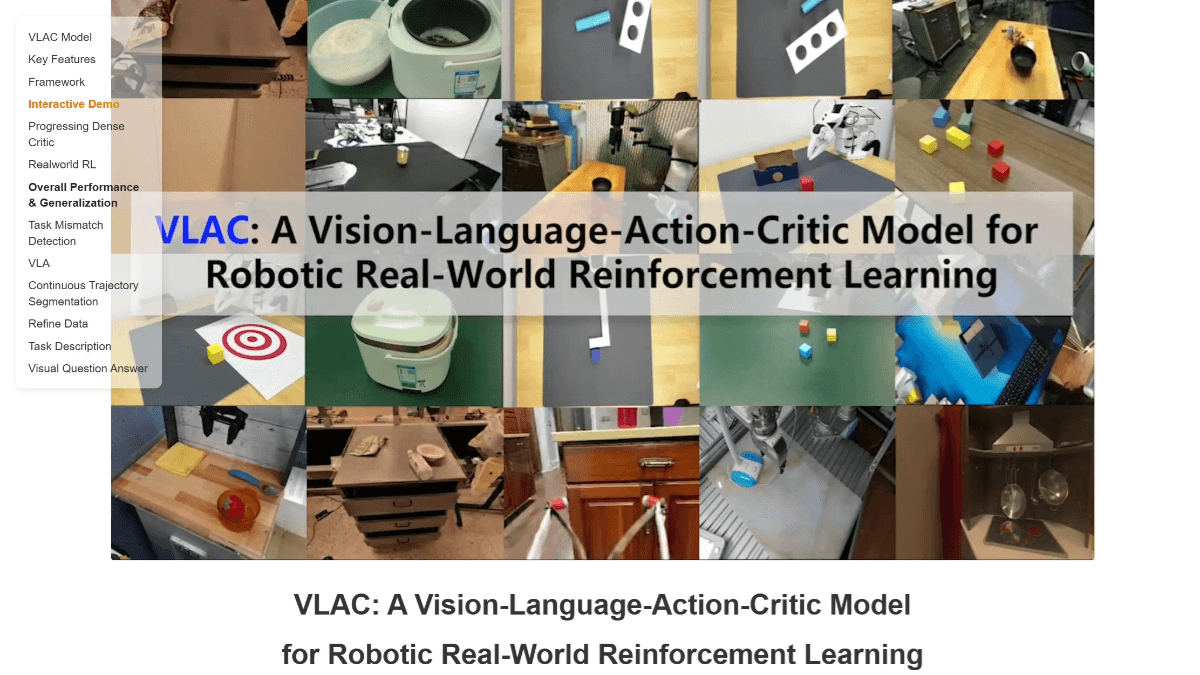
VLAC은 상하이 인공지능 연구소에서 오픈소스로 구현한 보상 매크로 모델입니다. InternVL 다중 모드 매크로 모델을 기반으로 인터넷 비디오 데이터와 로봇 작동 데이터를 통합하여 실제 세계에서 로봇 강화 학습을위한 프로세스 보상 및 작업 완료 추정을 제공합니다.VLAC는 효과적으로 ...
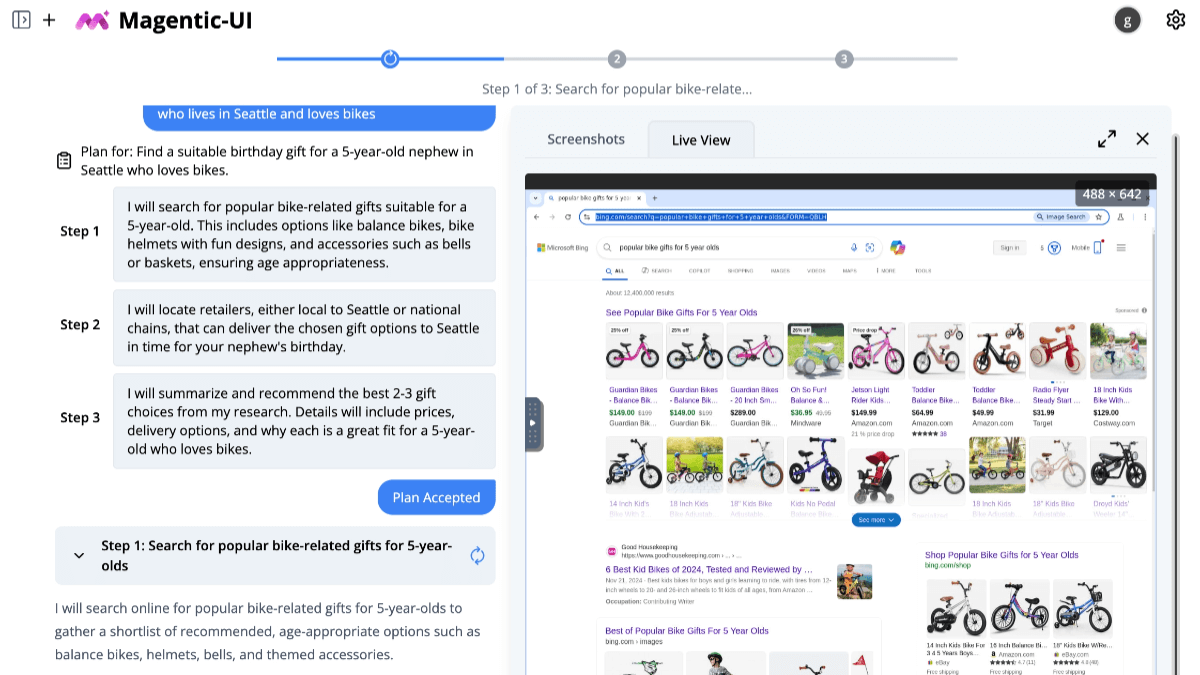
Magentic-UI는 Microsoft의 오픈 소스 인간-컴퓨터 협업 AI 에이전트 연구 도구로, 웹 탐색, 코드 실행, 파일 처리와 같은 복잡한 웹 작업을 용이하게 하기 위해 사용자와 긴밀하게 협력하는 것을 기반으로 합니다. 이 도구는 협업 계획을 강조하여 사용자가 ...
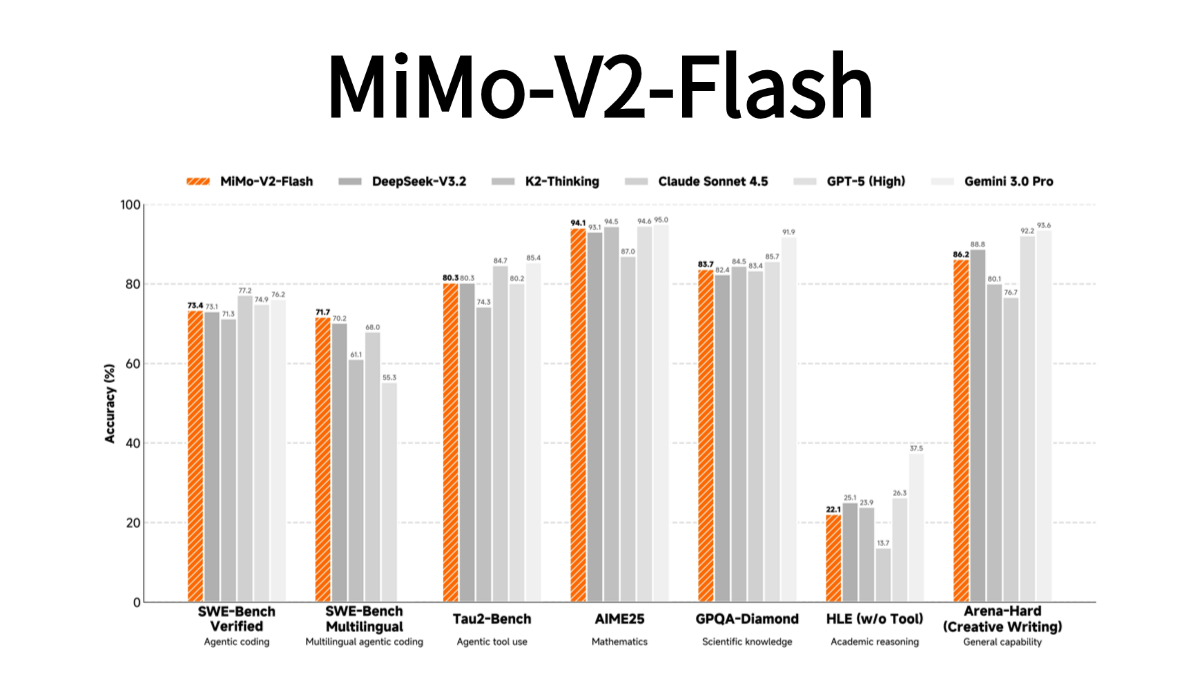
MiMo-V2-Flash는 효율적인 추론과 지능형 신체 애플리케이션에 초점을 맞춘 총 파라미터 3090억 개와 활성 파라미터 150억 개를 갖춘 Xiaomi에서 출시한 오픈 소스 MoE 아키텍처 대형 모델입니다. 이 모델은 하이브리드 주의 집중 아키텍처와 다중 단어 메타 예측 기술을 채택하여 초당 150 토큰의 추론 속도로 ...
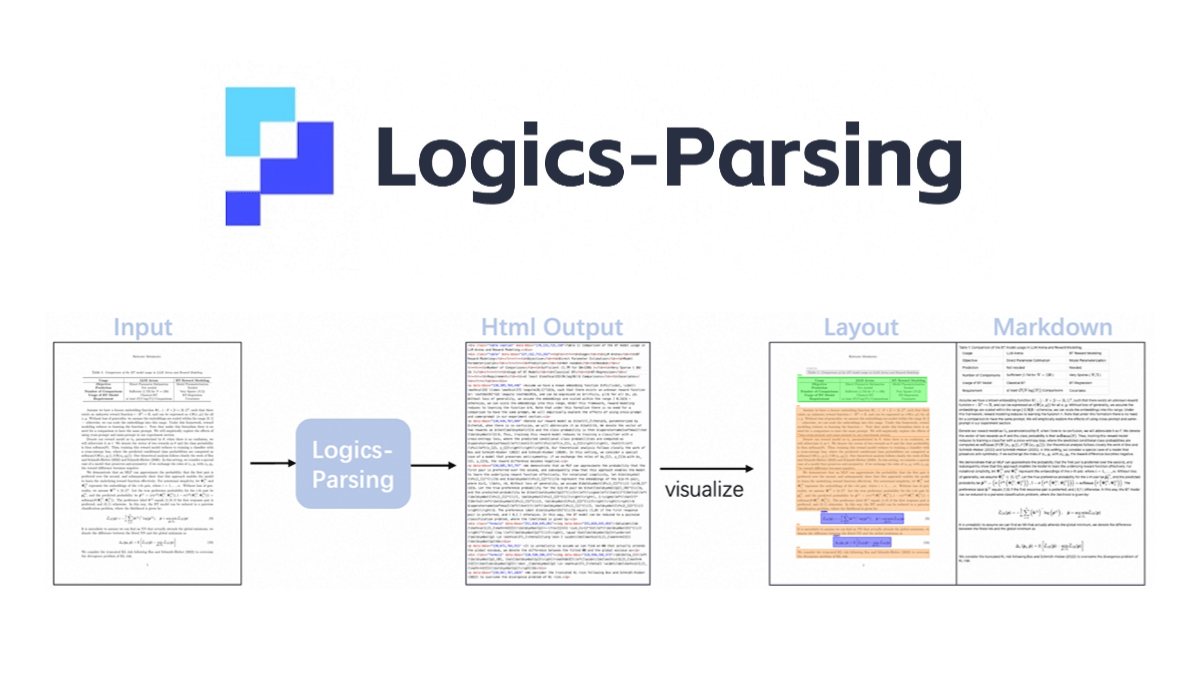
논리 구문 분석은 Qwen2.5-VL-7B를 기반으로하는 Ali 오픈 소스 엔드 투 엔드 문서 구문 분석 모델입니다. 강화 학습을 통해 문서 레이아웃 분석 및 읽기 순서 추론을 최적화하고 PDF 이미지를 구조화 된 HTML 출력으로 변환하고 다양한 콘텐츠를 지원할 수 있습니다 ...
QVQ-Max는 이미지와 비디오 콘텐츠를 "읽기"하고 분석 및 문제 해결을 위한 정보와 결합할 수 있는 알리토닉스의 최첨단 시각 추론 모델로, QVQ-72B-Preview의 업그레이드 버전입니다. QVQ-Max는 이미지 및 비디오 콘텐츠를 "읽기"하고 분석, 추론 및 문제 해결을 위해 정보를 결합할 수 있는 QVQ-72B-Preview의 업그레이드 버전입니다.QVQ-Max의 주요 기능에는 이미지 구문 분석, 비디오 분석 및 ...
미즈윅스는 메이퇀의 M17 팀이 모델의 지시를 따르는 능력을 평가하기 위해 사용하는 오픈 소스 대규모 모델 평가 세트입니다.미즈윅스는 3단계 평가 프레임워크를 사용하여 모델이 매크로에서 마이크로 수준까지 사용자의 지시에 따라 답변을 생성할 수 있는지 종합적으로 측정하며 답변 내용에 대한 지식은 긍정적으로 평가하지 않습니다.
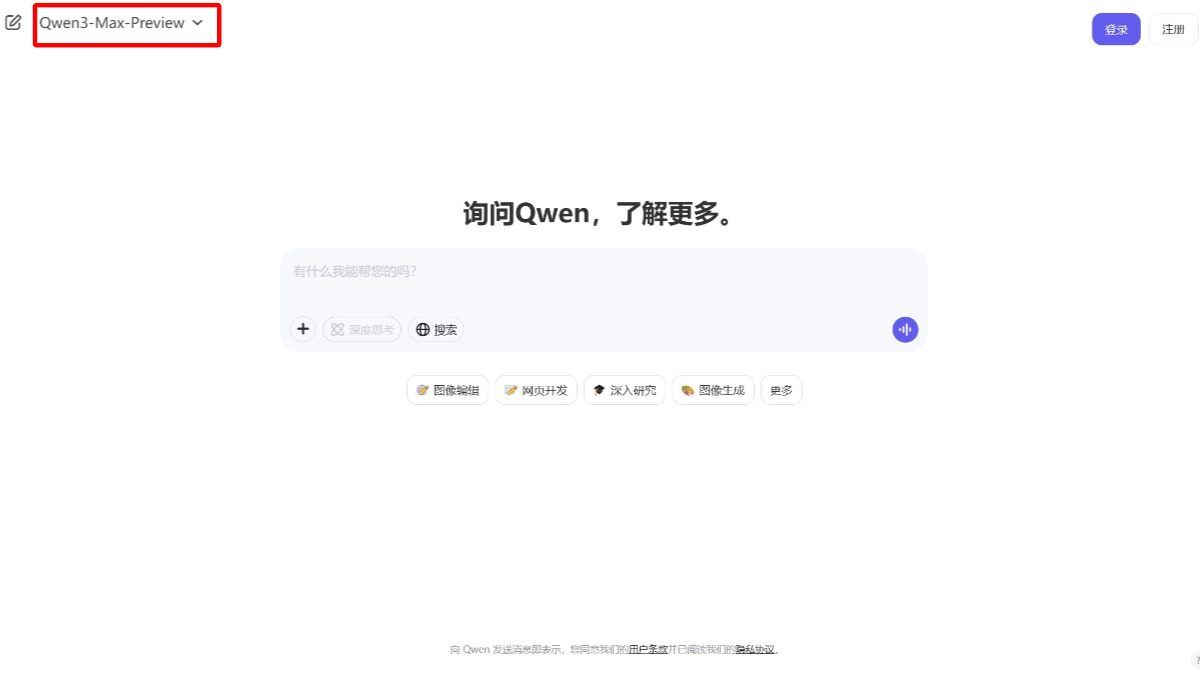
Qwen3-Max-Preview는 통이췐웬에서 출시한 최신 플래그십 대형 언어 모델입니다. Qwen3 제품군에서 가장 많은 파라미터를 가진 모델로, 파라미터 크기가 1조 개가 넘습니다. 이 모델은 추론, 명령어 추종, 다국어 지원 및 롱테일 지식 범위에서 상당한 개선을 이루었습니다...
후위안 월드-보이저(줄여서 후위안 보이저)는 텐센트에서 출시한 업계 최초의 초장거리 로밍 월드 모델로, 네이티브 3D 재구성을 지원합니다. 단일 이미지에서 사용자 정의 카메라 경로의 3D 포인트 클라우드 시퀀스를 생성하는 새로운 비디오 확산 프레임워크로, 다음을 지원합니다.
Qwen VLo는 통이 첸첸 팀이 도입한 멀티모달 통합 이해 및 생성 모델입니다. Qwen VLo는 세계를 '이해'하고 그 이해를 바탕으로 고품질로 재창조하여 인식에서 생성으로의 도약을 실현할 수 있습니다. VLo는 이미지의 내용을 정확하게 이해할 수 있으며, 이를 바탕으로 일관되고 고품질의 생성을 수행할 수 있습니다.
MiniCPM 4.1은 Facade Intelligence에서 도입한 매우 효율적인 엔드 사이드 대규모 언어 모델입니다. InfLLM v2 희소주의 아키텍처를 사용하면 각 어휘는 5% 미만의 어휘와의 상관관계만 계산하면 되므로 긴 텍스트의 처리 오버헤드를 크게 줄일 수 있습니다. 128K의 긴 텍스트 시나리오에서...
마인드링크는 쿤룬 월드와이드웹에서 출시한 오픈소스 추론의 대규모 모델입니다. 적응 형 추론 메커니즘을 통해 작업의 복잡성에 따라 유연한 전환 추론 모드, 간단한 작업 빠르게 생성, 복잡한 작업 심층 추론, 효율성과 정확성을 고려합니다. "생각"태그를 제거하기위한 계획 중심 추론 패러다임, 감소 ...
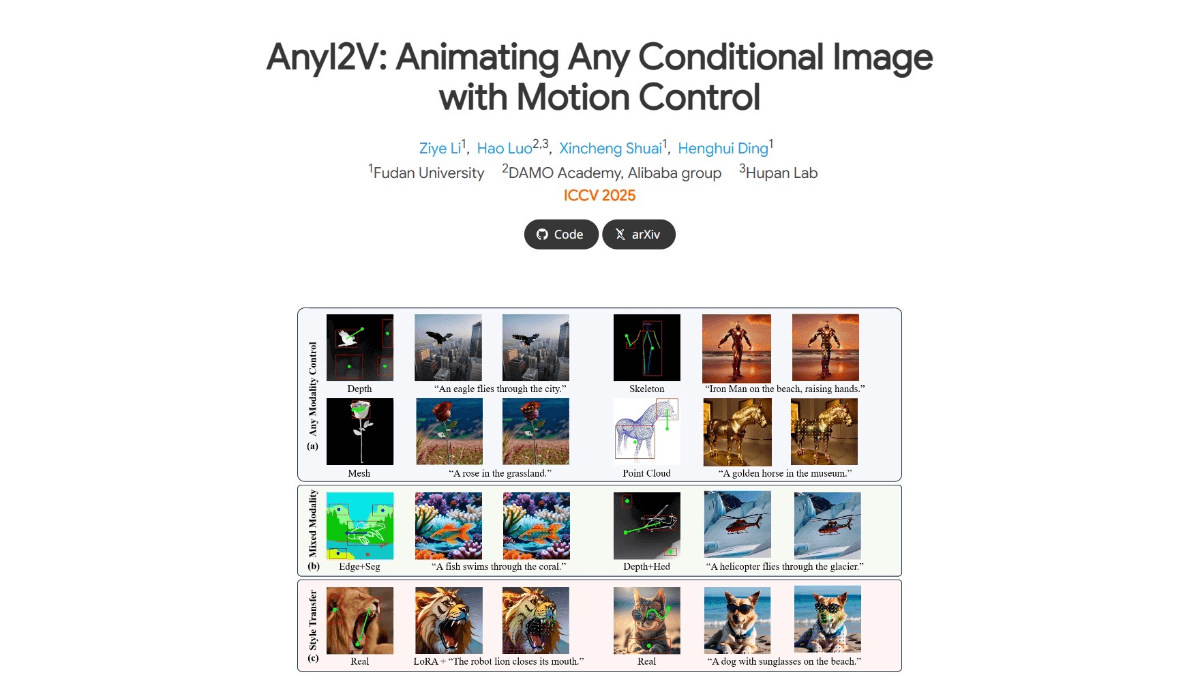
완무브는 알리 통이 연구소, 칭화대학교 및 기타 기관이 공동 개발한 오픈 소스 AI 비디오 생성 프레임워크로, 정밀한 모션 제어 기술을 통한 고품질 비디오 합성에 중점을 두고 있습니다. 핵심 기술은 기존 이미지 대 비디오 모델에 포인트 수준의 모션 제어를 원활하게 추가 할 수있는 "잠재적 궤적 안내"입니다 ...
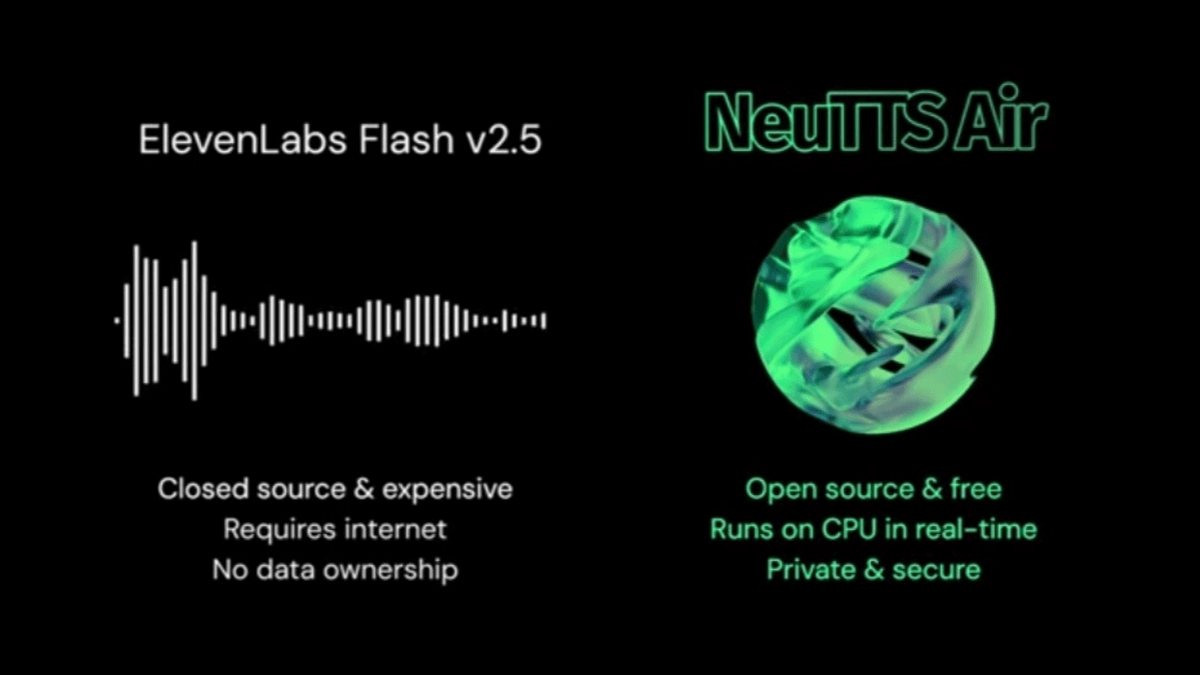
NeuTTS Air는 Neuphonic 팀이 개발한 오픈 소스 경량 음성 합성 모델로, 클라우드에 의존하지 않고 로컬 장치(예: 휴대폰, 노트북, 라즈베리파이)에서 실시간으로 실행할 수 있습니다. 0.5B 매개변수 Qwen 아키텍처와 자체 개발한 NeuCodec 코덱 사용...
플라이카운트 자바AI는 플라이카운트 테크놀로지에서 출시한 지능형 자바 개발 어시스턴트입니다. 이 플랫폼은 자연어 입력을 지원하여 요구사항 분석부터 코드 생성까지 지능형 개발의 전 과정을 지원합니다. 개발자는 요구 사항에 대한 설명만 입력하면 Flycount JavaAI가 완전한 엔지니어링 코드 프레임워크인 플랫폼을 정확하게 이해하고 생성할 수 있습니다.
ERNIE-4.5-21B-A3B-Thinking은 추론 작업에 초점을 맞춘 바이두의 오픈 소스 대규모 언어 모델입니다. 혼합 전문가(MoE) 아키텍처를 사용하여 총 참조 수는 210억 개에 달하며, 각 토큰은 30억 개의 매개 변수를 활성화하여 128K의 긴 컨텍스트 창을 지원합니다 ...
개인 정보 보호 및 보안에 민감한 개발 팀을 위해 설계된 오픈 소스 엔터프라이즈급 네이티브 AI 프로그래밍 도우미입니다.MonkeyCode는 코드 데이터 보안을 보장하기 위해 비공개 배포 및 오프라인 사용을 지원합니다. MonkeyCode는 코드 데이터의 보안을 보장하기 위해 비공개 배포 및 오프라인 사용을 지원합니다 ...
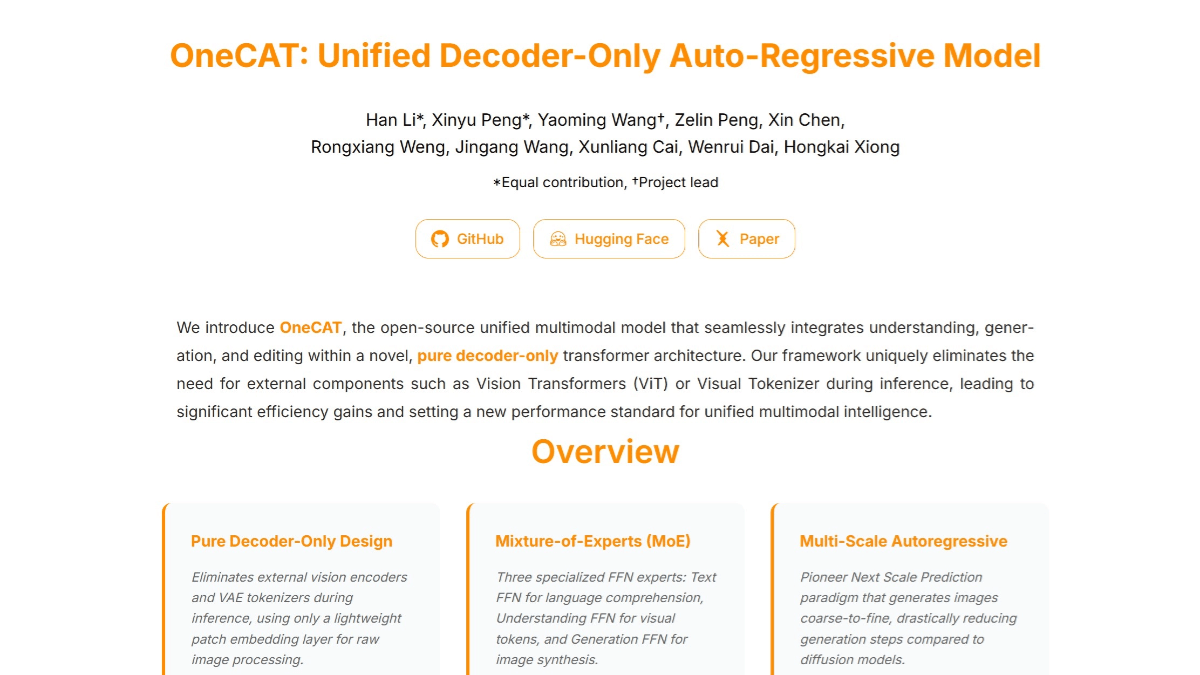
원캣은 메이투안이 상하이교통대학교와 함께 출시한 새로운 통합 멀티모달 모델로, 멀티모달 이해, 텍스트-이미지 생성, 이미지 편집 기능을 원활하게 통합하는 순수 디코더 아키텍처를 채택하고 있습니다. 이 모델은 외부 시각 코더와 모달리티별 디스모게이터에 의존하는 기존 멀티모달 모델의 설계를 버리고 모달리티별 ...
GLM-TTS는 강력한 음성 합성 기능을 갖춘 오픈 소스 산업 등급 음성 합성 시스템입니다. 2단계 생성 아키텍처를 채택하여 첫 번째 단계에서는 텍스트를 음성 토큰 시퀀스로 변환하고, 두 번째 단계에서는 토큰 시퀀스를 고품질 오디오로 변환합니다. 이 시스템은 3초의 음성 샘플만 지원하여 사운드를 완성할 수 있습니다.
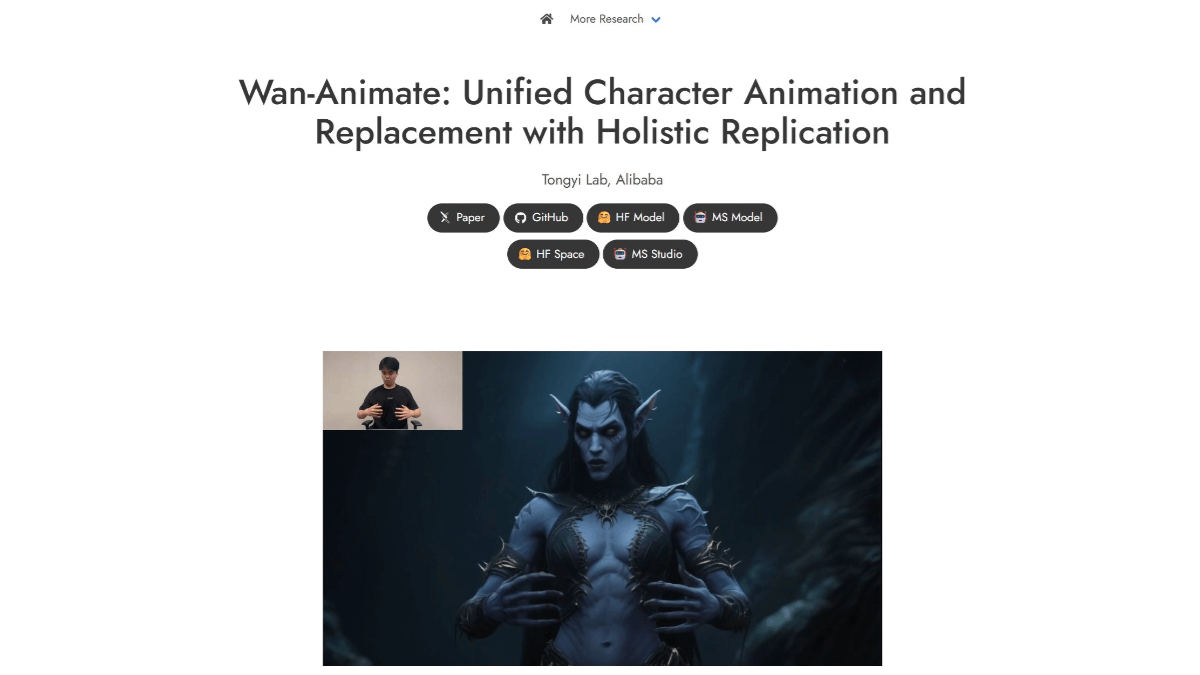
완2.2-애니메이트는 통이완샹의 오픈 소스 액션 생성 모델로, 액션 모방과 롤플레잉의 두 가지 모드를 지원합니다. 사용자는 캐릭터 사진과 참조 비디오 만 입력하면 모델이 비디오 캐릭터의 움직임과 표정을 그림 캐릭터로 마이그레이션하여 그림 캐릭터에 역동적 인 표현을 제공 할 수 있습니다 ...
샤오미 미모 오디오는 다국어 대화, 음성 연속, 적은 샘플 일반화 및 오디오 이해와 같은 강력한 기능을 갖춘 샤오미의 오픈 소스 70억 개 파라미터 엔드투엔드 음성 매크로 모델로, 음성 지능 및 오디오 이해 벤치마크에서 구글 제미를 능가하는 SOTA 레벨에 도달할 수 있습니다.
웬신 빅 모델 X1.1은 언어 이해와 생성을 개선하는 데 중점을 둔 하이브리드 강화 학습 프레임워크를 기반으로 바이두에서 출시한 심층 사고 모델입니다. 이 모델은 복잡한 질문을 처리하고, 지시를 따르고, 지능의 행동을 시뮬레이션하는 데 탁월하며, 지식이 풍부한 답변과 고품질 텍스트 콘텐츠를 정확하게 제공할 수 있습니다.
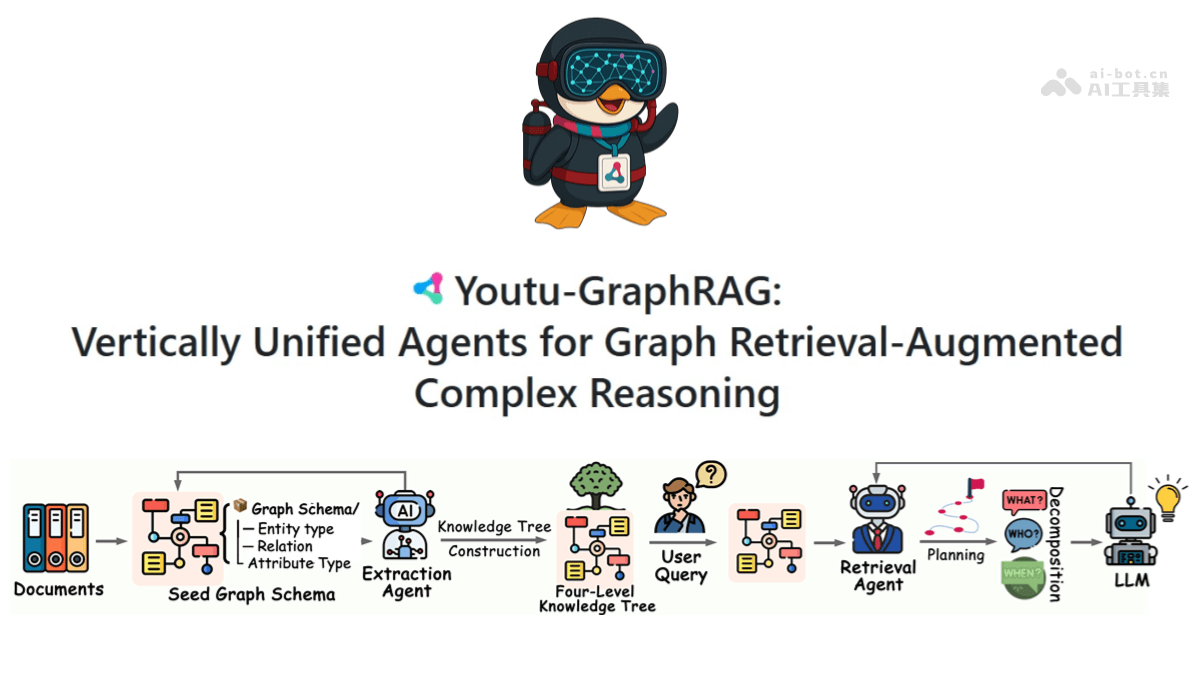
Youtu-GraphRAG는 대규모 언어 모델이 복잡한 Q&A 작업을 보다 정확하게 처리할 수 있도록 지원하는 텐센트 유투 연구소의 오픈 소스 그래프 검색 증강 생성 프레임워크입니다. 4계층 지식 트리를 구성하여 지식을 속성, 관계, 키워드 및 커뮤니티의 네 가지 수준으로 분해하여 행위의 자기 숙달에 대한 교차 도메인 지식을 달성합니다....
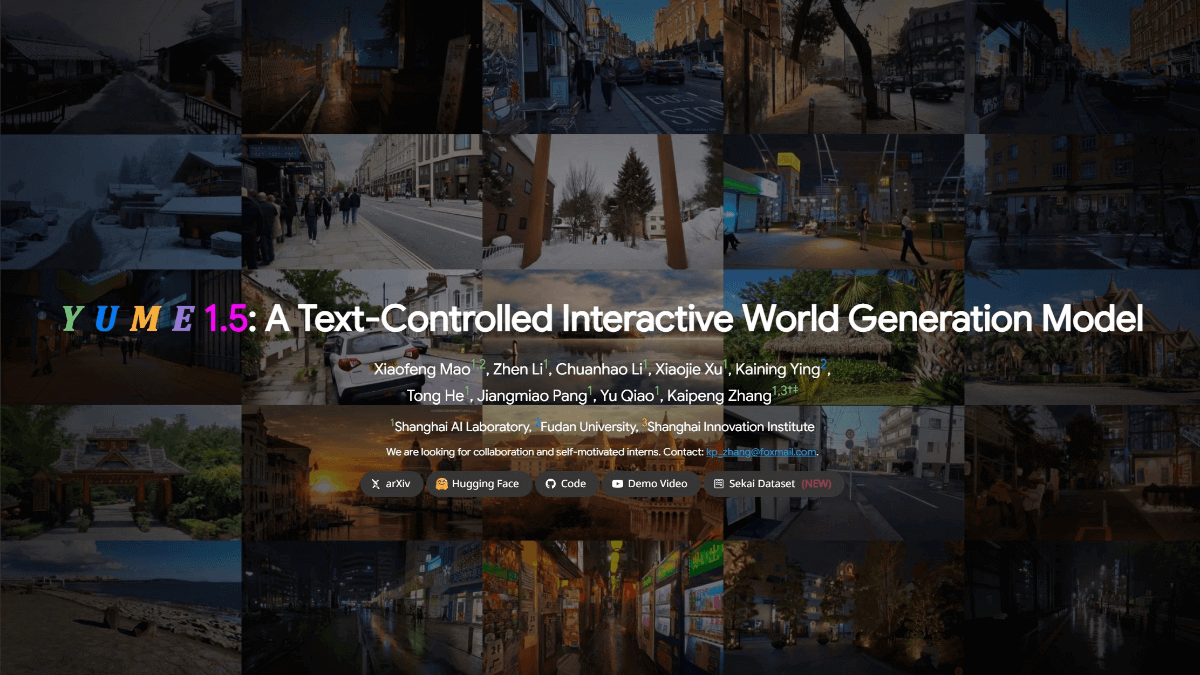
Yume 1.5는 상하이 인공지능 연구소, 푸단대학교, 상하이 혁신 연구소가 공동 개발한 오픈 소스 인터랙티브 월드 생성 모델로, 실시간 인터랙티브 렌더링(단일 카드에서 12FPS)이 가능합니다. 컨텍스트 길이가 증가하더라도 공동 시공간 채널 모델링(TSCM) 기술을 채택하여...
송블룸은 홍콩 중문대학교(선전) 및 난징대학교와 협력하여 Tencent AI Lab에서 개발한 오픈 소스 노래 생성 모델로, AI 음악 생성의 '가소성' 문제를 해결하고 구조적으로 완벽한 고품질의 노래를 생성할 수 있습니다. 10초 분량의 레퍼런스 오디오와 해당 가사를 입력하기만 하면...
FunctionGemma는 2억 7천만 개의 매개변수를 가진 Gemma 3 기본 모델을 기반으로 개발된 Google의 함수 호출에 최적화된 경량 AI 모델로, 휴대폰, 브라우저 및 기타 기기에서 자연어를 실시간으로 실행 가능한 API 명령으로 변환합니다. 핵심 기능은 로컬 오프...
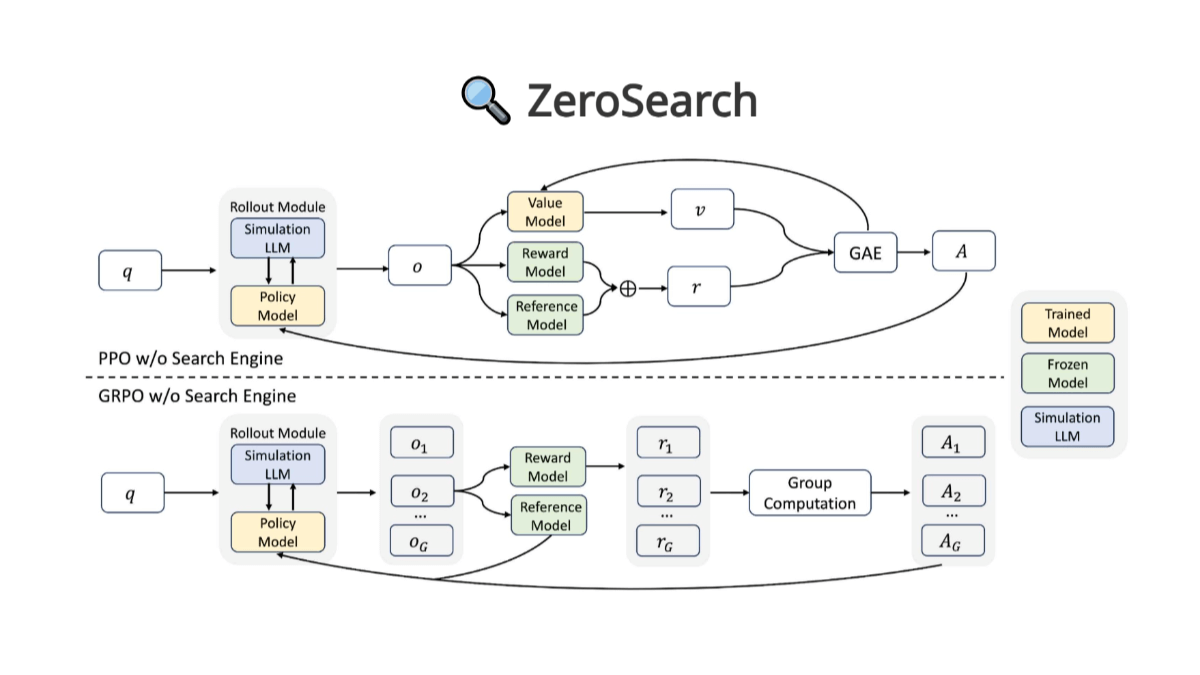
제로서치는 알리바바 통이랩의 오픈소스 혁신적 대형 모델 검색 엔진 프레임워크입니다. 이 프레임 워크는 검색 엔진의 시뮬레이션을 기반으로 실제 검색 엔진과 상호 작용할 필요가 없으며 자체 사전 학습 지식의 대규모 모델을 사용하여 관련 문서 또는 노이즈 문서를 생성하여 교육 비용을 크게 줄입니다 (80% 이상 감소 ...
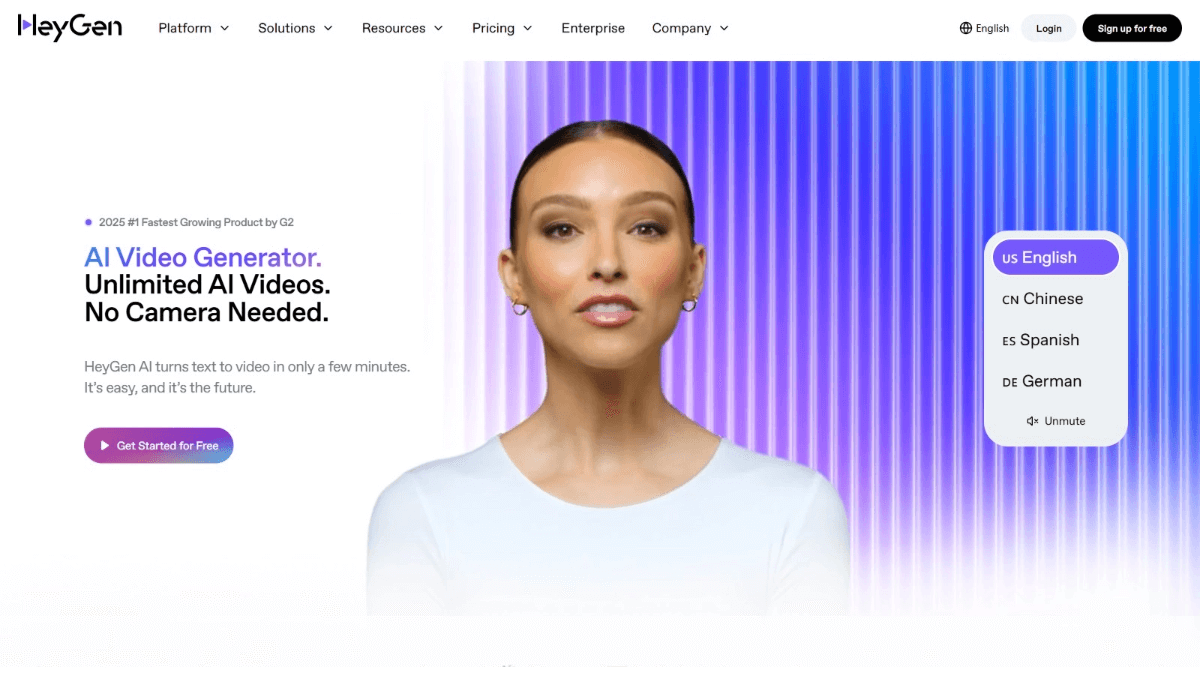
헤이젠은 간소화된 동영상 제작 프로세스를 지원하는 AI 기반 디지털 휴먼 동영상 제작 플랫폼으로, 사용자가 전문가 수준의 디지털 휴먼 동영상을 빠르게 제작할 수 있도록 지원합니다. 이 플랫폼은 고급 AI 기술을 기반으로 하여 사용자가 디지털 캐릭터의 이미지와 음성을 완벽하게 제어할 수 있으며, 다양한 배경을 포함한 풍부한 자료 라이브러리를 제공합니다.
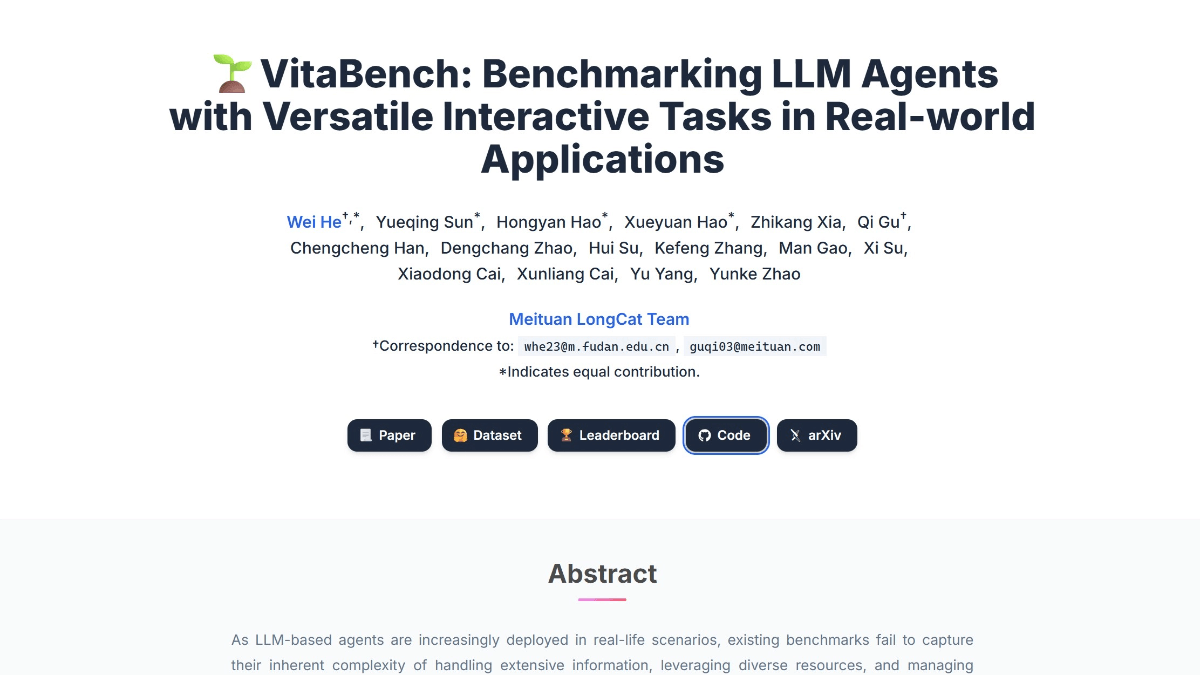
비타벤치는 메이투안의 롱캣 팀이 발표한 복잡한 생활 시나리오를 위한 최초의 대화형 에이전트 평가 벤치마크로, 실제 생활 시나리오에서 대규모 모델 지능의 종합적인 기능을 평가합니다. 테이크아웃 주문, 레스토랑 식사, 여행의 세 가지 빈도가 높은 생활 시나리오는 패키지를 구축하기 위한 캐리어로 사용됩니다....
에코케어는 중국과학원(CAS) 홍콩혁신연구센터의 인공지능 및 로봇공학 혁신센터(CAIR)가 개발한 대규모 초음파 기반 모델로, 다센터, 다지역, 다인종, 50개 이상의 개인을 포함하는 세계 최대 규모의 초음파 이미지 데이터세트(450만 개 이상의 이미지)로 훈련되었습니다....
SoulX-Podcast는 고품질 팟캐스트 콘텐츠 생성을 위해 설계된 Soul AI Lab의 오픈 소스 고급 다중 화자 대화 음성 합성 모델입니다. SoulX-Podcast는 여러 차례의 대화를 생성할 수 있으며 실제 팟캐스트 시나리오에서 원활한 대화를 시뮬레이션할 수 있으며 중국어, 영어 및 여러 개의 중국어를 지원합니다.
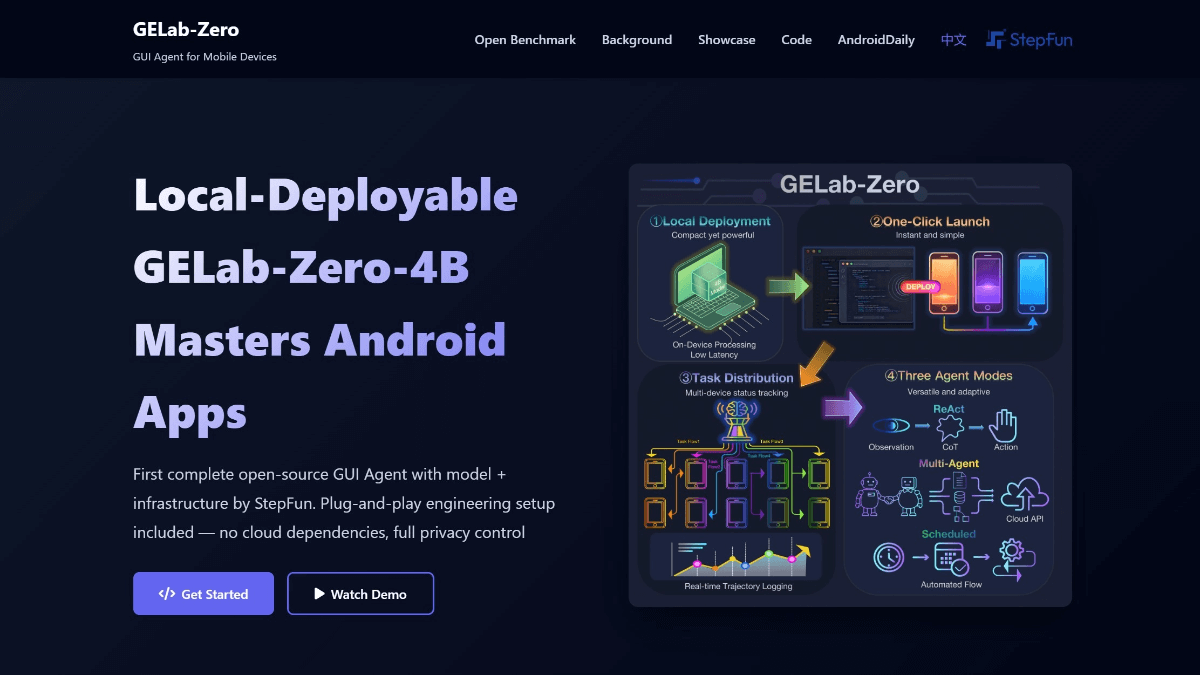
GELab-Zero는 4B 매개 변수가있는 Qwen3-VL-4B-Instruct 기본 모델을 기반으로 구축 된 Step Leap 팀의 오픈 소스 엔드 사이드 멀티 모달 GUI 에이전트 모델로, UI 요소를 인식하고 클릭, 슬라이드 등의 작업을 수행하고 교차 애플리케이션 작업을 지원합니다....
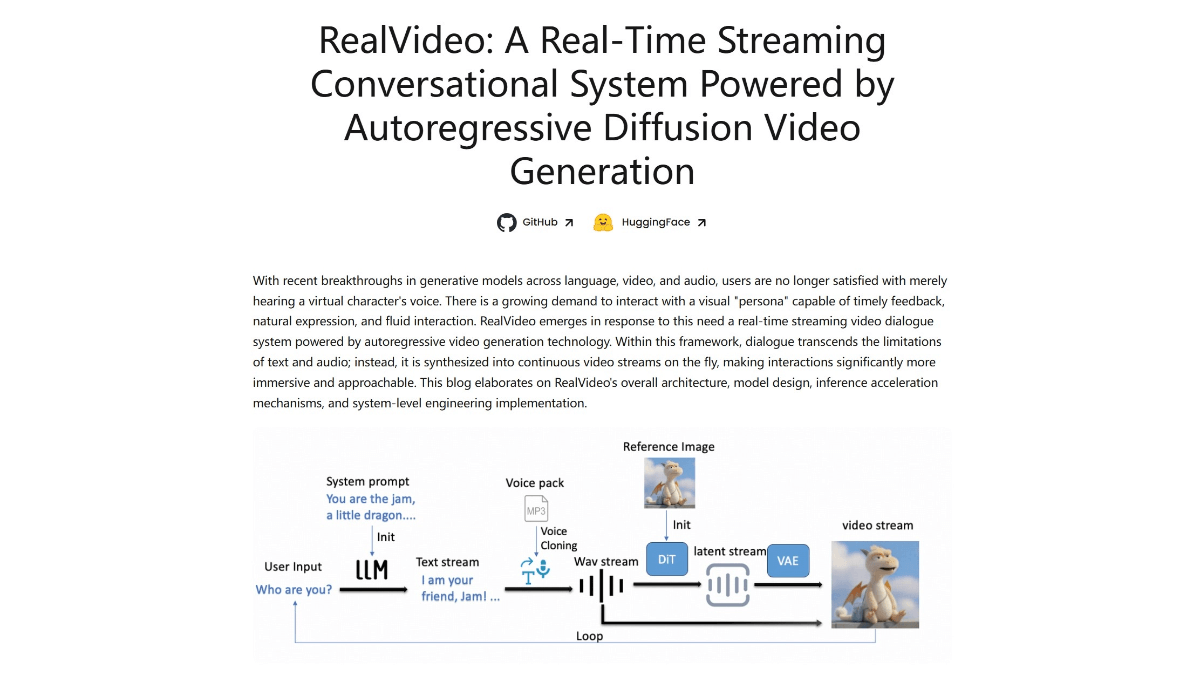
리얼비디오는 스마트 스펙트럼 AI의 오픈소스 실시간 스트리밍 비디오 생성 시스템으로, 2~3초 안에 자연스럽고 부드러운 비디오 응답을 빠르게 생성할 수 있습니다. 사용자가 사진을 업로드하고 텍스트를 입력하기만 하면 시스템이 해당 음성과 영상을 생성하여 AI 캐릭터와 실시간으로 대화할 수 있습니다...
FLM-Audio는 베이징 즈위안 인공지능 연구소가 스핀 매트릭스 및 싱가포르 난양 공과대학교와 함께 출시한 네이티브 전이중 오디오 대화 매크로 모델로, 중국어와 영어를 모두 지원합니다. 네이티브 전이중 아키텍처를 채택하여 각 시간 단계에서 듣기, 말하기 및 독백을 병합 할 수 있습니다 ...


 한국어
 简体中文
 English
 日本語
 Русский
 Español