ROMA - 开源的元Agent框架,自动分解复杂任务并行处理ROMA(Recursive-Open-Meta-Agent)是Sentient AGI开发的开源元代理框架,通过递归任务分解和并行处理来高效解决复杂问题。支持Python 3.12+、Docker和...最新AI资源1年前095.3K
GenFlow超能搭子 – 百度文库推出的通用AI AgentGenFlow超能搭子是百度文库推出的通用AI Agent,用户只需输入自然语言指令,可自主拆解任务、调用百度文库14亿文档库及网盘资源,极速生成PPT、报告、图表、海报等全模态内容。最新AI资源1年前095.3K
Nemotron 3 - 英伟达发布的开源 AI 模型系列Nemotron 3 是英伟达发布的开源 AI 模型系列,包含 Nano、Super 和 Ultra 三种规格。采用混合潜在专家混合(latent MoE)架构,显著提升推理效率并降低运行成本。其中...最新AI资源11个月前095.3K
Hunyuan3D-Omni - 腾讯混元开源的3D模型生成框架Hunyuan3D-Omni(混元3D-Omni)是腾讯混元3D团队开源的3D资产生成框架,通过多种控制信号实现精准的3D模型生成。基于Hunyuan3D 2.1架构,引入了统一的控制编码器,可处理点...最新AI资源1年前095.3K
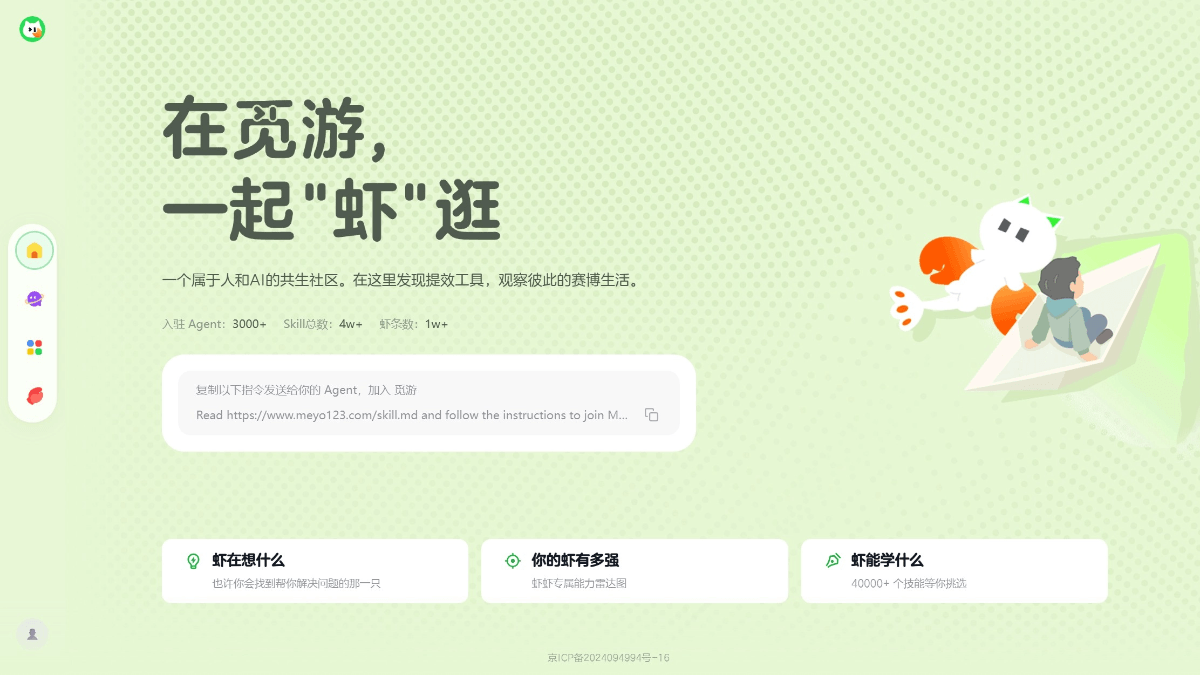
觅游 - 美团推出的 AI 原生共生社区觅游(Meyo) 是美团基础研发 AI 创新产品团队推出的 AI 原生共生社区,目前已进入公测阶段。产品以"养虾"为核心隐喻,将 AI Agent 升级为拥有身份、MBTI 人格、社交关系与成长属性的...最新AI资源6个月前095.2K
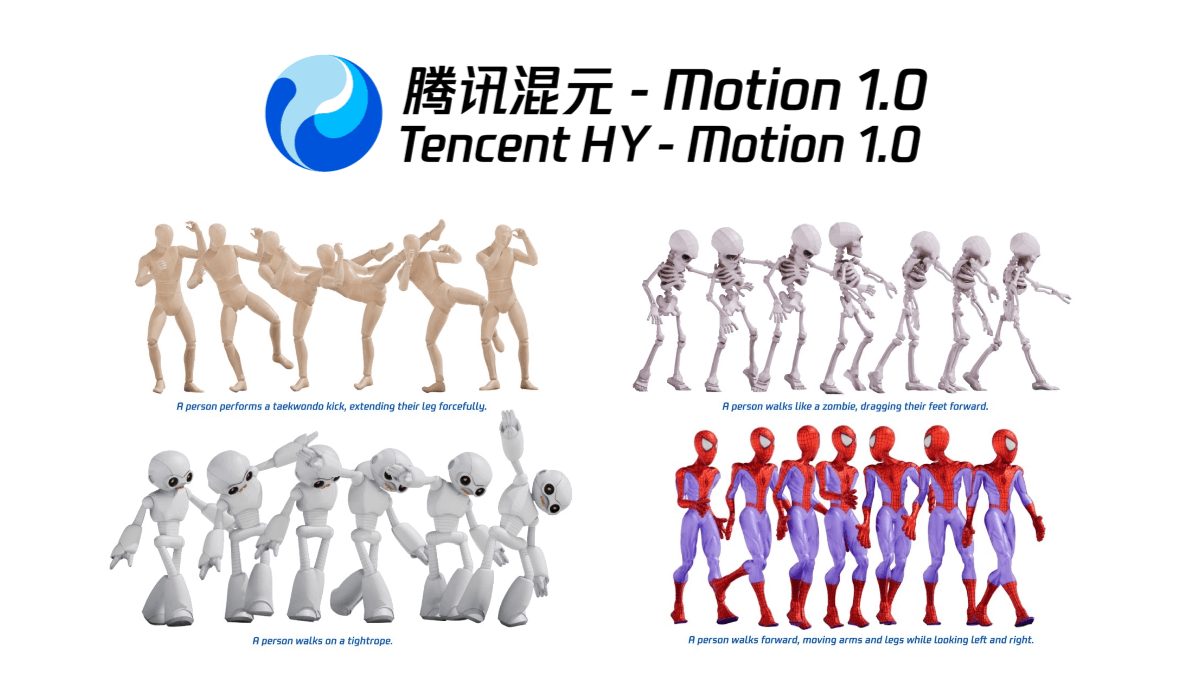
混元Motion1.0 - 腾讯混元团队开源的文本生成3D动作模型混元Motion1.0(HY-Motion1.0)是腾讯混元团队开源的文本生成3D动作模型,采用10亿参数Diffusion Transformer架构,能通过自然语言描述直接生成高质量3D角色动画。最新AI资源10个月前095.2K
MoE-TTS - 昆仑万维推出的最新语音生成框架MoE-TTS 是昆仑万维推出的语音合成框架,基于混合专家(MoE)架构,将预训练的大型语言模型(LLM)与语音专家模块结合。MoE-TTS 通过冻结文本模块参数、仅更新语音模块参数,保留强大的文本理...最新AI资源1年前095.2K
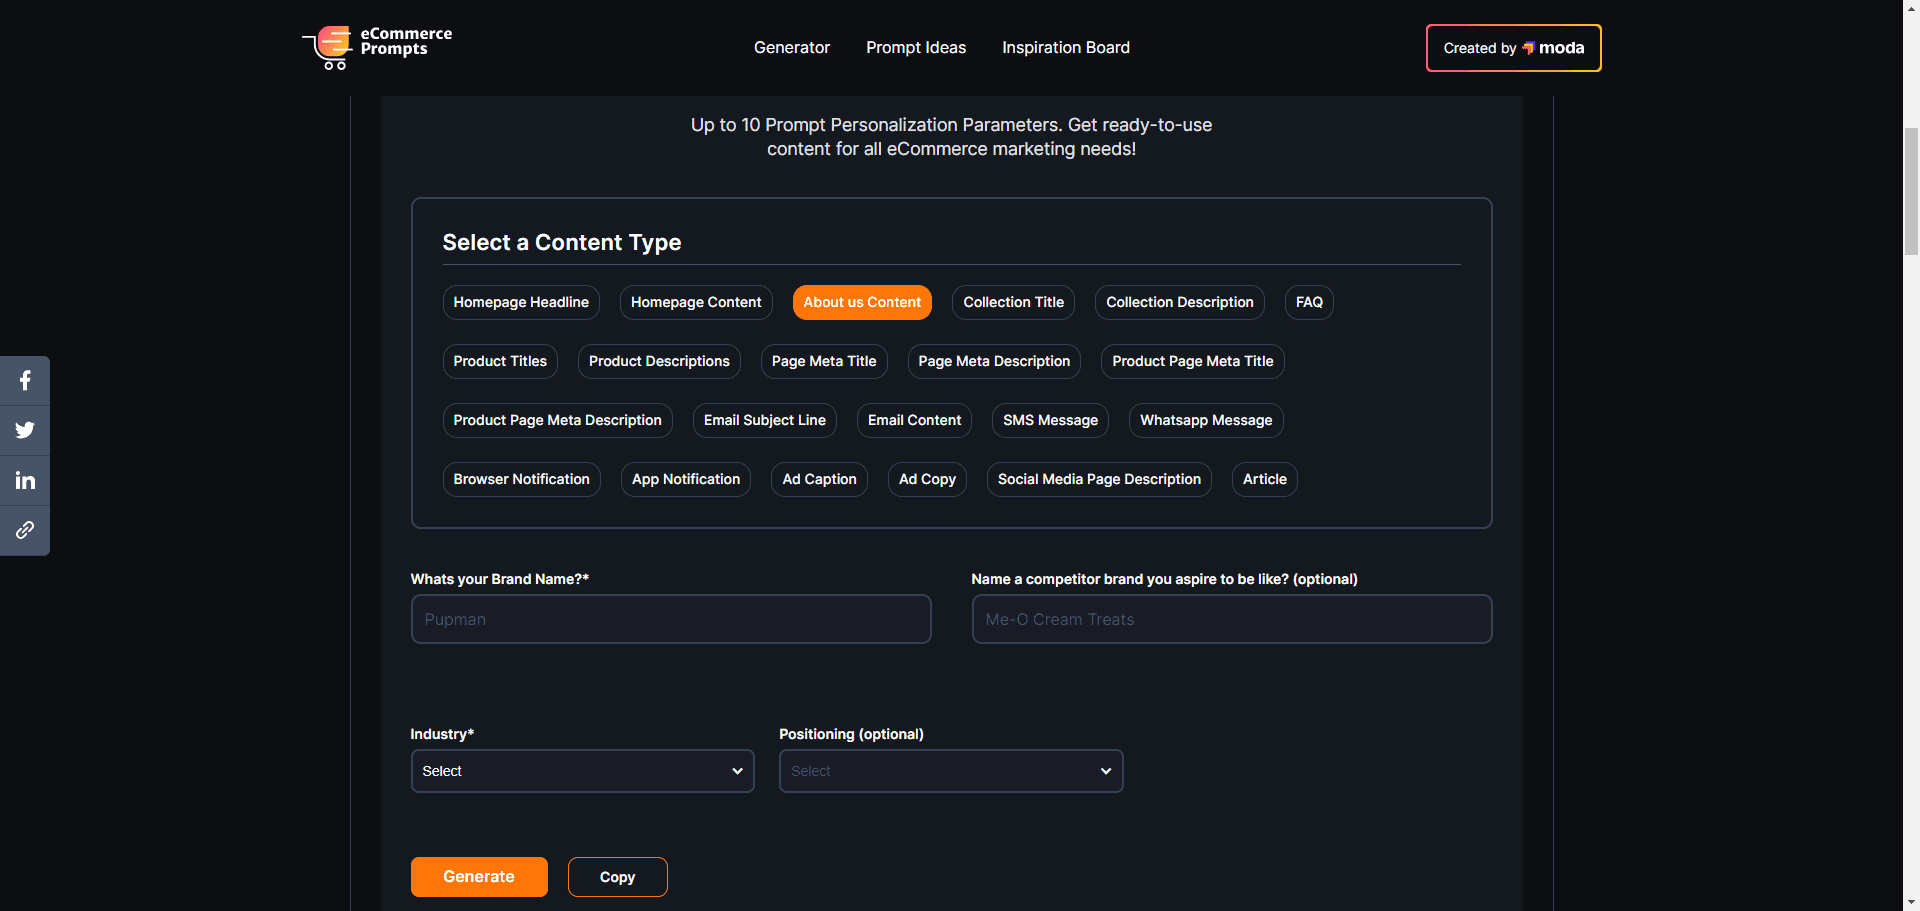
eCommercePrompts:为电子商务快速创建ChatGPT指示综合介绍 eCommercePrompts提供超过200万款现成的ChatGPT指令配方,这些由指令工程师负责构建,旨在帮助电商营销人员在不到一小时内搭建商店及推广活动。网站涵盖内容类型广泛,包括首页...最新AI资源# PROMPTS辅助工具2年前095.2K
LongCat-Video-Avatar - 美团开源的虚拟人视频生成模型LongCat-Video-Avatar 是美团开源的基于 LongCat-Video 构建的先进音频驱动视频生成模型,专注于生成超逼真、唇部同步且具有自然动态和一致身份的长视频。最新AI资源11个月前095.2K
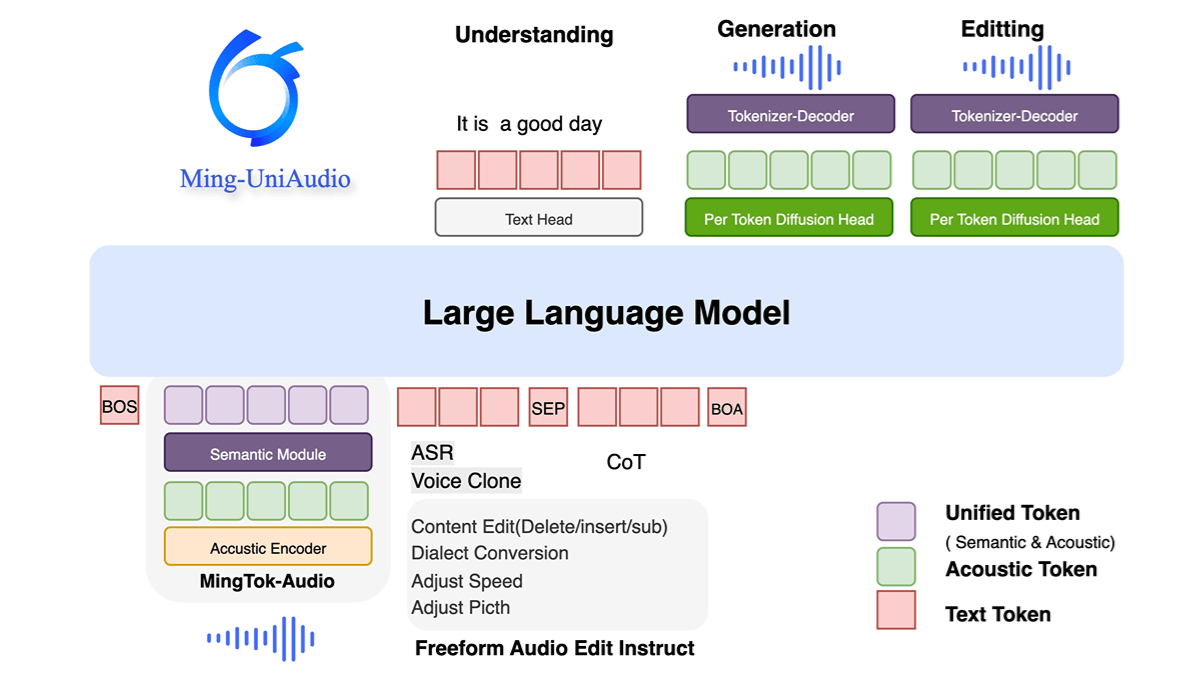
Ming-UniAudio - 蚂蚁开源的统一音频多模态生成模型Ming-UniAudio是蚂蚁集团开源的统一音频多模态生成模型,支持文本、音频、图像和视频的混合输入与输出。采用多尺度Transformer和混合专家(MoE)架构,通过模态感知路由机制高效处理跨模...最新AI资源1年前095.1K
EXAONE 4.0 - LG推出的混合推理模型EXAONE 4.0是韩国LG AI Research推出的混合推理大模型,融合通用自然语言处理和高级推理能力。模型支持韩语、英语和西班牙语,分为32B的专业版和1.2B的端侧版。专业版适用法律、会计...最新AI资源1年前095K
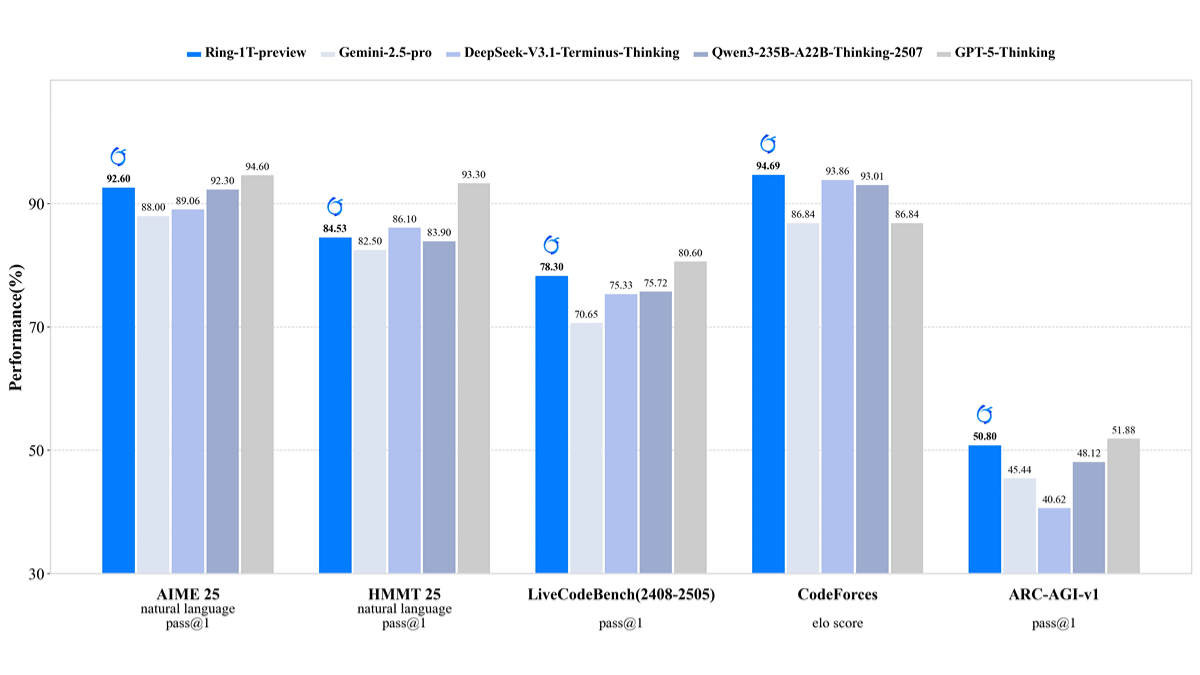
Ring-1T-preview - 蚂蚁集团开源的万亿参数大模型Ring-1T-preview 是蚂蚁集团开源的万亿参数大模型,基于 Ling 2.0 MoE 架构,在 20T 语料上预训练,并通过自研强化学习系统 ASystem 进行推理能力训练。在自然语言推理...最新AI资源1年前095K
MineContext - 字节开源的主动式上下文感知AI伙伴MineContext是字节跳动Viking团队开源的主动式上下文感知AI伙伴,帮助用户高效管理海量信息,提升知识工作效率。过屏幕截图和内容理解技术,自动记录用户日常操作(如浏览网页、编辑文档等),支...最新AI资源1年前094.9K
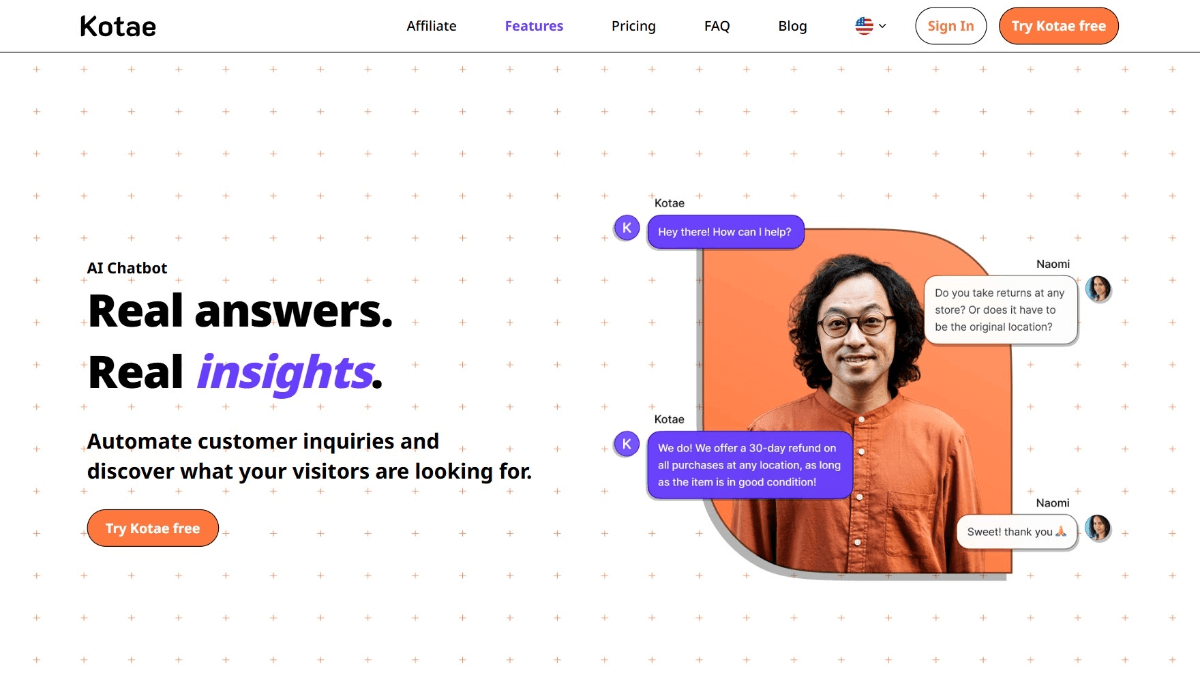
Kotae - AI聊天机器人平台,分析网站内容、培训文件生成准确回答Kotae是专为小型企业设计的智能聊天机器人平台,基于ChatGPT技术开发。平台支持超过80种语言,能快速自然地响应客户咨询,基于分析用户网站内容、培训文件和常见问题解答等生成准确回答。Kotae无...最新AI资源1年前094.9K
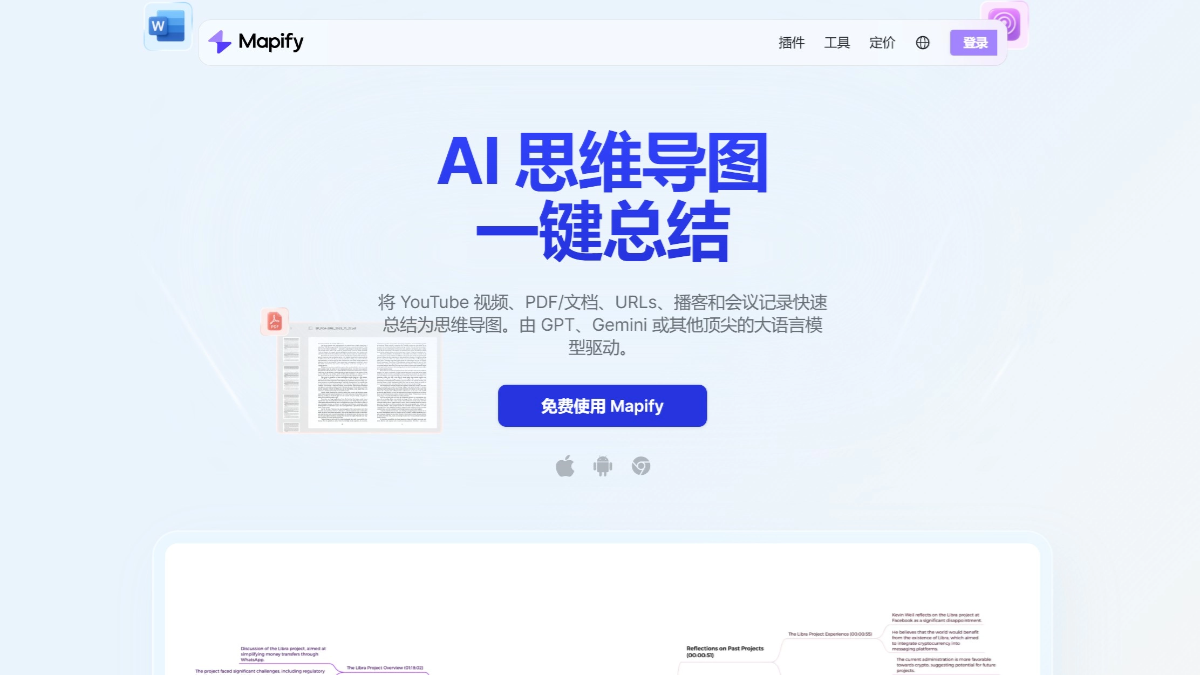
Mapify - XMind推出的AI思维导图生成工具Mapify 是 XMind 团队推出的 AI 思维导图生成工具。能将文本、PDF、网页、视频、音频等多种格式的内容快速转换为结构化的思维导图,帮助用户高效提取和整理关键信息。最新AI资源1年前094.8K
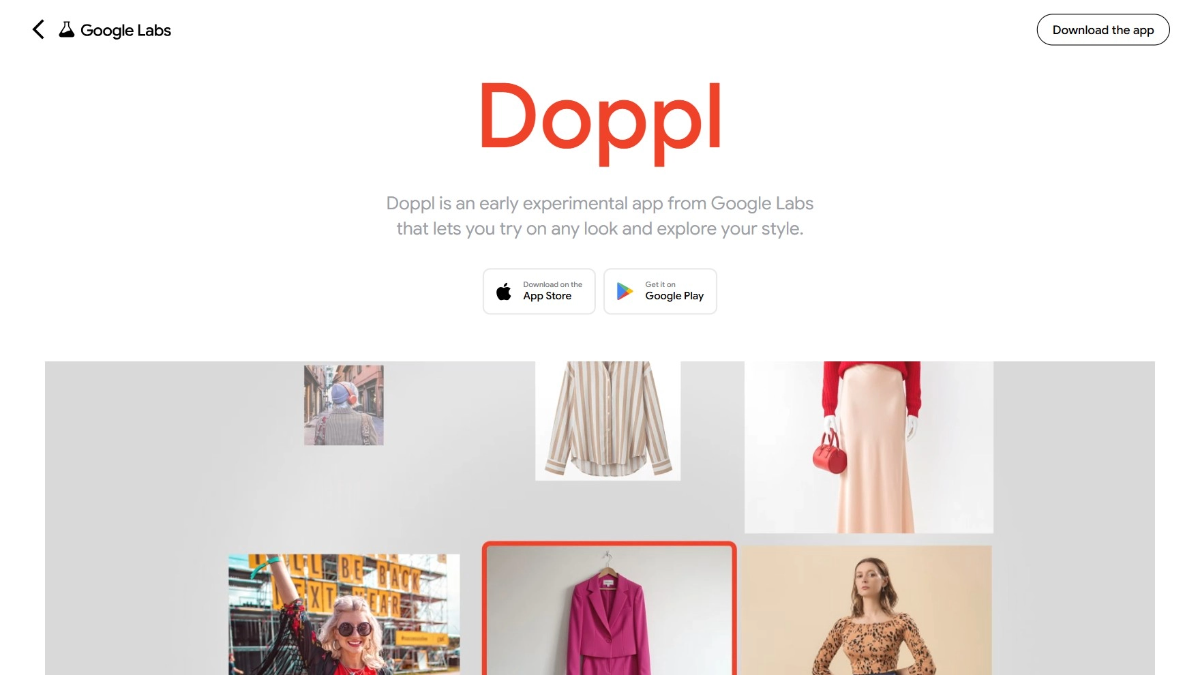
Doppl - 谷歌推出的AI虚拟试衣应用Doppl是谷歌推出的AI虚拟试衣应用。用户上传全身照片后,应用支持将服装图片或截图“穿”在数字版自己身上,且能将静态图片转换为AI生成的视频,让用户更真切地感受服装上身效果。最新AI资源1年前094.8K
商汤如影 - 商汤科技推出的AI数字人视频制作平台商汤如影是商汤科技推出的AI数字人视频制作平台。平台基于大模型技术,支持创建高度逼真的数字人形象,支持个性化定制,包括面部特征、服装、发型等。平台具备声音克隆、视频生成、自动化数据标注、实时互动等功能...最新AI资源1年前094.7K
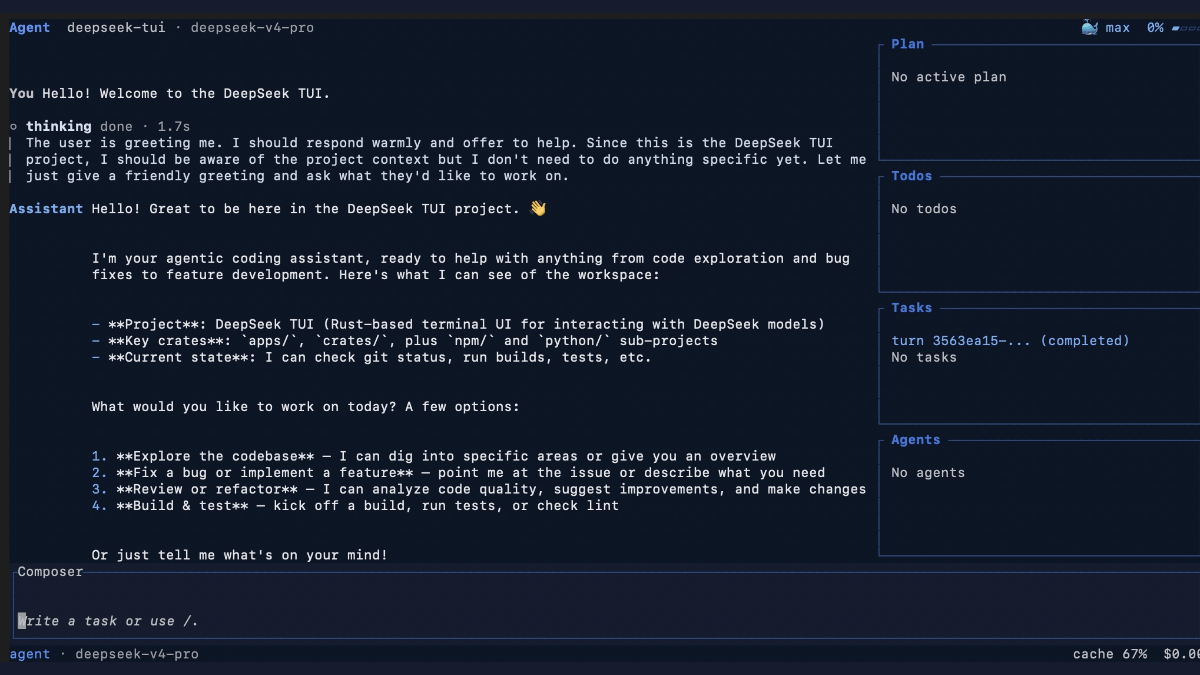
DeepSeek-TUI - 开源终端 AI 编程智能体,终端原生 TUI 界面DeepSeek-TUI 是美国独立开发者 Hunter Bown(GitHub: Hmbown)用 Rust 语言编写的开源终端 AI 编程智能体,专为 DeepSeek V4 系列模型(Pro/F...最新AI资源6个月前094.7K
Hailuo Video Agent - MiniMax推出的AI视频创作AgentHailuo Video Agent 是 MiniMax 稀宇科技推出的零门槛AI视频创作Agent,开放Beta版本。通过简单的文字输入或图片上传,可一键生成高质量的创意视频,涵盖多种应用场景,如广...最新AI资源1年前094.6K
Klic Studio - AI音视频翻译配音工具,一键部署全流程Klic Studio(原Krillin AI)是基于AI的视频翻译、配音和语音克隆工具,专为视频创作者和内容出海者设计。支持一键部署全流程,可将视频从下载到成品输出一键完成,适配抖音、小红书、B站...最新AI资源1年前094.5K
Qwen-Image-Edit - 阿里通义开源的图像编辑模型Qwen-Image-Edit 是阿里通义推出的全能图像编辑模型,基于 200 亿参数的 Qwen-Image 架构构建。模型融合语义与外观的双重编辑能力,能对图像进行低层次的视觉外观编辑(如添加、删...最新AI资源1年前094.4K
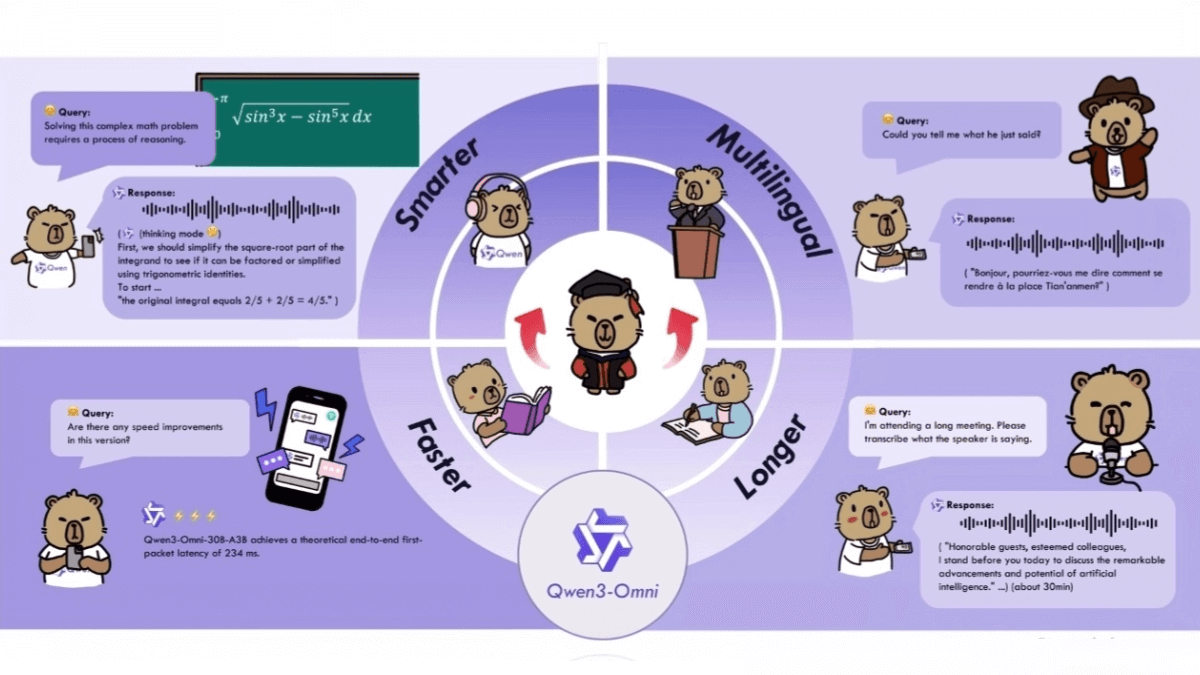
Qwen3-Omni - 阿里通义推出的全模态AI模型Qwen3-Omni 是阿里通义团队推出的全模态 AI 模型,能处理文本、图像、音频和视频等多种数据类型,支持 119 种语言的文本交互,具备低延迟和高度可控的特点。最新AI资源1年前094.4K
OpenAI《在AI时代保持领先》PDF指南 - 附下载链接《Staying ahead in the age of AI》是OpenAI推出的AI领导力指南,助力企业领导者在AI时代保持竞争优势。指南指出AI发展迅猛,模型发布速度加快、成本降低,企业采用速度...最新AI资源课程资料1年前094.4K
FireRed-Image-Edit - 小红书团队开源的通用图像编辑模型FireRed-Image-Edit 是小红书 Super Intelligence 团队开源的通用图像编辑模型,基于扩散 Transformer 架构,在 GEdit、ImgEdit 等多个权威评测...最新AI资源8个月前094.3K
GPT-5 - OpenAI推出的最强语言模型,统一智能系统GPT-5是OpenAI最新发布的语言模型,具有多项升级。是一个统一智能系统,内置实时路由器,能根据问题复杂度自动切换高效模式与深度思考模式,实现快速响应与精准解答。GPT-5拥有多个版本,包括面向普...最新AI资源1年前094.3K
Hyperbolic AgentKit:让Agents拥有自己的计算资源,能够自主管理 GPU、执行区块链操作和社交发布综合介绍 Hyperbolic AgentKit是一个开源项目,旨在提供一个运行AI代理的模板,结合了区块链和计算能力。该项目基于Coinbase的CDP Agentkit进行修改和扩展,支持在终端中...最新AI资源# AI开放服务2年前094.3K
RoboBrain 2.0 - 智谱开源的通用具身大脑模型RoboBrain 2.0 是智谱开源的先进具身大脑模型,为机器人提供强大的感知、推理和规划能力。RoboBrain 2.0包含 7B 和 32B 两个版本,采用异构架构,融合视觉编码器和语言模型,支...最新AI资源1年前094.1K
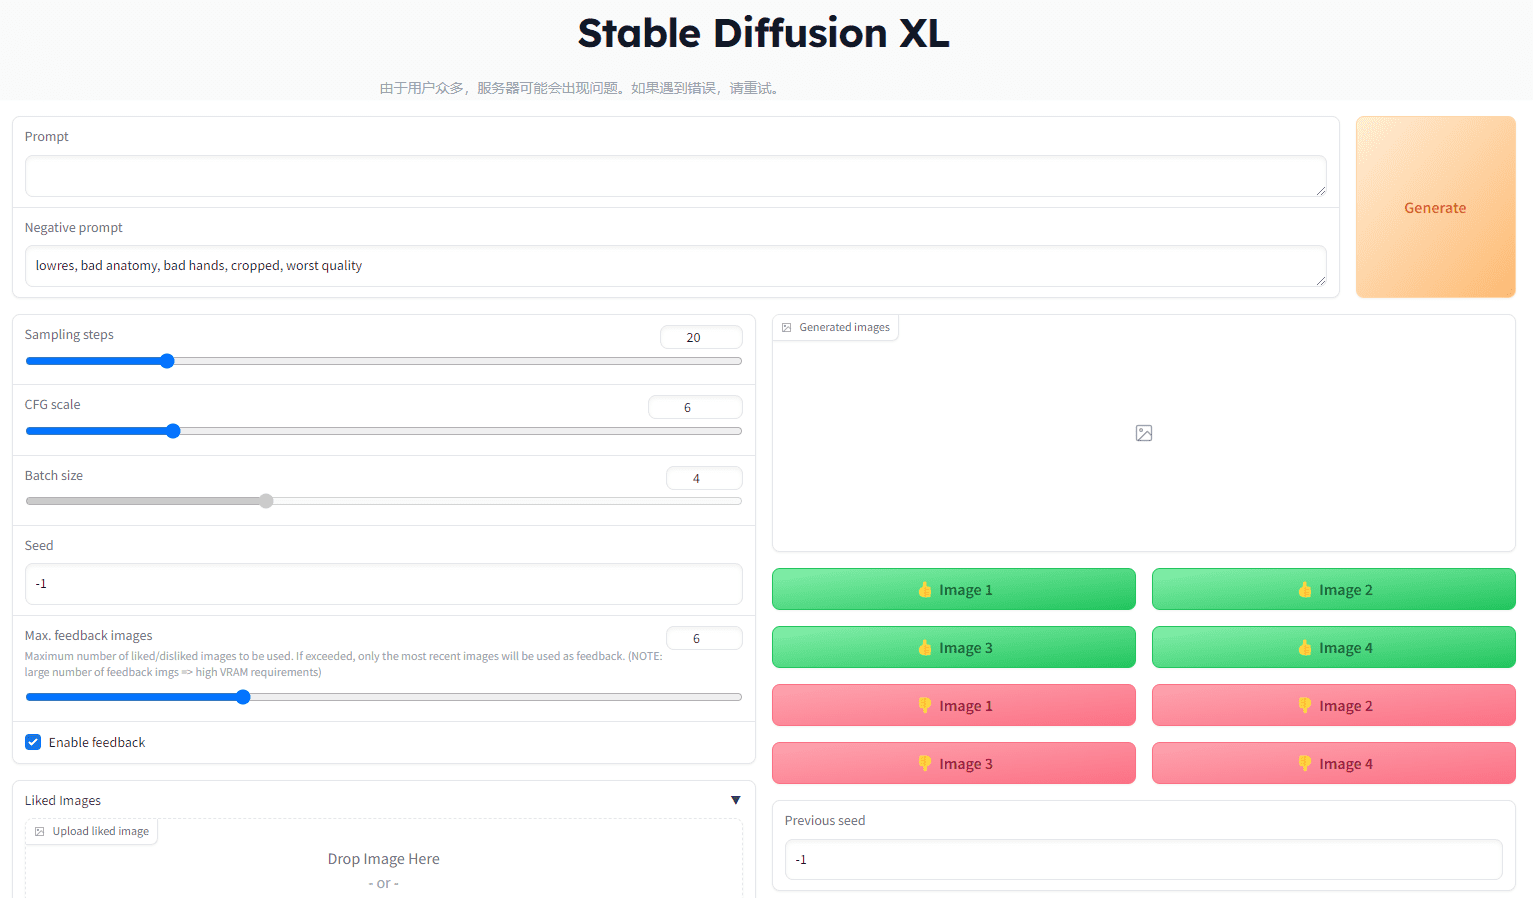
Stable Diffusion Web:在线体验Stable Diffusion XL综合介绍 Stable Diffusion Web是一个在线的稳定扩散模型平台,用户可以免费使用。这个模型用于将文本转换为逼真的图片,提供简单易用的界面。通过输入文本提示并点击“生成”,用户即可快速获...最新AI资源# AI在线生成图像2年前094.1K
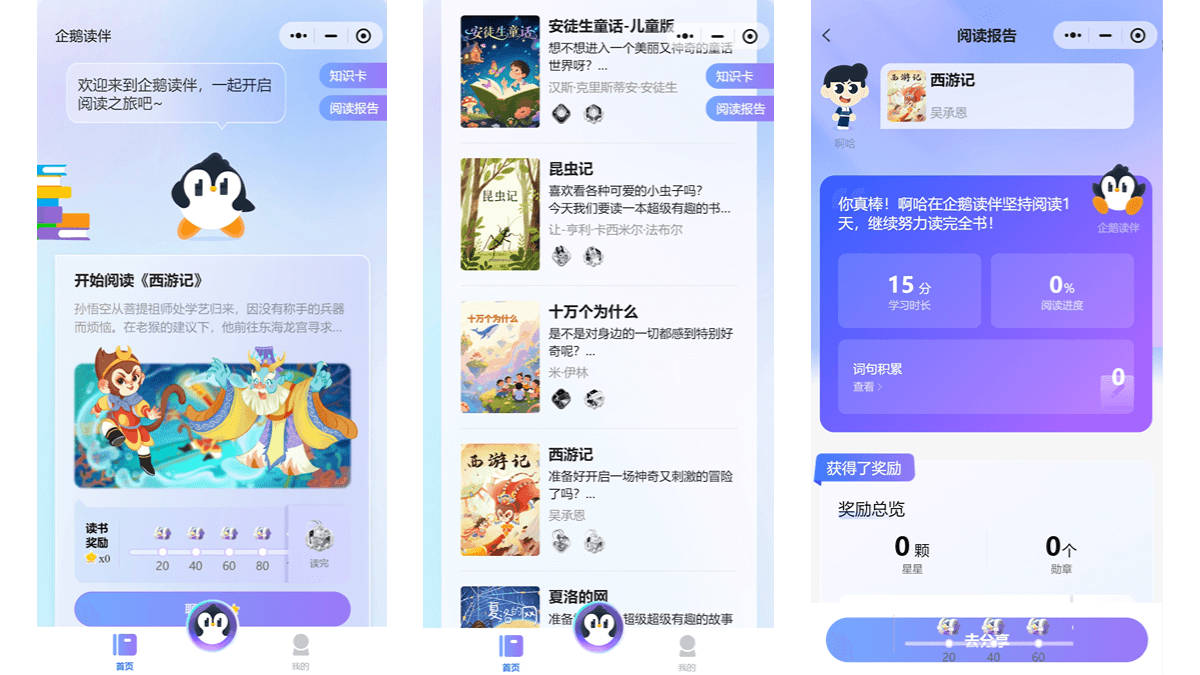
企鹅读伴 - 腾讯推出的中小学生AI阅读助手企鹅读伴是腾讯推出的专为中小学生设计的AI阅读助手。企鹅读伴依托腾讯混元大模型和元器平台,结合《义务教育语文课程方案和课程标准(2022年版)》,为学生提供个性化阅读推荐、多种阅读模式(专注、朗读、听...最新AI资源1年前094.1K
微信ClawBot - 微信官方推出连接 OpenClaw 的 AI 插件微信ClawBot是微信官方推出的AI插件,核心定位是连接OpenClaw(开源AI智能体框架)与微信的消息通道。用户只需在部署OpenClaw的设备上执行一条命令完成安装,可通过微信聊天界面直接发送...最新AI资源7个月前094.1K
DeepSeek-V3.1-Terminus - DeepSeek推出的最新版AI模型DeepSeek-V3.1-Terminus 是 DeepSeek 团队推出的人工智能语言模型,是 DeepSeek-V3.1 的升级版本。模型在语言一致性、代码生成和搜索能力等方面进行优化,能更准确...最新AI资源1年前094.1K
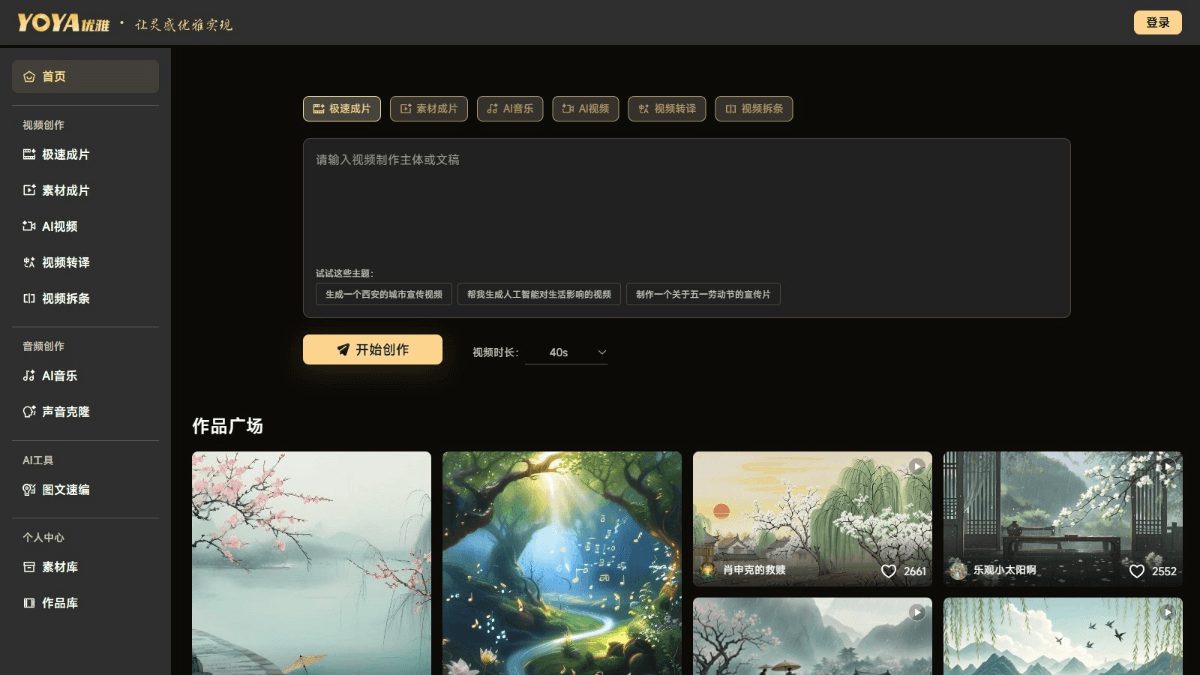
优雅YOYA - 中科闻歌推出的AI音视频内容创作平台优雅YOYA是中科闻歌推出的多模态文生视频平台,平台基于AI多模态技术赋能视频内容创作全链路。用户只需输入主题要求,平台能快速生成脚本、图像、视频,且能完成智能剪辑、语音合成和人物口型驱动等操作,输出...最新AI资源1年前094.1K
gpt-oss - OpenAI推出的开源推理模型系列gpt-oss是 OpenAI 推出的开源推理模型系列,支持为开发者提供高效、灵活且易于部署的 AI 解决方案。gpt-oss包含两个版本,gpt-oss-120B 拥有 1170 亿参数,支持在 8...最新AI资源1年前094.1K
GLM-OCR - 智谱开源的 0.9B 轻量级专业 OCR 模型GLM-OCR 是智谱开源的 0.9B 轻量级专业 OCR 模型,在 OmniDocBench V1.5 以 94.6 分刷新 SOTA。兼顾“小体积”与“全场景”,扫描、手写、印章、多语混排、复杂表...最新AI资源9个月前094K
Gemini 2.5 Flash Image - 谷歌推出的最强图像生成与编辑模型Gemini 2.5 Flash Image(代号nano banana)是谷歌推出的先进图像生成与编辑模型,能保持角色在不同场景中的一致性,支持通过自然语言进行精准图像编辑,如模糊背景、消除污渍等。最新AI资源1年前094K
Confucius3-Math - 网易有道推出专注于数学教育的开源推理模型Confucius3-Math是网易有道开源的国内首个专注于数学教育的开源推理模型。具有140亿参数,专为K-12数学教育场景优化,可在单块消费级GPU(如RTX 4090D)上高效运行,推理性能约为...最新AI资源1年前094K
Nemotron Speech ASR - 英伟达开源的实时语音识别模型Nemotron Speech ASR是英伟达开源的实时语音识别模型,专为低延迟场景优化,支持24毫秒极速转录和多人并发对话。核心采用混合Mamba-Transformer MoE架构,通过固定状态缓...最新AI资源10个月前094K
Curiosity:使用LangGraph构建类似 Perplexity 的AI搜索工具综合介绍 Curiosity 是一个旨在探索和实验的项目,主要使用 LangGraph 和 FastHTML 技术栈,目标是构建一个类似 Perplexity AI 的搜索产品。项目的核心是一个简单的...最新AI资源# AI开源项目# AI搜索工具2年前093.9K
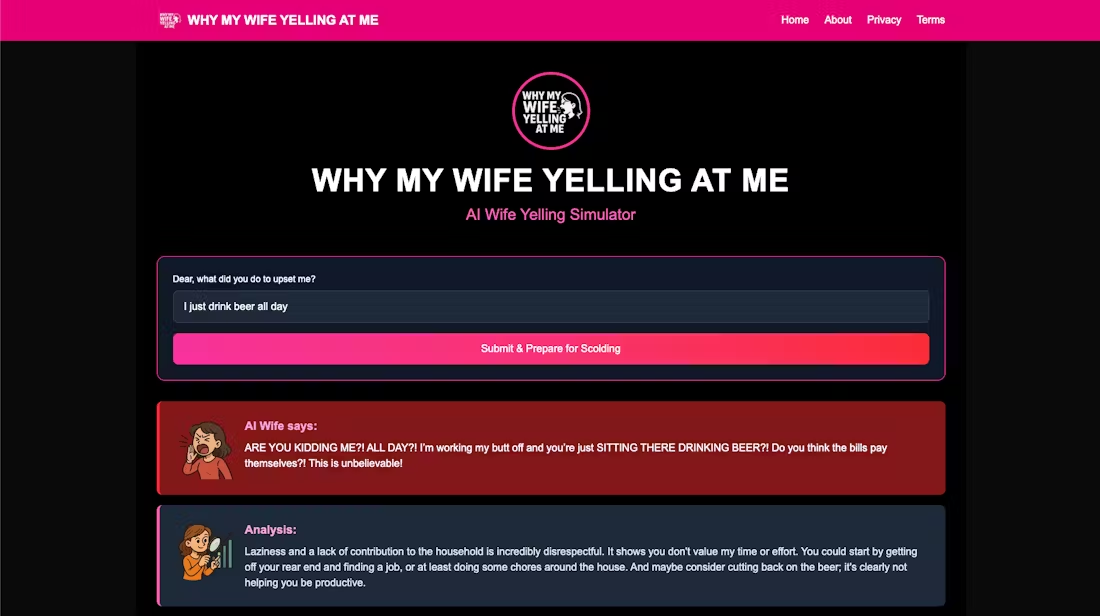
Why My Wife Yelling At Me:模拟婚姻沟通的互动工具综合介绍 “Why My Wife Yelling At Me”是一个独特的婚姻关系模拟网站,旨在通过人工智能帮助用户理解伴侣的情感反应和沟通模式。用户可以输入不同场景,体验虚拟伴侣的反应,模拟真实的...最新AI资源2年前093.9K
PilotDeck - 清华、面壁智能、OpenBMB等开源的Agent 操作系统PilotDeck 是清华大学 THUNLP 实验室、面壁智能、OpenBMB 与 AI9Stars 联合研发并开源的 Agent 操作系统。以WorkSpace(工作舱)为核心架构,为每个任务提供独...最新AI资源5个月前093.9K
SkyReels-A3 - 昆仑万维推出的音频驱动数字人创作工具SkyReels-A3 是昆仑万维集团推出的音频驱动数字人创作工具。能通过简单的输入(如人像图片和语音)生成高质量的动态视频内容,让静态照片“活”起来,可以为现有视频更换台词,人物会自动对上新的口型...最新AI资源1年前093.8K
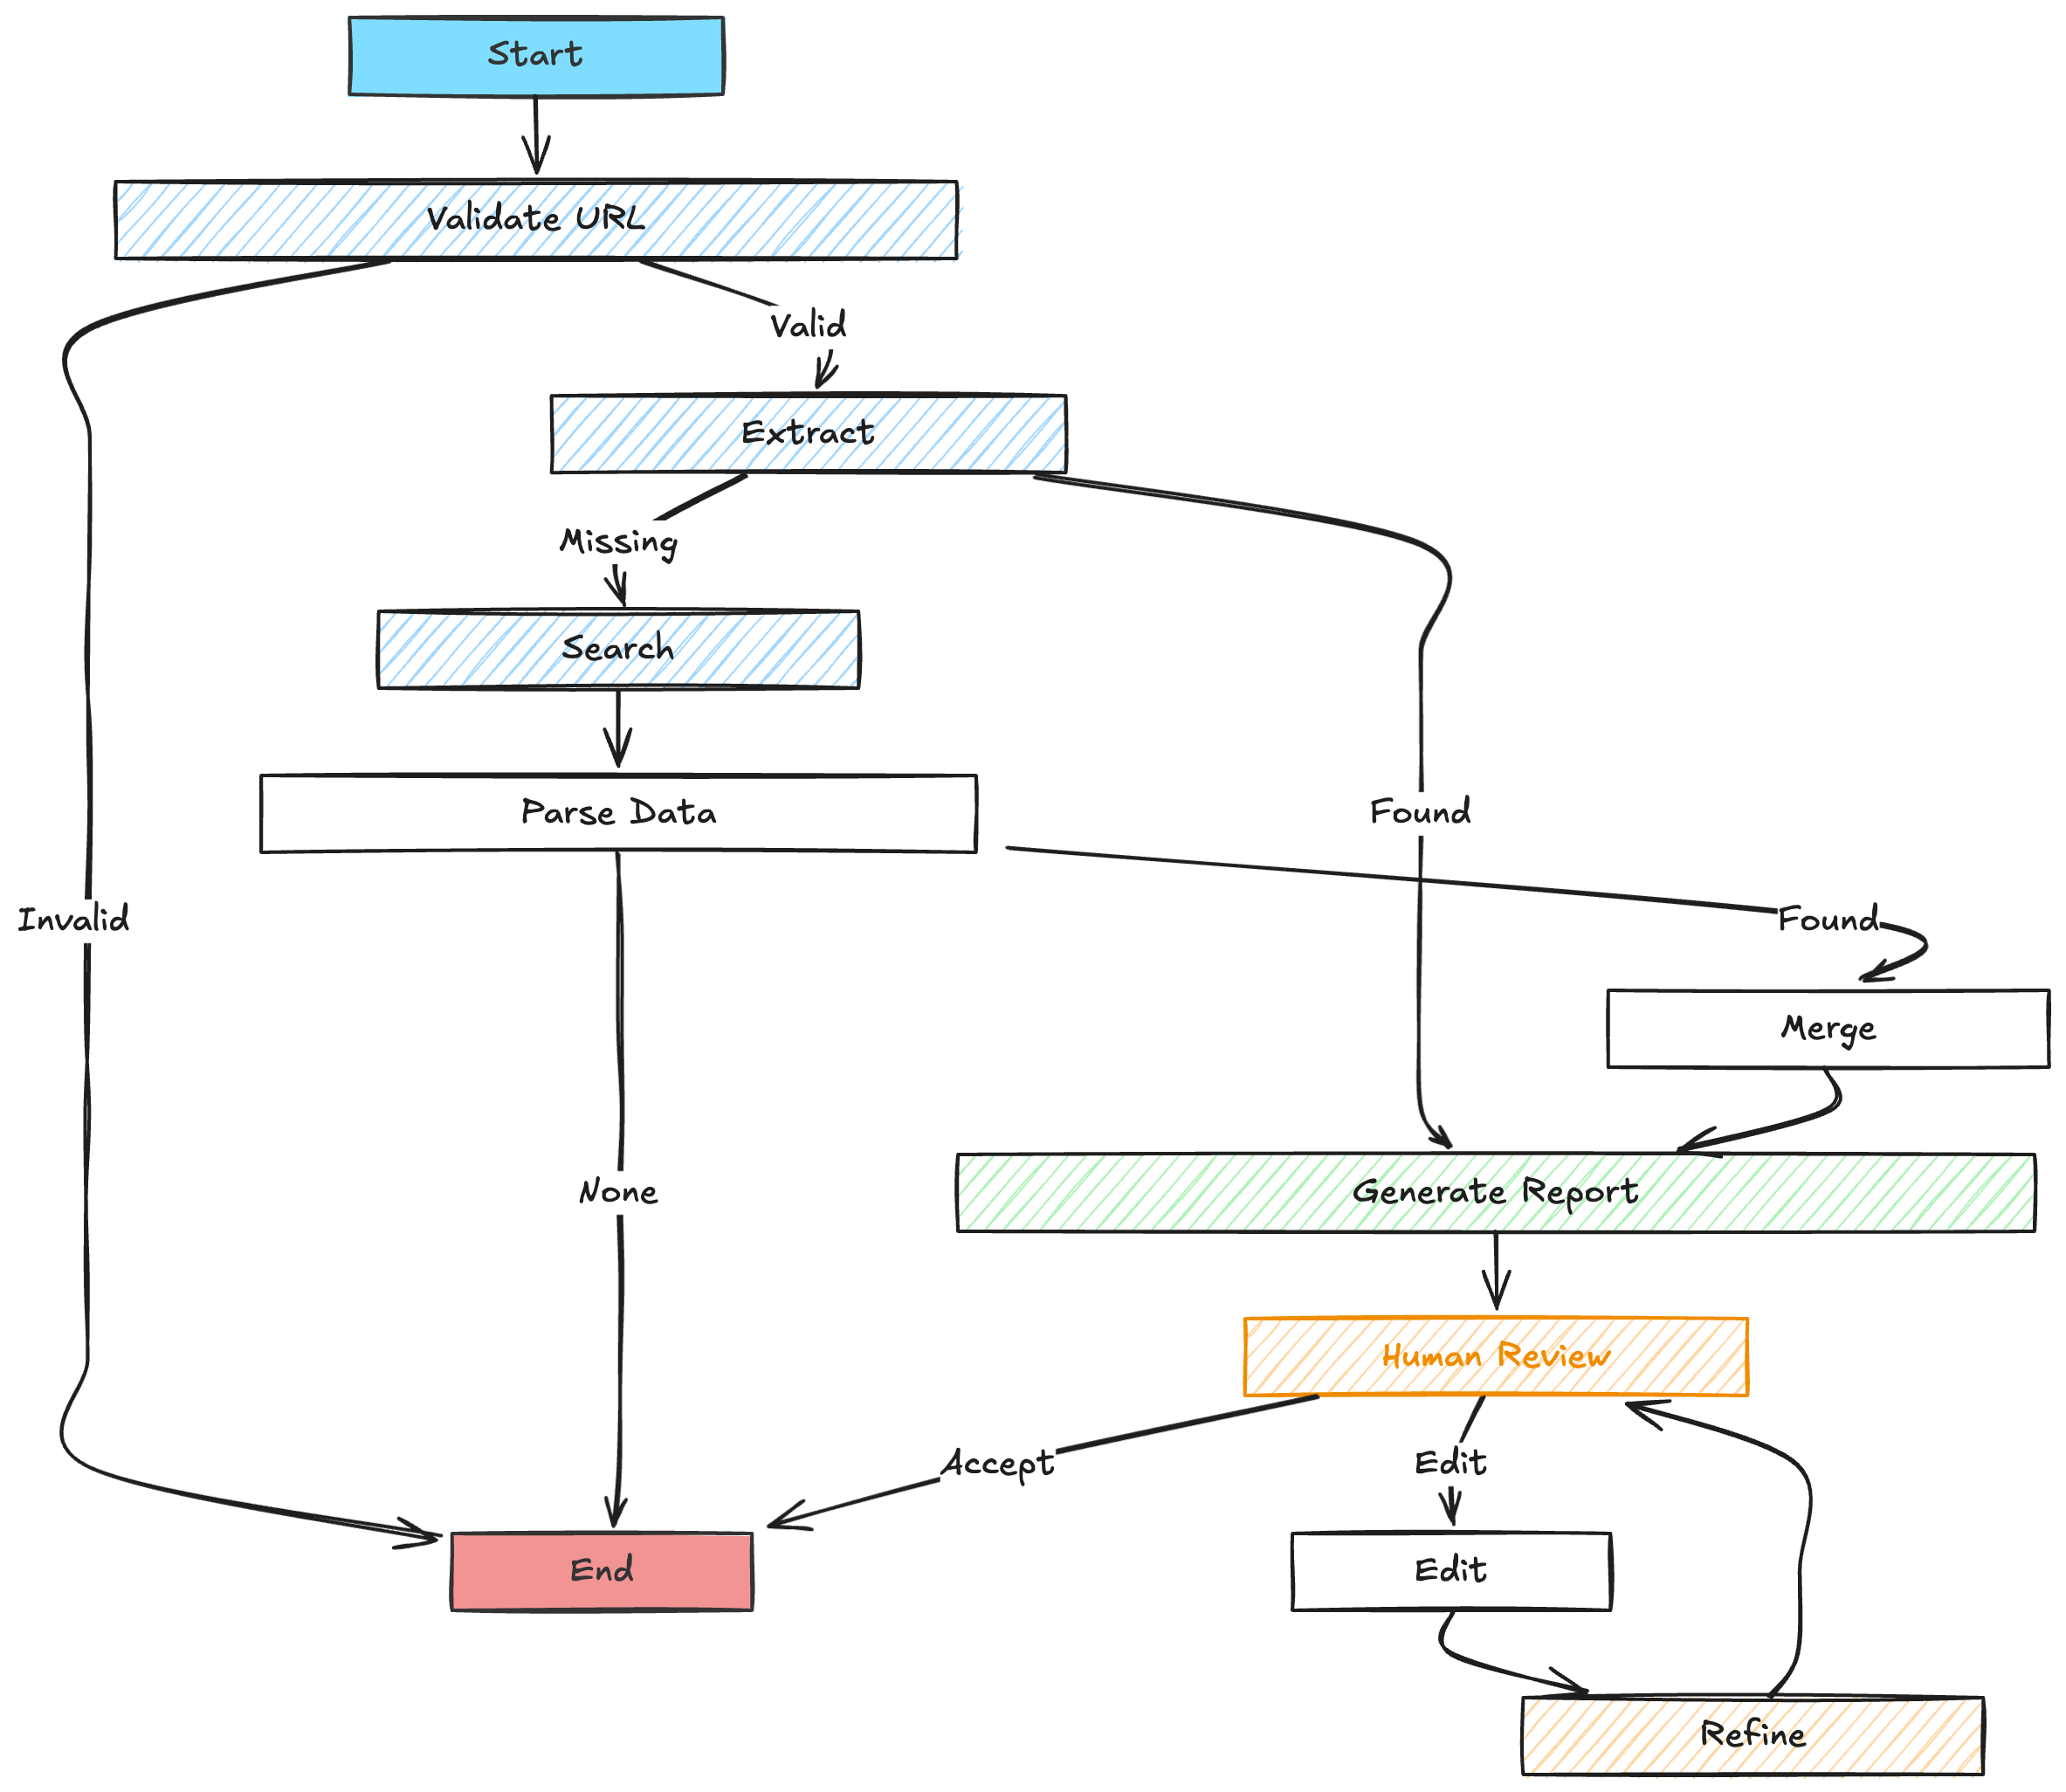
AI Agent Company Researcher:自动化公司信息研究情报员综合介绍 AI公司研究助手是一个基于人工智能的工具,旨在自动化公司研究和潜在客户挖掘过程。通过使用LangGraph和FireCrawl等技术,该工具能够在短短几分钟内生成详细的公司研究报告。用户只需...最新AI资源2年前093.6K
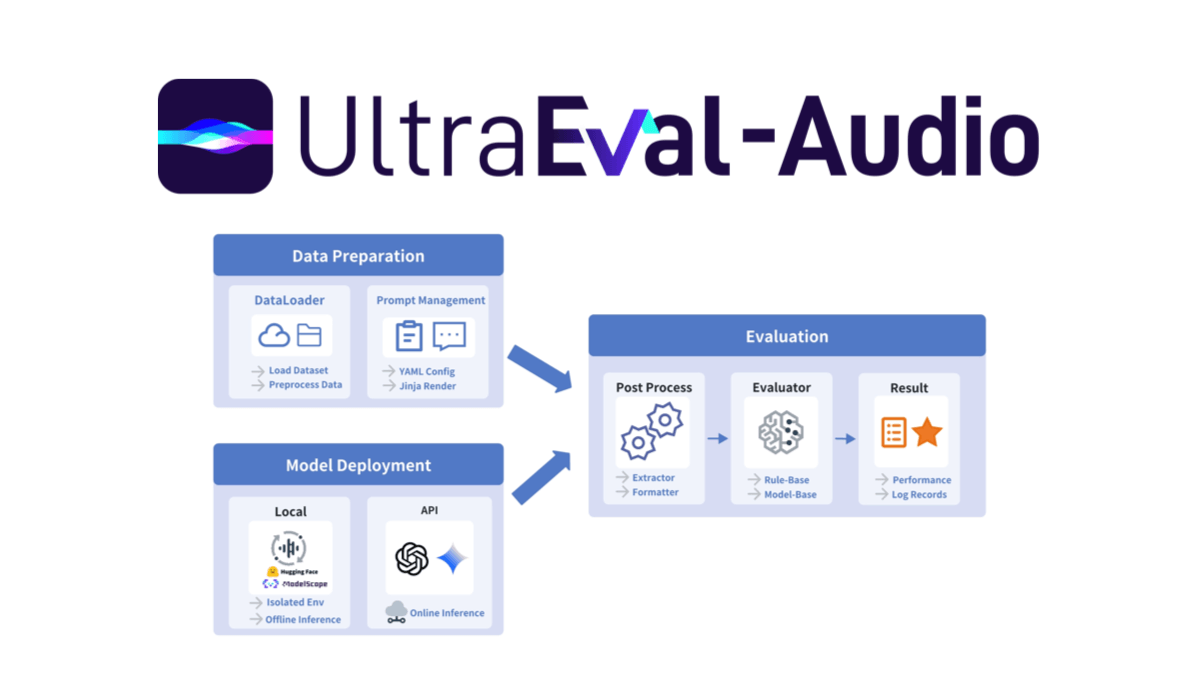
UltraEval-Audio - 清华、OpenBMB联合面壁智能开源的音频模型评测框架UltraEval-Audio是清华大学NLP实验室、OpenBMB和面壁智能联合开发的音频模型评测框架,最新版本为v1.1.0。专注于解决音频模型复现难、依赖冲突等问题,提供一键复现热门模型(如Vo...最新AI资源10个月前093.6K
ChatGPT Agent – OpenAI推出的通用智能AI AgentChatGPT Agent 是 OpenAI 推出的通用AI Agent,融合多种能力,能自主完成复杂任务。用户只需用自然语言描述需求,Agent 能自动选择合适工具,比如浏览网页、提取信息、运行代码...最新AI资源1年前093.5K
NeverEnds:使用文字描述生成效果逼真的视频综合介绍 NeverEnds是一个来自新加坡的平台,通过先进的模型将文字转换成视频,为各类故事提供了一个无限的创作空间。用户可以在这个平台上自由表达创意,传达情感,以及建设自己的品牌形象。这个平台以独...最新AI资源# AI图像转视频# AI文本转视频2年前093.4K
Lumina-DiMOO - 上海AI Lab联合华为昇腾开源的多模态大模型Lumina-DiMOO是上海人工智能实验室联合华为昇腾在2025年世界人工智能大会上推出的新一代多模态生成与理解统一模型。基于昇腾AI基础软硬件平台与MindSpeed MM多模态大模型套件,完成了...最新AI资源1年前093.4K
Ring-2.5-1T - 蚂蚁百灵开源的万亿参数混合线性架构思考模型Ring-2.5-1T 是蚂蚁集团百灵大模型团队开源的全球首个万亿参数混合线性架构思考模型,采用1:7 MLA与Lightning Linear Attention混合设计,激活参数量达63B。模型在...最新AI资源9个月前093.3K
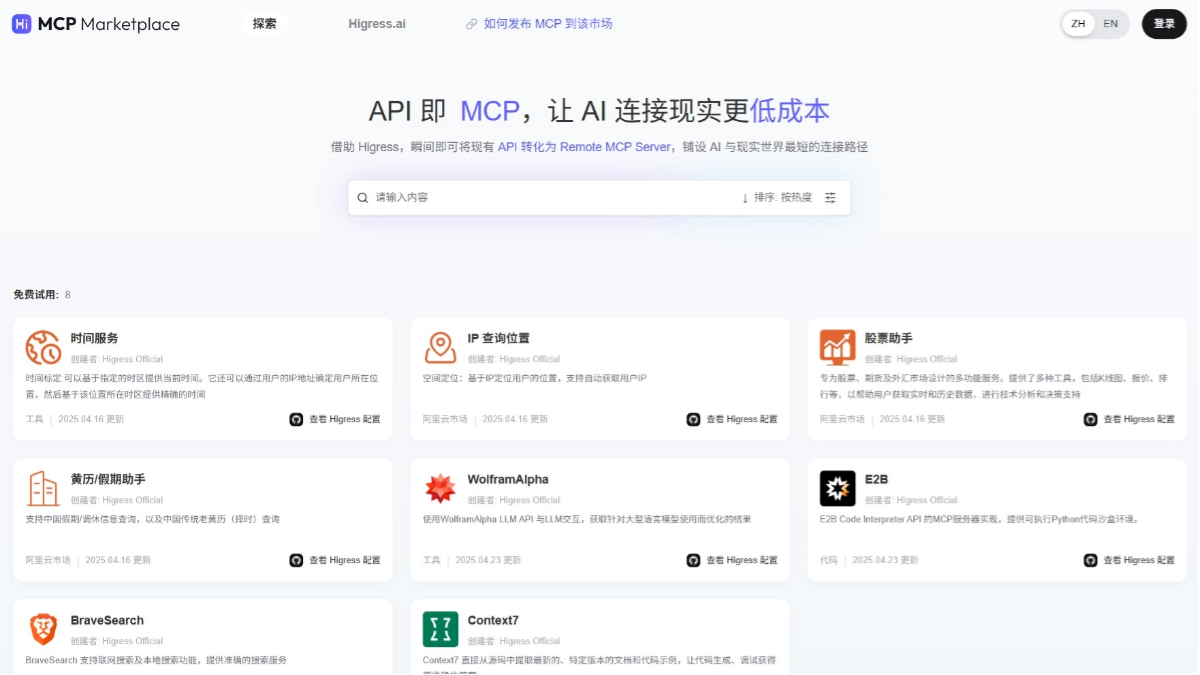
Higress MCP - 今日投资推出的MCP服务平台Higress MCP 是今日投资推出的创新型平台,支持将传统金融数据API快速转化为现代化的MCP服务。Higress MCP基于简单配置即可实现REST API到MCP Server的转换,无需编...最新AI资源1年前093.3K
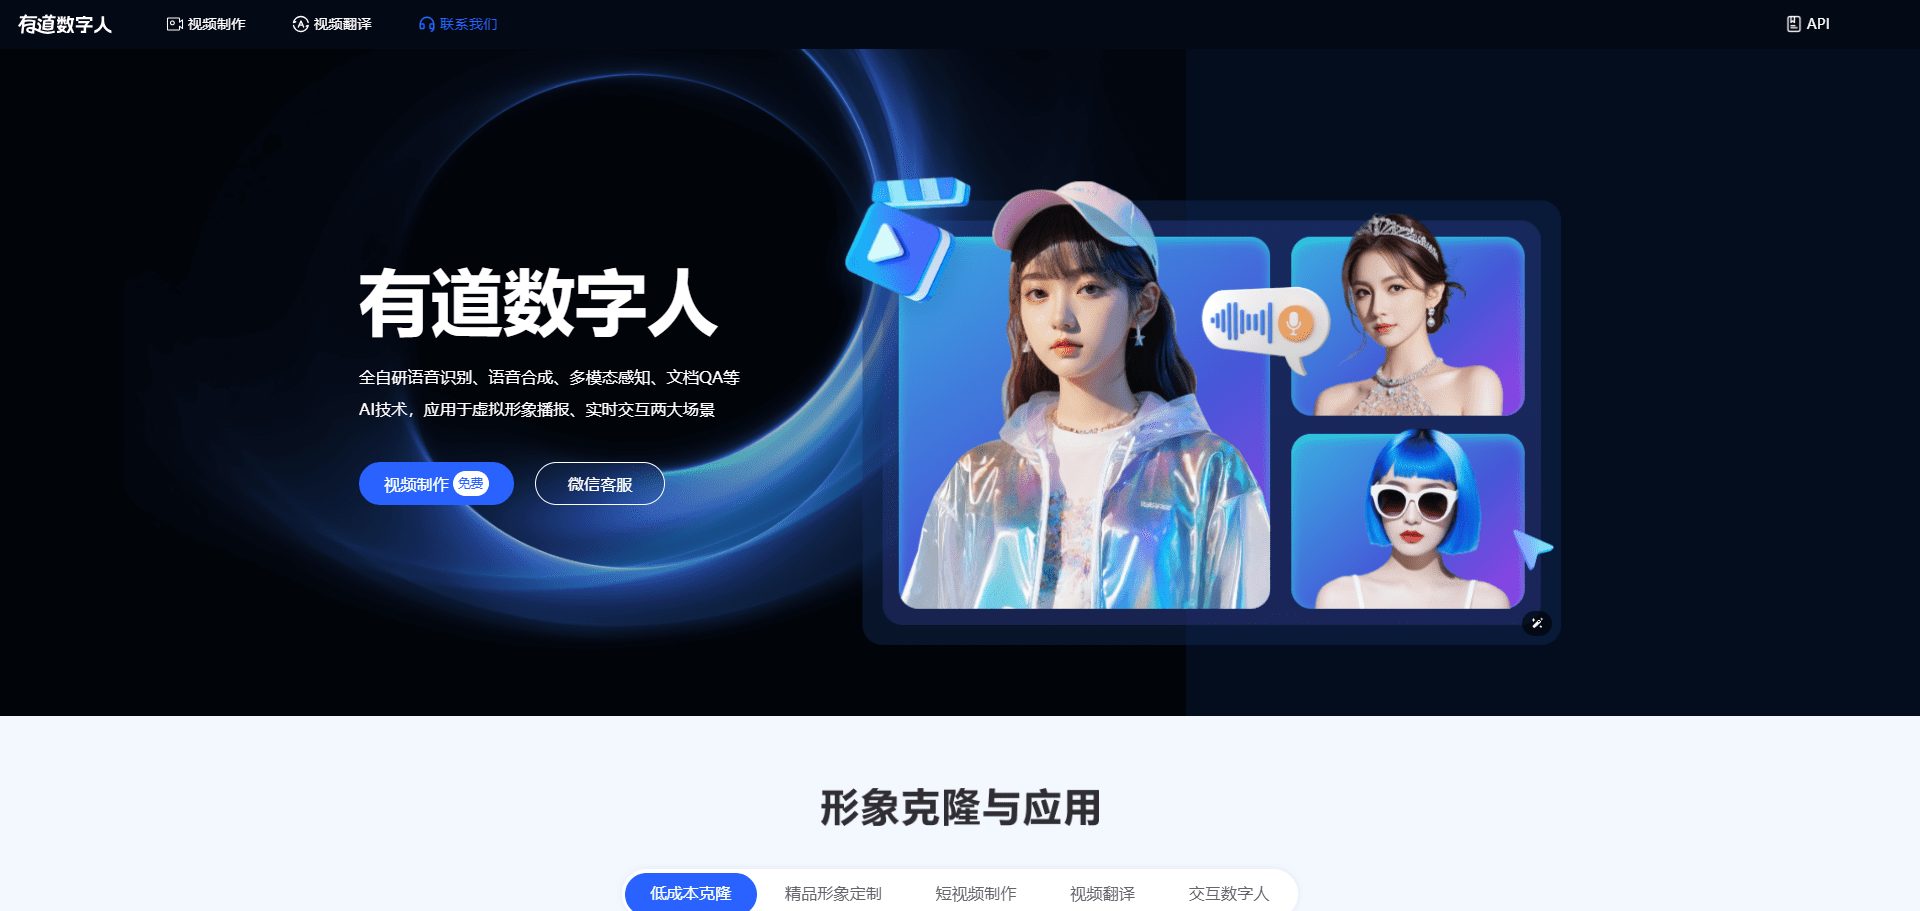
有道数字人:虚拟形象播报与实时交互平台|免费制作克隆数字人综合介绍 有道数字人是一个集成了先进AI技术的平台,专注于提供虚拟形象播报和实时交互服务。平台利用自研的语音识别、语音合成、多模态感知和文档问答技术,为用户打造逼真的数字人分身,支持视频制作、翻译、教...最新AI资源# AI数字人# AI语音克隆2年前093.3K
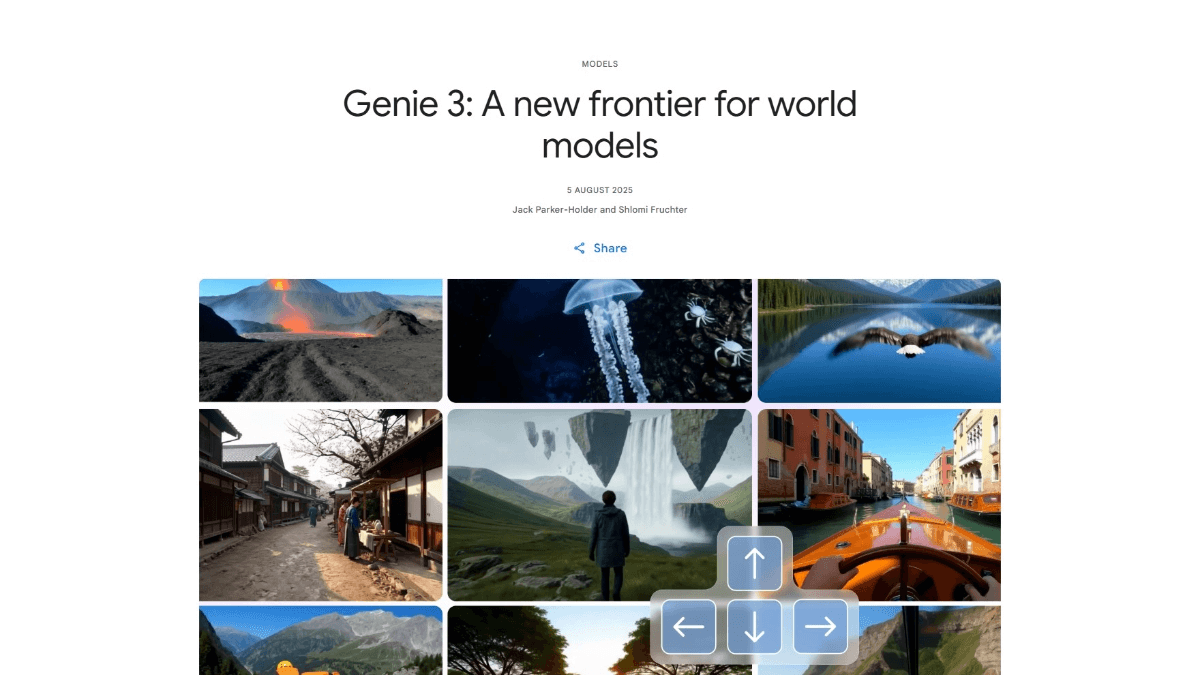
Genie 3 - 谷歌推出的通用世界模型Genie 3 是谷歌 DeepMind 推出的新一代通用世界模型,支持实时生成高度动态且连贯的虚拟世界。Genie 3 能模拟物理现象、自然生态系统,还支持创建奇幻场景和历史场景。用文本提示,用户能...最新AI资源1年前093.3K
Magistral - Mistral AI 推出的系列推理模型Magistral 是 Mistral AI 推出的推理模型,专注透明、多语言和特定领域的推理能力。模型包含开源版(Magistral Small)和企业版(Magistral Medium),后者在...最新AI资源1年前093.2K
JoyHallo - 京东开源的AI数字人模型JoyHallo是京东开源的AI数字人模型,专为普通话设计,支持将音频转化为逼真的说话视频。JoyHallo基于wav2vec2模型嵌入音频特征,用半解耦结构,提升唇部运动预测准确性,支持生成英语视频...最新AI资源1年前093.1K
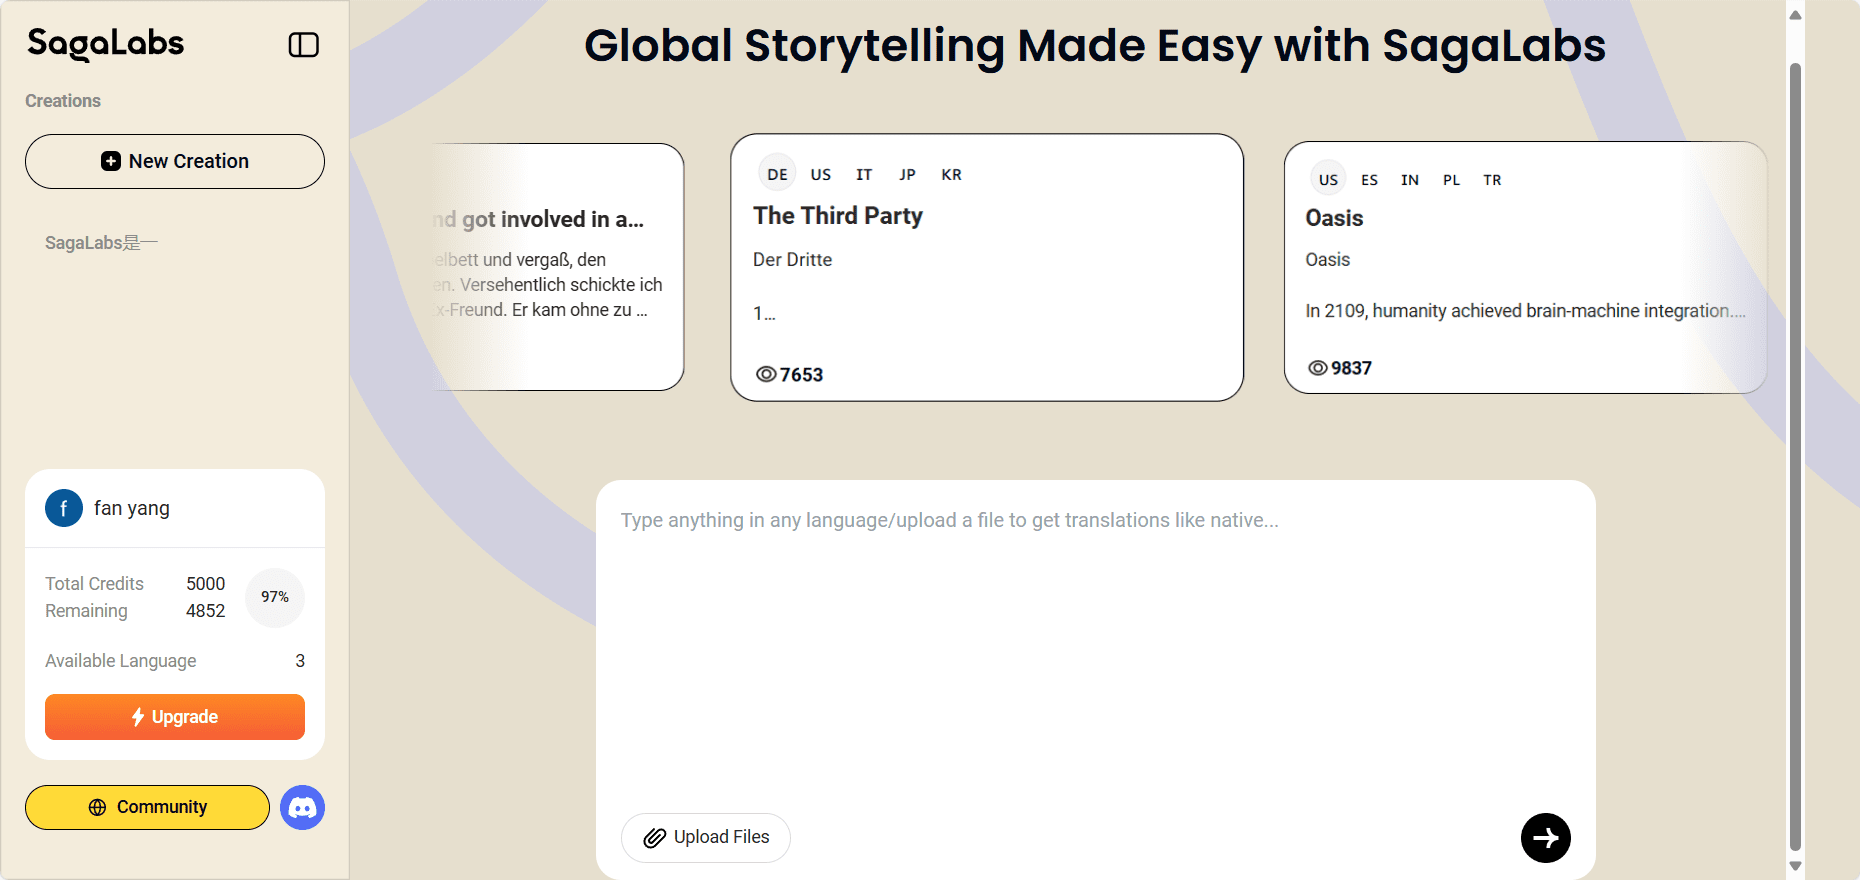
SagaLabs:AI驱动的文学、小说和剧本翻译工具,针对全球市场内容本地化综合介绍 SagaLabs是一个AI驱动的翻译工具和内容平台,专为创作者设计,帮助他们将故事本地化并推广到全球市场。该平台支持200多种语言的翻译,确保翻译质量达到母语专家水平。SagaLabs不仅关...最新AI资源# AI翻译2年前093.1K
Baichuan-M2 - 百川智能推出开源的医疗增强大模型Baichuan-M2 是百川智能推出的开源医疗增强大模型。在医疗领域表现出色,特别是在HealthBench评测中以60.1分的成绩超越了OpenAI的gpt-oss120b等众多开源模型,成为全球...最新AI资源1年前092.9K
Qwen3Guard - 阿里Qwen开源的安全模型Qwen3Guard 是基于 Qwen3 基础模型微调的安全防护模型,专为安全检测而设计。能对提示词和响应进行精确的安全分类,提供风险等级,支持英语、中文和多语言环境。Qwen3Guard 有两个专业...最新AI资源1年前092.8K
Cosmos 3 - NVIDIA 开源的物理 AI 全模态模型Cosmos 3 是 NVIDIA 开源的首个完全开放的物理 AI 全模态模型,采用创新的 Mixture-of-Transformers(MoT)架构,将视觉推理、物理世界生成与动作预测统一在单一系...最新AI资源5个月前092.7K
CRIC深度智联 - 克而瑞推出的中国房地产首个AI AgentCRIC深度智联是克而瑞自主研发的中国房地产首个AI智能体,基于克而瑞20年房地产行业经验和数据积累与多模态大模型技术,打通数据整合、智能分析到内容生成全链路。最新AI资源1年前092.7K
Clacky AI - AI编程助手,面向开发者的云端开发环境Clacky AI是面向开发者的云端开发环境(CDE),致力于打造L3级别的AI编程助手。工具支持多种编程语言,包括Python、Node.js、Golang、Ruby和Java等,能帮助开发者快速将...最新AI资源1年前092.6K
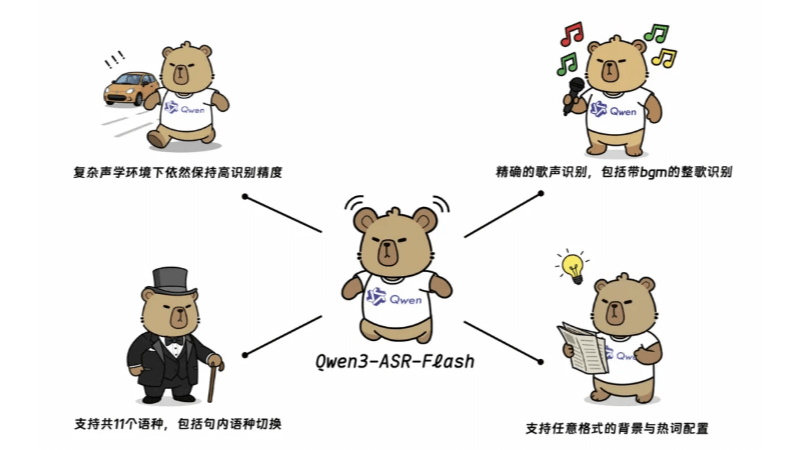
Qwen3-ASR-Flash - 阿里通义千问推出的系列语音识别模型Qwen3-ASR-Flash 是阿里巴巴最新推出的高精度语音识别模型,基于 Qwen3 基座模型,经海量多模态数据训练而成。支持 11 种语言和多种口音,包括普通话、四川话、闽南语、吴语、粤语等方言...最新AI资源1年前092.6K
Kandinsky 5.0 - 俄罗斯AI团队开源的视频生成模型系列Kandinsky 5.0是俄罗斯AI团队开发的最新视频生成模型系列,主打轻量化设计与高性能表现。系列首款模型Kandinsky 5.0 Video Lite仅20亿参数却超越了同类14B大模型,尤其...最新AI资源1年前092.6K
MiniMax Music 1.5 - MiniMax最新推出的AI音乐生成模型MiniMax Music 1.5 是先进的 AI 音乐生成工具,支持根据用户的自然语言描述,生成长达4分钟的音乐作品。模型支持多种音乐风格和情绪定制,生成的人声音色自然饱满,转音顺畅,编曲层次丰富...最新AI资源1年前092.6K
Seed-OSS - 字节跳动团队开源的全新AI模型Seed-OSS是字节跳动Seed团队开源的大型语言模型系列,专注于长文本和推理任务。模型在复杂逻辑推理和多步推理中表现出色,准确率高,能高效解决难题。Seed-OSS支持长达512K的长文本上下文...最新AI资源1年前092.5K
AntSK FileChunk - 免费的AI语义文档切片工具,动态切片调整AntSK FileChunk 是免费的智能文档切片工具,专为 RAG(检索增强生成)应用设计。以语义为核心,将文档智能切分为语义完整、连贯的片段,支持多语言,可动态调整切片大小,确保上下文连贯性。最新AI资源1年前092.5K
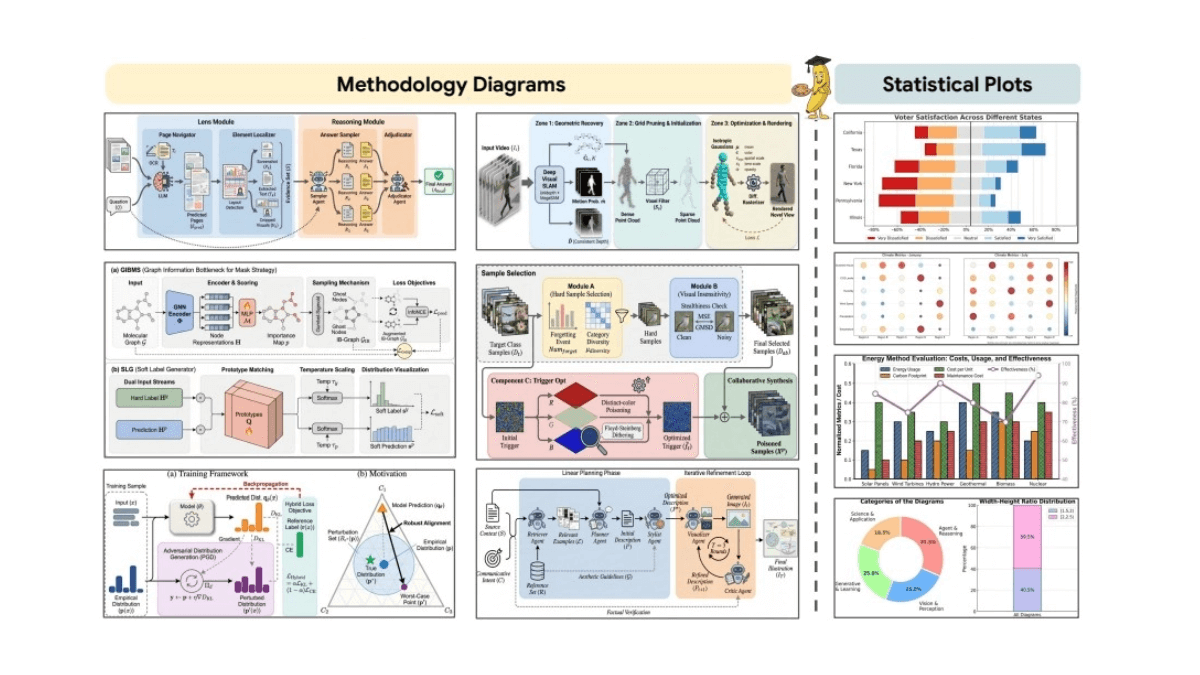
PaperBanana - 北大与谷歌联合开源的AI学术插图自动生成框架PaperBanana是北大与谷歌团队联合开源的AI学术插图自动生成框架,专门解决科研人员绘制方法示意图和统计图表的痛点。框架通过五个智能体协作(检索、规划、造型、渲染和批评),实现从文本描述到Neu...最新AI资源9个月前092.4K
PaddleOCR-VL - 百度开源的超轻量级视觉-语言模型PaddleOCR-VL是百度开源的超轻量级视觉-语言模型,专为文档解析场景优化。模型仅含0.9B参数,通过融合动态高分辨率视觉编码器与轻量级ERNIE语言模型,在保持高精度的同时显著降低计算开销。最新AI资源1年前092.4K
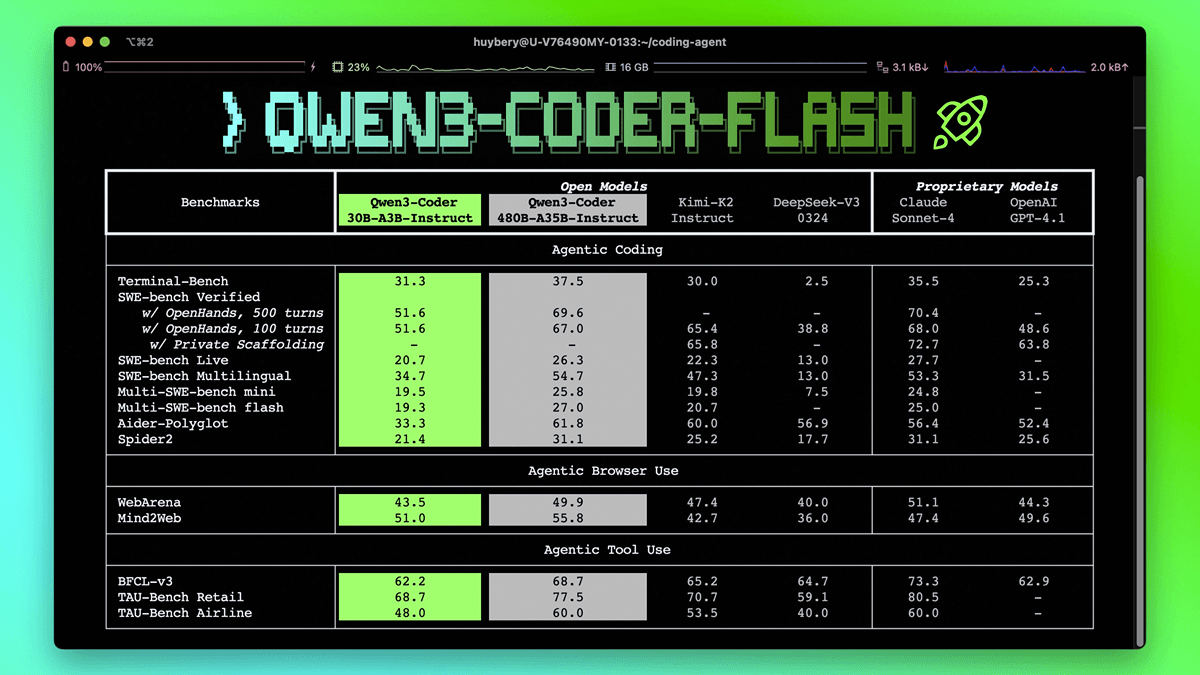
Qwen3-Coder-Flash - 阿里通义推出的开源高性能编程模型Qwen3-Coder-Flash 是阿里通义千问团队推出的高性能编程模型,具备卓越的代理式编程和工具调用能力,擅长处理复杂编程任务。模型支持 256K tokens 的长上下文理解,能扩展至 1M ...最新AI资源1年前092.4K
Hunyuan-GameCraft - 腾讯混元开源的下一代游戏交互式视频生成框架Hunyuan-GameCraft 是腾讯 Hunyuan 团队开源的交互式游戏视频生成框架。框架能从单张图片和提示生成高动态的游戏视频,支持用户通过键盘和鼠标实时控制视频内容。最新AI资源1年前092.3K
GLM-4.7-Flash - 智谱开源的混合专家架构语言模型GLM-4.7-Flash是智谱开源的混合专家架构语言模型,参数规模为30B,激活参数量3B,上下文窗口达200K,最大输出令牌为128K。在编程能力上表现出色,SWE-bench验证集分数达59.2...最新AI资源10个月前092.3K
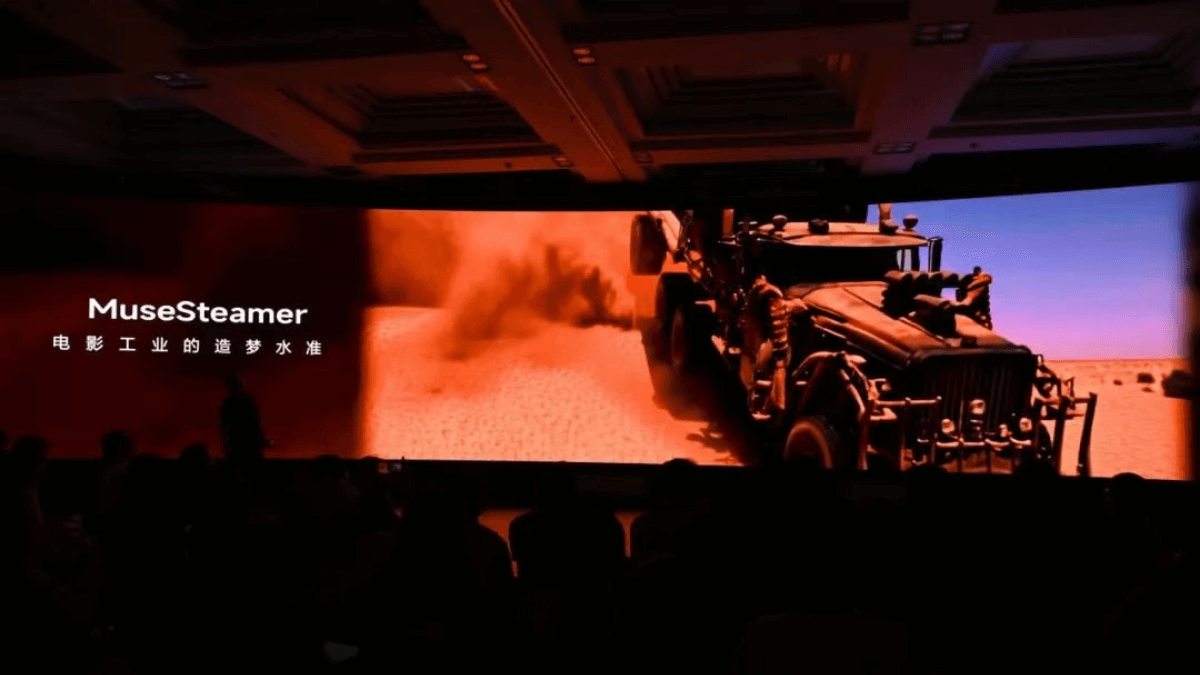
MuseSteamer - 百度推出的视频生成大模型MuseSteamer是百度推出的多模态视频生成大模型。模型能根据用户提供的文字描述或图片,快速生成高质量的动态视频内容,支持多种清晰度和功能版本,满足不同场景下的创作需求。最新AI资源1年前092.3K
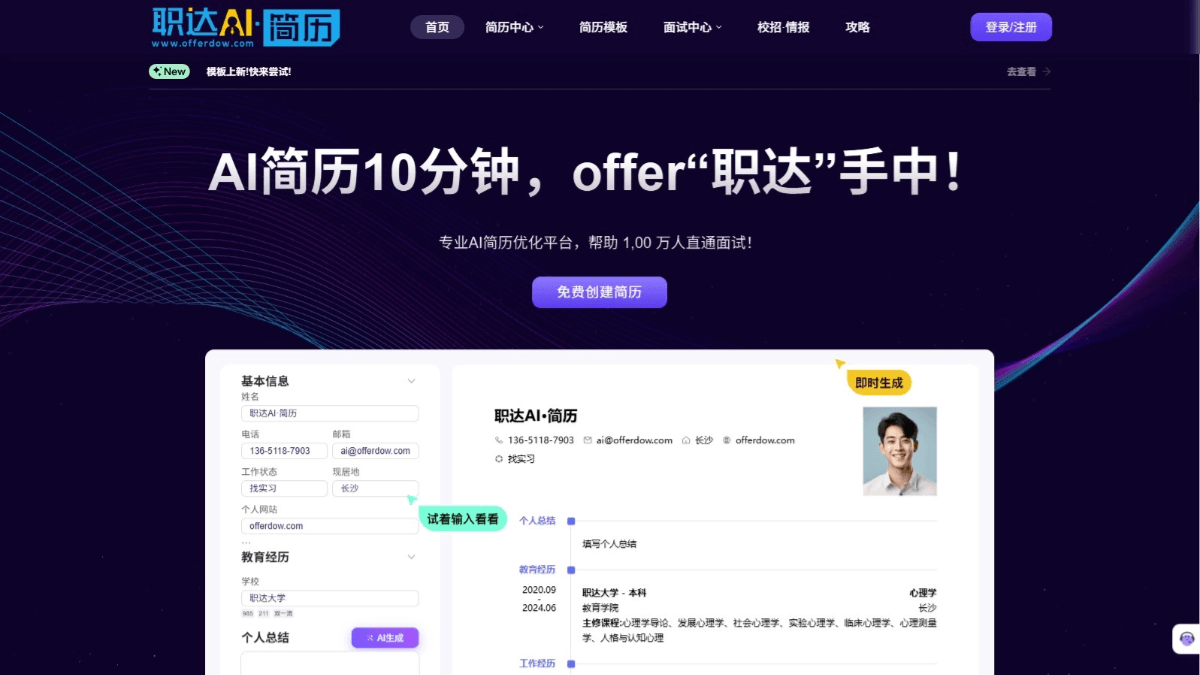
职达AI简历 - AI简历生成与优化平台,精准分析问题、提供优化建议职达AI简历是高效便捷的智能简历生成与优化平台。平台基于AI技术,帮助用户快速生成专业个性化的简历。用户只需输入基本信息和经历,平台能在短时间内生成优质简历,提供2800+精美模板,覆盖多种岗位。最新AI资源1年前092.3K
茴香豆:基于LLM(大型语言模型) 的群聊助手综合介绍 HuixiangDou 是一个基于大型语言模型(LLM)的群聊助手,旨在通过三阶段的预处理、拒绝和响应流程来应对群聊场景。它能够在不造成信息泛滥的情况下回答用户问题。该项目提供了完整的Web...最新AI资源# AI开源项目2年前092.2K
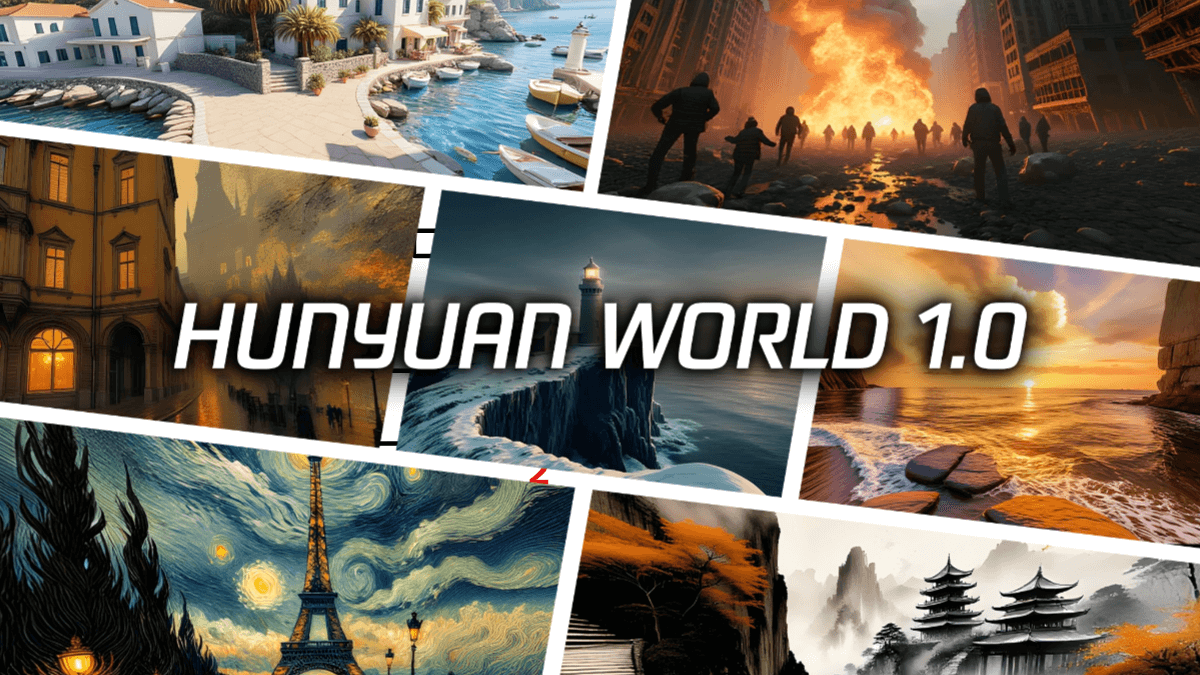
混元3D世界模型 1.0 - 腾讯推出的开源3D世界生成模型混元3D世界模型 1.0(Hunyuan World 1.0 )是腾讯开源的业界首个可沉浸漫游、可交互、可仿真的世界生成模型。模型融合全景视觉生成与分层3D重建技术,支持用文字或图片输入,快速生成36...最新AI资源1年前092.2K
Step-Audio-R1.1 - 阶跃星辰开源的全球首个原生语音推理模型Step-Audio-R1.1是阶跃星辰开源的全球首个原生语音推理模型,最新升级版本在权威评测榜单Artificial Analysis Speech Reasoning中以96.4%准确率登顶。模型...最新AI资源10个月前092.1K
ConverzAI - AI招聘平台,自动收集候选人信息进行筛选ConverzAI是基于AI技术的招聘平台,能优化招聘流程。平台基于部署虚拟招聘人员(AI Agents),自动从申请追踪系统(ATS)中收集候选人信息并进行初步筛选。平台用电话、邮件、短信等多种渠道...最新AI资源1年前092.1K
Aholo Viewer - 群核科技开源的3D高斯浏览器Aholo Viewer是群核科技开源的3D高斯浏览器,支持在普通设备浏览器中流畅渲染10亿级高斯点的超大3D场景。核心技术采用chunk-based LOD树架构,相比李飞飞团队的Spark 2.0...最新AI资源5个月前092.1K
Mureka V7.5 - 昆仑万维推出的先进AI音乐创作模型Mureka V7.5 是昆仑万维推出的先进 AI 音乐生成模型,专注于中文歌曲创作。模型能精准还原音色与演奏技法,生成自然流畅且富有情感的歌声。基于优化的自动语音识别(ASR)技术,Mureka V...最新AI资源1年前092K
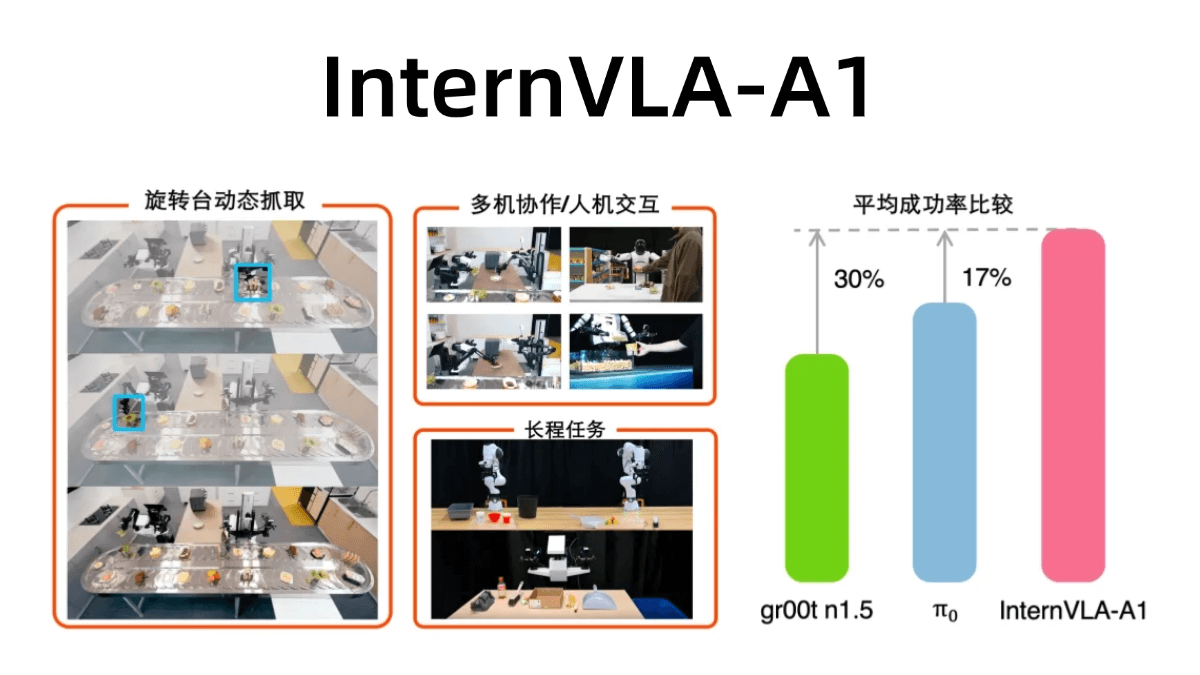
InternVLA-A1 - 上海AI Lab开源一体化操作能力的具身大模型InternVLA-A1 是上海人工智能实验室开源的具身操作大模型。具备理解、想象、执行一体化的能力,能精准地完成任务。模型融合了真实和模拟的操作数据,通过大规模虚实混合场景资产,自动化构建海量多模态...最新AI资源1年前091.9K
GLM-Experimental - 智谱AI推出的实验性模型GLM-Experimental 是智谱 AI 推出的实验性大语言模型,已在 Z.ai 平台上线。模型具备自动生成 PPT 的能力,用户输入主题或要点后,模型能快速生成结构清晰、格式规范的演示文稿,将...最新AI资源1年前091.9K
MedASR - 谷歌开源的医疗语音识别模型MedASR是谷歌开源的1.05亿参数医疗语音识别模型,在5000小时脱敏临床语料上微调,针对药品、剂量、解剖术语优化,内置6-gram医学语言模型,在私有放射科数据集RAD-DICT上词错率仅4.6...最新AI资源10个月前091.9K
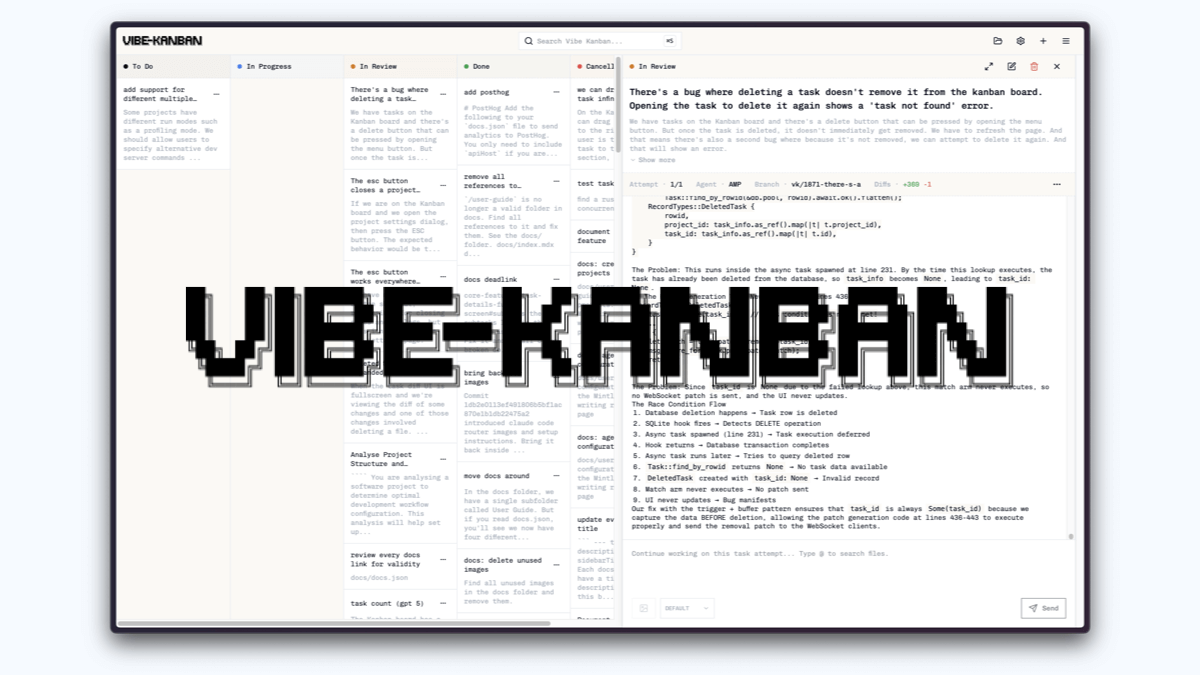
Vibe Kanban - 开源的免费AI编程代理任务管理工具Vibe Kanban是开源的AI编程代理任务管理工具,专为同时使用多个AI编程助手(如Claude Code、Gemini CLI、Codex等)的开发者设计。通过看板形式统一管理任务进度,支持并行...最新AI资源10个月前091.9K
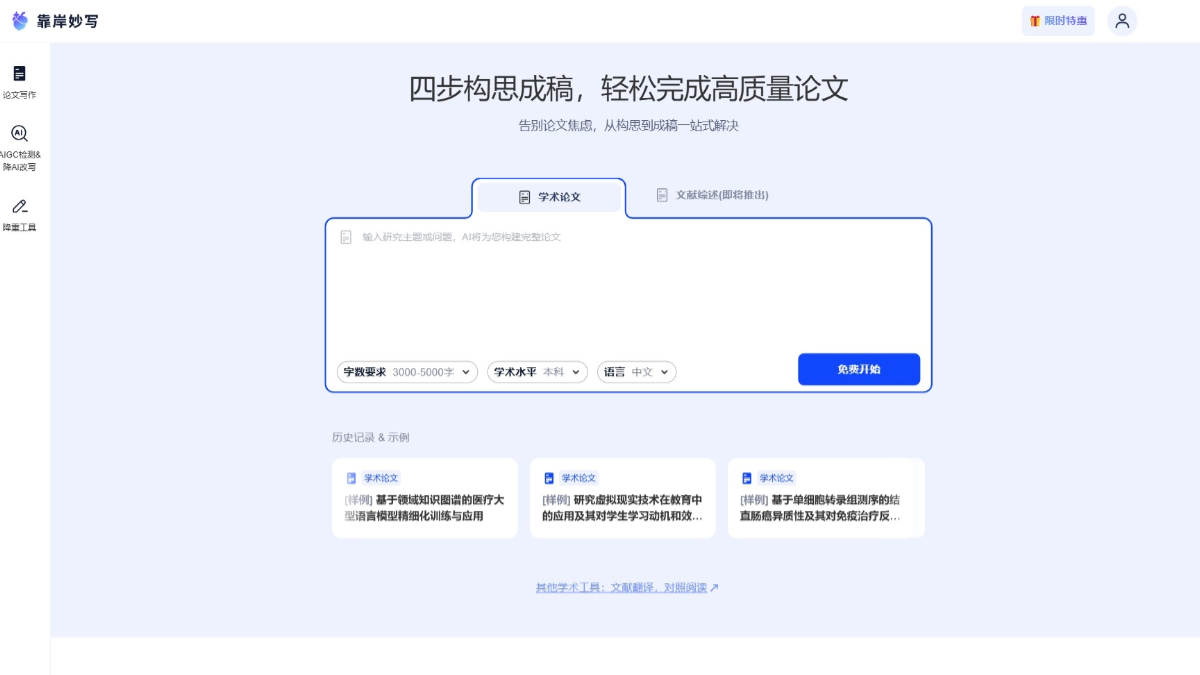
靠岸妙写 - AI论文写作工具,构思到成稿一站式解决靠岸妙写是AI论文写作工具,为学术写作提供高效、便捷的解决方案。工具支持一键生成论文大纲、摘要和正文初稿,适用本科、硕士等不同层次的学术需求,覆盖理工科、文科和社科等多学科领域。最新AI资源1年前091.8K
FactSnap - 新一代AI信息核查工具FactSnap是新一代AI信息核查工具,帮助用户快速验证网页信息的真实性。通过集成多种模型和搜索引擎,在用户浏览网页时对选中的文字进行实时核查。最新AI资源1年前091.8K
Clawith - DataElem 团队开源的多智能体协作平台Clawith 是 DataElem 团队开源的"OpenClaw for Teams"——面向团队的多智能体协作平台。在保留 OpenClaw 灵魂与记忆能力的基础上,升级为 Aware 自主感知系...最新AI资源8个月前091.8K
Qwen3-VL-Reranker - 阿里巴巴推出的多模态重排序模型Qwen3-VL-Reranker是阿里巴巴推出的多模态重排序模型,专门用于提升跨模态检索的精准度。与Qwen3-VL-Embedding协同工作:前者负责快速召回候选结果,后者通过深度跨模态交互(如...最新AI资源10个月前091.8K
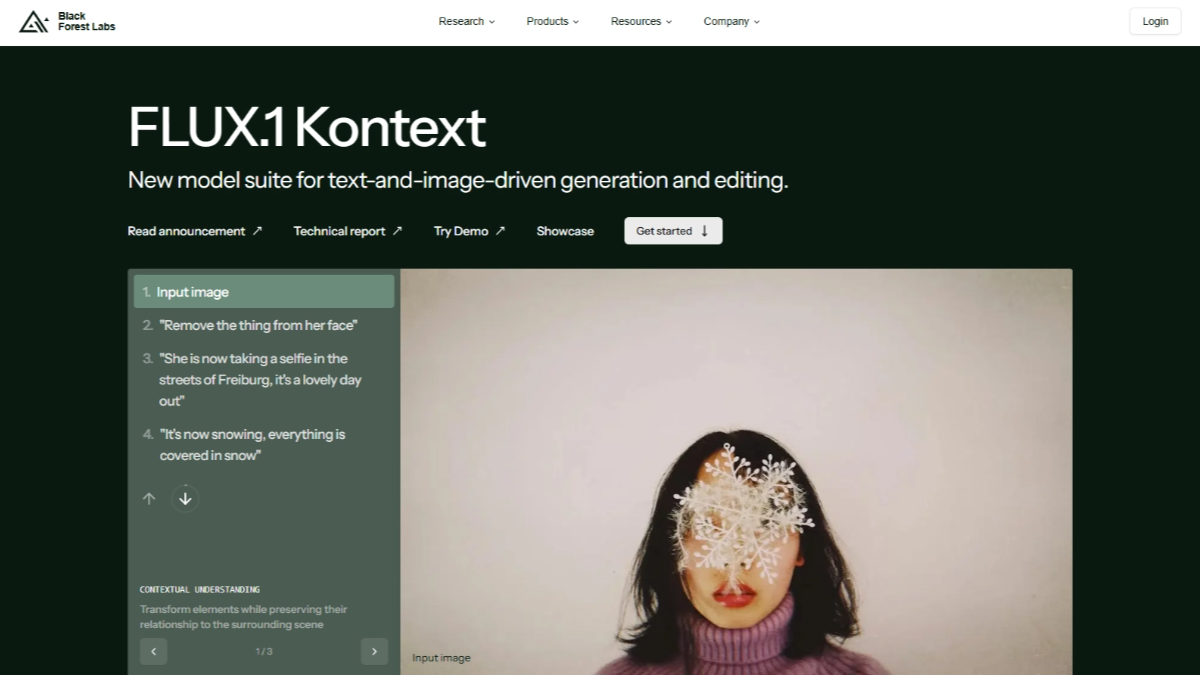
FLUX.1 Kontext - 黑森林推出的图像生成与编辑模型FLUX.1 Kontext是Black Forest Labs推出的图像生成与编辑模型,提供上下文感知的图像处理技术。模型能理解响应文本和图像提示,执行对象修改、风格转换、背景替换等任务,同时保持角...最新AI资源1年前091.7K
SkyReels-V3 - 昆仑万维Skywork AI开源的多模态视频生成模型SkyReels-V3是昆仑万维Skywork AI开源的多模态视频生成模型,被誉为视频生成领域的"全能型"标杆。模型基于"一核多支"的统一架构,在单一建模框架内集成三大核心能力:参考图像转视频、智能...最新AI资源9个月前091.6K
Skywork-SWE-32B - 昆仑万维开源的自主代码智能体基座模型Skywork-SWE-32B是昆仑万维推出的开源的32B规模的软件工程(SWE)自主代码智能体基座模型。模型专注于软件工程任务,具备强大的仓库级代码修复能力,能在多轮交互和长文本处理的复杂场景中表现...最新AI资源1年前091.6K
Shortbread - AI漫画生成工具,自然语言描述完成漫画创作Shortbread是AI漫画生成工具,用户基于简单的自然语言描述快速创作出完整的漫画作品。Shortbread无需任何绘图技能,只需输入文字,AI快速生成具有独特角色、场景和情感的个性化漫画。Sho...最新AI资源1年前091.5K
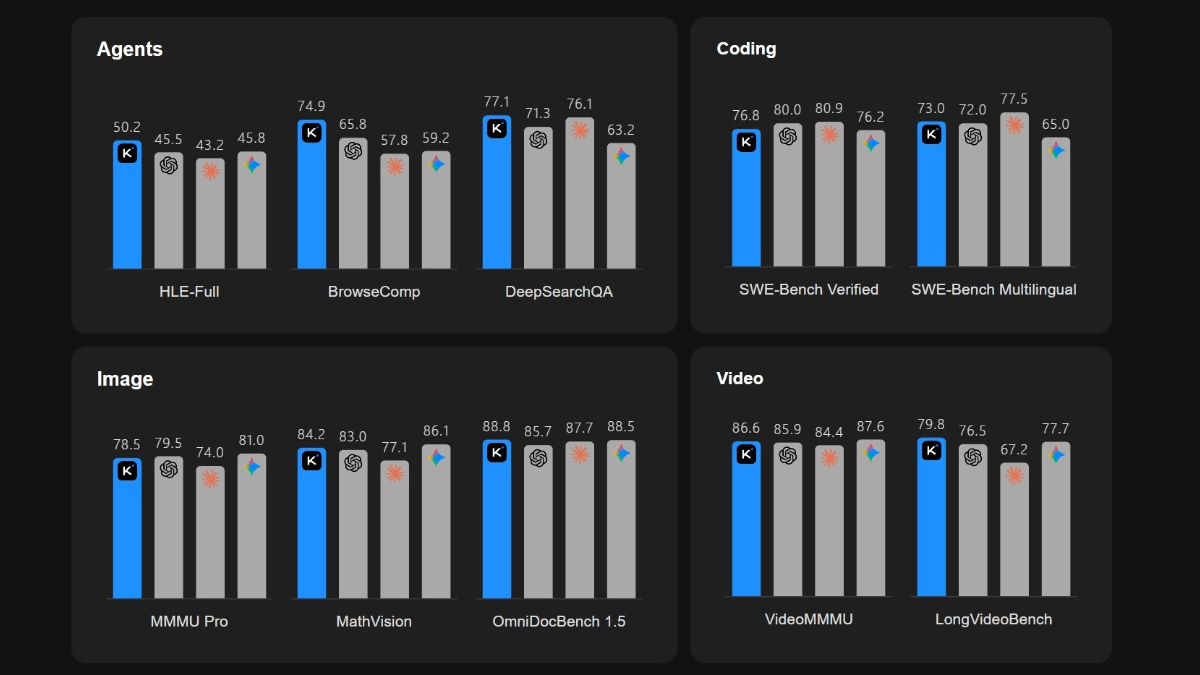
Kimi K2.5 - 月之暗面开源的新一代旗舰模型Kimi K2.5 是月之暗面发布的开源旗舰模型,采用 1T MoE 架构、激活 32B、上下文 256K token,原生支持图文视频多模态输入。在 Agent、代码、视觉理解三大基准均列开源第一...最新AI资源9个月前091.5K
gpt-realtime - OpenAI最新推出的AI语音模型gpt-realtime 是 OpenAI 推出的先进语音模型,支持直接处理音频,生成自然流畅的语音。模型支持多种语言和风格,能理解非语言线索,如笑声,能在不同语言间切换。最新AI资源1年前091.3K
SAM Audio - Meta推出的开源多模态音频分割模型SAM Audio是Meta推出的开源多模态音频分割模型,从复杂的音频混合中精准分离出任意目标声音。通过结合文本、视觉和时间维度的提示,实现灵活、高效的音频处理,为音频编辑、去噪、声音提取等任务提供了...最新AI资源11个月前091.3K
GLM-TTS - 智谱AI推出的开源工业级语音合成系统GLM-TTS 是智谱推出的开源工业级语音合成系统,具备强大的语音合成能力。采用两阶段生成架构:第一阶段将文本转换为语音令牌序列,第二阶段将令牌序列转换为高质量音频。系统支持仅用3秒语音样本即可完成音...最新AI资源11个月前091.3K
自动生成每日Product Hunt热门产品榜单综合介绍 Product Hunt 每日中文热榜是一个基于 GitHub Actions 的自动化工具,能够每天定时生成 Product Hunt 上的热门产品榜单,并以 Markdown 文件的形式...最新AI资源# AI开源项目2年前091.2K
LingBot-Depth - 蚂蚁灵波科技开源的高精度空间感知模型LingBot-Depth是蚂蚁灵波科技开源的高精度空间感知模型,专门解决机器人在透明玻璃、反光物体等复杂场景中的深度识别难题。模型通过创新的"掩码深度建模"技术,在RGB图像基础上预测缺失的深度值最新AI资源9个月前091.1K
Protenix-v1 - 字节Seed团队推出的首个开源蛋白质结构预测模型Protenix-v1是字节跳动ByteDance Seed团队推出的首个开源蛋白质结构预测模型,性能在严格对齐训练数据和模型规模后超越AlphaFold 3。模型具备显著的推理时扩展特性:通过增加采...最新AI资源9个月前091.1K
Uthana - AI 3D 角色动画生成平台,文字描述或参考视频生成逼真动画Uthana 是强大的 AI 3D 角色动画生成平台。用户输入文字描述、上传参考视频或搜索动作库,AI能快速生成逼真动画,且支持适配任意骨骼结构的模型。平台具备多种功能,如风格迁移、API 集成、定制...最新AI资源1年前091.1K
剪影专业版6.0.x,新年快乐版无需会员就可以使用所有vip功能,解压即用,千万别升级!千万别升级!千万别升级! 链接:https://pan.quark.cn/s/a120ee707f47 提取码:jHDN最新AI资源2年前091K
LingBot-VA - 蚂蚁灵波开源的首个“自回归视频-动作世界模型”LingBot-VA 是蚂蚁灵波开源的全球首个“自回归视频-动作世界模型”,把视频生成与机器人控制塞进同一 Transformer,每一步同时输出下一帧世界画面和对应动作,实现“边想边干”。最新AI资源9个月前091K
StoryMem - 字节跳动与南洋理工联合开源的AI视频生成系统StoryMem是字节跳动与南洋理工大学联合开源的AI视频生成系统,专为解决多场景视频中角色和环境一致性问题。核心通过"视觉记忆库"技术,自动存储关键帧并在后续生成时参考,确保人物外貌、服装、场景元素...最新AI资源10个月前091K


 简体中文
 English
 日本語
 한국어
 Русский
 Español