최신 AI 리소스

共 3185 篇文章
Uthana - AI 3D 角色动画生成平台,文字描述或参考视频生成逼真动画

Uthana - 사실적인 애니메이션을 생성하는 AI 3D 캐릭터 애니메이션 생성 플랫폼, 텍스트 설명 또는 참조 비디오

Uthana는 강력한 AI 3D 캐릭터 애니메이션 생성 플랫폼입니다. 사용자가 텍스트 설명을 입력하거나 참고 동영상을 업로드하거나 모션 라이브러리를 검색하면 AI가 모든 골격 구조를 가진 모델에 적용할 수 있는 사실적인 애니메이션을 빠르게 생성할 수 있습니다. 이 플랫폼에는 스타일 마이그레이션, API 통합, 커스터마이징 등 다양한 기능이 탑재되어 있습니다.
1 년 전
077.4K
Doppl - 谷歌推出的AI虚拟试衣应用

Doppl - Google의 AI 가상 피팅 앱

도플은 구글의 AI 가상 피팅 앱입니다. 사용자가 전신 사진을 업로드하면 애플리케이션은 자신의 신체 디지털 버전에 옷 사진이나 스크린샷을 '착용'하고, 정적인 사진에서 AI가 생성한 동영상으로 변환하여 사용자가 옷이 신체에 미치는 효과를 더욱 실감나게 느낄 수 있도록 지원합니다.
1 년 전
077.4K
LongCat-Video - 美团LongCat开源的视频生成模型

LongCat-Video - 미션의 LongCat 오픈 소스 비디오 생성 모델

롱캣-비디오는 MIT 오픈 소스 프로토콜을 사용하는 롱캣 팀의 13억 6천만 개 매개변수 비디오 생성 모델 오픈 소스로, 텍스트 생성 비디오, 그래프 생성 비디오 및 비디오 연속의 세 가지 주요 작업을 지원합니다. "거친에서 미세한"생성 전략과 블록 희소주의 메커니즘을 통한 모델은 몇 분 안에있을 수 있습니다 ...
11개월 전
077.3K
商汤如影 - 商汤科技推出的AI数字人视频制作平台

샹탕 루이 - 샹탕 테크놀로지가 출시한 AI 디지털 휴먼 비디오 제작 플랫폼

샹탕 루잉은 샹탕 테크놀로지가 출시한 AI 디지털 휴먼 동영상 제작 플랫폼입니다. 이 플랫폼은 빅 모델 기술을 기반으로 얼굴 특징, 의상, 헤어스타일 등을 포함한 매우 사실적인 디지털 인간 이미지와 개인화 제작을 지원합니다. 이 플랫폼은 사운드 복제, 비디오 생성, 자동화된 데이터 주석, 실시간 상호 작용 및 기타 기능을 갖추고 있습니다....
1 년 전
077.3K
VoxCPM 1.5 - 面壁智能开源的端到端文本到语音模型

VoxCPM 1.5 - 패싯 인텔리전스 오픈 소스 엔드투엔드 텍스트 음성 변환 모델링

VoxCPM 1.5는 Facade Intelligence에서 출시한 오픈 소스 음성 생성 모델로, 스플리터 없이 텍스트 음성 변환(TTS) 기술을 기반으로 몇 가지 혁신과 개선 사항을 적용했습니다. 엔드 투 엔드 확산 자동 회귀 아키텍처를 채택하여 텍스트에서 직접 연속 음성 파형을 생성하므로 기존 세분화 방법의 한계를 피할 수 있습니다....
9개월 전
077.2K
ChatGPT Agent – OpenAI推出的通用智能AI Agent

ChatGPT 에이전트 - OpenAI의 범용 지능형 AI 에이전트

ChatGPT 에이전트는 여러 기능을 결합하여 복잡한 작업을 자율적으로 완료하는 OpenAI의 범용 AI 에이전트입니다. 사용자는 자연어로 자신의 요구 사항을 설명하기만 하면 에이전트가 웹 검색, 정보 추출, 코드 실행 등 적절한 도구를 자동으로 선택할 수 있습니다.
1 년 전
077.2K
SkyReels-A3 - 昆仑万维推出的音频驱动数字人创作工具

SkyReels-A3 - 쿤룬왕웨이의 오디오 기반 디지털 휴먼 제작 도구

SkyReels-A3는 쿤룬 월드 와이드 그룹의 오디오 기반 디지털 휴먼 제작 툴입니다. SkyReels-A3는 오디오 기반 디지털 휴먼 제작 도구로, 간단한 입력(예: 인물 이미지 및 음성)을 통해 고품질의 동적 비디오 콘텐츠를 생성하고, 정적인 사진을 '생동감 있게' 만들고, 기존 비디오의 대사를 캐릭터가 자동으로 일치하는 새로운 립싱크로 대체할 수 있습니다....
1 년 전
077.1K
Hunyuan-GameCraft - 腾讯混元开源的下一代游戏交互式视频生成框架

훈위안-게임크래프트 - 차세대 게임용 인터랙티브 비디오를 생성하기 위한 텐센트 훈위안의 오픈 소스 프레임워크입니다.

훈위안-게임크래프트는 텐센트 훈위안 팀의 오픈 소스 인터랙티브 게임 비디오 생성 프레임워크입니다. 단일 사진 및 프롬프트에서 프레임워크를 사용하여 매우 역동적인 게임 비디오를 생성하고, 키보드와 마우스를 통해 사용자가 비디오 콘텐츠를 실시간으로 제어할 수 있도록 지원합니다.
1 년 전
077.1K
Hailuo Video Agent - MiniMax推出的AI视频创作Agent

Hailuo 비디오 에이전트 - MiniMax의 AI 비디오 제작 에이전트

하이뤄 비디오 에이전트는 미니막스에서 출시한 문턱 없는 AI 비디오 제작 에이전트로, 오픈 베타 버전입니다. 간단한 텍스트 입력 또는 이미지 업로드를 통해 클릭 한 번으로 고품질의 창의적인 동영상을 생성할 수 있으며, 다음과 같은 다양한 응용 시나리오를 다룰 수 있습니다.
1 년 전
077K
Tencent-HY-MT1.5 - 腾讯混元开源的翻译模型系列

Tencent-HY-MT1.5 - 텐센트 하이브리드 오픈 소스 번역 모델 시리즈

텐센트 하이브리드 오픈 소스 번역 모델 버전 1.5는 1.8B와 7B 두 가지 모델을 포함하여 33 개 국제 언어와 5 가지 중국어 및 중국어 / 방언 번역을 지원하는 텐센트 하이브리드 오픈 소스 번역 모델 버전 1.5입니다.1.8B 모델은 휴대 전화 및 기타 소비자 등급 장치에 특별히 최적화되어 있으며 1GB의 RAM 만 얻을 수 있습니다.
9개월 전
076.9K
Kaleido - 智谱AI联合清华大学等开源的多主体参考视频生成模型

칼레이도 - 칭화대학교 등과 함께 Smart Spectrum AI가 오픈소스화한 다중 피사체 참조 비디오 생성 모델입니다.
칼레이도는 허페이 공과대학교, 칭화대학교, 스마트 스펙트럼 AI가 공동 개발한 오픈 소스 다중 피사체 참조 비디오 생성 모델입니다. 여러 참조 이미지를 통해 피사체 일관된 비디오를 생성하여 다중 피사체 일관성 및 배경 분리에서 기존 모델의 결함을 해결합니다.Kaleido는 특수한 데이터를 통해 비디오를 생성합니다.
9개월 전
076.7K
Genie 3 - 谷歌推出的通用世界模型

Genie 3 - Google의 일반 세계 모델

Genie 3는 매우 역동적이고 일관된 가상 세계를 실시간으로 생성할 수 있는 Google DeepMind의 차세대 범용 세계 모델로, 물리 현상과 자연 생태계를 시뮬레이션하고 판타지 및 역사 시나리오를 생성할 수 있도록 지원합니다. 텍스트 프롬프트를 통해 사용자는 ...
1 년 전
076.7K
NitroGen - 英伟达联合斯坦福大学、加州理工等开源的游戏AI模型

NitroGen - 스탠포드, 칼텍 등과 협력하는 NVIDIA의 오픈 소스 게이밍 AI 모델입니다.

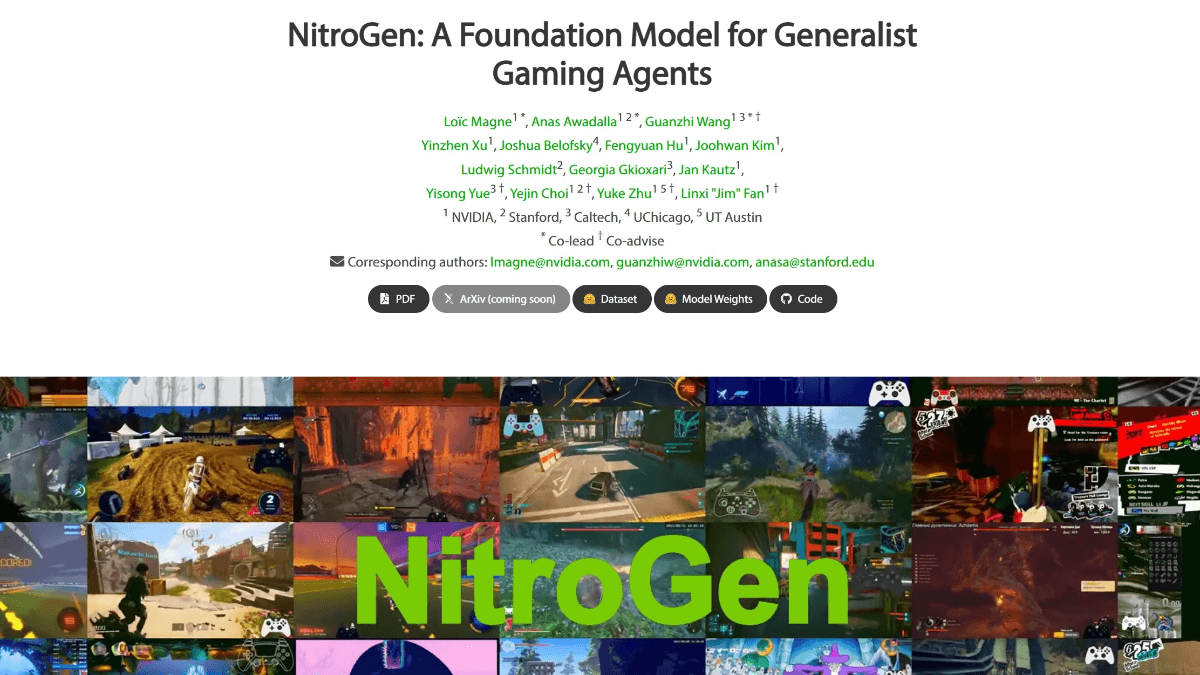
NitroGen은 NVIDIA가 스탠포드 대학, 칼텍 및 기타 기관과 함께 개발한 오픈 소스 게임 AI 모델로, 1,000개 이상의 다양한 유형의 게임을 플레이할 수 있습니다. 이 모델은 GROOT N1.5 아키텍처를 기반으로 하며, 40,000시간의 게임 비디오 데이터(조이스틱 조작 주석 포함)를 분석하여 완성되었습니다....
9개월 전
076.7K
职达AI简历 - AI简历生成与优化平台,精准分析问题、提供优化建议

JobTech AI 이력서 - 문제를 정확하게 분석하고 최적화 제안을 제공하는 AI 이력서 생성 및 최적화 플랫폼입니다.

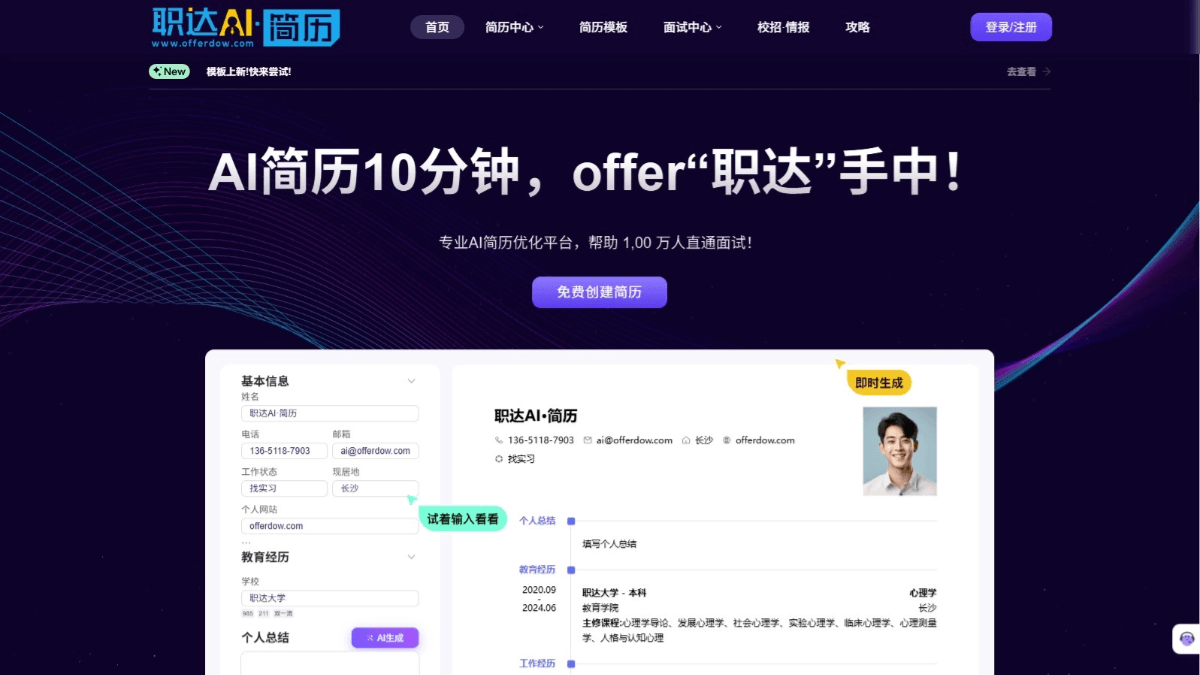
Job AI 이력서는 효율적이고 편리한 지능형 이력서 생성 및 최적화 플랫폼입니다. 이 플랫폼은 AI 기술을 기반으로 사용자가 전문적이고 개인화된 이력서를 빠르게 생성할 수 있도록 도와줍니다. 사용자는 기본 정보와 경력만 입력하면 다양한 직무를 포괄하는 2800개 이상의 아름다운 템플릿을 제공하여 단시간에 고품질의 이력서를 생성할 수 있습니다.
1 년 전
076.6K
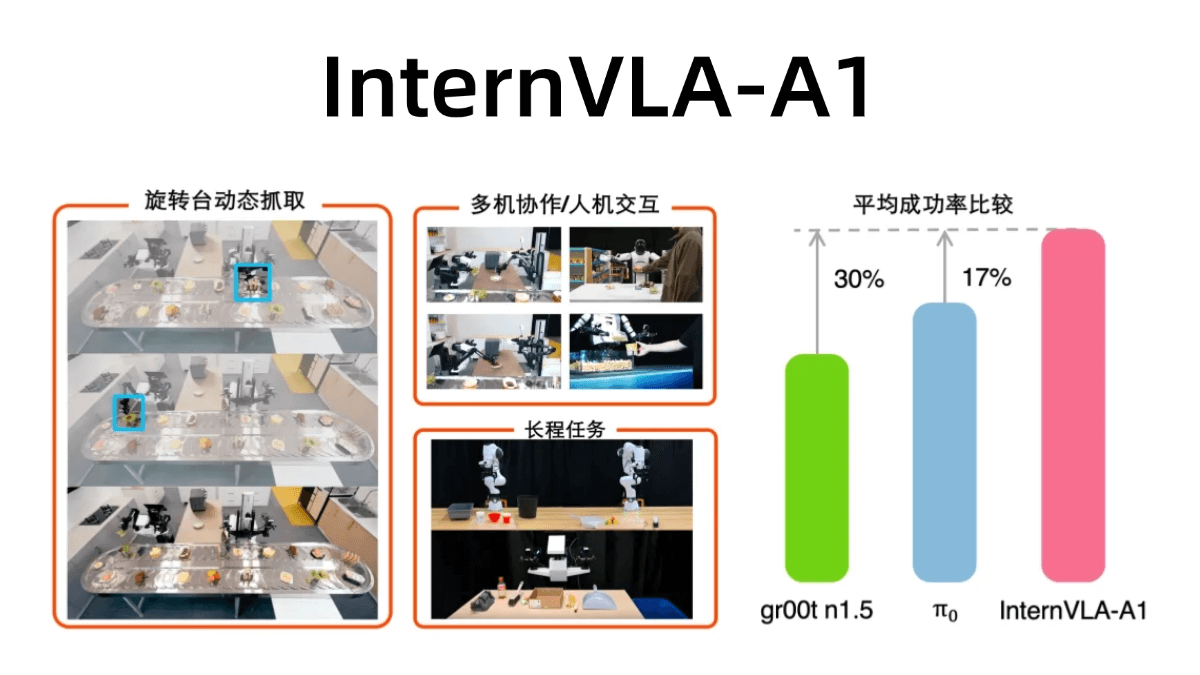
InternVLA-A1 - 上海AI Lab开源一体化操作能力的具身大模型

InternVLA-A1 - 상하이 AI 랩, 대형 모델 구현을 위한 운영 기능의 오픈 소스 통합

InternVLA-A1은 상하이 인공 지능 연구소에서 오픈소스로 제공하는 대규모 구현 작업 모델입니다. 통합을 이해하고, 상상하고, 실행할 수 있는 능력을 갖추고 있으며, 작업을 정확하게 완료할 수 있습니다. 이 모델은 실제 및 시뮬레이션 운영 데이터를 융합하고 대규모 가상-실제 하이브리드 장면 에셋을 통해 대규모 멀티모달 구축을 자동화합니다.
1 년 전
076.5K
Magistral - Mistral AI 推出的系列推理模型

Magistral - Mistral AI의 추론 모델 시리즈

Magistral은 투명한 다국어 및 도메인별 추론 기능에 중점을 둔 Mistral AI의 추론 모델입니다. 이 모델은 오픈 소스 버전(Magistral Small)과 엔터프라이즈 버전(Magistral Medium)으로 구성되어 있으며, 후자는 ...
1 년 전
076.3K
GLM-Experimental - 智谱AI推出的实验性模型

GLM-Experimental - 스마트 스펙트럼 AI에서 출시한 실험적 모델

GLM-Experimental은 위즈덤 스펙트럼 AI에서 출시한 실험적인 대규모 언어 모델로, 현재 Z.ai 플랫폼에서 사용할 수 있습니다. 이 모델에는 PPT를 자동으로 생성하는 기능이 있습니다. 사용자가 주제나 요점을 입력하면 모델이 명확하게 구조화되고 형식이 지정된 프레젠테이션을 빠르게 생성하여...
1 년 전
076.3K
gpt-realtime - OpenAI最新推出的AI语音模型

gpt-realtime - OpenAI의 최신 AI 음성 모델

gpt-realtime은 자연스럽고 부드러운 음성을 생성하기 위해 오디오의 직접 처리를 지원하는 OpenAI의 고급 음성 모델입니다. 이 모델은 여러 언어와 스타일을 지원하고 웃음과 같은 비언어적 단서를 이해하며 언어 간에 전환할 수 있습니다.
1 년 전
076.2K
靠岸妙写 - AI论文写作工具,构思到成稿一站式解决

쿠션 원더풀 라이터 - AI 에세이 작성 도구, 아이디어에서 완성된 논문까지 원스톱 솔루션

Leaning Wonderful Writer는 학술 논문 작성을 위한 효율적이고 편리한 솔루션을 제공하는 AI 논문 작성 도구입니다. 이 도구는 학부 및 석사 학위와 같은 다양한 수준의 학문적 요구에 적용 가능하며 과학 기술, 예술 및 사회 과학과 같은 다학제 분야를 다루는 논문의 개요, 초록 및 초안을 한 번의 클릭으로 생성할 수 있도록 지원합니다.
1 년 전
076.1K
Klic Studio - AI音视频翻译配音工具,一键部署全流程

Klic Studio - AI 오디오/비디오 번역 및 더빙 도구, 원클릭으로 전체 프로세스를 배포할 수 있는 도구

Klic Studio(구 Krillin AI)는 동영상 제작자와 콘텐츠 내보내기를 위해 설계된 AI 기반 동영상 번역, 더빙 및 음성 복제 도구입니다. 전체 프로세스의 원클릭 배포를 지원하여 한 번의 클릭으로 다운로드부터 완성된 출력까지 비디오를 완성할 수 있으며, Jieyin, Xiaohongshu, B ...에 맞게 조정되었습니다.
1 년 전
076K
JoyHallo - 京东开源的AI数字人模型

조이할로 - 징동의 오픈소스 AI 디지털 휴먼 모델

조이할로는 중국어용으로 설계된 징동의 오픈소스 AI 디지털 휴먼 모델로, 오디오를 사실적인 말하기 비디오로 변환하는 것을 지원하며, 입술 움직임 예측 정확도를 높이기 위해 반분리 구조를 사용하여 wav2vec2 모델을 기반으로 오디오 기능을 내장하고 영어 비디오 생성을 지원합니다....
1 년 전
076K
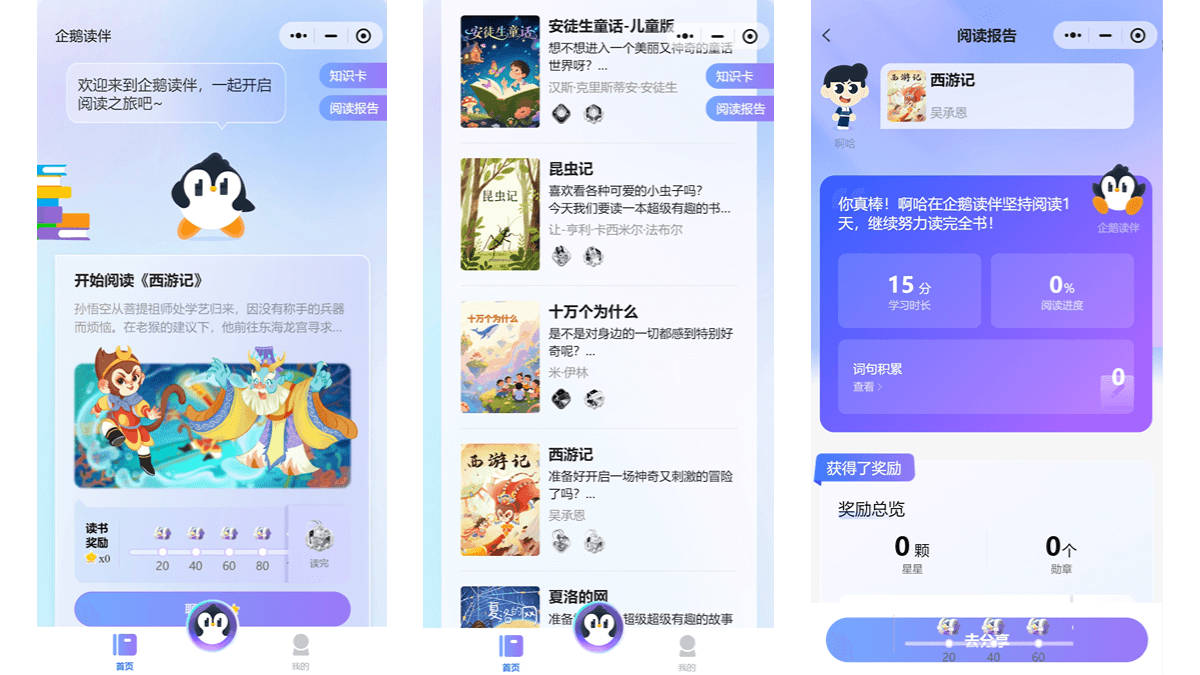
企鹅读伴 - 腾讯推出的中小学生AI阅读助手

펭귄 독서 도우미 - 초등학생과 중고등학생을 위한 텐센트의 AI 독서 도우미

펭귄 리딩 컴패니언은 초등학생과 중고등학생을 위해 설계된 텐센트의 인공지능 독서 도우미입니다. 펭귄 리딩 컴패니언은 텐센트의 하이브리드 빅 모델과 메타머신 플랫폼을 의무 교육 언어 교과 과정 프로그램 및 교과 과정 표준(2022년판)과 결합하여 학생들에게 개인화된 독서 추천, 다양한 독서 모드(집중, 소리 내어 읽기, 듣기...)를 제공합니다.
1 년 전
075.9K
FactSnap - 新一代AI信息核查工具

팩트스냅 - 차세대 AI 정보 검증 도구

팩트스냅은 사용자가 웹 정보의 진위 여부를 빠르게 확인할 수 있도록 도와주는 차세대 AI 정보 검증 도구입니다. 여러 모델과 검색 엔진을 통합하여 사용자가 웹을 탐색하는 동안 선택한 텍스트에 대한 실시간 검증을 수행합니다.
1 년 전
075.8K
MiniMax Music 1.5 - MiniMax最新推出的AI音乐生成模型

미니막스 뮤직 1.5 - 미니막스의 최신 AI 음악 생성 모델!

미니맥스 뮤직 1.5는 사용자의 자연어 설명을 기반으로 최대 4분 분량의 음악 생성을 지원하는 고급 AI 음악 생성 도구입니다. 이 모델은 다양한 음악 스타일과 분위기 사용자 지정을 지원하며 자연스럽고 완전한 보컬 톤, 부드러운 전환 및 풍부한 레이어 편곡을 생성합니다....
1 년 전
075.7K
Squibler - AI小说辅助写作平台,助力构思到创作全过程

Squibler - 아이디어에서 창작까지 전 과정을 지원하는 AI 소설 지원 글쓰기 플랫폼

스퀴블러는 작가를 위해 설계된 강력한 AI 지원 글쓰기 플랫폼으로, 구상부터 창작, 출판에 이르는 전 과정을 도와줍니다. 이 플랫폼은 소설, 시나리오, 단편 소설 등 다양한 스토리 템플릿을 제공합니다. 사용자는 초기 컨셉만 입력하면 AI가 개요, 캐릭터, 장면 등을 생성할 수 있습니다.
1 년 전
075.5K
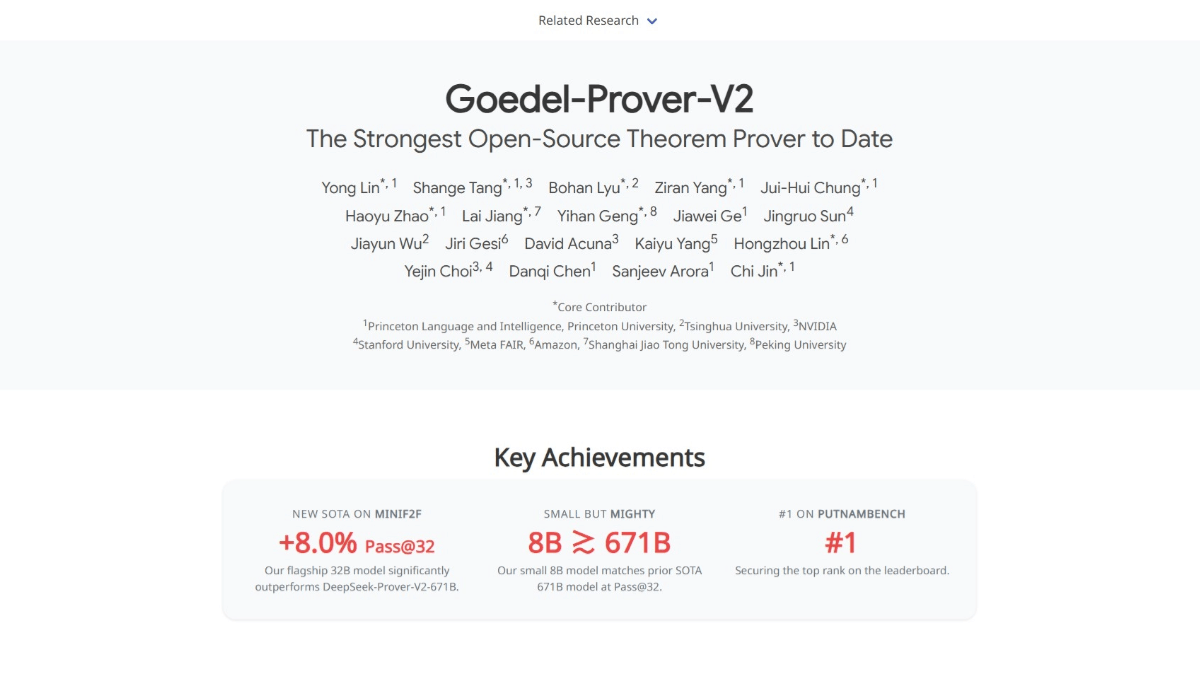
Goedel-Prover-V2 - 普林斯顿联合清华和英伟达等开源的定理证明模型

Goedel-Prover-V2 - 칭화대, NVIDIA 등과 함께 사용하는 프린스턴의 오픈 소스 정리 증명 모델입니다.

Goedel-Prover-V2는 프린스턴 대학교, 칭화 대학교, NVIDIA와 같은 주요 기관의 오픈 소스 정리 증명 모델입니다. 이 모델은 계층적 데이터 합성, 검증자 가이드 자체 수정 및 모델 평균화와 같은 혁신적인 기술을 기반으로 자동화된 형식 증명의 성능을 크게 향상시킵니다....
1 년 전
075.4K
Skywork-SWE-32B - 昆仑万维开源的自主代码智能体基座模型

Skywork-SWE-32B - 쿤룬완웨이 오픈 소스 자율 코드 지능형 바디 기본 모델

Skywork-SWE-32B는 쿤룬 월드와이드웹에서 도입한 오픈 소스 32B 규모의 소프트웨어 엔지니어링(SWE) 자율 코드 인텔리전스 기본 모델입니다. 이 모델은 소프트웨어 엔지니어링 작업에 초점을 맞추고 강력한 저장소 수준의 코드 복구 기능을 갖추고 있으며 다단계 상호 작용 및 긴 텍스트 처리가 있는 복잡한 시나리오에서 수행할 수 있습니다.
1 년 전
075.3K
MoE-TTS - 昆仑万维推出的最新语音生成框架

MoE-TTS - 쿤룬웨이의 최신 음성 생성 프레임워크

MoE-TTS는 사전 학습된 대규모 언어 모델(LLM)과 음성 전문가 모듈을 결합하는 혼합 전문가(MoE) 아키텍처를 기반으로 하는 쿤룬완웨이가 도입한 음성 합성 프레임워크로, 텍스트 모듈 파라미터는 고정하고 음성 모듈 파라미터만 업데이트하여 강력한 텍스트 추론 기능을 유지합니다...
1 년 전
075.2K
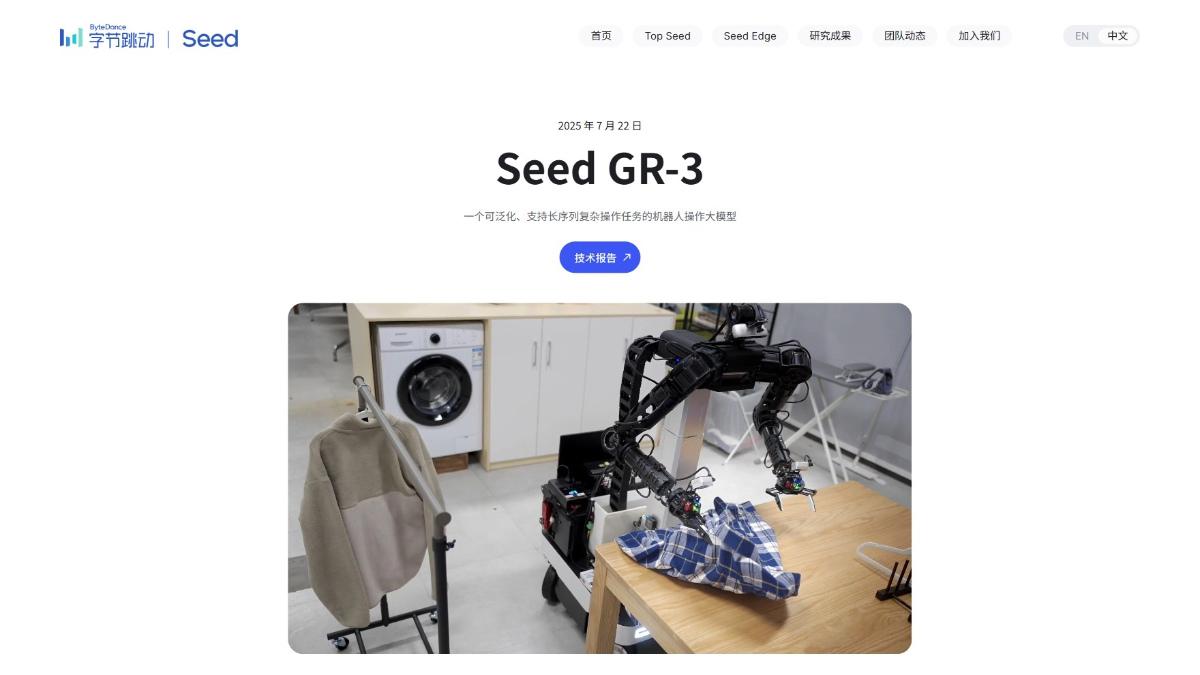
Seed GR-3 - 字节跳动Seed团队推出的通用机器人模型

Seed GR-3 - 워드프레스 시드 팀의 범용 로보틱스 모델

Seed GR-3는 새로운 환경과 복잡한 명령에 적응할 수 있는 강력한 일반화 기능을 갖춘 바이트댄스에서 개발한 범용 로봇 모델입니다. 이 모델은 시각, 언어 및 동작 정보를 융합하고 로봇 데이터, VR 인체 궤적 데이터 및 공개 그래픽 데이터의 3-in-1 학습 방법을 기반으로 새로운 물체에 대한 반응 능력을 향상시킵니다....
1 년 전
075.2K
Mureka V7.5 - 昆仑万维推出的先进AI音乐创作模型

Mureka V7.5 - Quintessence의 고급 AI 음악 제작 모델

Mureka V7.5는 중국 작곡에 중점을 둔 쿤룬 월드 와이드의 최첨단 AI 음악 생성 모델입니다. 이 모델은 음색과 연주 기법을 정확하게 재현하여 자연스럽고 부드럽고 감성적인 보컬을 생성합니다. 최적화된 자동 음성 인식(ASR) 기술을 기반으로 하는 Mureka V...
1 년 전
075.2K
HunyuanImage 3.0 - 腾讯开源的免费多模态图像生成模型

헌위안이미지 3.0 - 텐센트 오픈소스 무료 멀티모달 이미지 생성 모델

훈위안이미지 3.0(훈위안 이미지 3.0)은 텐센트에서 공개하고 오픈소스로 제공한 네이티브 멀티모달 이미지 생성 모델입니다. 모델 매개변수 크기는 80B로, 현재 오픈소스 이미지 생성 모델 중 가장 많은 매개변수를 가진 최고의 평가 결과입니다. 하이브리드 이미지 3.0은 실시간 이미지 생성을 지원하며, 사용자는 측면 ...
12개월 전
075.2K
Ovis-U1 - 阿里推出的多模态统一AI模型

Ovis-U1 - Ali에서 출시한 멀티모달 통합 AI 모델

Ovis-U1은 알리바바 그룹의 Ovis 팀이 30억 개의 매개변수 규모로 도입한 멀티모달 통합 모델입니다. 이 모델은 멀티모달 이해, 텍스트-이미지 생성, 이미지 편집의 세 가지 핵심 기능을 갖추고 있으며 고급 아키텍처 설계와 협업 및 통합 교육 방법을 통해 고충실도 이미지 구현을 지원합니다.
1 년 전
075.1K
EXAONE 4.0 - LG推出的混合推理模型

EXAONE 4.0 - LG의 하이브리드 추론 모델

엑사온 4.0은 범용 자연어 처리와 고급 추론 기능을 결합한 한국 LG AI 리서치의 하이브리드 추론 그랜드 모델입니다. 이 모델은 한국어, 영어, 스페인어를 지원하며 32B 전문가용 버전과 12B 엔드-사이드 버전으로 나뉩니다. 전문가용 버전은 법률, 회계...
1 년 전
075K
DeckSpeed - AI PPT制作工具,自然语言生成演示文稿

DeckSpeed - AI PPT 메이커, 자연어 생성 프레젠테이션

DeckSpeed는 대화형 상호작용을 기반으로 하는 AI 프레젠테이션 제작 도구로, 사용자가 자연어를 기반으로 자신의 요구를 표현하여 기존 템플릿에 의존하지 않고도 개인화된 슬라이드를 빠르게 생성할 수 있습니다. 이 도구는 실시간 피드백 조정을 지원하며, 사용자는 언제든지 슬라이드의 색상, 스타일, 내용을 수정하여 프레젠테이션을 완성할 수 있습니다.
1 년 전
074.9K
AudioFly - 科大讯飞开源的文本生成音效AI模型

AudioFly - KU Xunfei 오픈 소스 텍스트 생성 사운드 AI 모델

AudioFly는 텍스트에서 음향 효과를 생성하기 위한 오픈 소스 AI 모델입니다. 10억 개의 파라미터가 포함된 잠재적 확산 모델 아키텍처를 기반으로 AudioSet, AudioCaps, TUT 및 내부 데이터 세트와 같은 대규모의 다양한 오디오 텍스트 데이터 세트에 대해 학습된 모델입니다.
12개월 전
074.2K
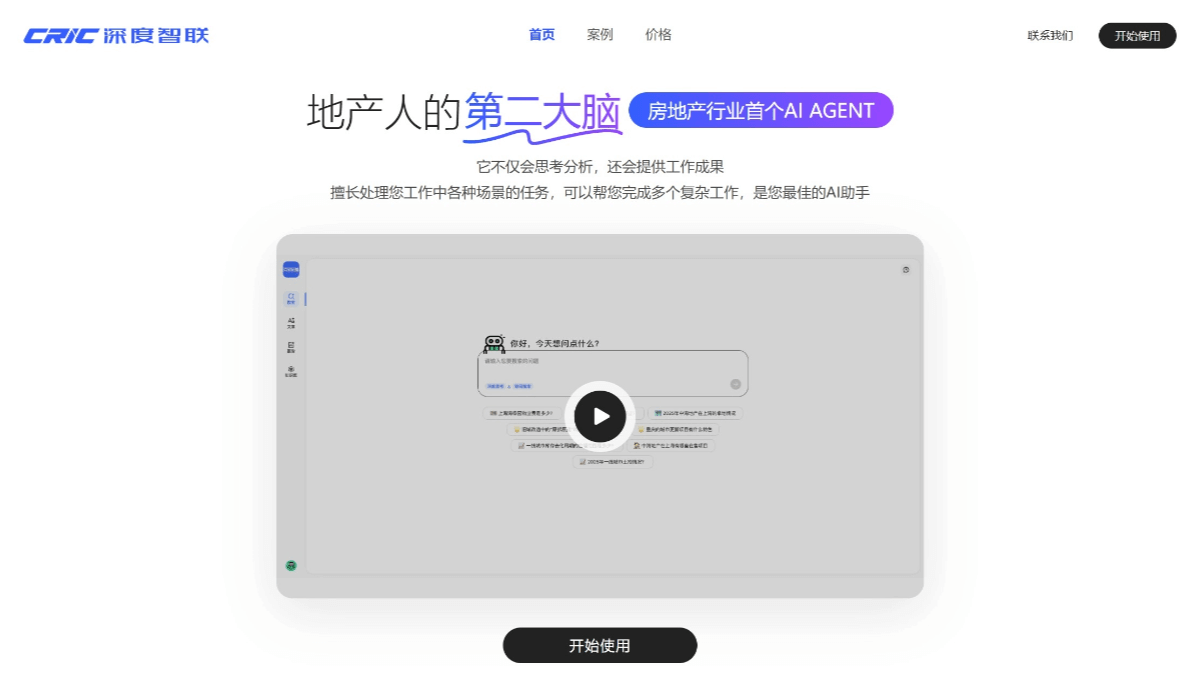
CRIC深度智联 - 克而瑞推出的中国房地产首个AI Agent

CRIC - 중국 최초의 부동산 AI 에이전트, CRIC 출시

CRIC 뎁스 인텔리전스는 CRIC가 독자적으로 개발한 중국 부동산 최초의 AI 지능체로, 부동산 업계에서 20년간 축적한 CRIC의 경험과 데이터, 멀티모달 대형 모델 기술을 바탕으로 데이터 통합, 지능형 분석, 콘텐츠 생성에 이르는 전체 사슬을 열어줍니다.
1 년 전
074K
ThinkSound - 阿里通义推出的音频生成模型

ThinkSound - 알리 통이의 오디오 생성 모델링

씽크사운드는 알리 통이 스피치 팀이 도입한 최초의 CoT(연쇄적 사고) 오디오 생성 모델입니다. 이 모델은 CoT 추론의 도입을 기반으로 비디오 이미지에 정확하게 일치하는 음향 효과를 생성하여 기존 기술이 화면의 동적 세부 사항과 공간 관계를 포착하기 어렵다는 문제를 해결할 수 있습니다.
1 년 전
074K
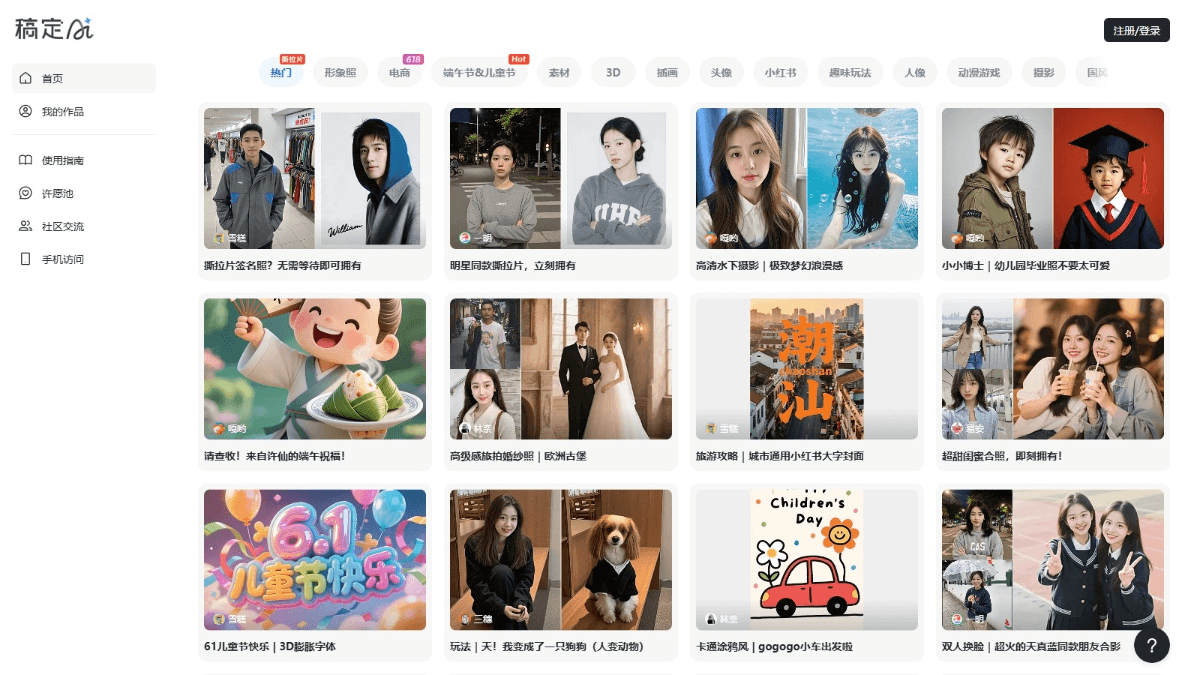
稿定AI社区 - AI创意内容设计平台,多种设计资源满足不同创作需求

초안 작성 AI 커뮤니티 - AI 크리에이티브 콘텐츠 디자인 플랫폼, 다양한 크리에이티브 요구 사항을 충족하는 다양한 디자인 리소스

드래프팅 AI 커뮤니티는 사용자에게 풍부한 창의적인 디자인 리소스와 도구를 제공하는 온라인 AI 창작 영감 플랫폼입니다. 이 플랫폼은 이미지 사진, 전자상거래 디자인, 명절 테마, 3D 일러스트레이션, 아바타 디자인, 샤오홍슈 소재, 인물 디자인 등 다양한 디자인 분야를 다루며 다양한 사용자의 요구를 충족합니다.
1 년 전
074K
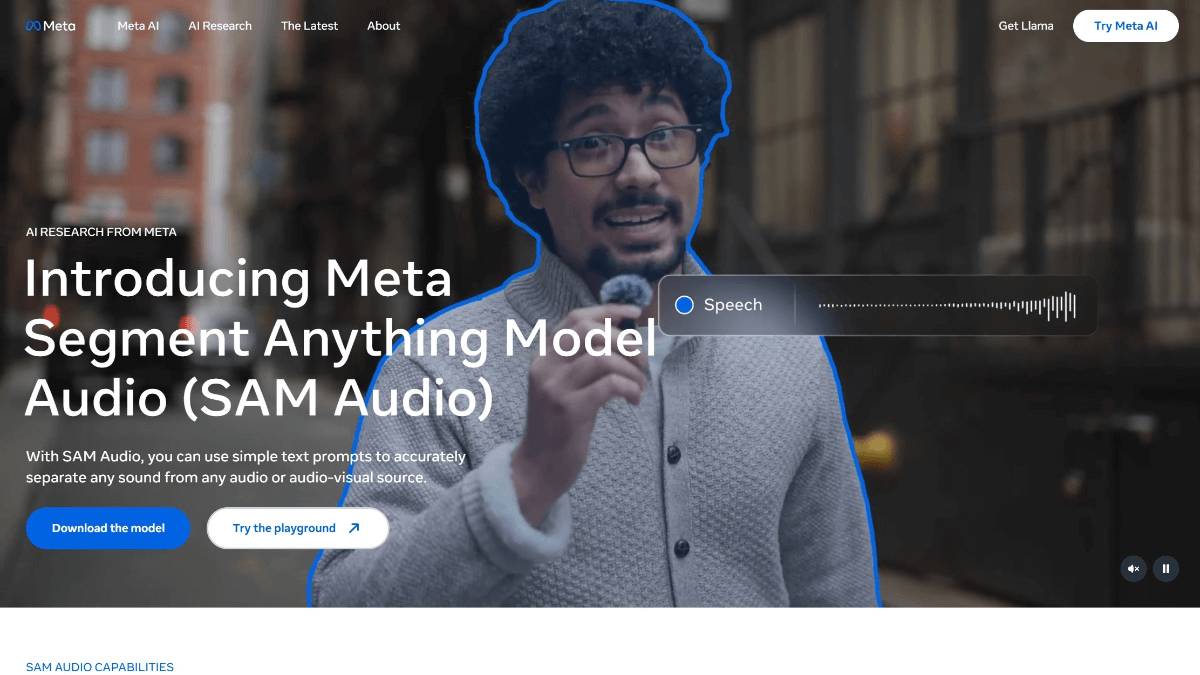
SAM Audio - Meta推出的开源多模态音频分割模型

SAM Audio - 메타의 오픈 소스 멀티모달 오디오 세분화 모델

SAM 오디오는 복잡한 오디오 믹스에서 임의의 대상 사운드를 정확하게 분리하기 위해 메타에서 도입한 오픈 소스 멀티모달 오디오 세분화 모델입니다. 텍스트, 시각 및 시간적 차원의 단서를 결합하여 오디오 편집, 노이즈 제거, 사운드 추출 등의 작업을 유연하고 효율적으로 처리할 수 있습니다.
9개월 전
074K
AutoMV - M-A-P联合北邮、南大等开源的免费音乐视频生成系统

AutoMV - 베이퍄오, NU 등과 연계한 M-A-P 오픈 소스 무료 뮤직비디오 생성 시스템

AutoMV는 M-A-P 팀이 여러 대학과 협력하여 개발한 오픈 소스 뮤직비디오 생성 시스템으로, 교육 없이도 완성된 곡을 기반으로 일관된 뮤직비디오를 자동으로 생성할 수 있으며, 음악 분석, 대본 작성, 연출 및 품질 관리 모듈을 포함한 다중 지능 협업 모델을 채택하여 가사, 비트 등을 정확하게 분석할 수 있습니다....
9개월 전
073.9K
CWM - Meta FAIR开源的代码世界语言模型

CWM - 메타 페어 오픈 소스 코드 월드 언어 모델

CWM(코드 월드 모델)은 메타 페어 팀이 공개한 320억 개의 파라미터를 가진 오픈 소스 월드 언어 모델로, 코드 생성 및 추론을 위해 설계되었습니다. 코드 실행 프로세스를 시뮬레이션하고 변수 상태 변화를 예측하고 미리 예측할 수 있는 '월드 모델'이라는 개념을 도입했습니다.
12개월 전
073.9K
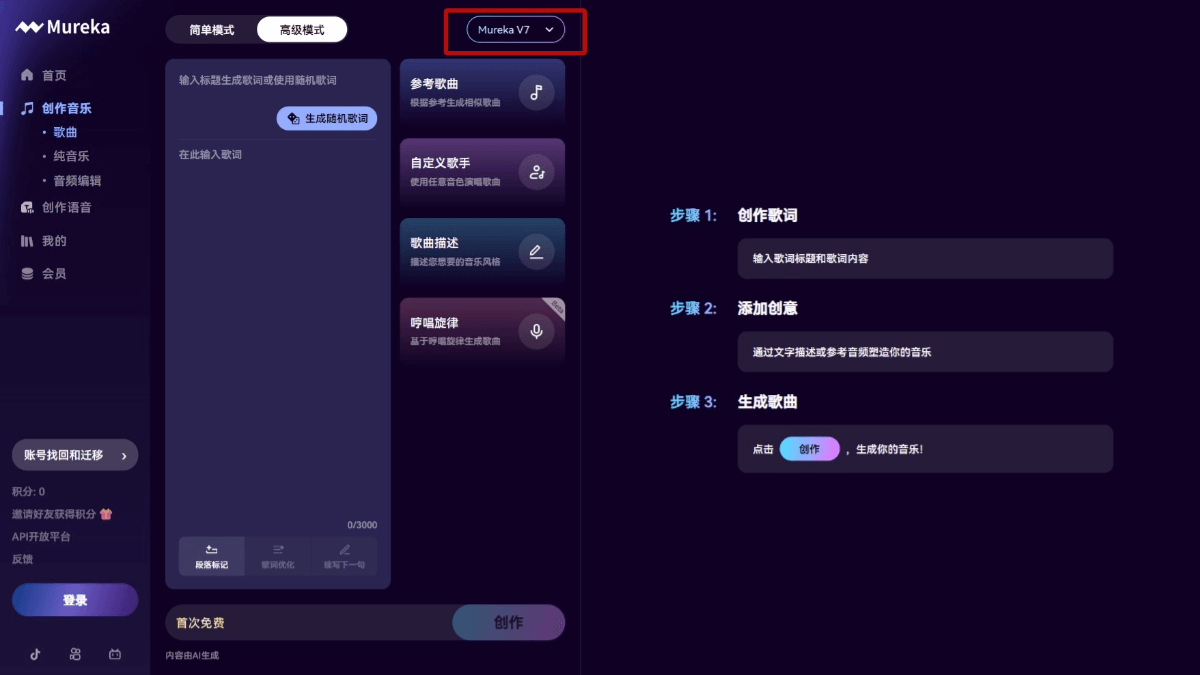
Mureka V7 - 昆仑万维推出的AI音乐生成模型

Mureka V7 - Quintessence의 AI 음악 생성 모델

Mureka V7은 쿤룬 월드와이드에서 출시한 고급 AI 음악 생성 모델입니다. 이 모델은 보다 일관성 있고 예술적인 음악 작품을 생성하기 위해 세부 사항을 채우기 전에 음악의 전체 구조를 계획하는 것을 지원하는 MusiCoT 기술을 기반으로 합니다.
1 년 전
073.6K
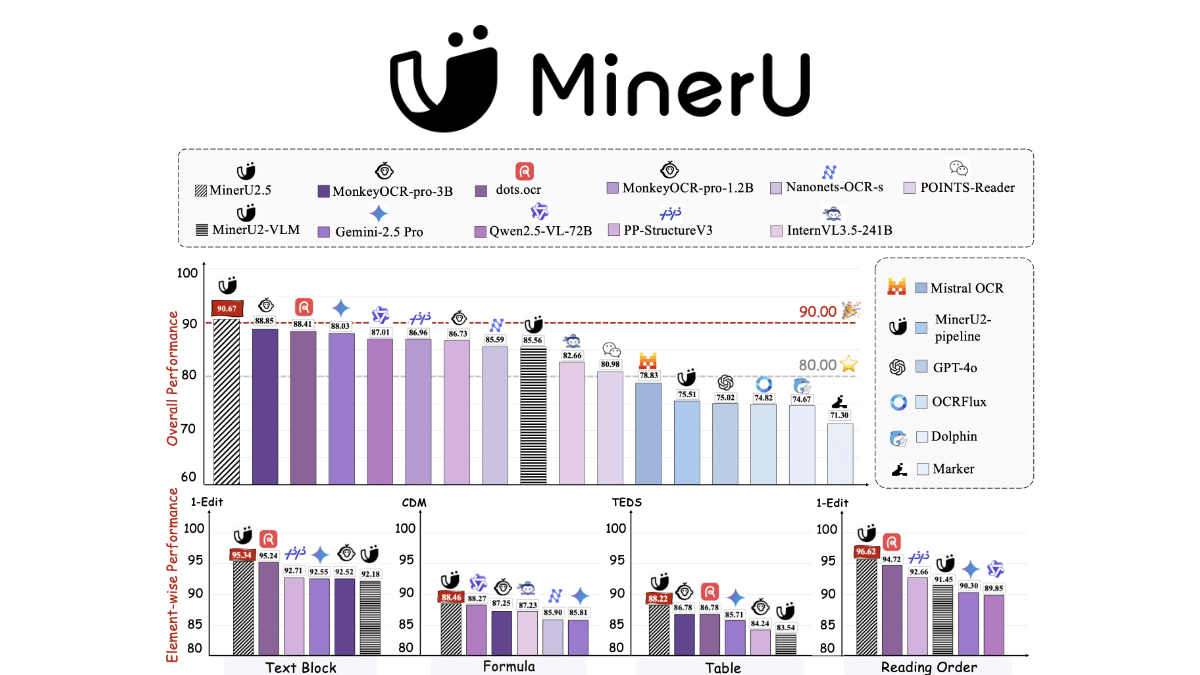
MinerU2.5 - 上海AI Lab联合北大开源的文档解析模型

MinerU2.5 - 상하이 AI Lab과 북경대학교 오픈 소스 문서 구문 분석 모델

MinerU2.5는 상하이 인공지능 연구소와 북경대학교 팀이 공동으로 개발한 분리형 시각 언어 모델로, 고해상도 문서 이미지 구문을 효율적으로 처리하는 데 중점을 두고 있습니다. 핵심 혁신은 "글로벌 레이아웃 감지 후 로컬 콘텐츠 인식"의 2단계 설계에 있습니다. 첫 번째 단계는 저해상도...
11개월 전
073.5K
MedASR - 谷歌开源的医疗语音识别模型

MedASR - Google의 오픈 소스 의료 음성 인식 모델

MedASR은 구글이 오픈소스화한 1억 5천만 개의 파라미터 의료 음성 인식 모델로, 5,000시간의 감작된 임상 말뭉치를 기반으로 미세 조정되어 약물, 용량 및 해부학 용어에 최적화되어 있으며, 6그램의 의료 언어 모델이 내장되어 있고 민간 방사선 데이터 세트 RAD-DICT에서 단어 오류율이 4.6에 불과합니다....
9개월 전
073.4K
AntSK FileChunk - 免费的AI语义文档切片工具,动态切片调整

AntSK FileChunk - 무료 AI 시맨틱 문서 슬라이싱 도구, 동적 슬라이싱 조정

AntSK FileChunk는 RAG(검색 증강 생성) 애플리케이션을 위해 설계된 무료 지능형 문서 슬라이싱 도구입니다. 시맨틱을 핵심으로 하여 문서를 의미적으로 완전하고 일관된 세그먼트로 지능적으로 슬라이스하고, 다국어를 지원하며, 슬라이스 크기를 동적으로 조정하여 문맥의 일관성을 보장합니다.
1 년 전
073.3K
Step-Audio 2 mini - 阶跃星辰开源的语音大模型

스텝오디오 2 미니 - 스텝스타 오픈 소스 음성 매크로 모델링

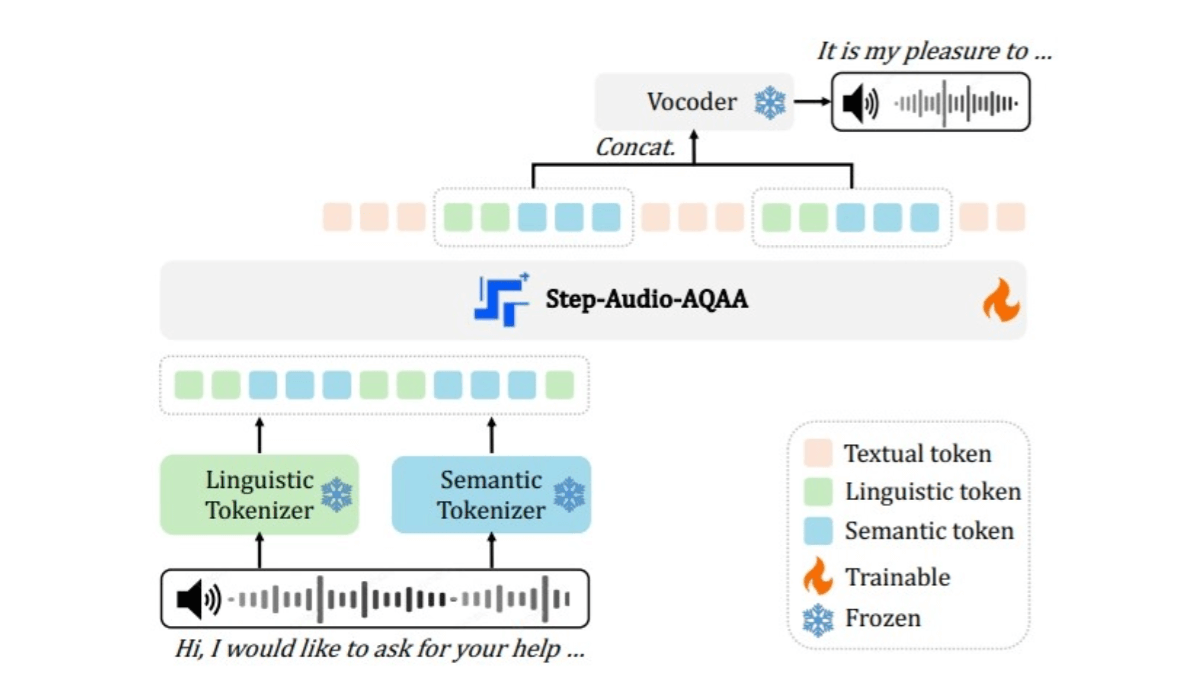
스텝오디오 2 미니는 스텝오디오의 오픈 소스 엔드투엔드 음성 매크로 모델입니다. 기존의 음성 모델 구조를 깨고 진정한 엔드투엔드 멀티모달 아키텍처를 채택하여 원시 오디오 입력을 짧은 지연 시간으로 음성 응답 출력으로 직접 변환하고 언어학적 정보 및 비음성 신호를 이해합니다.
1 년 전
072.6K