Zen 브라우저는 Firefox 커널 기반의 오픈 소스 브라우저로, 세로 탭 표시줄 및 작업 공간 분리와 같은 핵심 기능을 통해 간단하고 효율적인 브라우징 경험에 중점을 두고 있습니다. 사이드바 디자인으로 50개 이상의 탭의 전체 제목을 명확하게 표시하고 다중 창 분할 화면 브라우징을 지원합니다.
InternVLA-M1은 상하이 인공 지능 연구소의 오픈 소스로 구현된 운영 '두뇌'로, 명령에 따라 작동하는 두 가지 시스템 운영의 대형 모델입니다. 이 모델은 '사고-행동-학습'을 포괄하는 완전한 폐쇄 루프를 구축하며 높은 수준의 공간 추론과 작업 계획을 담당합니다. 이 모델은 2단계 교육 정책을 채택합니다 ...
미스트랄 바이브는 코드 검색, 파일 조작, 버전 관리 및 기타 작업을 완료하기 위해 자연어 상호 작용을 지원하는 Devstral 모델을 기반으로 개발된 미스트랄 AI의 오픈 소스 명령줄 코딩 어시스턴트입니다. 기호를 통해 프로젝트 구조와 Git 상태를 자동으로 스캔할 수 있습니다....
DeepSearchQA는 복잡한 다단계 쿼리 작업에서 지능의 성능을 평가하기 위해 설계된 Google의 오픈 소스 AI 연구 에이전트 테스트 벤치마크입니다. 17개 도메인을 포괄하는 900개의 수작업으로 설계된 "인과 관계 체인" 작업으로 구성되어 있으며, AI가 인간 연구원처럼 행동하고 다단계 작업을 수행하도록 요구합니다.
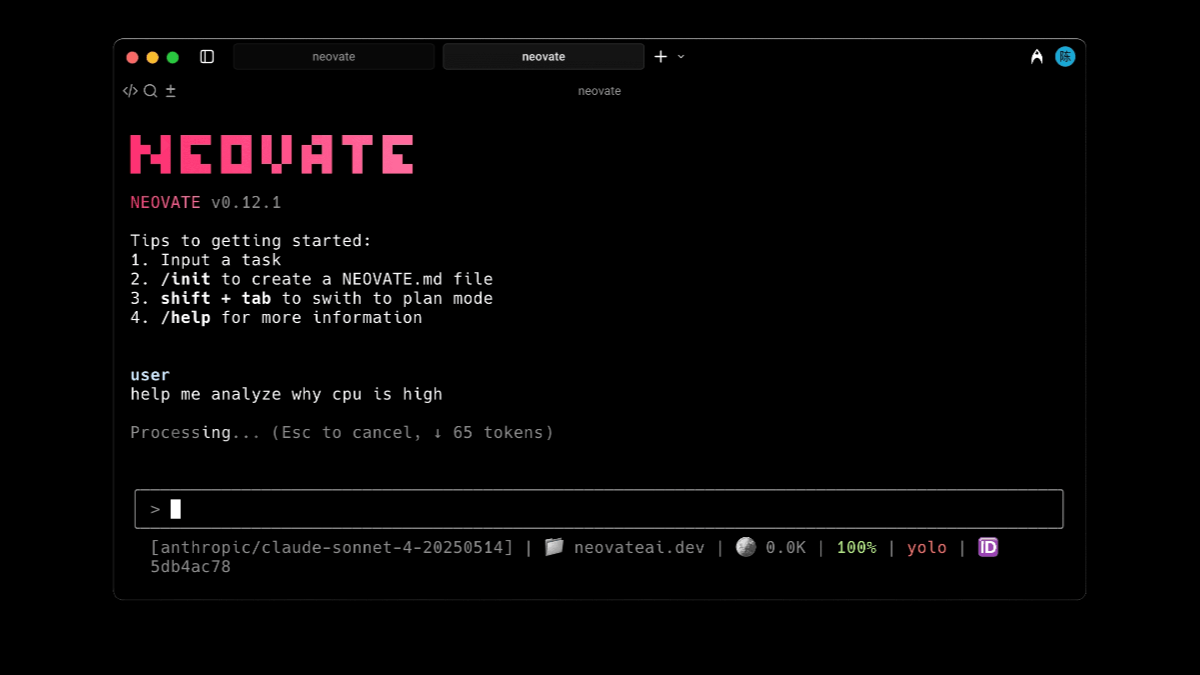
네오베이트 코드는 앤트그룹 알리페이 경험 기술 부서의 오픈소스 지능형 프로그래밍 도우미로, 인공지능 기술을 통해 개발 효율성을 향상시킵니다. 대화형 개발 기능을 통해 개발자는 자연어를 통해 요구 사항을 설명할 수 있으며, Neovate Code는 이를 이해하고 해당 세대를 생성할 수 있습니다.
Code2Video는 코드 스니펫을 고품질 비디오 콘텐츠(MP4 형식)로 자동 변환하는 혁신적인 오픈 소스 프로젝트입니다. 독특한 코드 중심 패러다임을 통한 이 프로젝트는 탄소-now-cli 도구를 사용하여 코드를 아름다운 이미지로 생성하고, ffmpeg를 사용합니다 ...
유니픽셀은 픽셀 수준의 시각 언어 이해를 달성하기 위해 홍콩 폴리테크닉 대학교, 텐센트, 중국과학원, Vivo가 공동으로 제안한 새로운 멀티모달 모델입니다. 객체 참조 및 분할 기능을 통합하여 이미지 분할, 비디오 분할, 영역 이해 및 파이분할과 같은 다양한 세분화된 작업을 지원합니다.
T5Gemma 2는 Google에서 오픈소스로 제공하는 차세대 인코더-디코더 모델로, 멀티모달 및 긴 컨텍스트 처리 기능으로 업그레이드된 Gemma 3 아키텍처를 기반으로 합니다. 텍스트와 이미지를 포함한 다양한 데이터 유형을 지원하며, 생성 시 매우 긴 컨텍스트(최대 128K)를 처리할 수 있습니다.
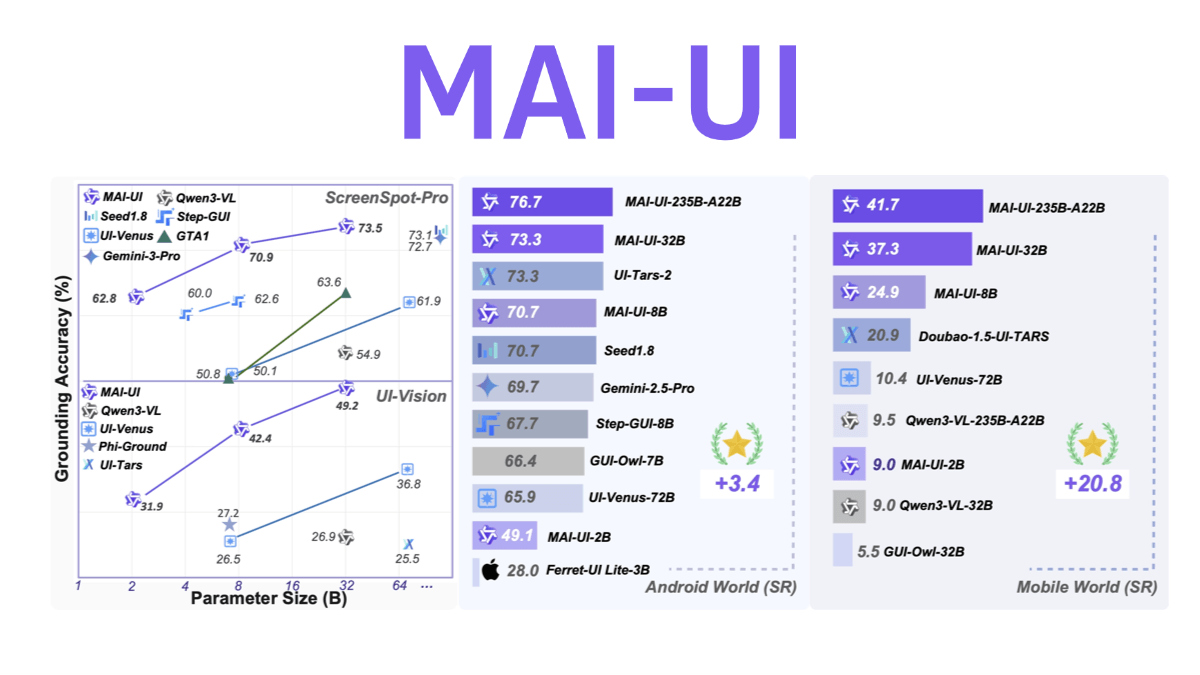
MAI-UI는 알리바바 통이 연구소의 오픈 소스 범용 GUI 지능형 바디 기반 모델로, 애플리케이션 간 작동, 퍼지 의미 이해, 능동적 사용자 상호 작용 및 다단계 프로세스 조정이라는 네 가지 주요 기능을 갖추고 있습니다. 엔드 클라우드 협업 아키텍처를 채택한 경량 모델은 장치에 상주하여 일상적인 작업을 처리하고 복잡한 작업은 클라우드를 대규모로 호출할 수 있습니다.
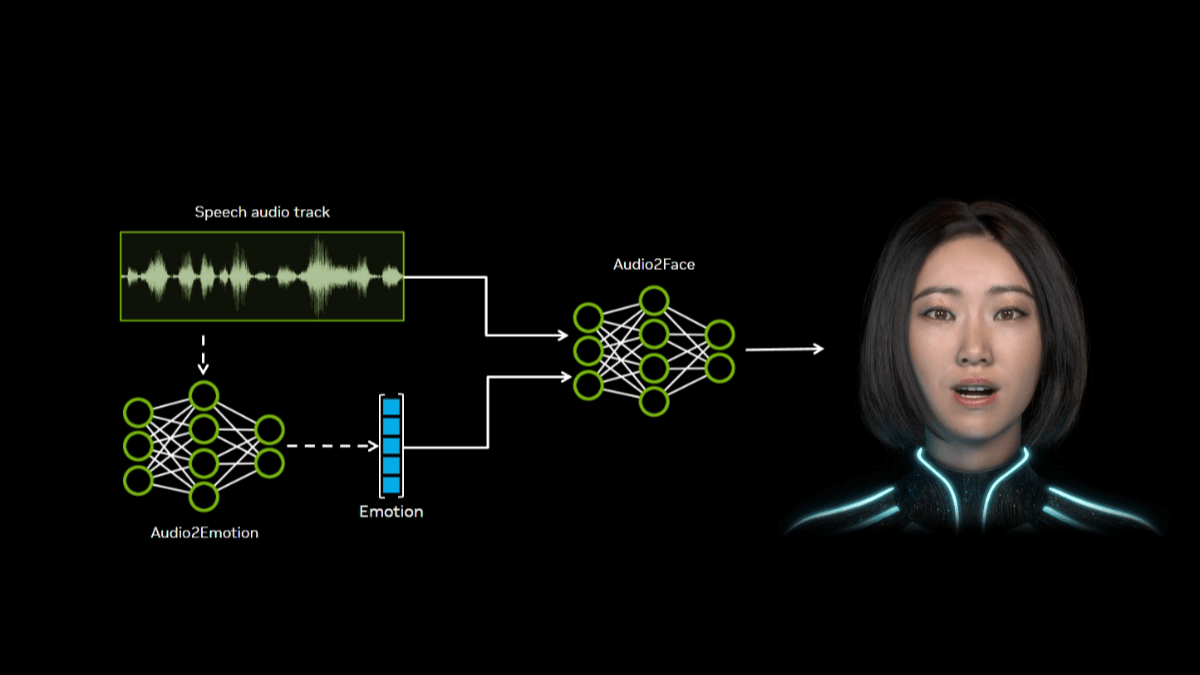
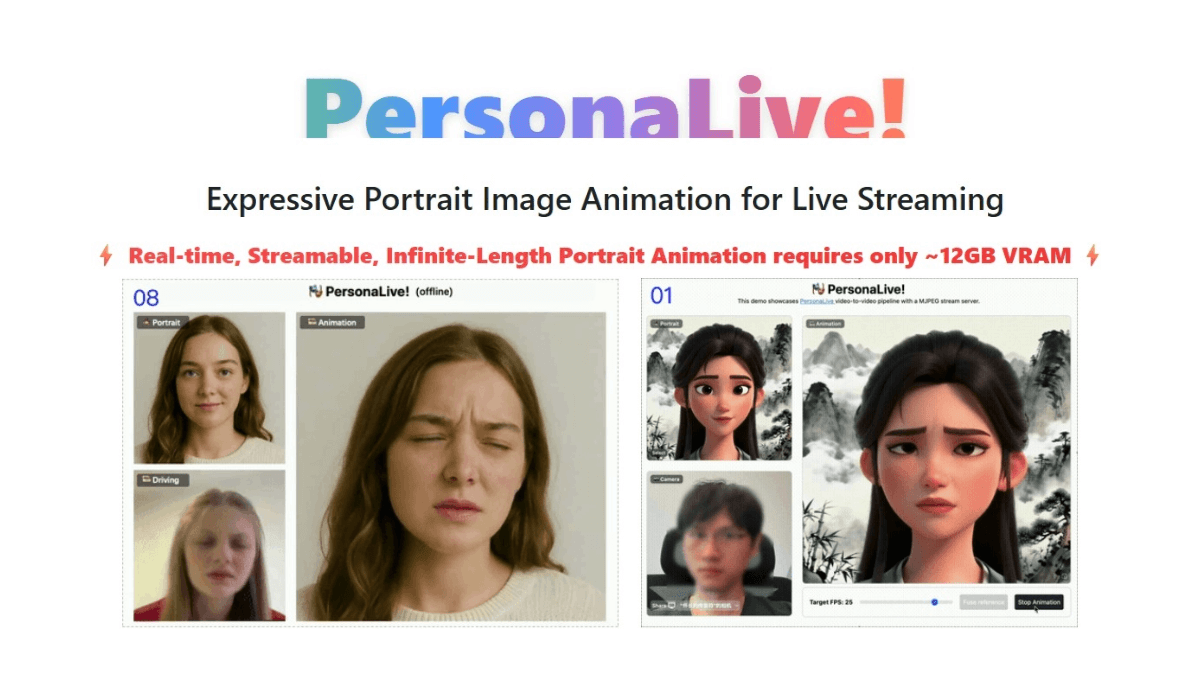
페르소나라이브는 마카오 대학교, dzine.ai, 그레이터 베이 지역 대학교의 GVC 랩이 공동 개발한 오픈 소스 실시간 AI 얼굴 교체 라이브 스트리밍 프레임워크입니다. 일반 소비자용 그래픽 카드(12GB 비디오 메모리)에서 지연 시간이 짧고 프레임 속도가 빠른 디지털 퍼스널 드라이브를 구현할 수 있으며 카메라를 통한 실시간 스트리밍을 지원합니다....
SurfSense는 오픈 소스 AI 리서치 및 지식 관리 도구입니다. 고도로 사용자 정의가 가능하며 검색 엔진, Slack, Jira, Notion, YouTube, GitHub 및 기타 여러 외부 데이터 소스에 연결하여 사용자가 정보를 쉽게 통합할 수 있습니다. 사용자는 다양한 자료를 업로드할 수 있습니다.
OpenAutoGLM은 다중 모드 인식을 통해 휴대폰 화면의 내용을 이해하고 사용자가 지정한 작업을 완료하기 위해 작업 흐름을 자동으로 생성 할 수있는 "휴대폰 사용"기능을 갖춘 오픈 소스 지능형 신체 모델입니다. 사용자는 "근처 훠궈를 검색하려면 메이투안을 열어..."와 같이 자연어를 사용하여 요구 사항을 설명하기만 하면 됩니다.
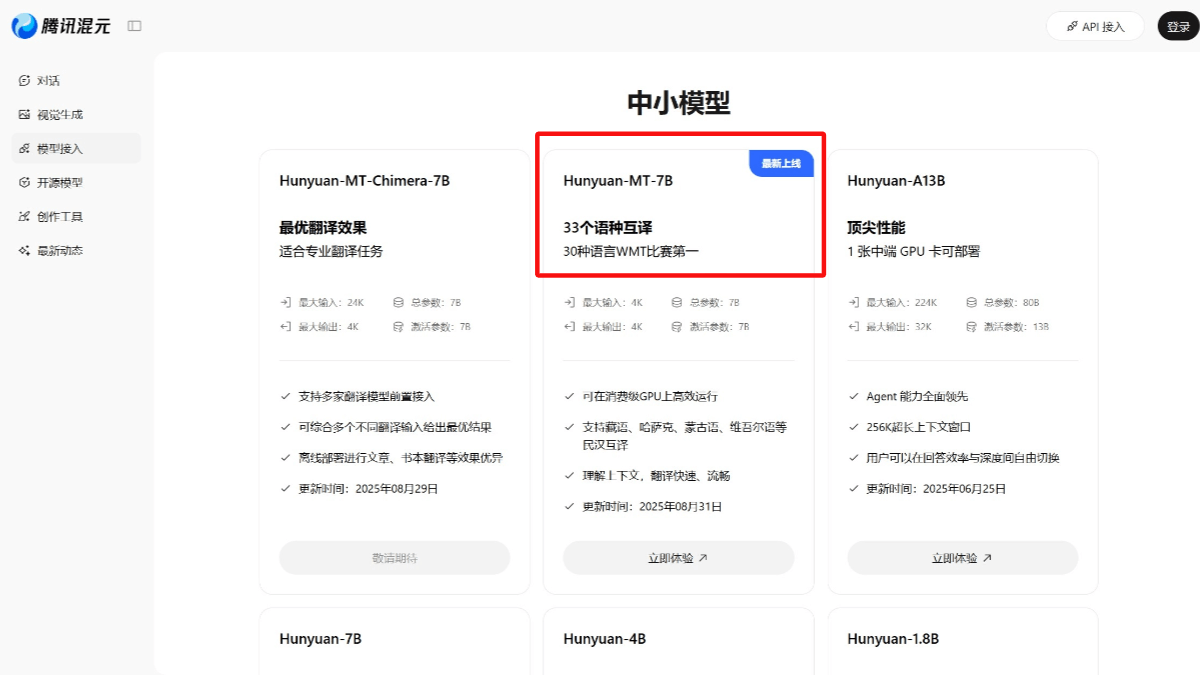
Hunyuan-MT-7B는 텐센트 혼합 메타 팀이 도입한 경량 번역 모델로 70억 개의 레퍼런스를 보유하고 있으며 광둥어, 위구르어, 티베트어를 포함한 33개 언어와 5개 중국 민속 언어/방언의 상호 번역을 지원합니다. 국제 컴퓨터 언어학 협회(ACL) WMT2025 대회에서...
훈위안OCR은 텐센트 하이브리드 팀이 오픈소스화한 고성능 광학 문자 인식 모델로, 10억 개의 레퍼런스만 보유하고 있습니다. 하이브리드 멀티모달 아키텍처를 기반으로 개발된 이 모델은 엔드투엔드 설계를 채택하여 텍스트 감지, 인식 및 문서 구문 분석 작업을 효율적으로 처리할 수 있습니다. 이 모델은 복잡한 문서 테스트에서 94.1점을 획득하여 ...
Youtu-Embedding은 엔터프라이즈급 애플리케이션을 위해 설계된 Tencent의 Youtu Labs에서 개발한 오픈 소스 범용 텍스트 표현 모델입니다. 텍스트는 심층 신경망에 의해 고차원 벡터 공간에 매핑되어 의미적으로 유사한 문장이 해당 공간에서 서로 가깝게 배치되어 정확한 의미 검색을 달성합니다.
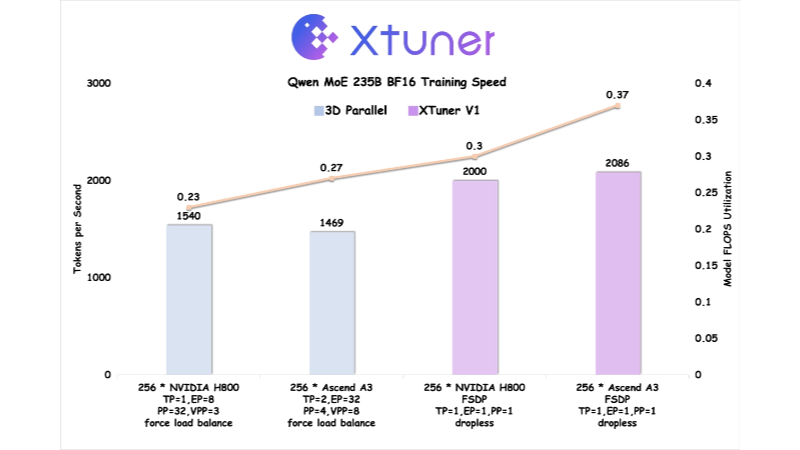
XTuner V1은 상하이 인공 지능 연구소에서 오픈 소스화한 차세대 대규모 모델 훈련 엔진으로, 초대형 스파스 혼합 전문가(MoE) 모델 훈련을 위해 설계되었습니다. PyTorch FSDP를 기반으로 개발된 이 엔진은 메모리, 통신 및 로드의 다차원 최적화를 통해 고성능을 달성합니다.
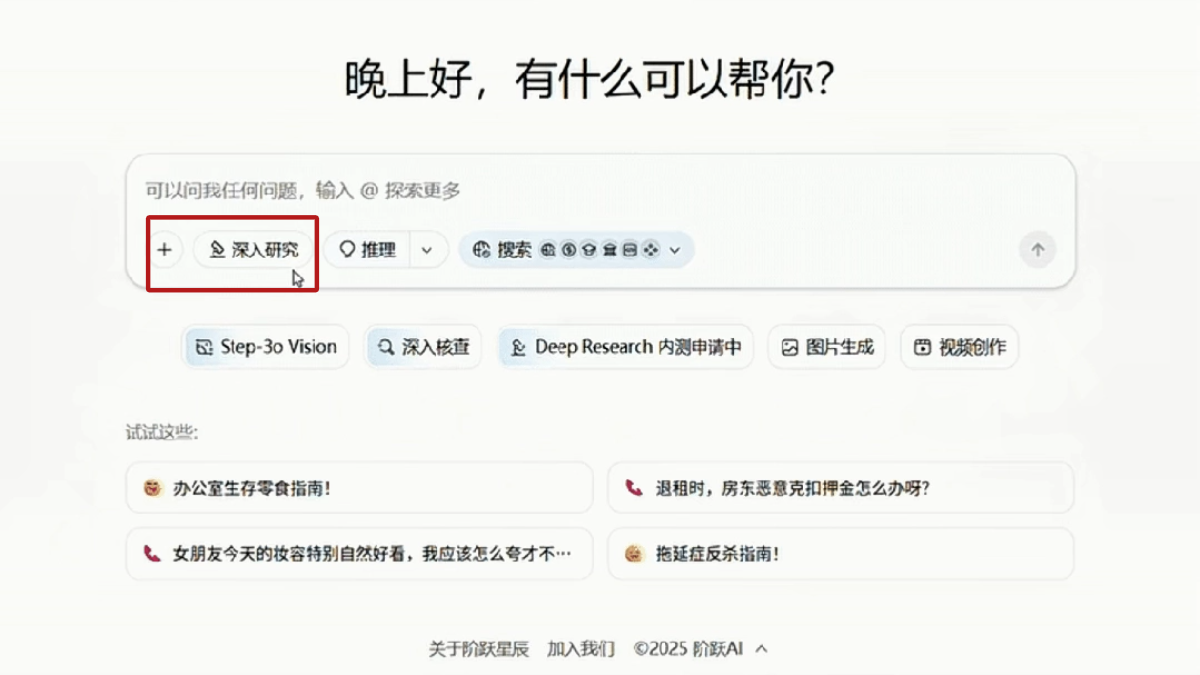
스텝스 딥 리서치는 스텝스 스타에서 출시한 효율적인 인공지능 리서치 도구로, 복잡한 이슈에 대한 리서치를 자율적으로 완료하고 단기간에 전문적인 보고서를 생성할 수 있습니다. 이 도구는 금융, 컨설팅, 의료, 법률 및 기타 분야를 위해 설계되었으며 심층적인 검색 및 정보 통합 기능으로 업계에서 뛰어난 평가를 받고 있습니다.
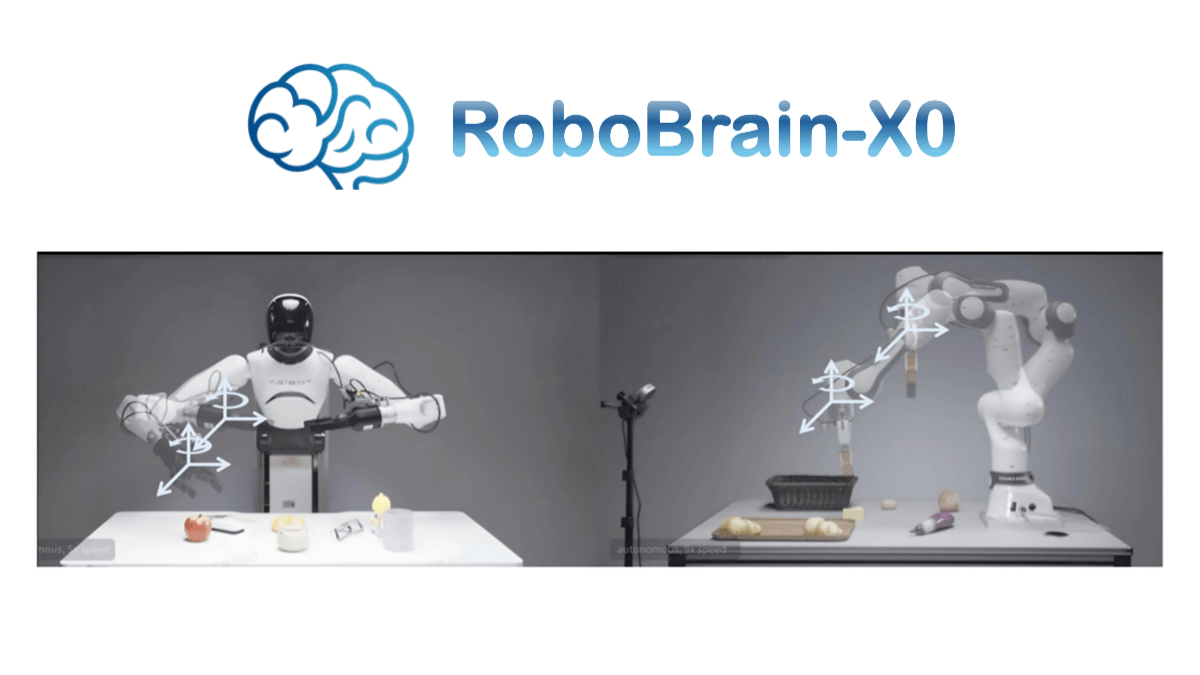
로보브레인-X0은 위즈덤 소스 연구소가 오픈소스로 공개한 세계 최초의 제로 샘플 교차 온톨로지 일반화를 지원하는 오픈소스 구현 모델로, 업계에서 큰 의미를 지니고 있습니다. 다양한 구성의 여러 실제 로봇을 구동하여 미세 조정없이 기본 작동 작업을 완료 할 수 있으며, 소량의 샘플 미세 조정 후 복제 기능을 보여줍니다.
rStar2-Agent는 Microsoft에서 오픈소스로 제공하는 고급 AI 수학적 추론 모델로, AIME24 테스트에서 80.61 TP3T의 정확도를 달성하여 강력한 수학적 문제 해결 능력을 입증했습니다. 이 모델은 과학적 추론 기능을 갖추고 있으며, GPQA-Diamond 벤치마크에서 ...
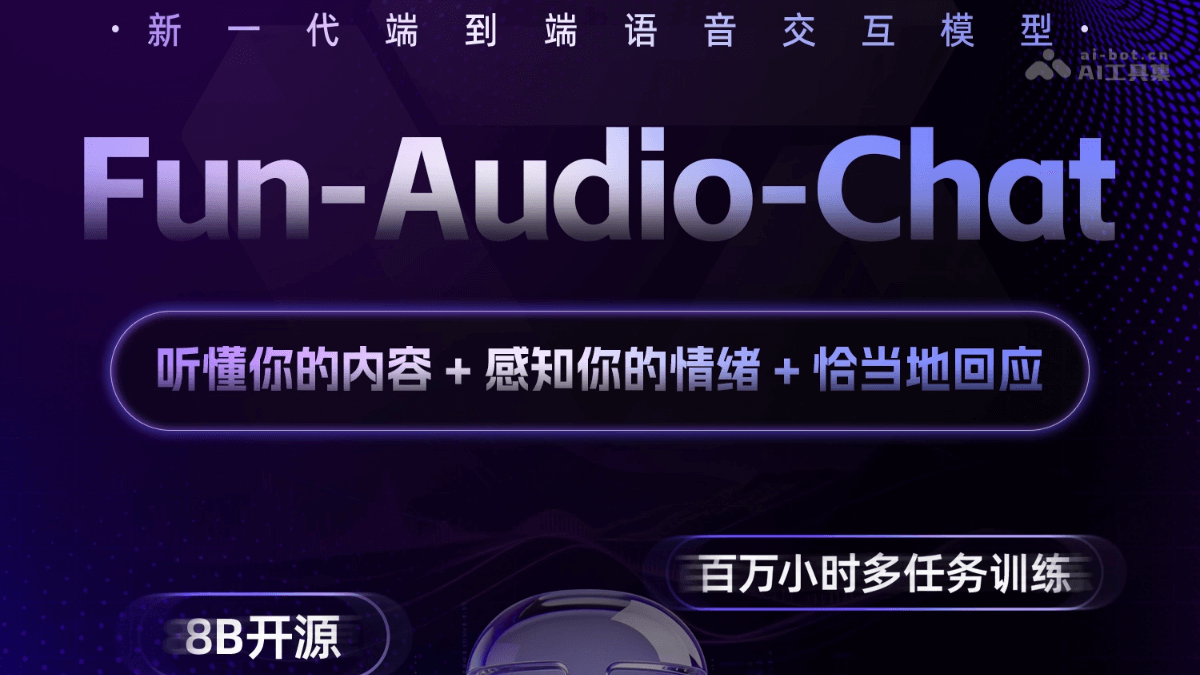
Fun-Audio-Chat-8B는 알리 통이 팀의 오픈 소스 80억 매개 변수 엔드 투 엔드 음성 빅 모델, 음성 출력에서 직접 음성, ASR + LLM + TTS 접합 필요 없음, 중국어와 영어에 유창하며 지연 시간이 짧고 자연스러운 음색을 가진 이중 언어입니다. 25Hz의 이중 해상도 공유 LLM 사용...
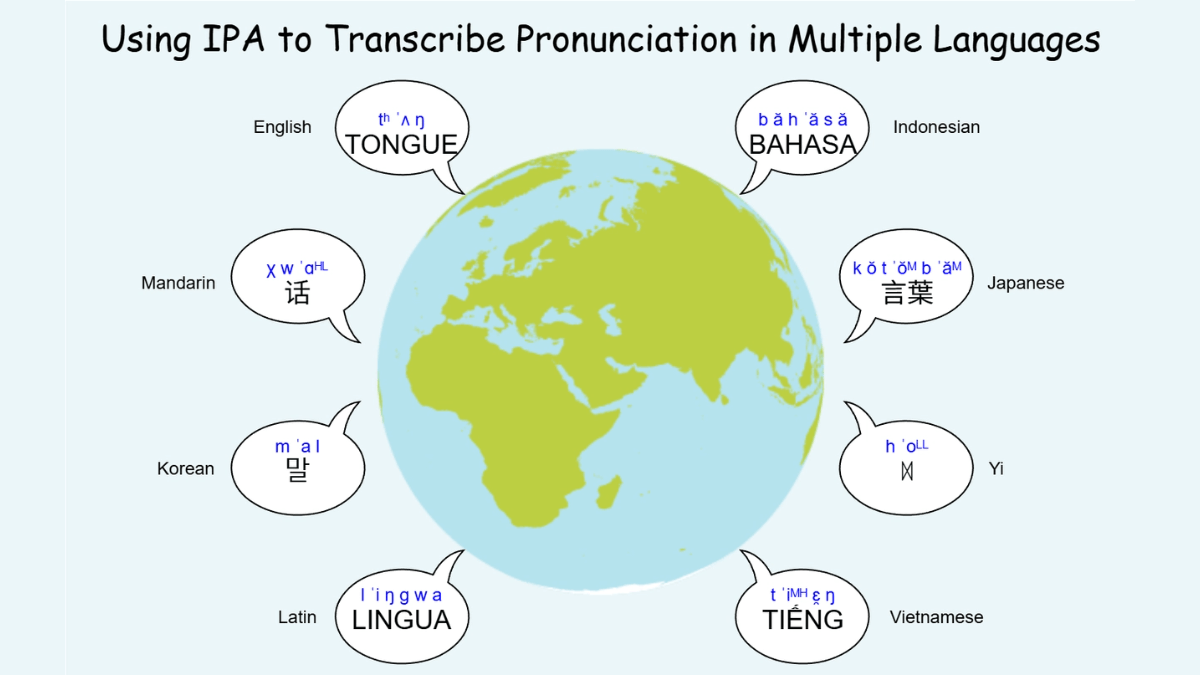
DiaMoE-TTS는 방언 데이터 부족, 직교 불일치, 복잡한 음운 변화 문제를 해결하기 위해 칭화대학교와 거대 네트워크가 공동으로 오픈소스화한 다중 방언 음성 합성 프레임워크로, 국제 음성 알파벳(IPA)을 기반으로 합니다. 통합된 IPA 프런트엔드 표준화된 음소 표현을 통해 방언 간 차이를 제거하여 ...
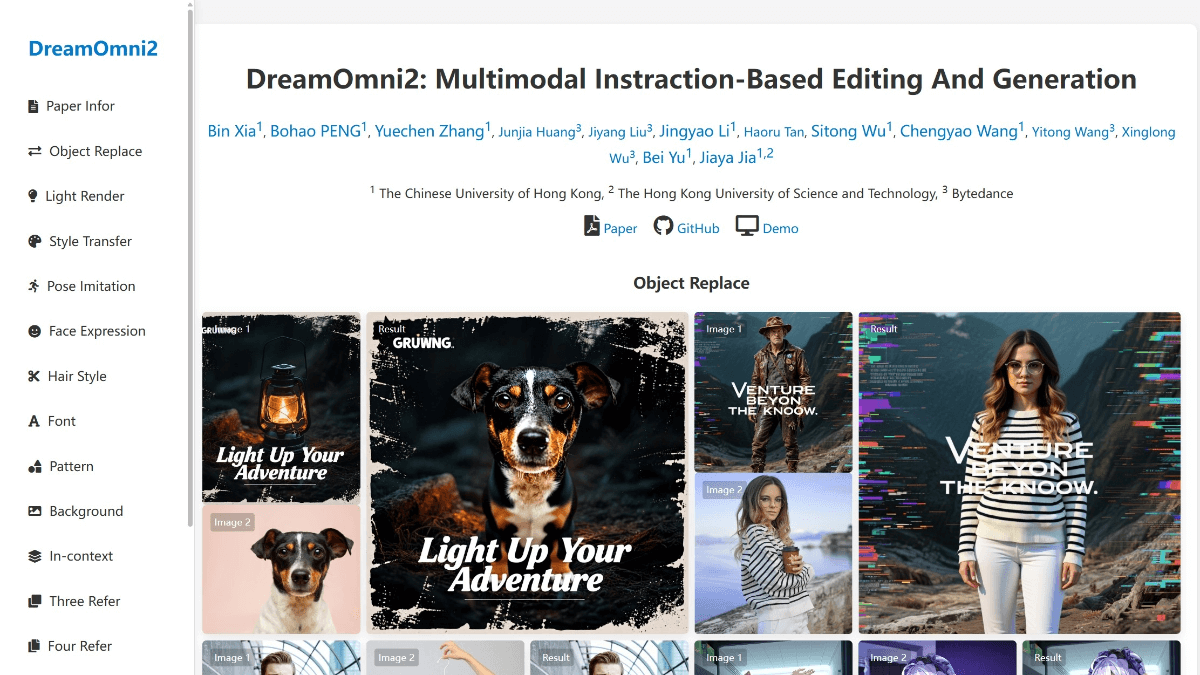
드림옴니2는 HKUST의 Jiajia 팀이 개발한 오픈 소스 멀티모달 AI 이미지 편집 및 생성 모델입니다. 텍스트와 이미지 명령을 동시에 처리할 수 있으며, 여러 참조 이미지를 지원하여 크리에이터에게 보다 유연한 제작 방법을 제공합니다. 이 모델은 3단계 데이터 합성 프로세스, 공동 학습 생성/편집을 통해 훈련됩니다.
Pyscn은 파이썬 개발자가 코드의 잠재적 문제를 감지하여 유지보수성을 개선할 수 있도록 설계된 지능형 코드 품질 분석 도구입니다. 제어 흐름도를 통해 데드 코드를 분석하고, APTED+LSH 알고리즘을 사용하여 중복 코드를 식별하고, 모듈 결합 및 원 복잡도와 같은 메트릭을 계산합니다....
MobileLLM-R1은 수학적, 프로그래밍 및 과학적 추론을 위해 설계된 Meta의 효율적인 추론 모델 오픈 소스 시리즈입니다. 여기에는 각각 1억 4천만 개, 3억 6천만 개, 9억 5천만 개의 매개변수 버전이 포함된 기본 모델과 최종 모델이 포함되어 있습니다. 이 모델은 일반적인 채팅 모델이 아니며 미세 조정(SFT...
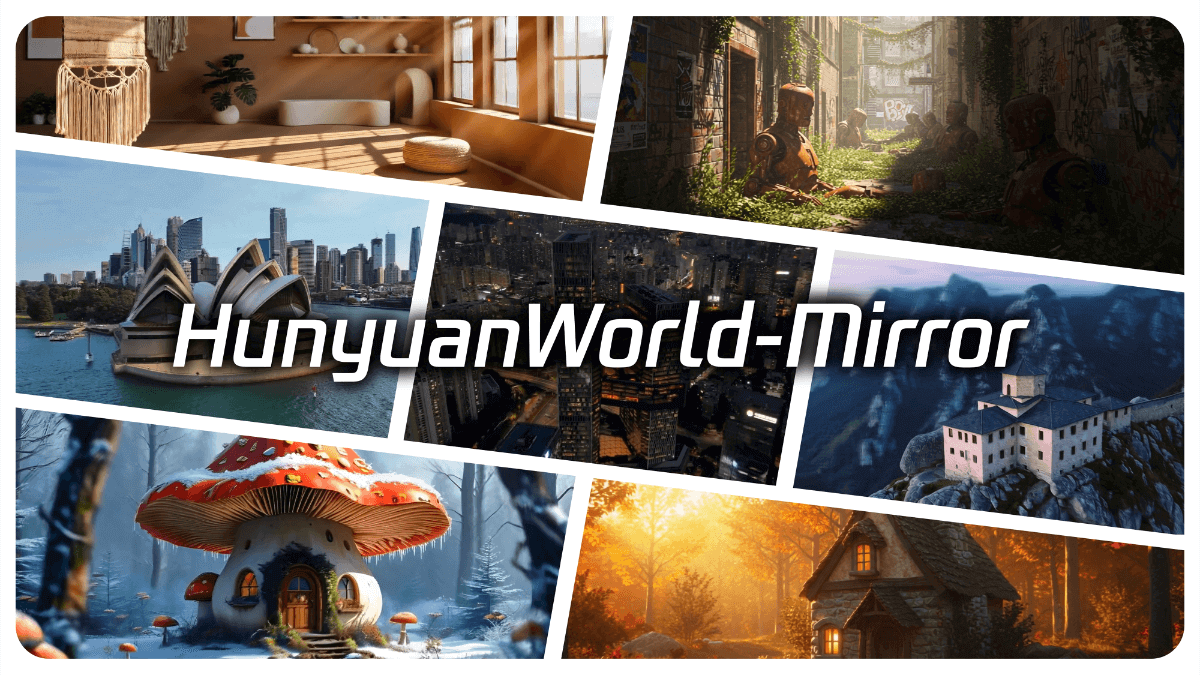
월드미러 1.1(월드미러)은 텐센트 월드미러 팀이 출시한 대형 모델의 오픈 소스 3D 재구성으로, 월드미러 시리즈의 업그레이드 버전입니다. 카메라 위치, 내부 참조, 깊이 맵 등과 같은 멀티뷰 이미지, 비디오 및 멀티 모달 선험적 입력을 지원하며, 기존의 3D 재구성에만 의존하는 방식을 탈피하여...
에버메모스는 첸 티엔차오가 이끄는 샨다 팀이 출시한 오픈 소스 장기 기억 운영체제로, 대규모 언어 모델의 고정된 컨텍스트 창으로 인한 메모리 단절 문제를 해결하기 위해 인공지능을 위해 설계되었습니다. 이 시스템은 인간의 뇌 기억 메커니즘을 기반으로 4계층 아키텍처(에이전트 계층, 메모리 계층, 인덱스 계층, ...
KoalaQA는 Chaitin 팀이 개발한 오픈소스 지능형 애프터서비스 시스템입니다. AI 모델을 기반으로 AI 고객 서비스, AI 검색 및 지식 기반 관리 기능을 제공하여 기업이 지능형 Q&A 플랫폼을 신속하게 구축할 수 있도록 지원합니다. 이 시스템은 연중 무휴 실시간 응답을 지원합니다 ...
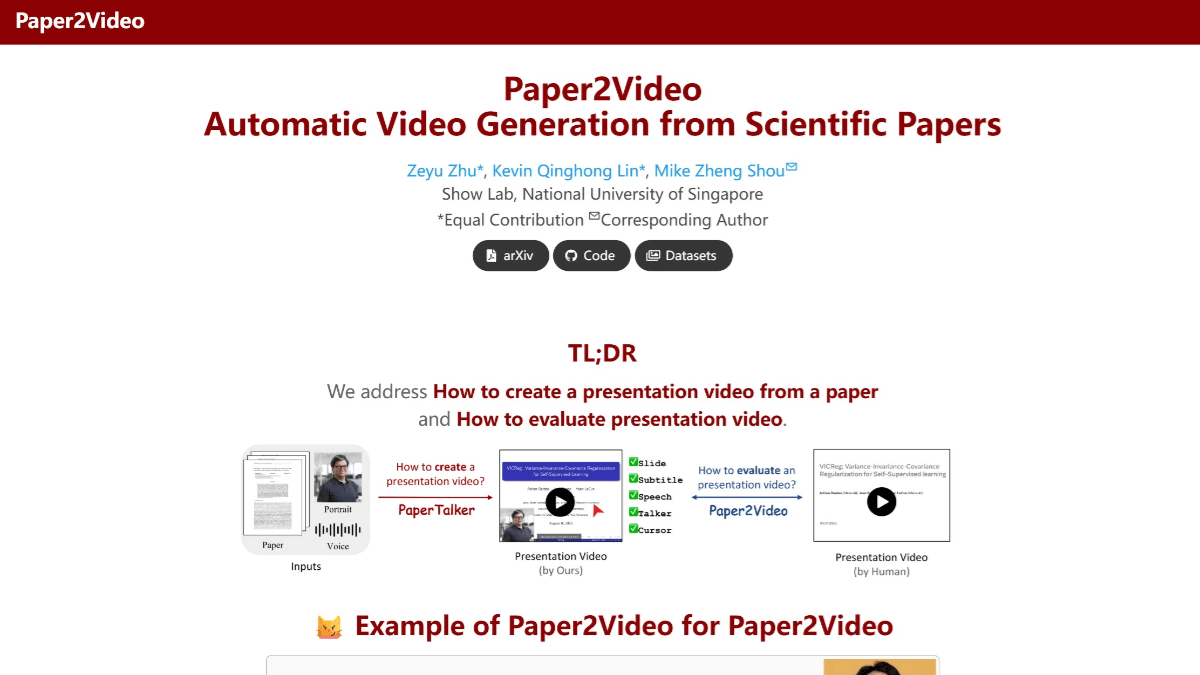
Paper2Video는 싱가포르 국립대학교 쇼 랩에서 학술 논문을 위한 자동 프레젠테이션 비디오 생성을 위한 오픈 소스 프로젝트입니다. PaperTalker 다중 지능 프레임워크를 사용하여 논문을 슬라이드, 자막, 음성 해설 및 발표자 아바타가 포함된 완전한 프레젠테이션 비디오로 변환합니다....
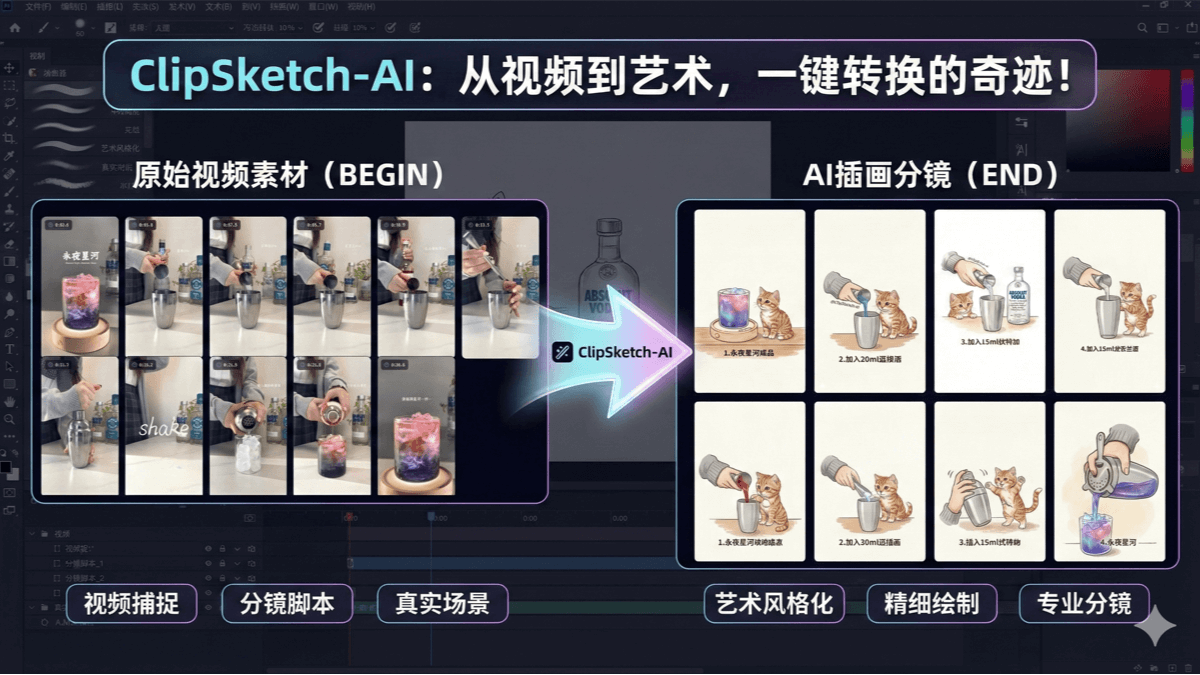
ClipSketch AI는 짧은 동영상 제작자를 위해 설계된 오픈 소스 동영상에서 손으로 그린 분할 화면 도구입니다. B 스테이션, 샤오홍슈 및 기타 플랫폼의 동영상을 한 번의 클릭으로 손으로 그린 스타일의 스토리보드로 변환하고, 키 프레임 표시, 서브 장면 자동 생성 및 소셜 카피를 지원하며, 사용자 정의 역할을 통합할 수 있습니다.
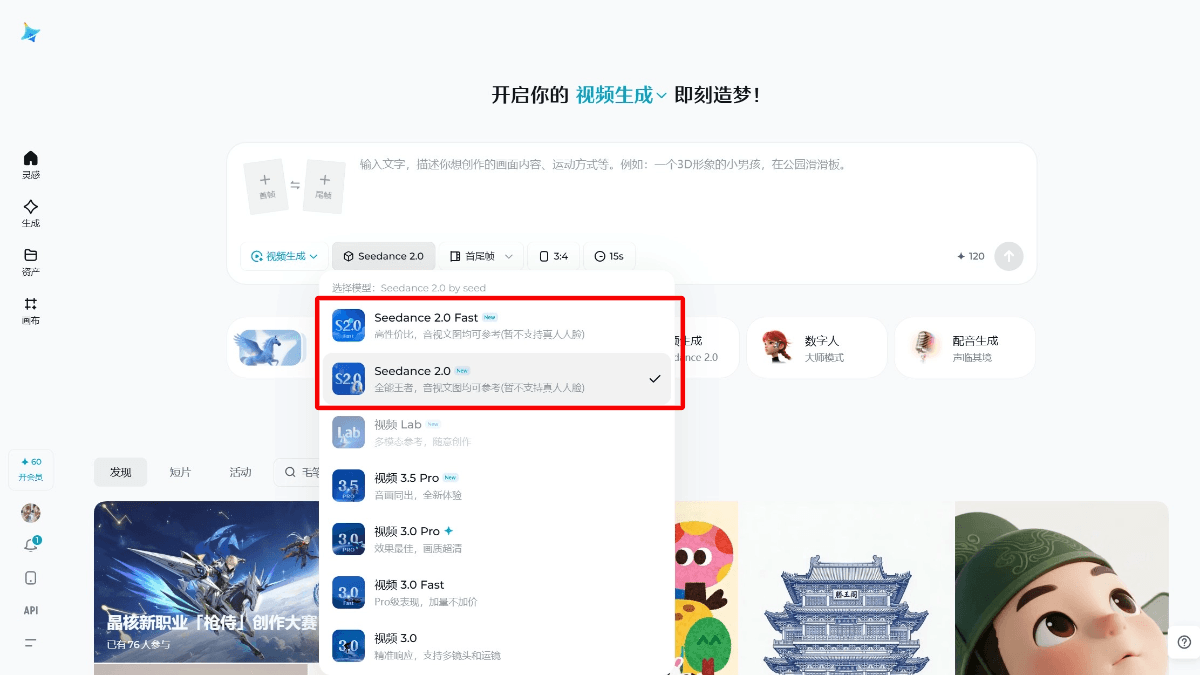
Vidi2는 비디오 콘텐츠 이해, 분석 및 생성에 중점을 둔 2세대 멀티모달 비디오 이해 및 생성 빅모델로, ByteDance에서 오픈소스화했습니다. 텍스트, 비디오 및 오디오 모달리티의 공동 입력을 지원하며, 사진 콘텐츠, 사운드 정보 및 자연어 명령을 동시에 이해하여 모달 간 상호 작용 및 푸시 기능을 구현할 수 있습니다.
노코베이스는 AI 기반 오픈 소스 노코드 개발 플랫폼을 기반으로 비즈니스 시스템의 신속한 구축을 지원하며, 애플리케이션 개발 구성을 통해 프로그래밍을 완료 할 수 없습니다. 이 프로젝트는 Apache-2.0 프로토콜을 사용하고 기업 관리, 협업 플랫폼 및 기타 분야에 적합한 개인 배포 및 유연한 확장 성을 제공합니다 ...
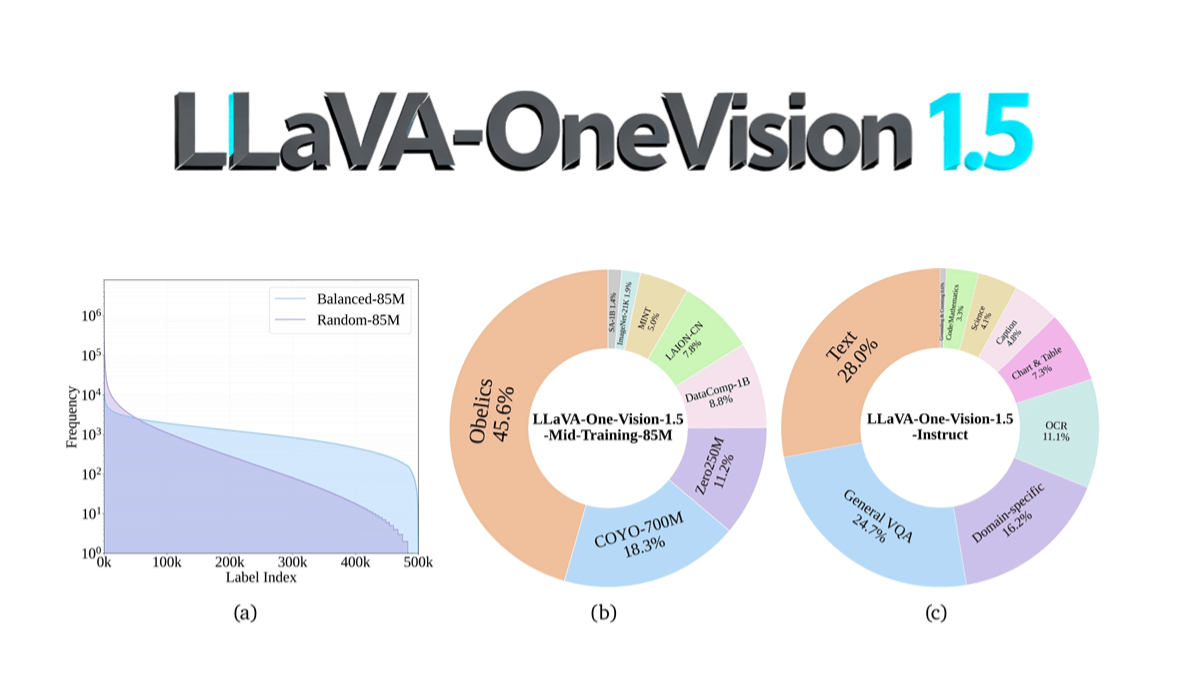
LLaVA-OneVision-1.5는 128개의 A800...에서 8B 파라미터 스케일을 사용하는 EvolvingLMMS-Lab 팀의 오픈 소스 멀티모달 모델로, 컴팩트한 3단계 훈련 프로세스(언어-이미지 정렬, 개념 평형화 및 지식 주입, 명령어 미세 조정)를 통해 학습합니다.
토크코디는 무료 오픈 소스 AI 프로그래밍 어시스턴트 데스크톱 애플리케이션으로, Rust + 타우리 2를 기반으로 구축되어 Windows, macOS, Linux 세 가지 플랫폼을 지원하며 기본 성능, 빠른 시작, 낮은 리소스 사용량 등의 이점을 제공합니다. 50 개 이상의 주류 A 지원 ...
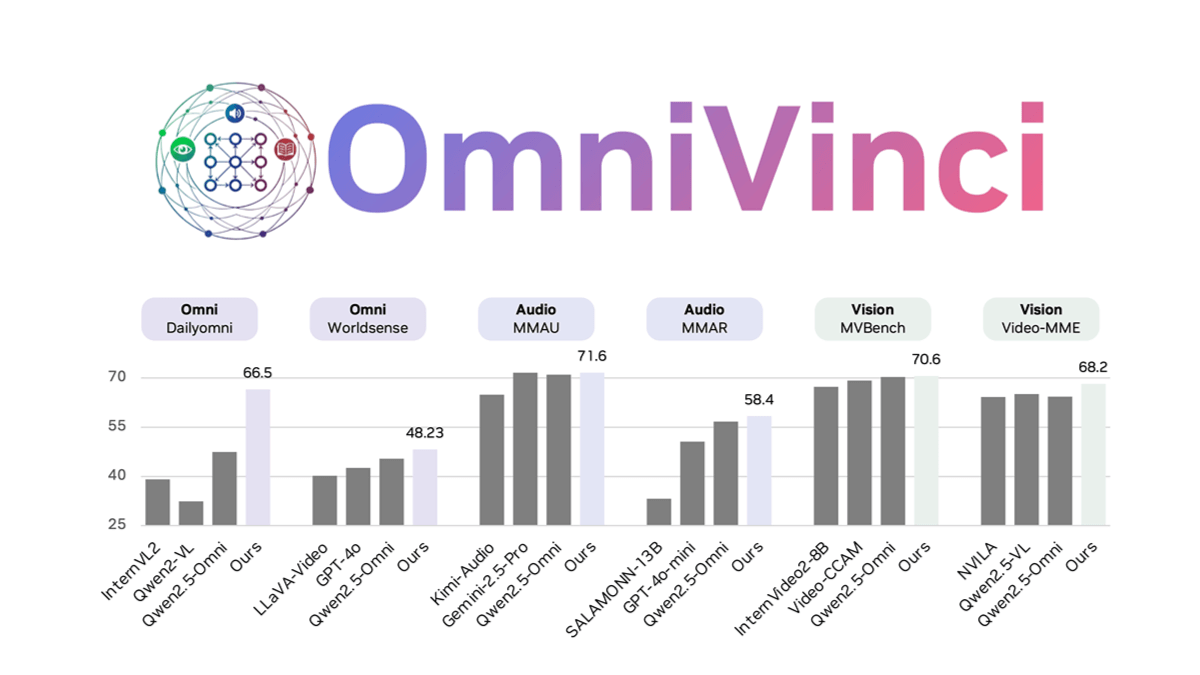
옴니빈치는 아키텍처 혁신과 데이터 최적화를 통해 멀티모달 모델의 모달 파편화 문제를 해결하는 NVIDIA에서 개발한 오픈 소스, 완전 모달, 대규모 언어 모델입니다. 시각 및 오디오 임베딩의 정렬은 일시적으로 임베딩된 그룹 캡처를 활용하는 OmniAlignNet을 통해 향상됩니다.
LazyCraft는 오픈 소스 프레임워크 LazyLLM을 기반으로 상탕이 구축한 오픈 소스 AI 에이전트 애플리케이션 개발 및 관리 플랫폼으로, 기업과 개발자를 위한 원스톱 AI 애플리케이션 개발 솔루션을 제공합니다. 개발자가 낮은 임계값과 저렴한 비용으로 대규모 모델 애플리케이션을 신속하게 빌드하고 출시할 수 있도록 지원합니다.
SAM 3D는 Meta의 SAM 시리즈를 기반으로 하는 3D 재구성 모델로, SAM 3D 오브젝트와 SAM 3D 바디의 두 가지로 구성되어 있습니다. SAM 3D 오브젝트는 단일 사진에서 인터랙티브 3D 오브젝트 모델을 생성할 수 있으며, 다음과 같은 기능을 지원합니다.
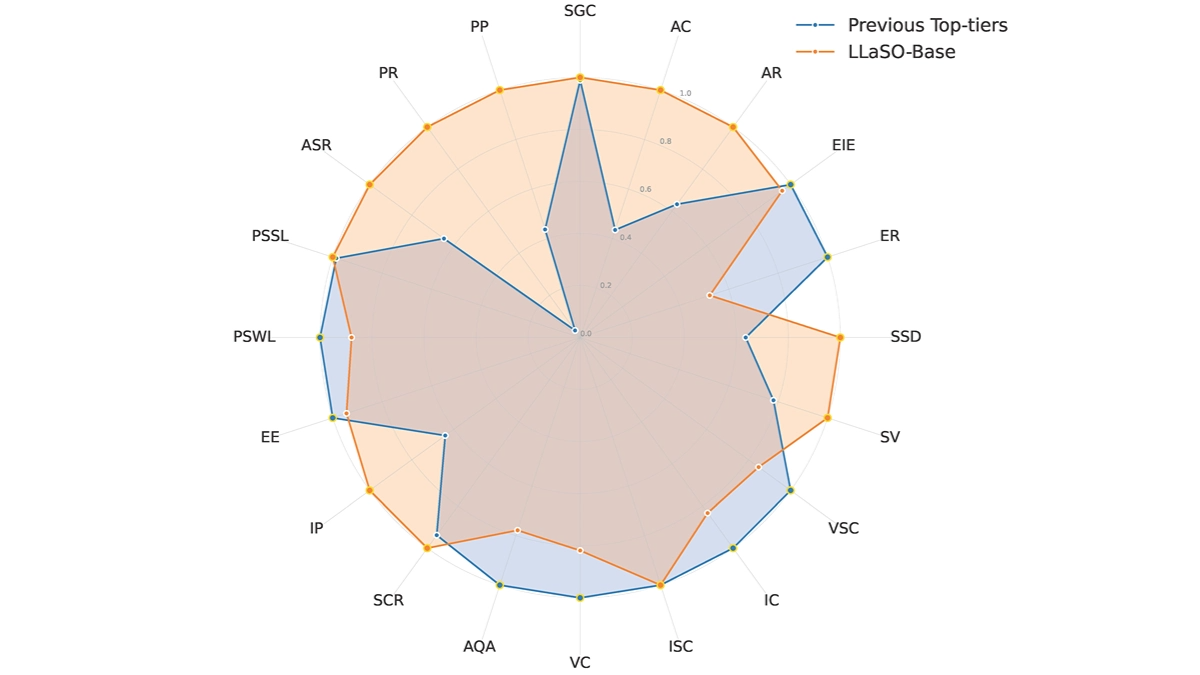
LLaSO는 베이징 뎁스 로직 인텔리전스 테크놀로지가 출시한 오픈 소스 음성 모델로, 음성 및 텍스트 데이터를 통합하고 정렬 데이터 세트, 명령 미세 조정 데이터 세트 및 평가 벤치마크를 제공하여 대규모 음성 언어 모델링 분야의 데이터 분산과 작업 범위 부족 문제를 해결합니다.
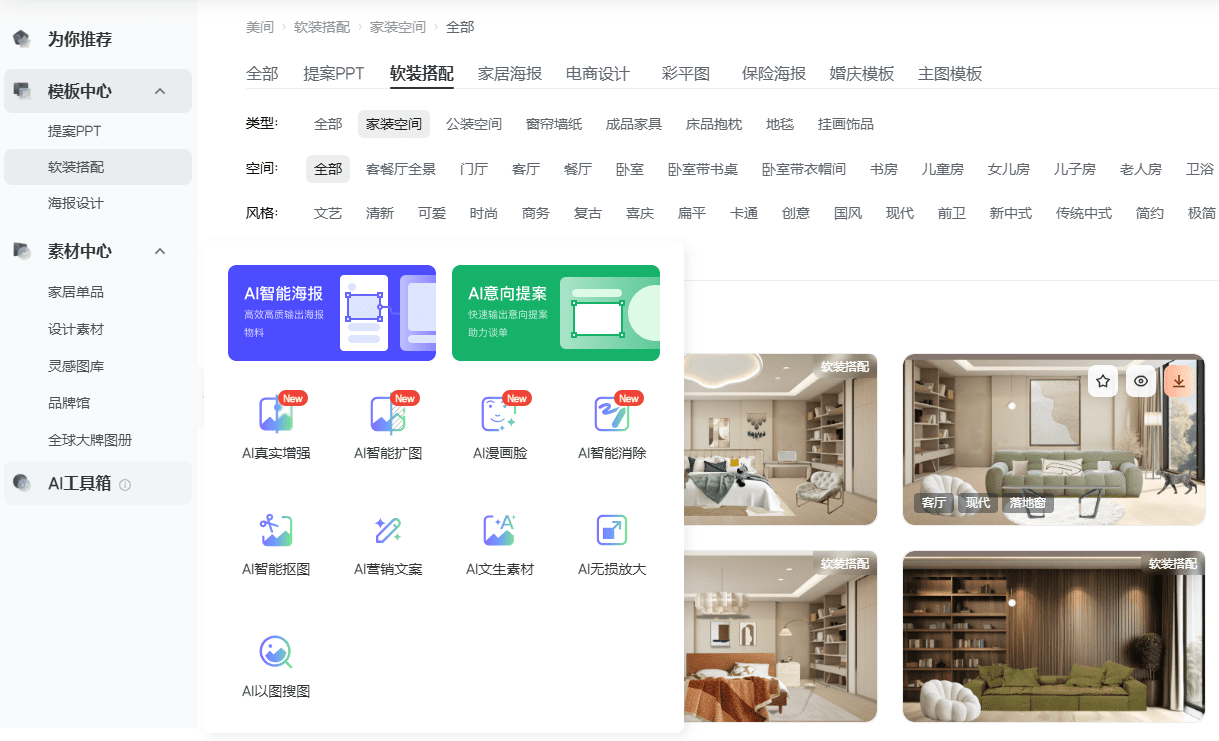
종합 소개 Meiman은 주택 디자인 및 마케팅 협상에 중점을 둔 온라인 플랫폼입니다. 이 사이트는 디자이너와 주택 소유주가 고품질 디자인 제안서를 신속하게 생성할 수 있도록 풍부한 디자인 자료, 소프트 퍼니싱 및 제안서 PPT 템플릿, 포스터 템플릿 등을 제공합니다. 메이만의 온라인 소프트 퍼니싱 디자인 도구는 단 10초 만에 사용할 수 있습니다 ...
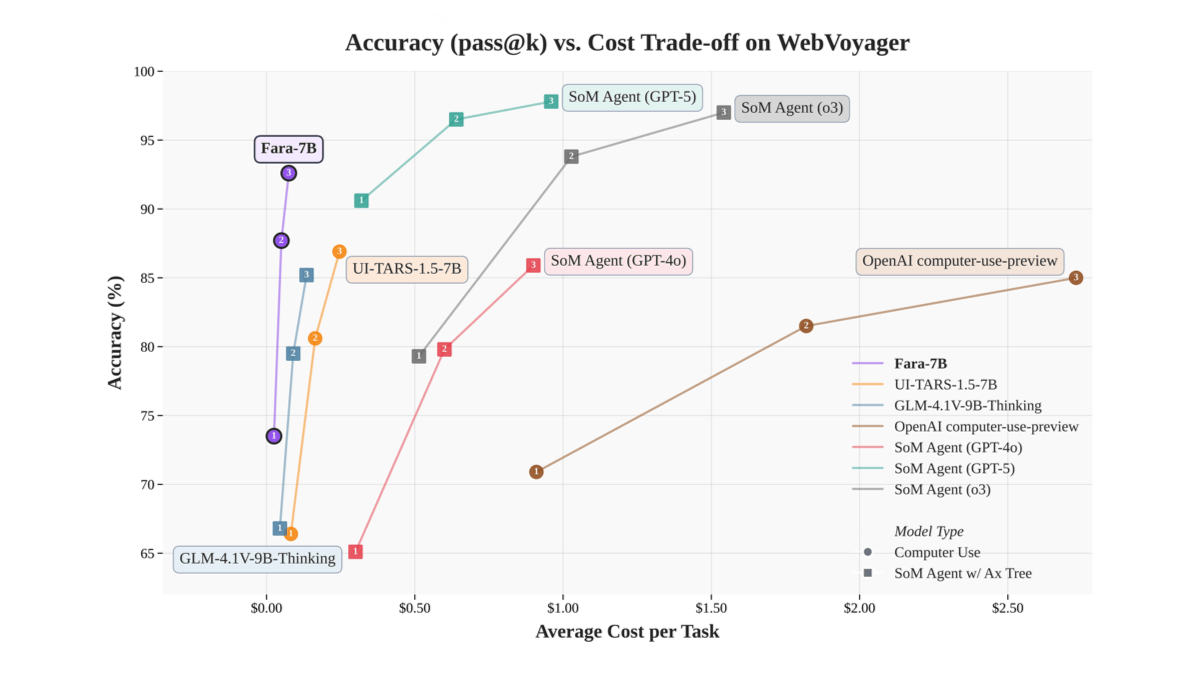
Fara-7B는 Qwen 2.5-VL-7B 아키텍처를 기반으로 하는 70억 개 매개변수 규모의 컴퓨터 운영 에이전트(CUA) 모델의 Microsoft 오픈 소스 릴리스입니다. 웹 페이지의 스크린샷을 시각적으로 구문 분석하고 화면에서 클릭, 입력 등을 수행함으로써 추가적인 접근성 트리나 여러 개의 대형 모델에 의존할 필요가 없습니다....









 한국어
 简体中文
 English
 日本語
 Русский
 Español