
M3.1-Flash-Preview是什么
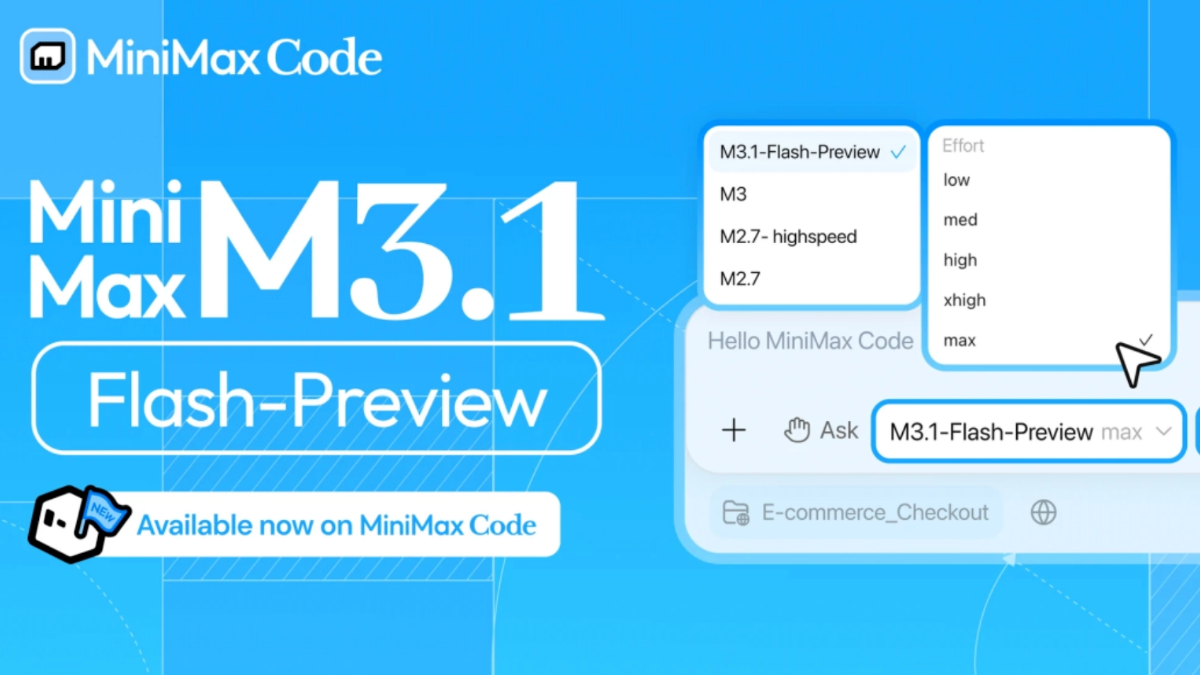
M3.1-Flash-Preview 是 MiniMax 推出的编程大模型,首发于 MiniMax Code 平台,面向日常开发场景,能完成从 Bug 定位、代码实现到测试验证的完整交付流程。M3.1-Flash-Preview 支持文本、图像、视频等多模态输入,拥有百万级上下文窗口,可一次性处理大型代码库。同时提供 low 至 max 五档推理强度调节,首字延迟约 280ms,兼顾速度与深度。
M3.1-Flash-Preview的功能特色
- 全链路开发闭环:能从问题定位、逻辑实现一路做到测试验证与成果交付,覆盖日常编码全流程。
- 边界情况处理细腻:对开发需求的理解较为深入,能妥善处理各种边角场景,交付质量稳定。
- 测试自动补全:改完代码后自动生成回归测试用例,并检查改动是否影响既有功能,降低合并后的回归风险。
- 多模态需求输入:可直接看懂文本、截图甚至视频,需求表达更直观,理解更准确。
- 超长上下文能力:百万级 token 窗口,整仓代码、长文档一次喂入也不截断,适合大型项目分析。
- 五档推理强度:low 到 max 自由调节,简单任务秒回,复杂任务深度思考,速度与质量自己权衡。
- 又快又省:首字延迟约 280ms、生成速度约 126 tokens/秒,配合稀疏架构和激进量化,调用成本显著低于同档位模型。
M3.1-Flash-Preview的核心优势
- 端到端交付能力:把定位、写码、测验证、交付串成一条流水线,开发者只需描述需求,不用在多个工具间来回切换。
- 响应速度出众:首字延迟低至约 280ms,生成速度约 126 tokens/秒,轻量任务几乎即问即答。
- 超长上下文窗口:百万 token 容量让它能一口气读完整仓库,做架构分析和跨文件重构时不会因截断而丢上下文。
- 输入形式灵活:原生支持文本、图像、视频,贴张报错截图或录段操作视频能让它理解问题。
- 推理强度可控:low 至 max 五档 Effort 自由切换,简单修复求快、复杂开发求深,用户按场景自主权衡。
M3.1-Flash-Preview官网是什么
- 项目官网:https://agent.minimaxi.com/download
M3.1-Flash-Preview的操作步骤
- 获取客户端:访问 MiniMax Code 官网https://agent.minimaxi.com/download,按操作系统下载并安装。
- 登录账号:启动客户端,使用 MiniMax 账号完成登录。
- 切换模型:在模型列表中找到并选中 M3.1-Flash-Preview。
- 调节强度:根据任务难度在 low~max 五档中选择合适的推理强度。
- 下达任务:直接用自然语言描述开发需求(如修复 Bug、实现功能),模型会自动完成分析、编码、测试并输出结果。
M3.1-Flash-Preview的适用人群
- 个人开发者 / 独立开发者:一人身兼多职,需要模型从需求理解到代码交付全流程包办,且推理成本低,高频使用无压力。
- 敏捷团队开发工程师:日常 Bug 修复、功能快速迭代场景多,280ms 级别的响应速度能跟上高频开发节奏。
- 大型项目维护者:需要处理庞大代码库、做跨文件重构和影响评估的人群,百万级上下文窗口正好解决传统模型读不完整个仓库的痛点。
- 多模态协作型开发者:习惯用截图、报错录屏等方式描述问题的用户,可直接把图像、视频丢给模型理解。
M3.1-Flash-Preview的常见问题
Q1:普通用户能直接使用 M3.1-Flash-Preview 吗?
A1:不能。目前仅限 MiniMax Code 客户端和 Token Plan 用户,暂不支持 API 或其他渠道调用。
Q2:五档推理强度(Effort)有什么区别?
A2:从 low 到 max 共五档,强度越低响应越快、消耗越低,适合简单任务;强度越高思考越深入,适合复杂开发。例如 Low 档首字延迟可低至约 210ms,可按任务复杂度自由权衡。
Q3:它最多能处理多长的代码?
A3:支持百万级 token 上下文窗口,可以一次性读入大型代码库或长文档,无需手动拆分项目。
Q4:支持哪些类型的输入?
A4:原生多模态,支持文本、图像、视频输入,例如贴报错截图或录屏辅助理解需求。
Q5:生成速度怎么样?
A5:首字延迟约 280ms,生成速度约 126 tokens/秒,轻量任务体验接近瞬时。
© 版权声明
文章版权归 AI分享圈 所有,未经允许请勿转载。
相关文章

暂无评论...
 简体中文
 English
 日本語
 한국어
 Русский
 Español