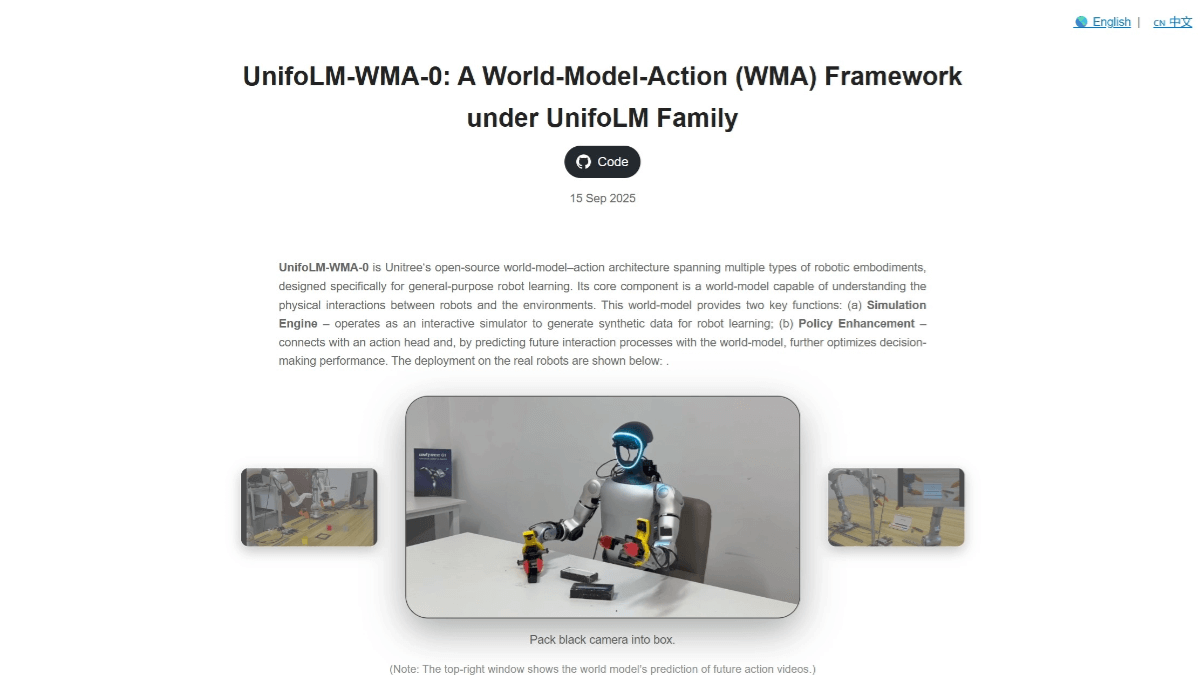

MOSS-Image是什么
MOSS-Image 是模思智能与 OpenMOSS 团队联合推出的开源文生图模型,以 5B 参数的扩散 Transformer 为核心,搭配 Qwen3.5-9B 文本编码器与 FLUX.2 VAE。MOSS-Image主打文字渲染与版式控制,支持中英文长文本、JSON 布局指令和最高 4096 tokens 的提示词,通过剔除 AI 生成图的训练策略降低"AI 味",适合海报、电商图等设计场景。
MOSS-Image的功能特色
- 文生图生成:仅凭文字描述可产出写实照片、动漫、插画等多种风格画面。
- 中英文字渲染:对密集排版与长段落文字做专项优化,能较好保留换行等格式。
- 结构化布局控制:通过 JSON 中的 summary、items、bbox 字段,精确指定标题、物体与文字的位置。
- 超长提示词支持:最长可处理 4096 tokens,适合包含多主体、空间关系和镜头语言的复杂需求。
- 丰富部署生态:提供 Diffusers、Gradio、ComfyUI、SGLang、vLLM-Omni 等多种接入方式,并有量化、加速和 LoRA 等社区衍生方案。
MOSS-Image的核心优势
- 画面更自然:训练时剔除了 AI 生成图像,削弱常见的"塑料感"和过度修饰,成片更接近真实摄影质感。
- 文字渲染领先:针对中英文密集文本重点调优,LLTB 基准 Mean-6 覆盖率达 96.3%,在开放权重模型中表现突出。
- 布局精细可控:原生支持 JSON Layout 与 Bounding Box 指令,标题、物体、文字的位置都能显式指定,构图不再"靠猜"。
- 复杂指令消化能力强:4096 tokens 的长提示词上限,让多主体、空间关系、镜头语言等细节可以同时传达给模型。
- 轻量易二次开发:5B 参数规模便于微调,加上 Apache-2.0 宽松协议,LoRA、量化和加速衍生模型在社区快速涌现。
MOSS-Image的项目地址
- 项目官网:https://openmoss.ai/MOSS-Image/
- GitHub仓库:https://github.com/OpenMOSS/MOSS-Image
- HuggingFace模型库:
- https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
- https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base
- 技术论文:https://github.com/OpenMOSS/MOSS-Image/blob/main/paper/MOSS_Image_Technical_Report.pdf
MOSS-Image的使用步骤
- 搭建环境:准备 Python 3.10+ 和 NVIDIA GPU,安装与 CUDA 版本匹配的 PyTorch。
- 获取代码:从 GitHub 克隆 MOSS-Image 仓库,并创建独立的虚拟环境。
- 安装依赖:激活虚拟环境后,运行 requirements.txt 安装所需库。
- 加载模型:通过 Diffusers 以 custom_pipeline="pipeline_moss_image" 方式加载 Base 或 SFT 权重。
- 设置精度:DiT 建议用 bfloat16、VAE 用 float32,然后将管道移至 CUDA。
- 普通生图:输入自然语言描述,设定宽高、推理步数(如 50 步)和引导系数(如 3.0)即可生成。
- 布局生图:把标题、物体和文字位置写成 JSON 格式的 Layout,作为提示词传入以控制排版。
- 复杂需求:用 Prompt Enhancer 将创意扩写成详细描述或结构化布局,再交给模型生成。
- ComfyUI 方案:在 ComfyUI Manager 中搜索安装 MOSS-Image 插件,导入示例工作流直接运行。
MOSS-Image的适用人群
- 平面设计师 / 电商美工:需要快速产出海报、详情页、主图,且对文字排版位置有精确要求的人群。
- 自媒体与内容运营:经常需要为公众号、小红书等平台生成带文案的配图,看重中英文文字渲染能力。
- AI 绘画爱好者与二次元创作者:想利用多风格 LoRA 进行插画、人物、概念设计,且希望本地部署、自由微调。
- 开发者与技术团队:需要 Apache-2.0 宽松协议做二次开发、集成进产品或搭建私有生图服务的技术人员。
MOSS-Image的常见问题
Q1:MOSS-Image 对显卡有什么要求?
A1:官方建议 NVIDIA GPU、显存 12–24GB 分层可用;显存紧张时可选择 INT8/GGUF/MLX 量化版本,或开启 8步/4步加速与模型卸载策略。
Q2:可以用来做"图生图"或图片编辑吗?
A2:目前图像编辑链路较弱,它主要定位为文生图模型,这是其主要短板之一。
Q3:支持中文提示词吗?文字能渲染中文吗?
A3:可以。文本编码器为 Qwen3.5-9B,对中文提示词和中英文密集/长文本渲染都做了专项优化。
Q4:商用授权有限制吗?
A4:权重采用 Apache-2.0 协议,允许商用和二次开发,这也是其相较部分闭源模型的优势。
Q5:如何精确控制海报上文字和元素的位置?
A5:使用原生 JSON Layout 功能,通过 summary、items、text、bbox 字段指定各元素坐标,而非仅靠自然语言描述。
© 版权声明
文章版权归 AI分享圈 所有,未经允许请勿转载。
相关文章

暂无评论...
 简体中文
 English
 日本語
 한국어
 Русский
 Español