에버메모스는 첸 티엔차오가 이끄는 샨다 팀이 출시한 오픈 소스 장기 기억 운영체제로, 대규모 언어 모델의 고정된 컨텍스트 창으로 인한 메모리 단절 문제를 해결하기 위해 인공지능을 위해 설계되었습니다. 이 시스템은 인간의 뇌 기억 메커니즘을 기반으로 4계층 아키텍처(에이전트 계층, 메모리 계층, 인덱스 계층, ...
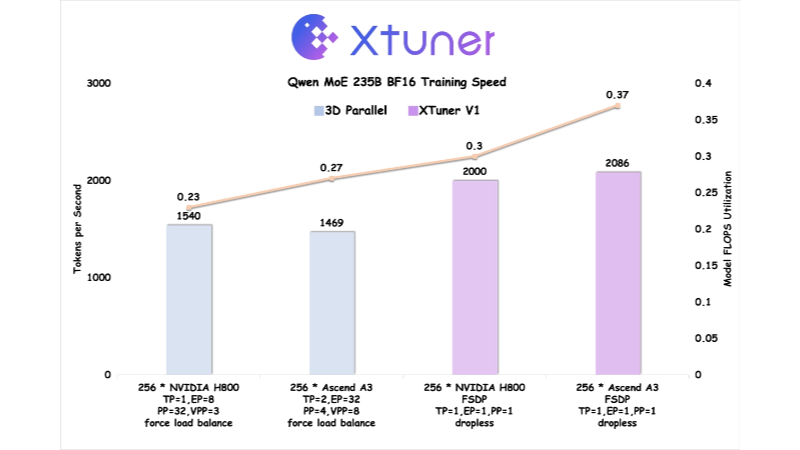
XTuner V1은 상하이 인공 지능 연구소에서 오픈 소스화한 차세대 대규모 모델 훈련 엔진으로, 초대형 스파스 혼합 전문가(MoE) 모델 훈련을 위해 설계되었습니다. PyTorch FSDP를 기반으로 개발된 이 엔진은 메모리, 통신 및 로드의 다차원 최적화를 통해 고성능을 달성합니다.
노코베이스는 AI 기반 오픈 소스 노코드 개발 플랫폼을 기반으로 비즈니스 시스템의 신속한 구축을 지원하며, 애플리케이션 개발 구성을 통해 프로그래밍을 완료 할 수 없습니다. 이 프로젝트는 Apache-2.0 프로토콜을 사용하고 기업 관리, 협업 플랫폼 및 기타 분야에 적합한 개인 배포 및 유연한 확장 성을 제공합니다 ...
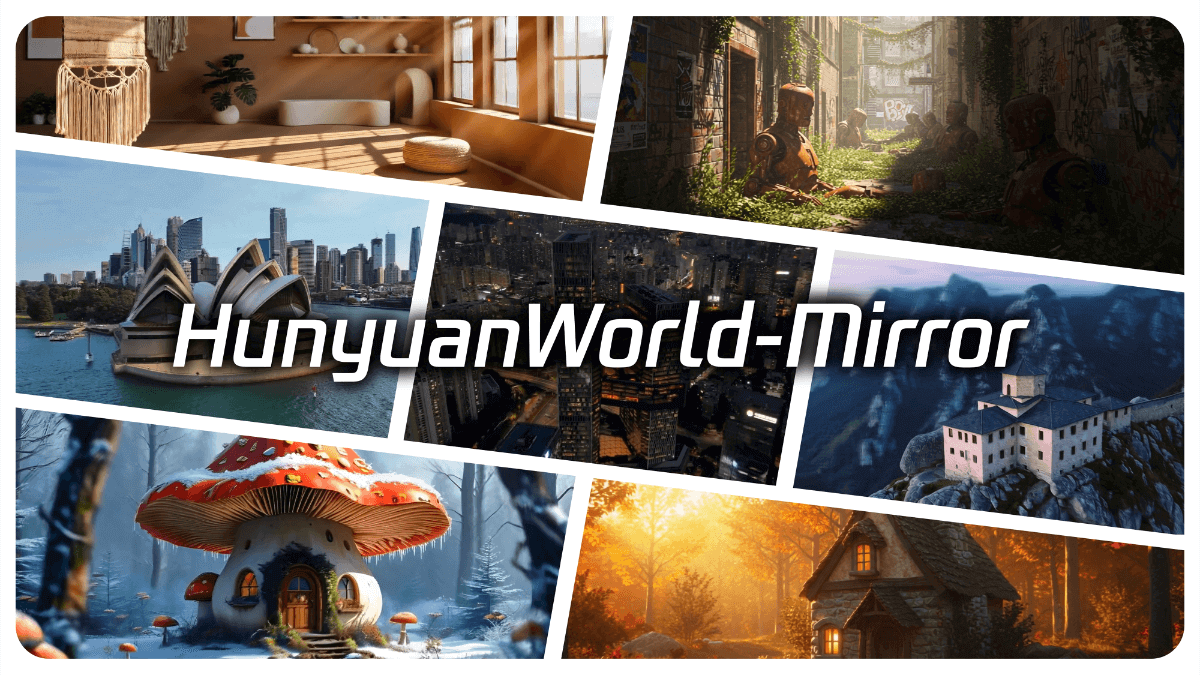
월드미러 1.1(월드미러)은 텐센트 월드미러 팀이 출시한 대형 모델의 오픈 소스 3D 재구성으로, 월드미러 시리즈의 업그레이드 버전입니다. 카메라 위치, 내부 참조, 깊이 맵 등과 같은 멀티뷰 이미지, 비디오 및 멀티 모달 선험적 입력을 지원하며, 기존의 3D 재구성에만 의존하는 방식을 탈피하여...
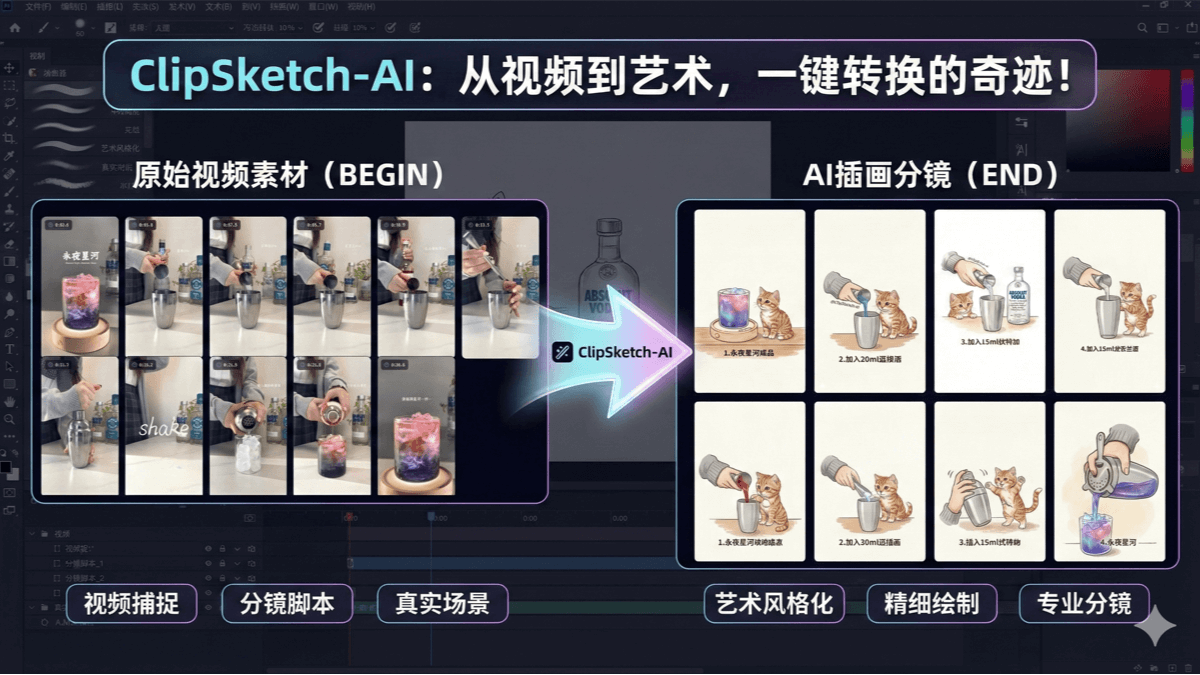
ClipSketch AI는 짧은 동영상 제작자를 위해 설계된 오픈 소스 동영상에서 손으로 그린 분할 화면 도구입니다. B 스테이션, 샤오홍슈 및 기타 플랫폼의 동영상을 한 번의 클릭으로 손으로 그린 스타일의 스토리보드로 변환하고, 키 프레임 표시, 서브 장면 자동 생성 및 소셜 카피를 지원하며, 사용자 정의 역할을 통합할 수 있습니다.
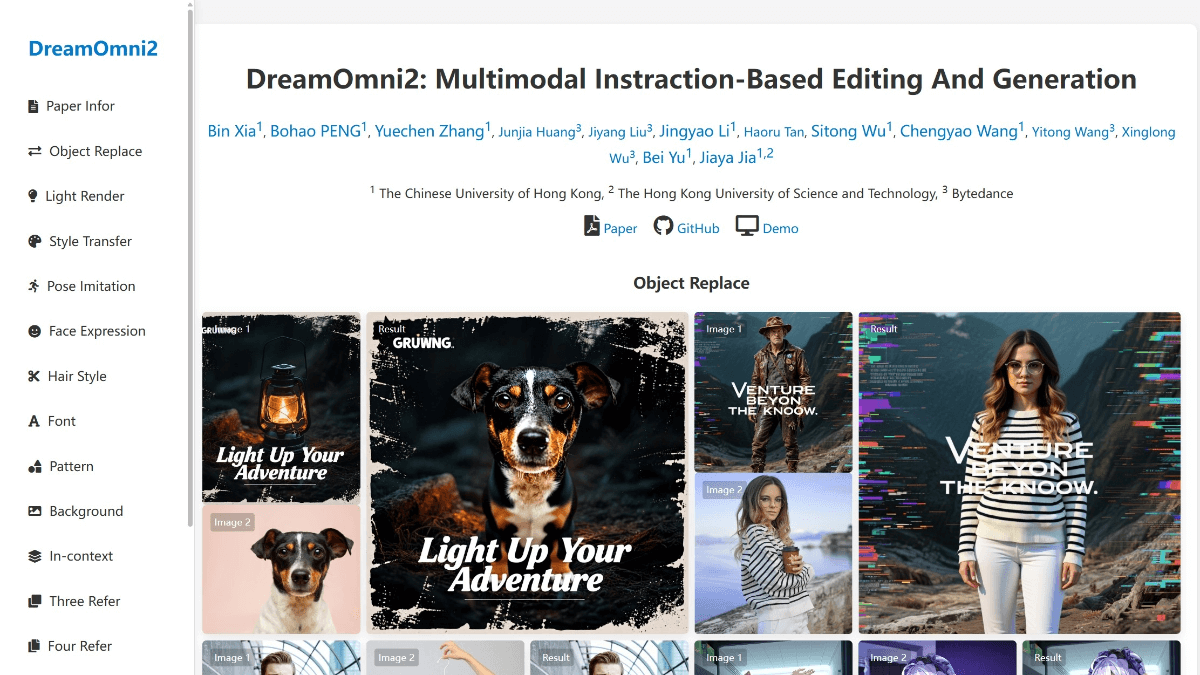
드림옴니2는 HKUST의 Jiajia 팀이 개발한 오픈 소스 멀티모달 AI 이미지 편집 및 생성 모델입니다. 텍스트와 이미지 명령을 동시에 처리할 수 있으며, 여러 참조 이미지를 지원하여 크리에이터에게 보다 유연한 제작 방법을 제공합니다. 이 모델은 3단계 데이터 합성 프로세스, 공동 학습 생성/편집을 통해 훈련됩니다.
토크코디는 무료 오픈 소스 AI 프로그래밍 어시스턴트 데스크톱 애플리케이션으로, Rust + 타우리 2를 기반으로 구축되어 Windows, macOS, Linux 세 가지 플랫폼을 지원하며 기본 성능, 빠른 시작, 낮은 리소스 사용량 등의 이점을 제공합니다. 50 개 이상의 주류 A 지원 ...
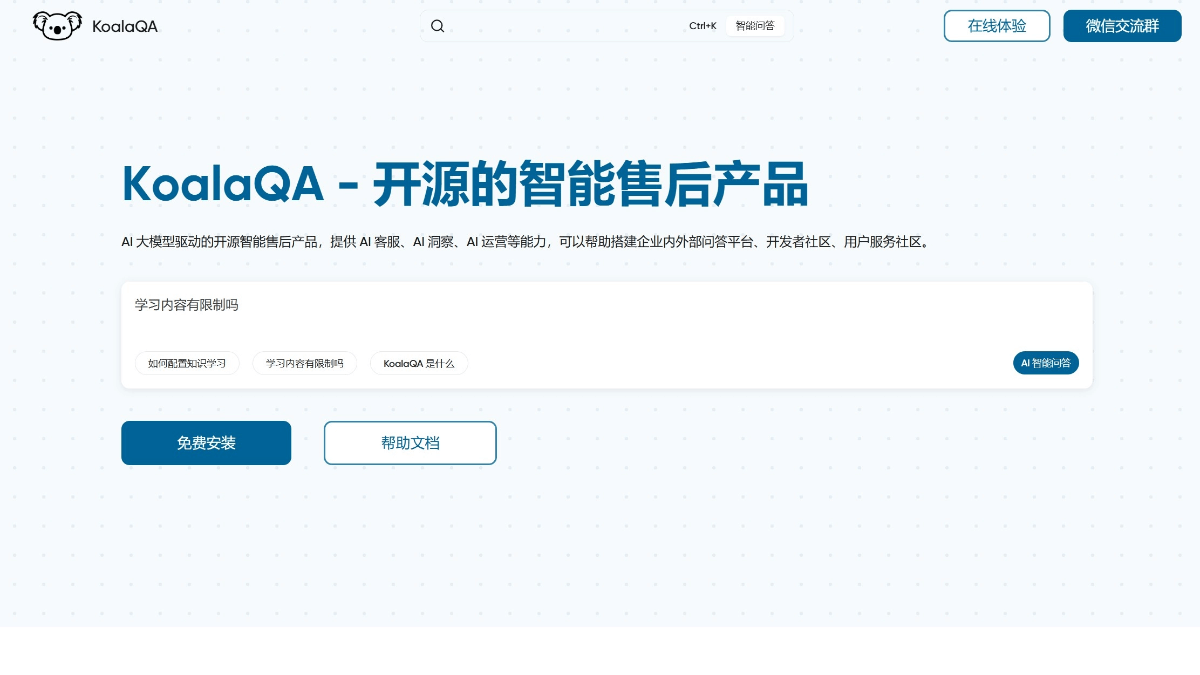
KoalaQA는 Chaitin 팀이 개발한 오픈소스 지능형 애프터서비스 시스템입니다. AI 모델을 기반으로 AI 고객 서비스, AI 검색 및 지식 기반 관리 기능을 제공하여 기업이 지능형 Q&A 플랫폼을 신속하게 구축할 수 있도록 지원합니다. 이 시스템은 연중 무휴 실시간 응답을 지원합니다 ...
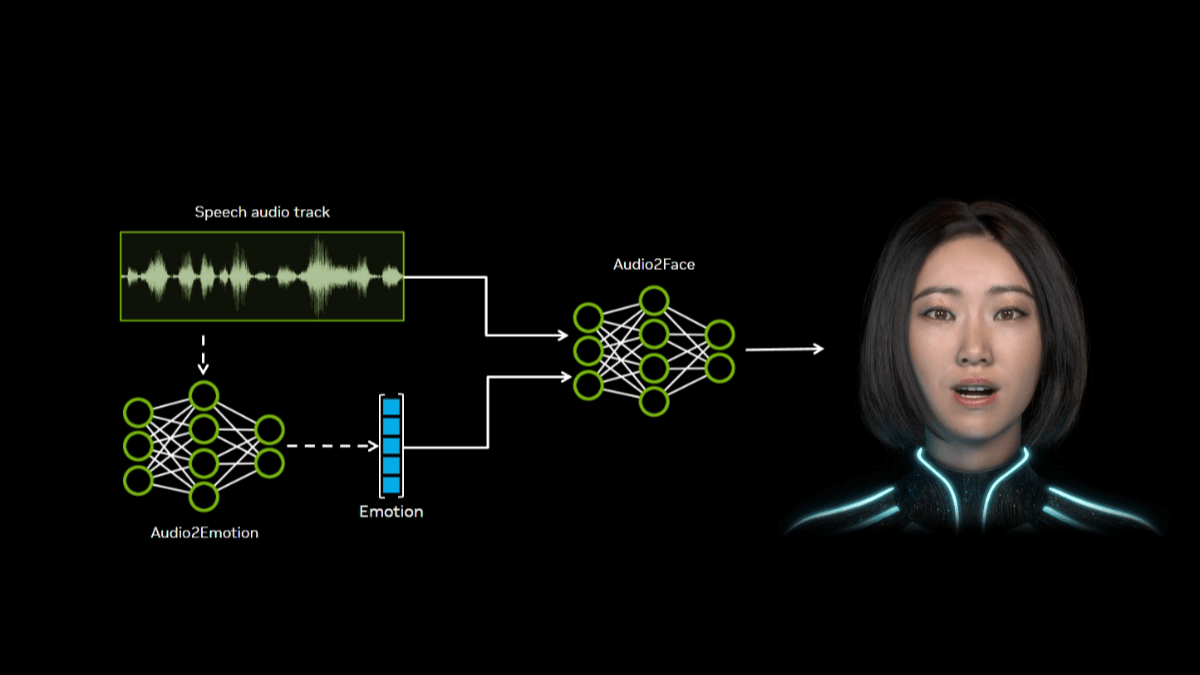
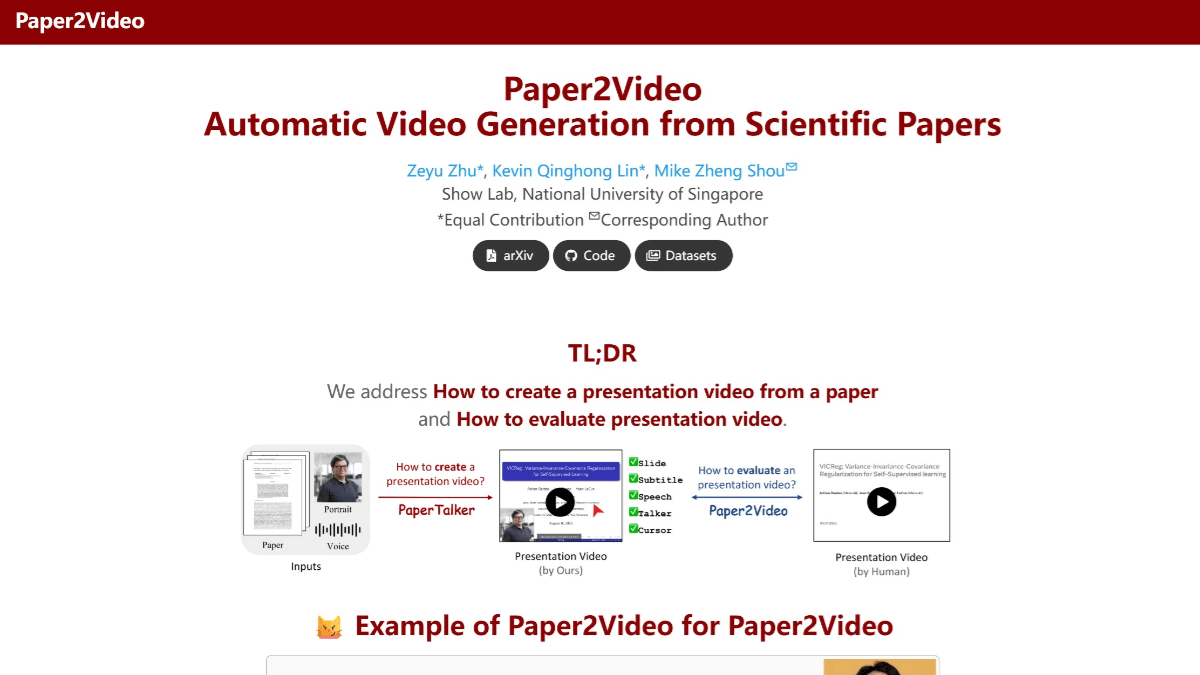
Paper2Video는 싱가포르 국립대학교 쇼 랩에서 학술 논문을 위한 자동 프레젠테이션 비디오 생성을 위한 오픈 소스 프로젝트입니다. PaperTalker 다중 지능 프레임워크를 사용하여 논문을 슬라이드, 자막, 음성 해설 및 발표자 아바타가 포함된 완전한 프레젠테이션 비디오로 변환합니다....
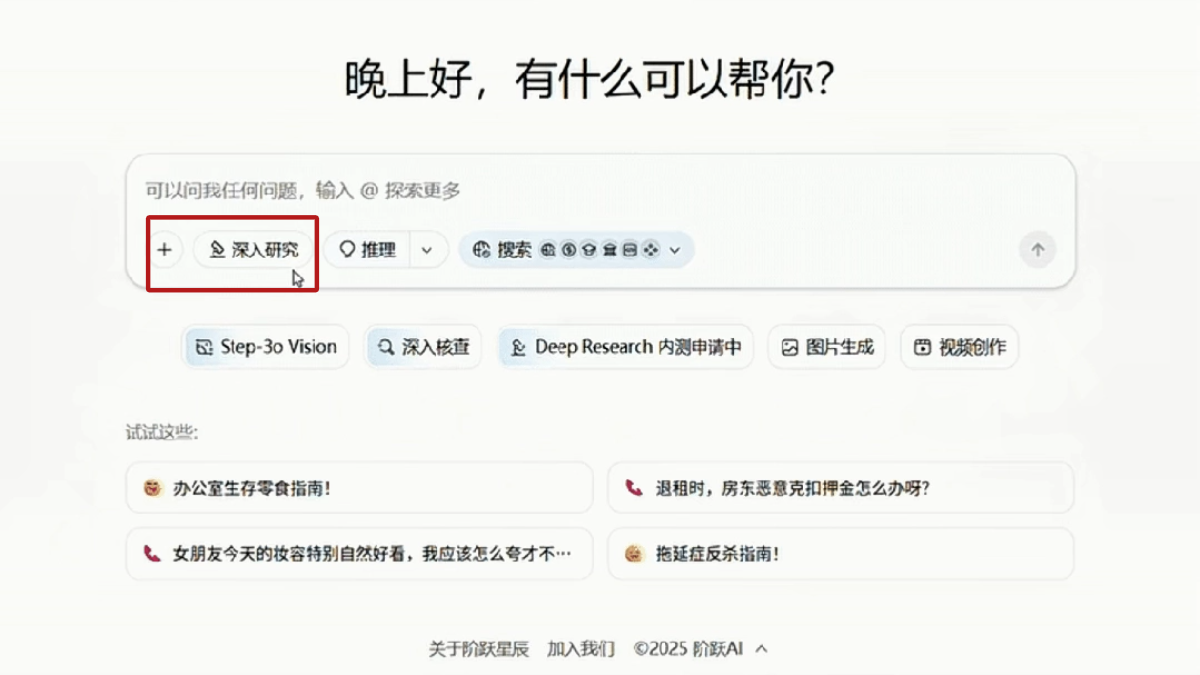
스텝스 딥 리서치는 스텝스 스타에서 출시한 효율적인 인공지능 리서치 도구로, 복잡한 이슈에 대한 리서치를 자율적으로 완료하고 단기간에 전문적인 보고서를 생성할 수 있습니다. 이 도구는 금융, 컨설팅, 의료, 법률 및 기타 분야를 위해 설계되었으며 심층적인 검색 및 정보 통합 기능으로 업계에서 뛰어난 평가를 받고 있습니다.
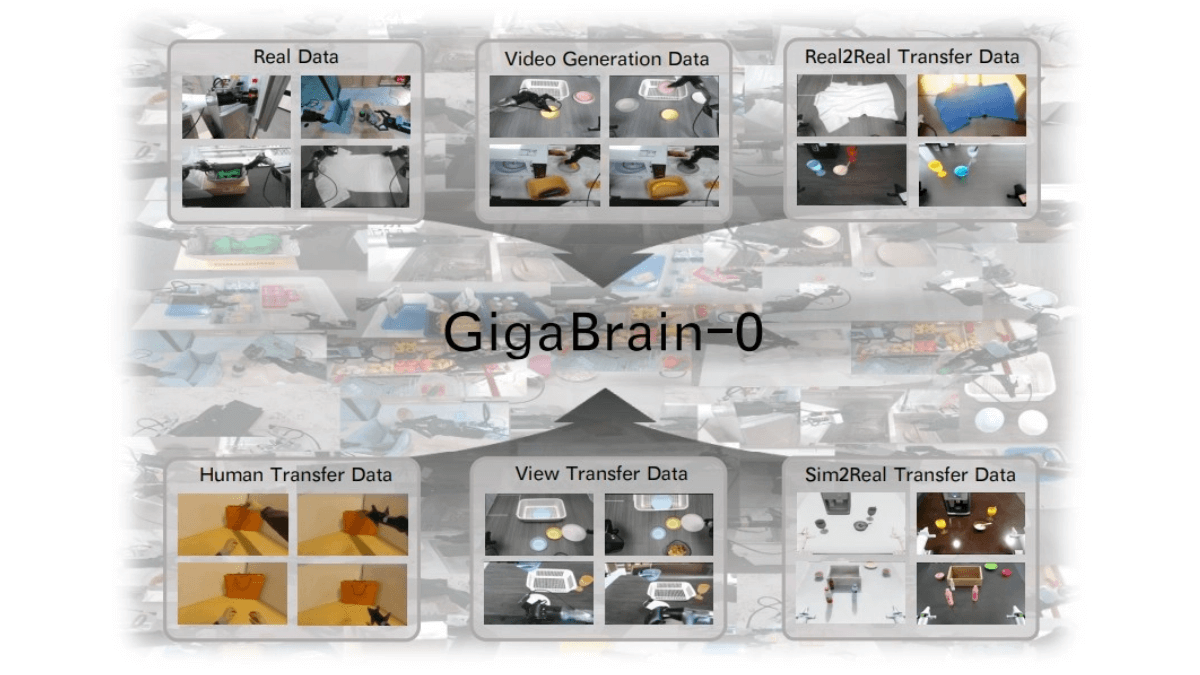
기가브레인-0은 세계 모델 생성 데이터를 사용하여 실제 머신 일반화를 달성하는 중국 최초의 엔드투엔드 비전-언어-액션(VLA) 구현 기본 모델로, 기가비전과 후베이 휴머노이드 로봇 혁신 센터가 오픈 소스로 공동 출시했습니다. 하이브리드 트랜스포머 아키텍처를 채택하여 ...
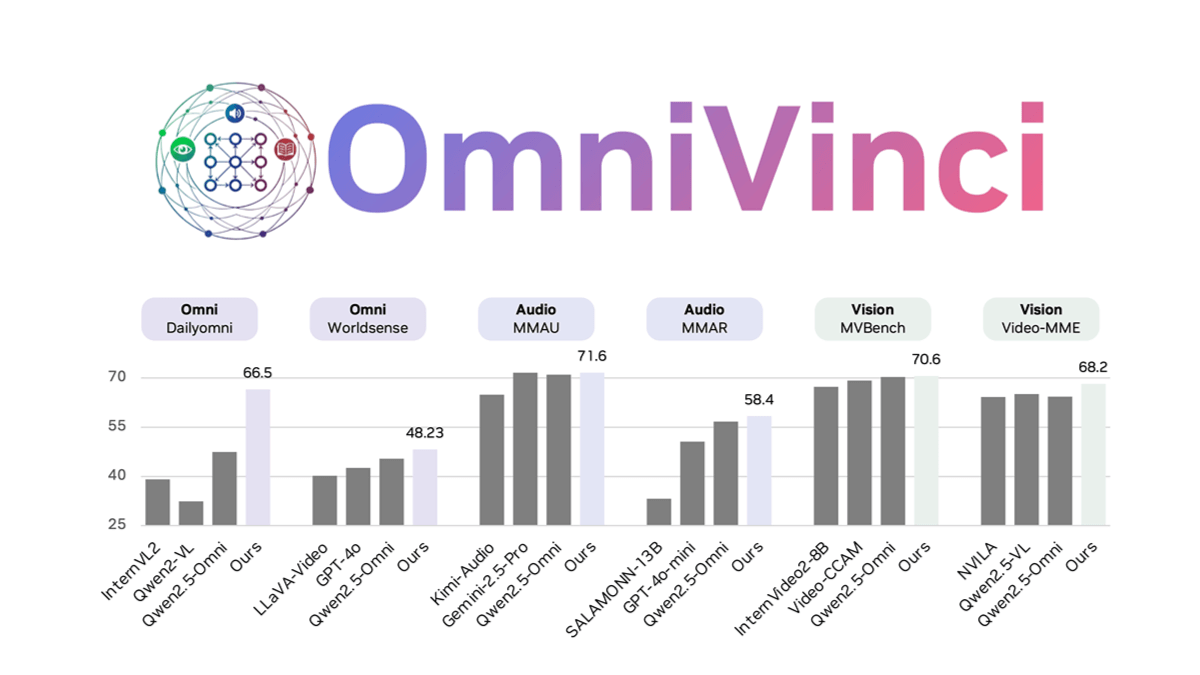
옴니빈치는 아키텍처 혁신과 데이터 최적화를 통해 멀티모달 모델의 모달 파편화 문제를 해결하는 NVIDIA에서 개발한 오픈 소스, 완전 모달, 대규모 언어 모델입니다. 시각 및 오디오 임베딩의 정렬은 일시적으로 임베딩된 그룹 캡처를 활용하는 OmniAlignNet을 통해 향상됩니다.
InfinityStar는 고해상도 이미지 및 동영상 생성을 위해 설계된 ByteDance에서 오픈소스화한 통합 시공간 자동 회귀 프레임워크입니다. 개별 자동 회귀 접근 방식을 사용하여 단일 모델에서 텍스트 대 이미지, 텍스트 대 비디오 및 이미지 대 비디오 작업을 동시에 처리할 수 있습니다. 이 프레임워크는 VBench에서 벤치마킹되었습니다 ...
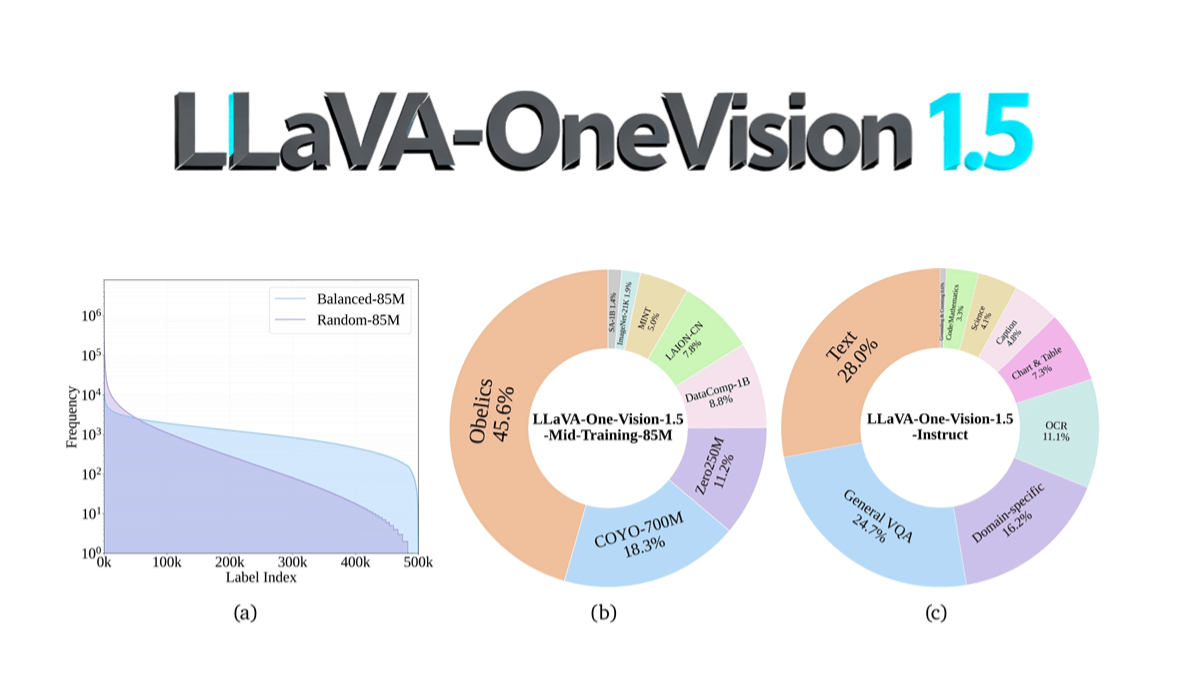
LLaVA-OneVision-1.5는 128개의 A800...에서 8B 파라미터 스케일을 사용하는 EvolvingLMMS-Lab 팀의 오픈 소스 멀티모달 모델로, 컴팩트한 3단계 훈련 프로세스(언어-이미지 정렬, 개념 평형화 및 지식 주입, 명령어 미세 조정)를 통해 학습합니다.
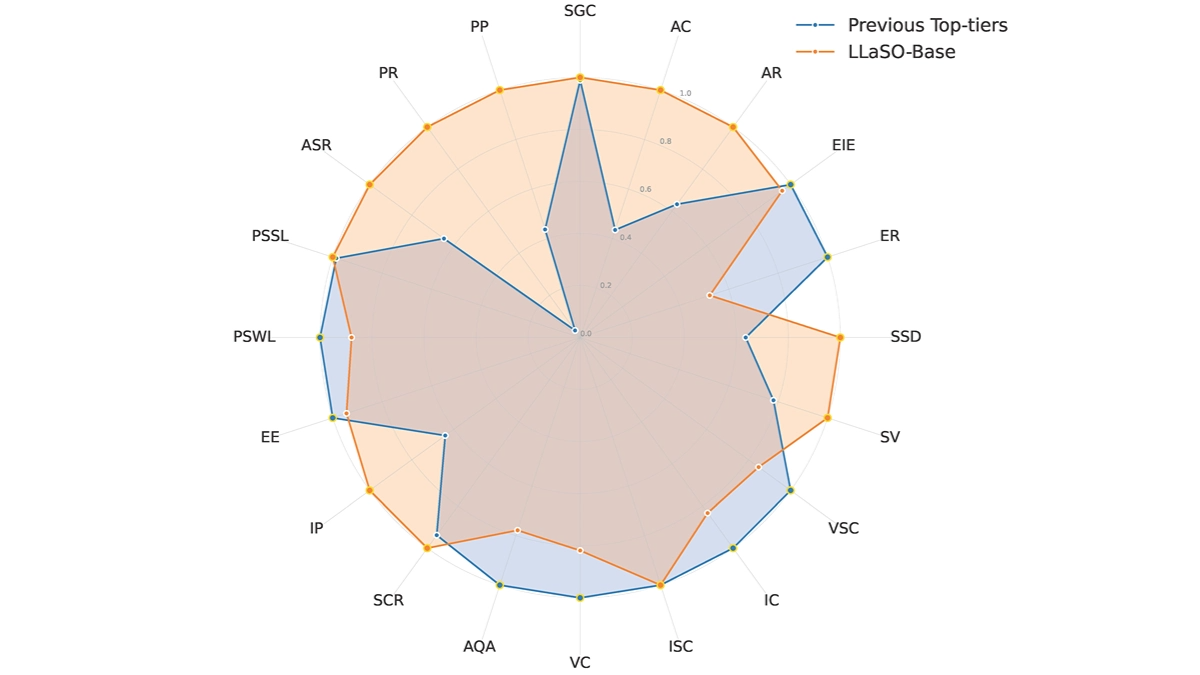
LLaSO는 베이징 뎁스 로직 인텔리전스 테크놀로지가 출시한 오픈 소스 음성 모델로, 음성 및 텍스트 데이터를 통합하고 정렬 데이터 세트, 명령 미세 조정 데이터 세트 및 평가 벤치마크를 제공하여 대규모 음성 언어 모델링 분야의 데이터 분산과 작업 범위 부족 문제를 해결합니다.
로보코인은 베이징 즈위안 인공지능 연구소가 여러 기업 및 대학과 함께 오픈소스화한 세계 최초의 대규모 양팔 로봇 실기계 데이터셋으로, 15종의 로봇 플랫폼, 18만 개의 실제 동작 궤적, 421종의 작업 시나리오가 포함되어 있습니다. 가장 큰 특징은 작업을 분해하는 계층적 주석 시스템을 채택했다는 점입니다.
Frappe 빌더는 Frappe에서 개발한 오픈 소스 로우코드 웹사이트 빌더로, 핵심 기능은 드래그 앤 드롭 구성 요소를 지원하는 Figma와 유사한 시각적 편집기를 제공하여 웹사이트를 빠르게 구축할 수 있도록 하는 것입니다. Frappe 생태계의 일부(Frappeverse)...
Vidi2는 비디오 콘텐츠 이해, 분석 및 생성에 중점을 둔 2세대 멀티모달 비디오 이해 및 생성 빅모델로, ByteDance에서 오픈소스화했습니다. 텍스트, 비디오 및 오디오 모달리티의 공동 입력을 지원하며, 사진 콘텐츠, 사운드 정보 및 자연어 명령을 동시에 이해하여 모달 간 상호 작용 및 푸시 기능을 구현할 수 있습니다.
SAM 3D는 Meta의 SAM 시리즈를 기반으로 하는 3D 재구성 모델로, SAM 3D 오브젝트와 SAM 3D 바디의 두 가지로 구성되어 있습니다. SAM 3D 오브젝트는 단일 사진에서 인터랙티브 3D 오브젝트 모델을 생성할 수 있으며, 다음과 같은 기능을 지원합니다.
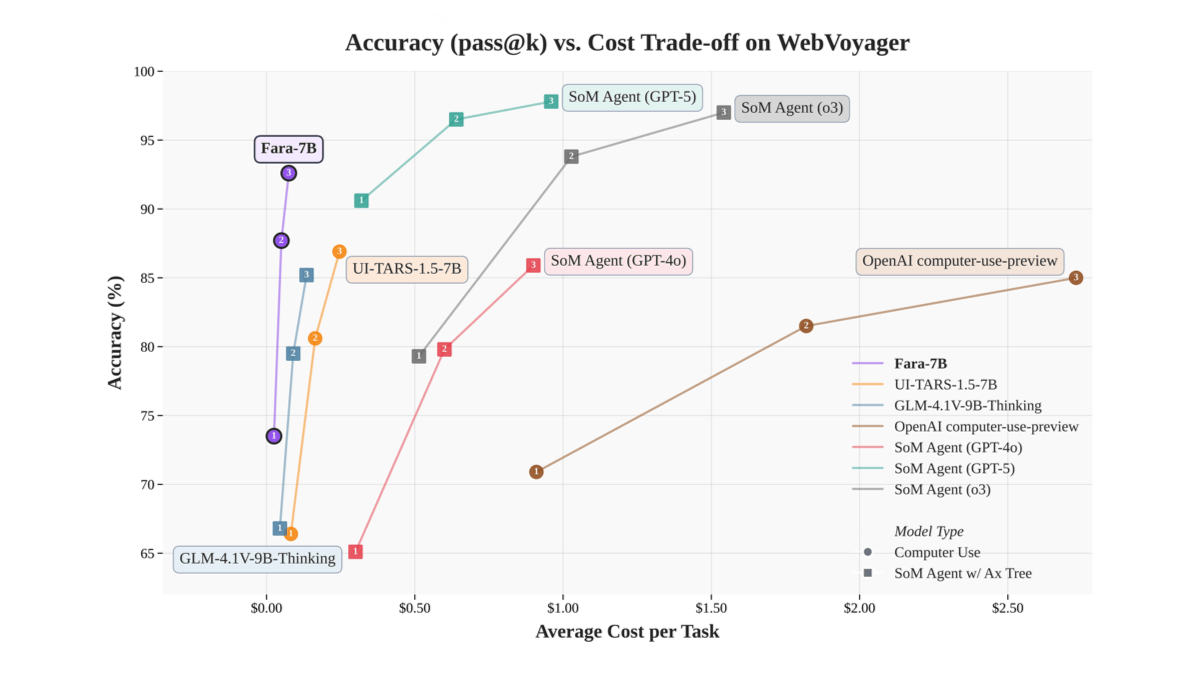
Fara-7B는 Qwen 2.5-VL-7B 아키텍처를 기반으로 하는 70억 개 매개변수 규모의 컴퓨터 운영 에이전트(CUA) 모델의 Microsoft 오픈 소스 릴리스입니다. 웹 페이지의 스크린샷을 시각적으로 구문 분석하고 화면에서 클릭, 입력 등을 수행함으로써 추가적인 접근성 트리나 여러 개의 대형 모델에 의존할 필요가 없습니다....
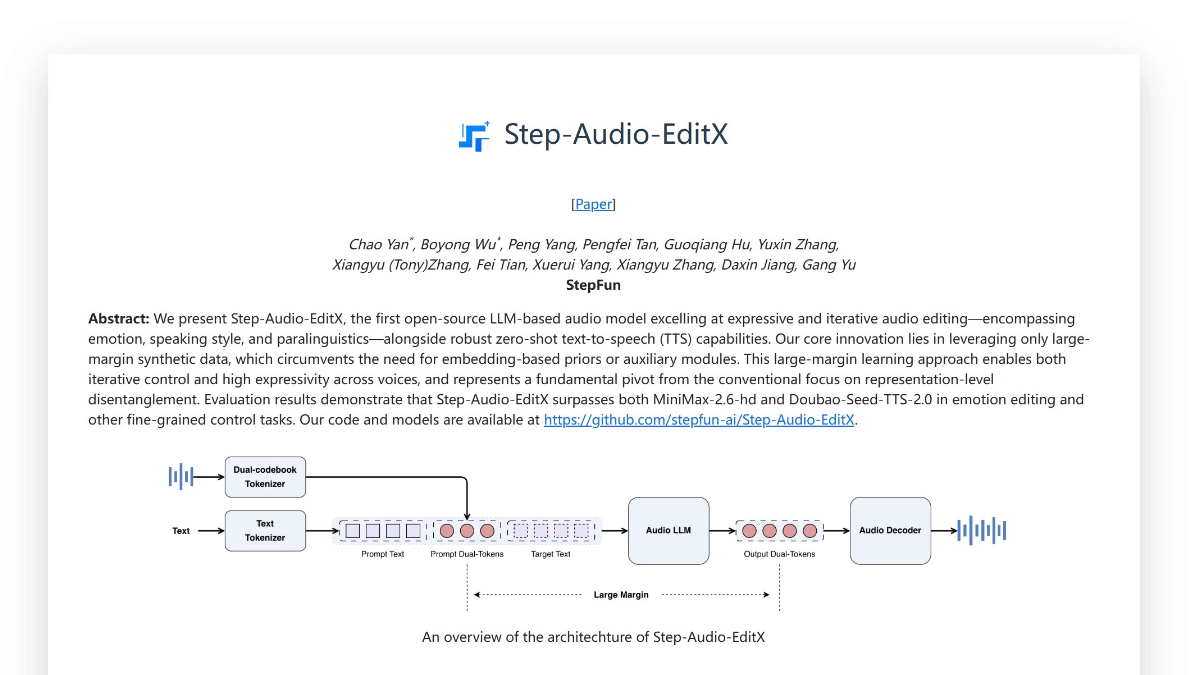
Step-Audio-EditX는 스텝스타 팀이 개발한 오픈 소스 오디오 편집 매크로 모델로, 인공 지능 기술을 통한 오디오 콘텐츠의 세밀한 조작에 중점을 두고 있습니다. 이 모델은 오디오 분위기, 말하기 스타일(예: 투정, 노인 억양 등) 및 반언어적 요소(예: 웃음, 한숨...)를 동적으로 조정할 수 있습니다.
LazyCraft는 오픈 소스 프레임워크 LazyLLM을 기반으로 상탕이 구축한 오픈 소스 AI 에이전트 애플리케이션 개발 및 관리 플랫폼으로, 기업과 개발자를 위한 원스톱 AI 애플리케이션 개발 솔루션을 제공합니다. 개발자가 낮은 임계값과 저렴한 비용으로 대규모 모델 애플리케이션을 신속하게 빌드하고 출시할 수 있도록 지원합니다.
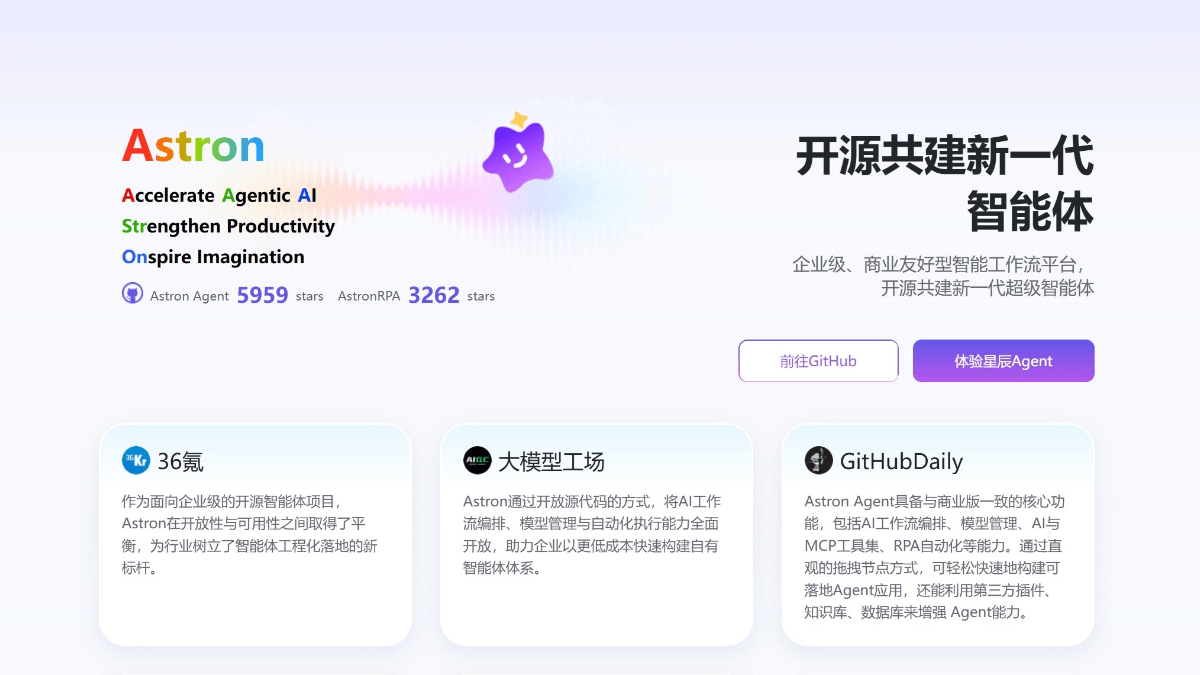
Astron Agent는 KDDI의 오픈 소스 엔터프라이즈급 지능형 워크플로 개발 플랫폼으로, 기업이 착륙 가능한 AI 에이전트 애플리케이션을 신속하게 구축할 수 있도록 지원하는 데 중점을 두고 있습니다. Java + Spring Boot 기술 스택 사용, 경량 프라이빗 배포 지원(최소 2코어 4G 구성), 내장 ...
NewBie-image-Exp0.1은 NewBieAI-Lab 팀이 오픈소스화한 최초의 실험적인 애니메이션 텍스트 기반 그래픽 모델로, 보조 스타일에 최적화된 35억 개의 파라미터가 포함된 Next-DiT 아키텍처를 사용합니다. 이 모델은 듀얼 텍스트 인코더(GEMMA3-4B)를 통해 2차 스타일에 최적화되어 있습니다.
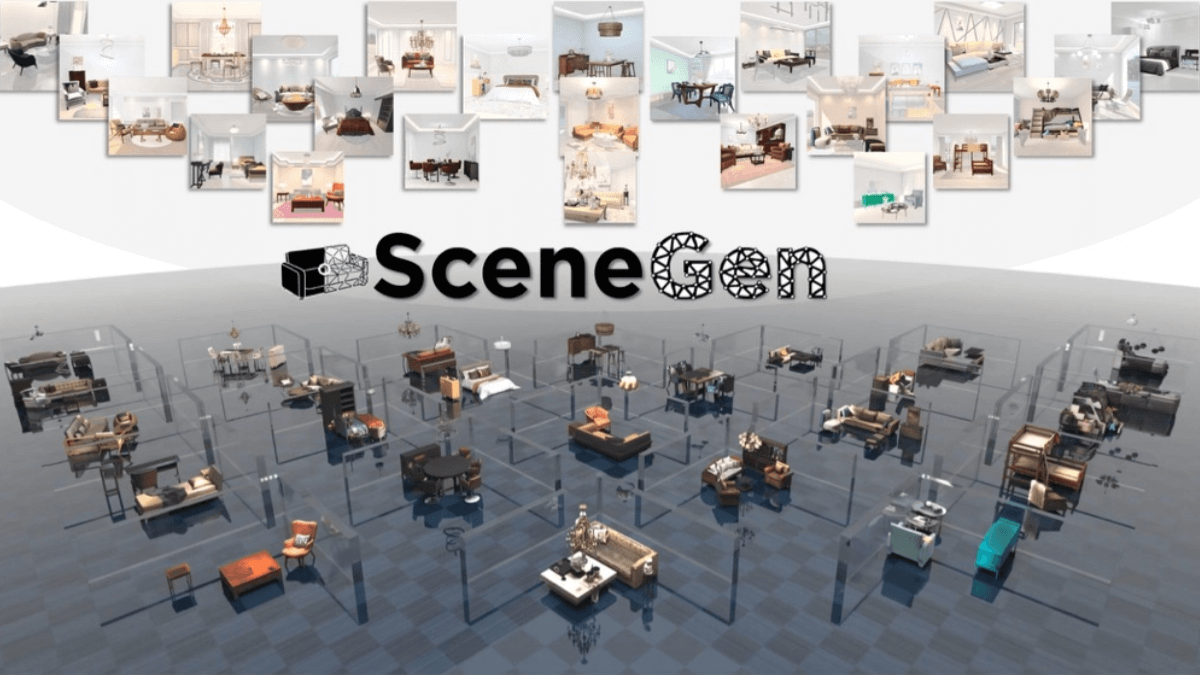
센스노바-SI는 샹테크에서 출시한 오픈 소스 공간 지능 그랜드 모델로, 공간 이해와 추론에 있어 AI의 능력을 향상시키는 데 중점을 두고 있습니다. 이 모델은 공간 측정, 재구성, 관계 판단, 원근 변환, 변형 분석, 공간 추론 등 6가지 핵심 차원에서 탁월한 성능을 발휘하며 다른 모델보다 월등히 뛰어납니다.
Bee는 데이터 품질을 개선하여 오픈 소스 모델과 폐쇄 소스 모델 간의 성능 격차를 좁히기 위해 텐센트 혼합 요소 팀과 칭화대학교가 공동으로 출시한 풀스택 오픈 소스 멀티모달 빅 모델 솔루션입니다. 이 프로젝트에는 세 가지 핵심 성과가 포함되어 있습니다. 1,500만 개 규모의 고품질 2계층 CoT 데이터 세트 Honey-Data...
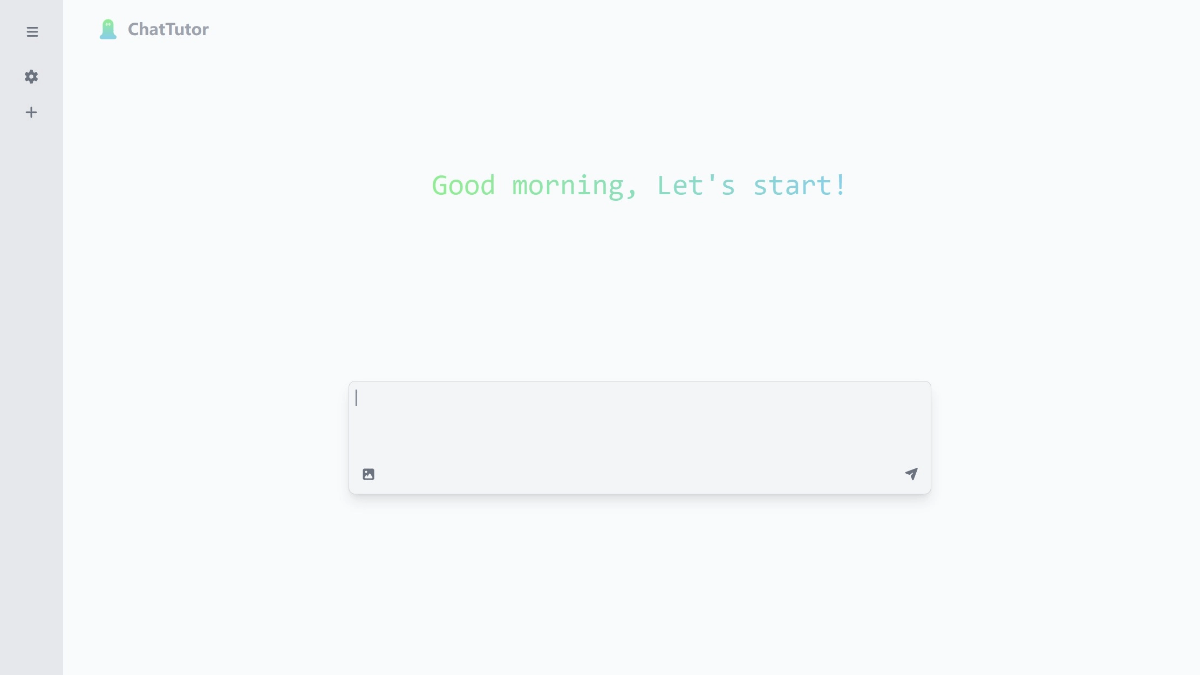
ChatTutor는 오픈 소스 AI 교구로, STEM 과목의 시각적 대화형 학습에 중점을 두고 있습니다. 대화 Q&A 및 동적 그리기 기능을 달성하는 다중 지능형 바디 아키텍처를 통해 화이트보드에 수학 그래픽, 물리 회로 또는 마인드맵을 실시간으로 그릴 수 있어 사용자가 추상적인 일반 개념을 직관적으로 이해할 수 있도록 도와줍니다.
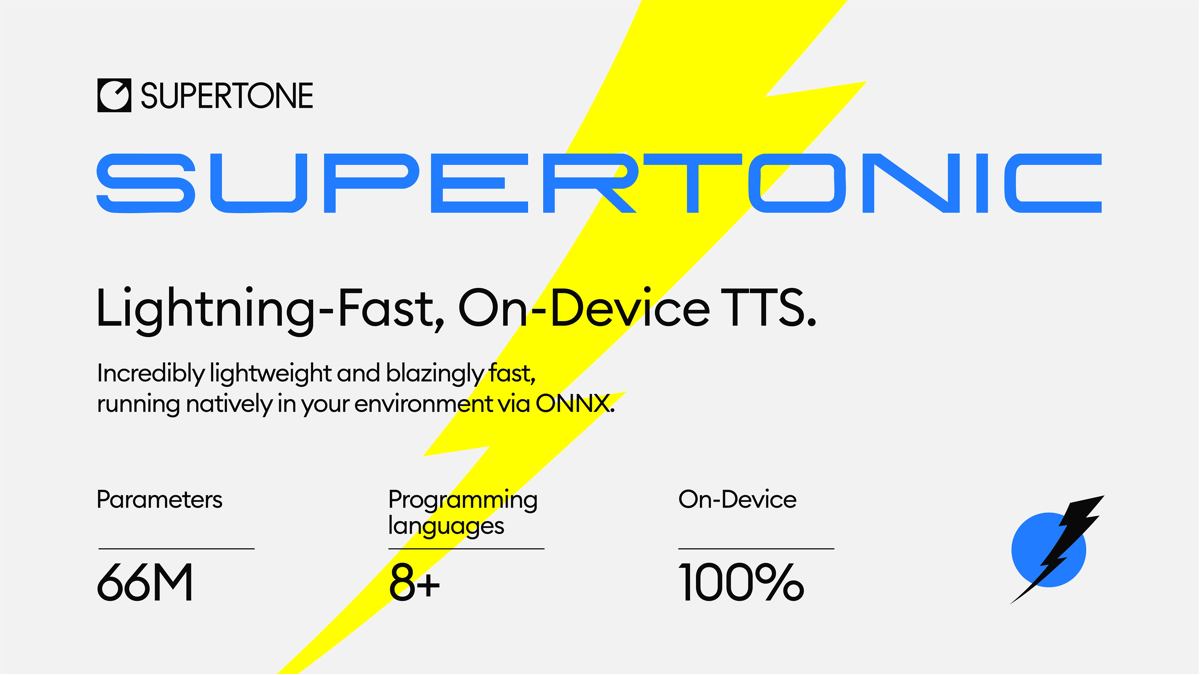
슈퍼토닉은 로컬 장치에서 빠른 음성 생성에 초점을 맞춘 오픈 소스 고성능 텍스트 음성 변환(TTS) 시스템입니다. ONNX 런타임 기술을 사용하여 휴대폰, 컴퓨터, 심지어 라즈베리 파이와 같은 장치에서 실행할 수 있고 23개 언어와 음성 클론을 지원하며 네트워크가 필요하지 않습니다....






 한국어
 简体中文
 English
 日本語
 Русский
 Español