
Unlimited OCR 2是什么
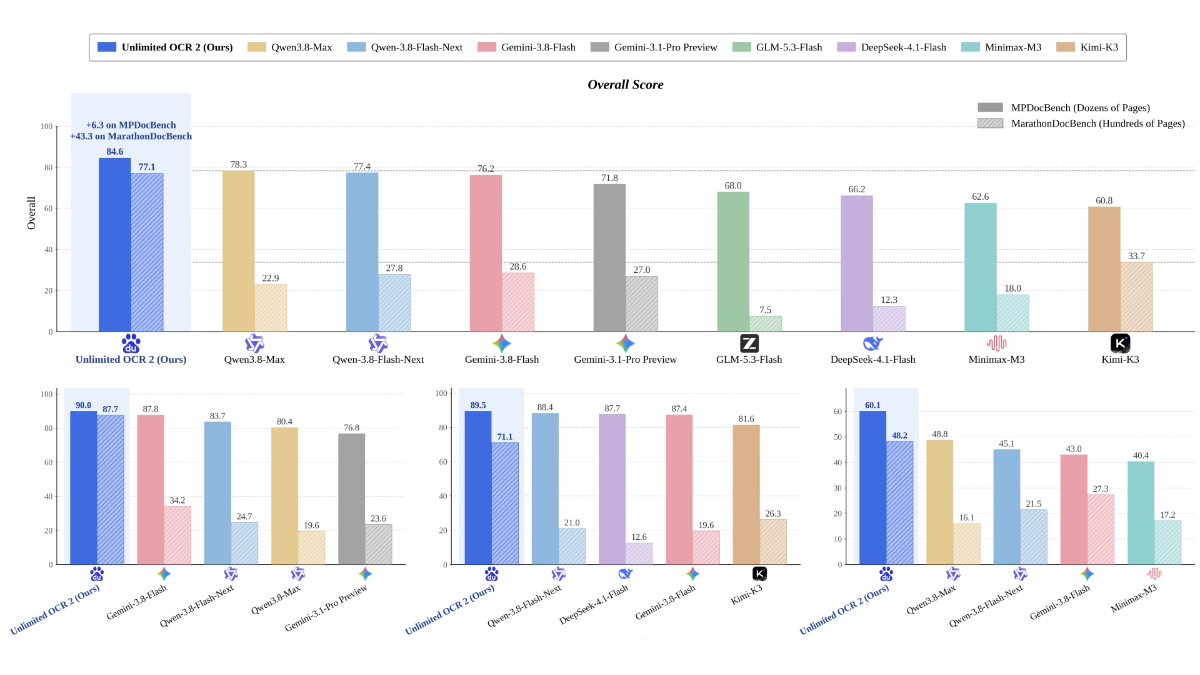
Unlimited OCR 2 是百度文心开源的端到端文档解析模型,用稀疏参考滑动窗口注意力替代全局全量计算,搭配无限解码机制,让单张普通显卡能一次解析数千页长文档,且随页数增长不显存失控。Unlimited OCR 2 仅3B参数(激活5亿),在MPDocBench、MarathonDocBench等长文档基准上达到领先水平,支持跨页内容回看与关联,适合整本图书、长篇研报、法律卷宗等场景的批量数字化与RAG知识库构建。
Unlimited OCR 2的功能特色
- 真正的"无限"文档长度:一次调用即可吞吐数千页书籍,实测能一口气读完《哈利·波特》全七部(3623 页),全程不断片、不丢上下文。
- 页数越多,优势越明显:Unlimited OCR 2 通过稀疏注意力让计算量不再随页数线性膨胀,"超长文档"成为它的主场。
- 自带"记忆力"的跨页理解:能主动回看前面读过的页面,核对跨页标题、跨页表格、前后呼应的段落与引用,从根本上避免"逐页识别再拼接"造成的上下文断裂。
- 轻量却高效:仅 3B 总参数、5 亿激活参数,KV 显存峰值压降至原来的约 4%;单张普通消费级显卡就能跑,无需堆卡。
- 开源可商用:代码与权重全量开放,GitHub 与 Hugging Face 均可获取,同时提供百度智能云与 AI 开放平台的在线服务入口,本地部署和云端调用都方便。
- 输出灵活、易于集成:可导出纯文本、Markdown 或 JSON 结构化结果,适配 RAG 知识库、批处理管线与业务系统的二次开发。
- 复杂版面也能啃:表格、公式、多栏版面、阅读顺序等复杂场景均有针对性优化,不是只能"认字"。
Unlimited OCR 2的核心优势
- 页数不再是天花板:把文档解析的容量极限从"几十页"直接拉到"数千页",整本书一次读完。
- 越长的文档,它越划算:传统方案里页数越多,算得越久、越容易出错;Unlimited OCR 2 靠稀疏注意力让成本不随页数线性增长,长文档更凸显它的性价比。
- 上下文不再"断片" :多页拼接式 OCR 最大的痛点是前后文割裂。模型原生具备跨页回看能力,能对照前文理解当前内容,让长篇文档的解析结果保持整体连贯。
- 硬件门槛低到离谱:KV 显存占用压到原来的 4% 左右,一张普通消费级显卡就能扛住超长文档。中小团队不必为跑长文档专门买昂贵的专业卡。
- 跑得又快又省:百页级场景下单步解码速度比全量注意力快 7 倍,并发吞吐提升至原来的 3.65 倍,同样的机器能服务更多请求,推理成本明显摊薄。
Unlimited OCR 2官网是什么
- GitHub仓库:https://github.com/baidu/Unlimited-OCR
- HuggingFace模型库:https://huggingface.co/spaces/baidu/Unlimited-OCR-2
Unlimited OCR 2的使用步骤
- 选入口:GitHub 或 Hugging Face 拉取开源代码和权重本地部署。
- 备好文档:把要解析的 PDF、扫描件或图片整理成完整清晰、方向正确的版本,页码别缺、别乱。
- 把文档喂给模型:在线入口直接上传文件;本地部署则先配好运行环境、加载模型权重,再通过命令行或脚本调用。
- 告诉它你要什么:按需配置输出格式、解析页数范围,以及是否需要开启表格识别、版面分析等功能。
- 跑起来,等结果:提交任务,模型会自动完成跨页理解、内容抽取和结构化输出。
- 抽查关键内容:重点核对容易出错的跨页标题、长表格、公式、页码、引用和段落衔接处,长文档建议分段抽检。
- 导出或接入业务:结果可导出为文件,也能通过 API 挂进自己的批处理流程、RAG 知识库或业务系统中。
Unlimited OCR 2的适用人群
- 文献/图书数字化从业者:高校图书馆、档案馆、古籍数字化团队需要把整本典籍、教材批量转成可检索文本,它的任意页数能力正是刚需。
- 金融与投研分析师:动辄几百页的招股书、年报、研报,以前要拆成几十次喂给模型;现在一次解析,还能跨页关联财务数据和风险提示。
- 法律与合规人员:处理法规汇编、合同卷宗、案件材料时,跨页条款关联、前后引用核对是高频痛点。
- RAG/知识库开发者:做企业知识库、智能问答的工程师,需要把超长 PDF 干净地解析成结构化文本入库。
- 科研人员与学生:读长篇论文、综述、学位论文,需要快速抽取观点、保留上下文做笔记和引用。
Unlimited OCR 2的常见问题
Q1:它一次到底能处理多少页?
A1:官方实测一次性解析过 3600+ 页(《哈利·波特》全系列)。理论上"任意页数",但万页级文档按约 1.5 秒/页的吞吐仍需数小时,建议大任务分段提交。
Q2:需要什么显卡才能跑?
A2:模型总参数 3B、激活仅 5 亿,KV 显存峰值约 1.77 GB,单张普通消费级显卡即可;批量并发任务建议显存更充裕的卡。
Q3:支持哪些输入和输出格式?
A3:输入以 PDF、扫描图片类文档为主;输出支持纯文本、Markdown、JSON 等,可直接对接 RAG 和批处理流程。
Q4:和 MinerU 有什么区别,选哪个?
A4:要"长"选它——任意页数、跨页理解是原生能力;要"广"选 MinerU——格式支持更全面、部署档位更灵活、RAG 生态更成熟。二者也可组合使用。
© 版权声明
文章版权归 AI分享圈 所有,未经允许请勿转载。
相关文章

暂无评论...
 简体中文
 English
 日本語
 한국어
 Русский
 Español