magic-html: extrae los datos del cuerpo de una URL HTML, salida texto plano/markdown
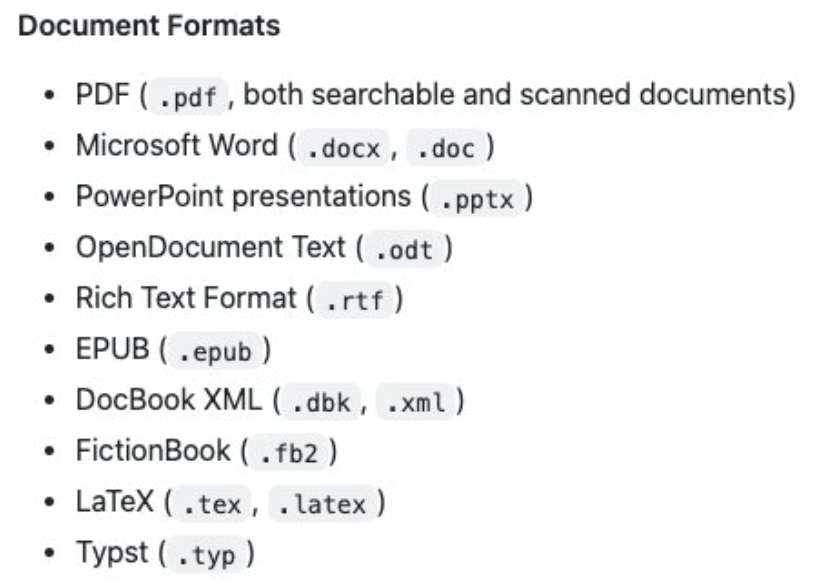
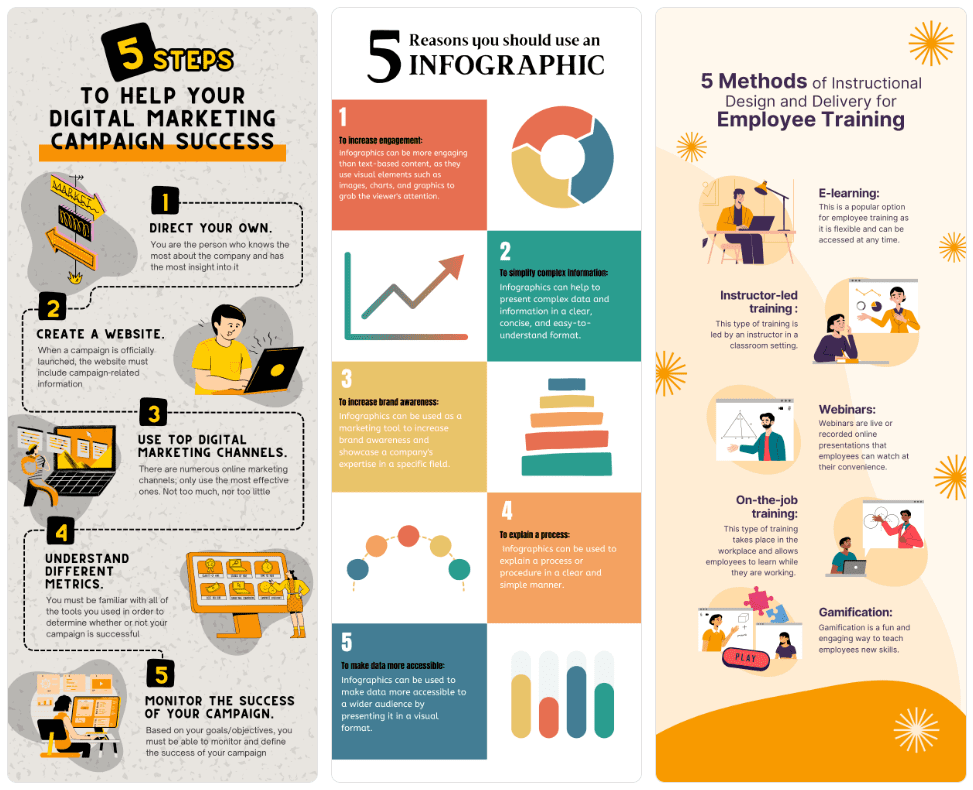
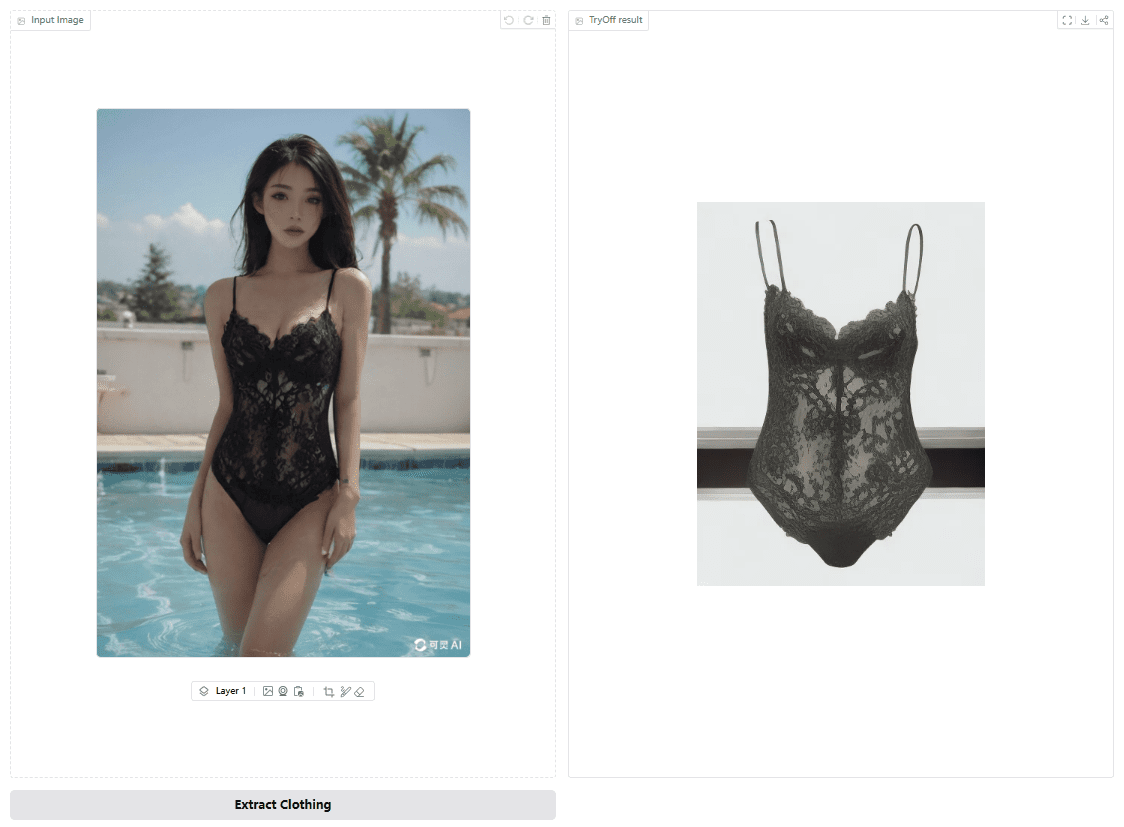
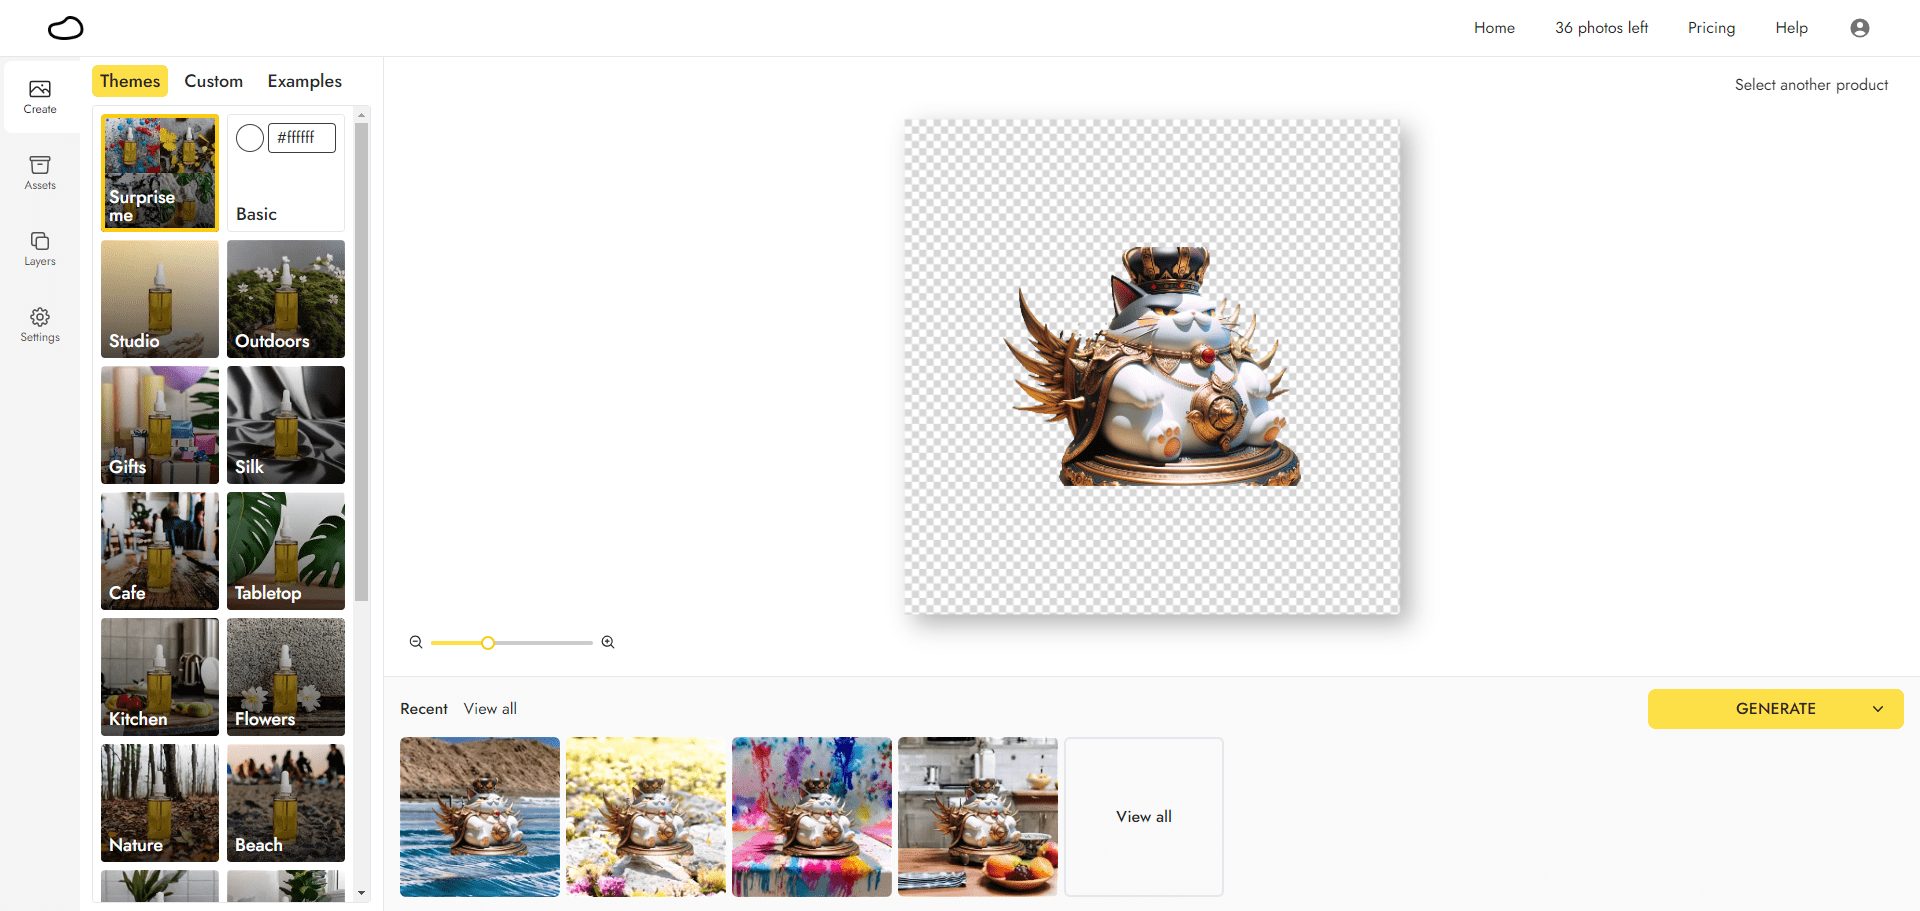
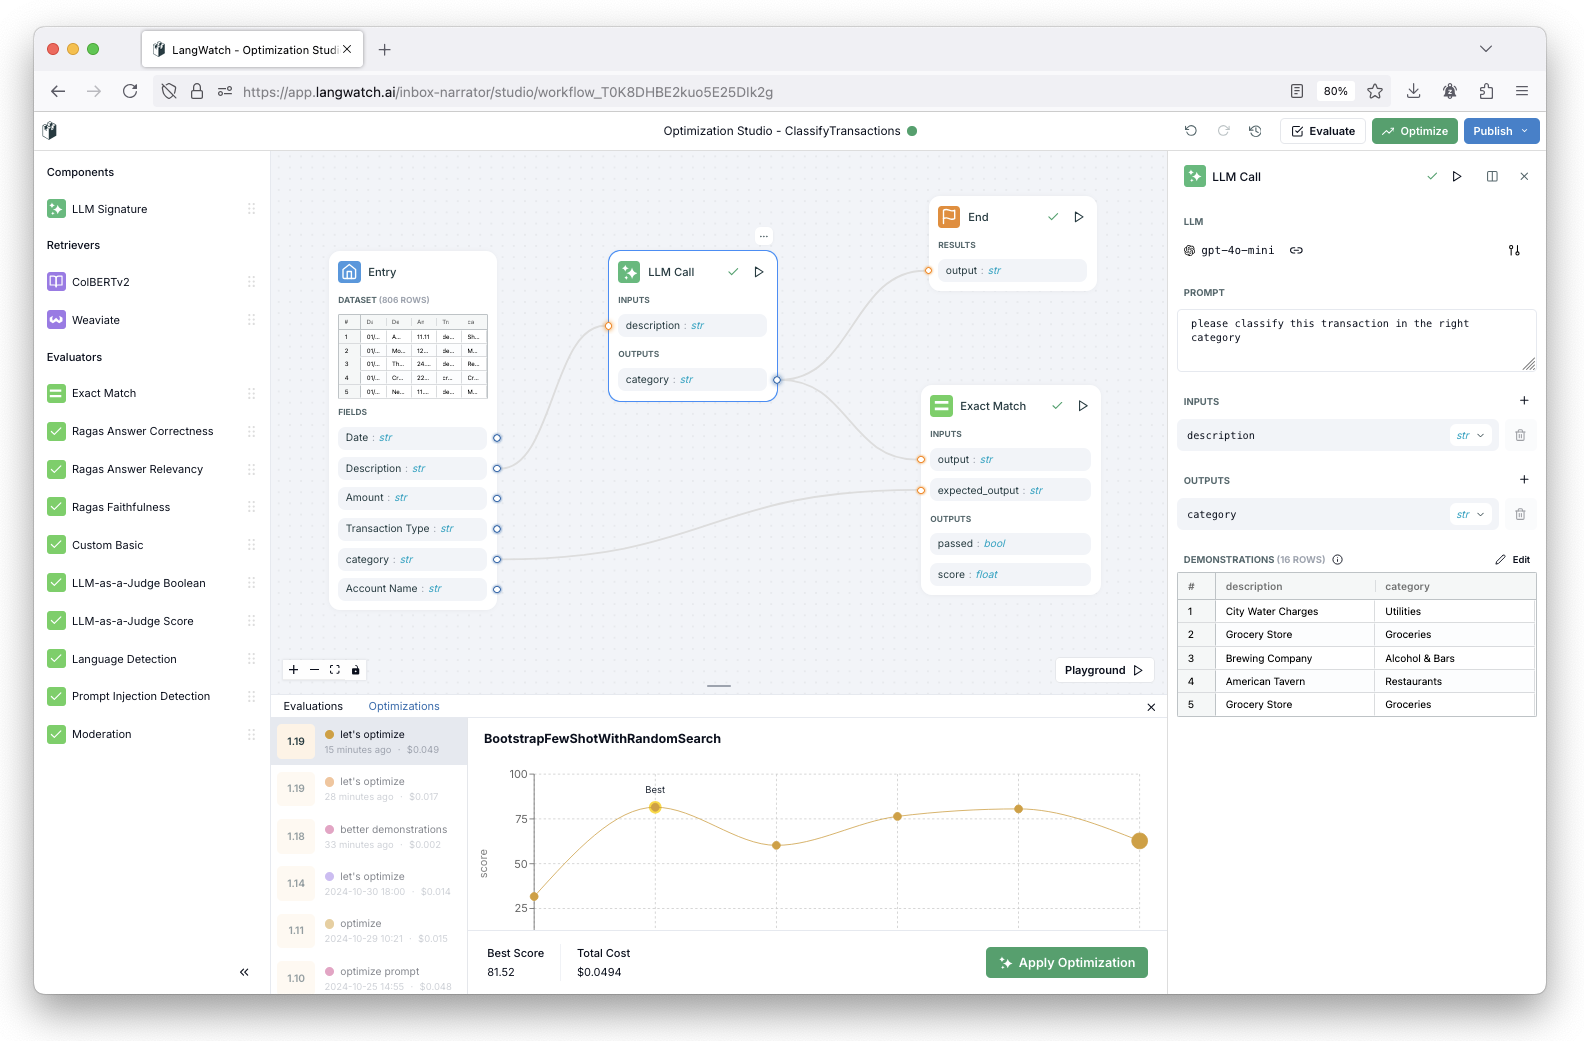
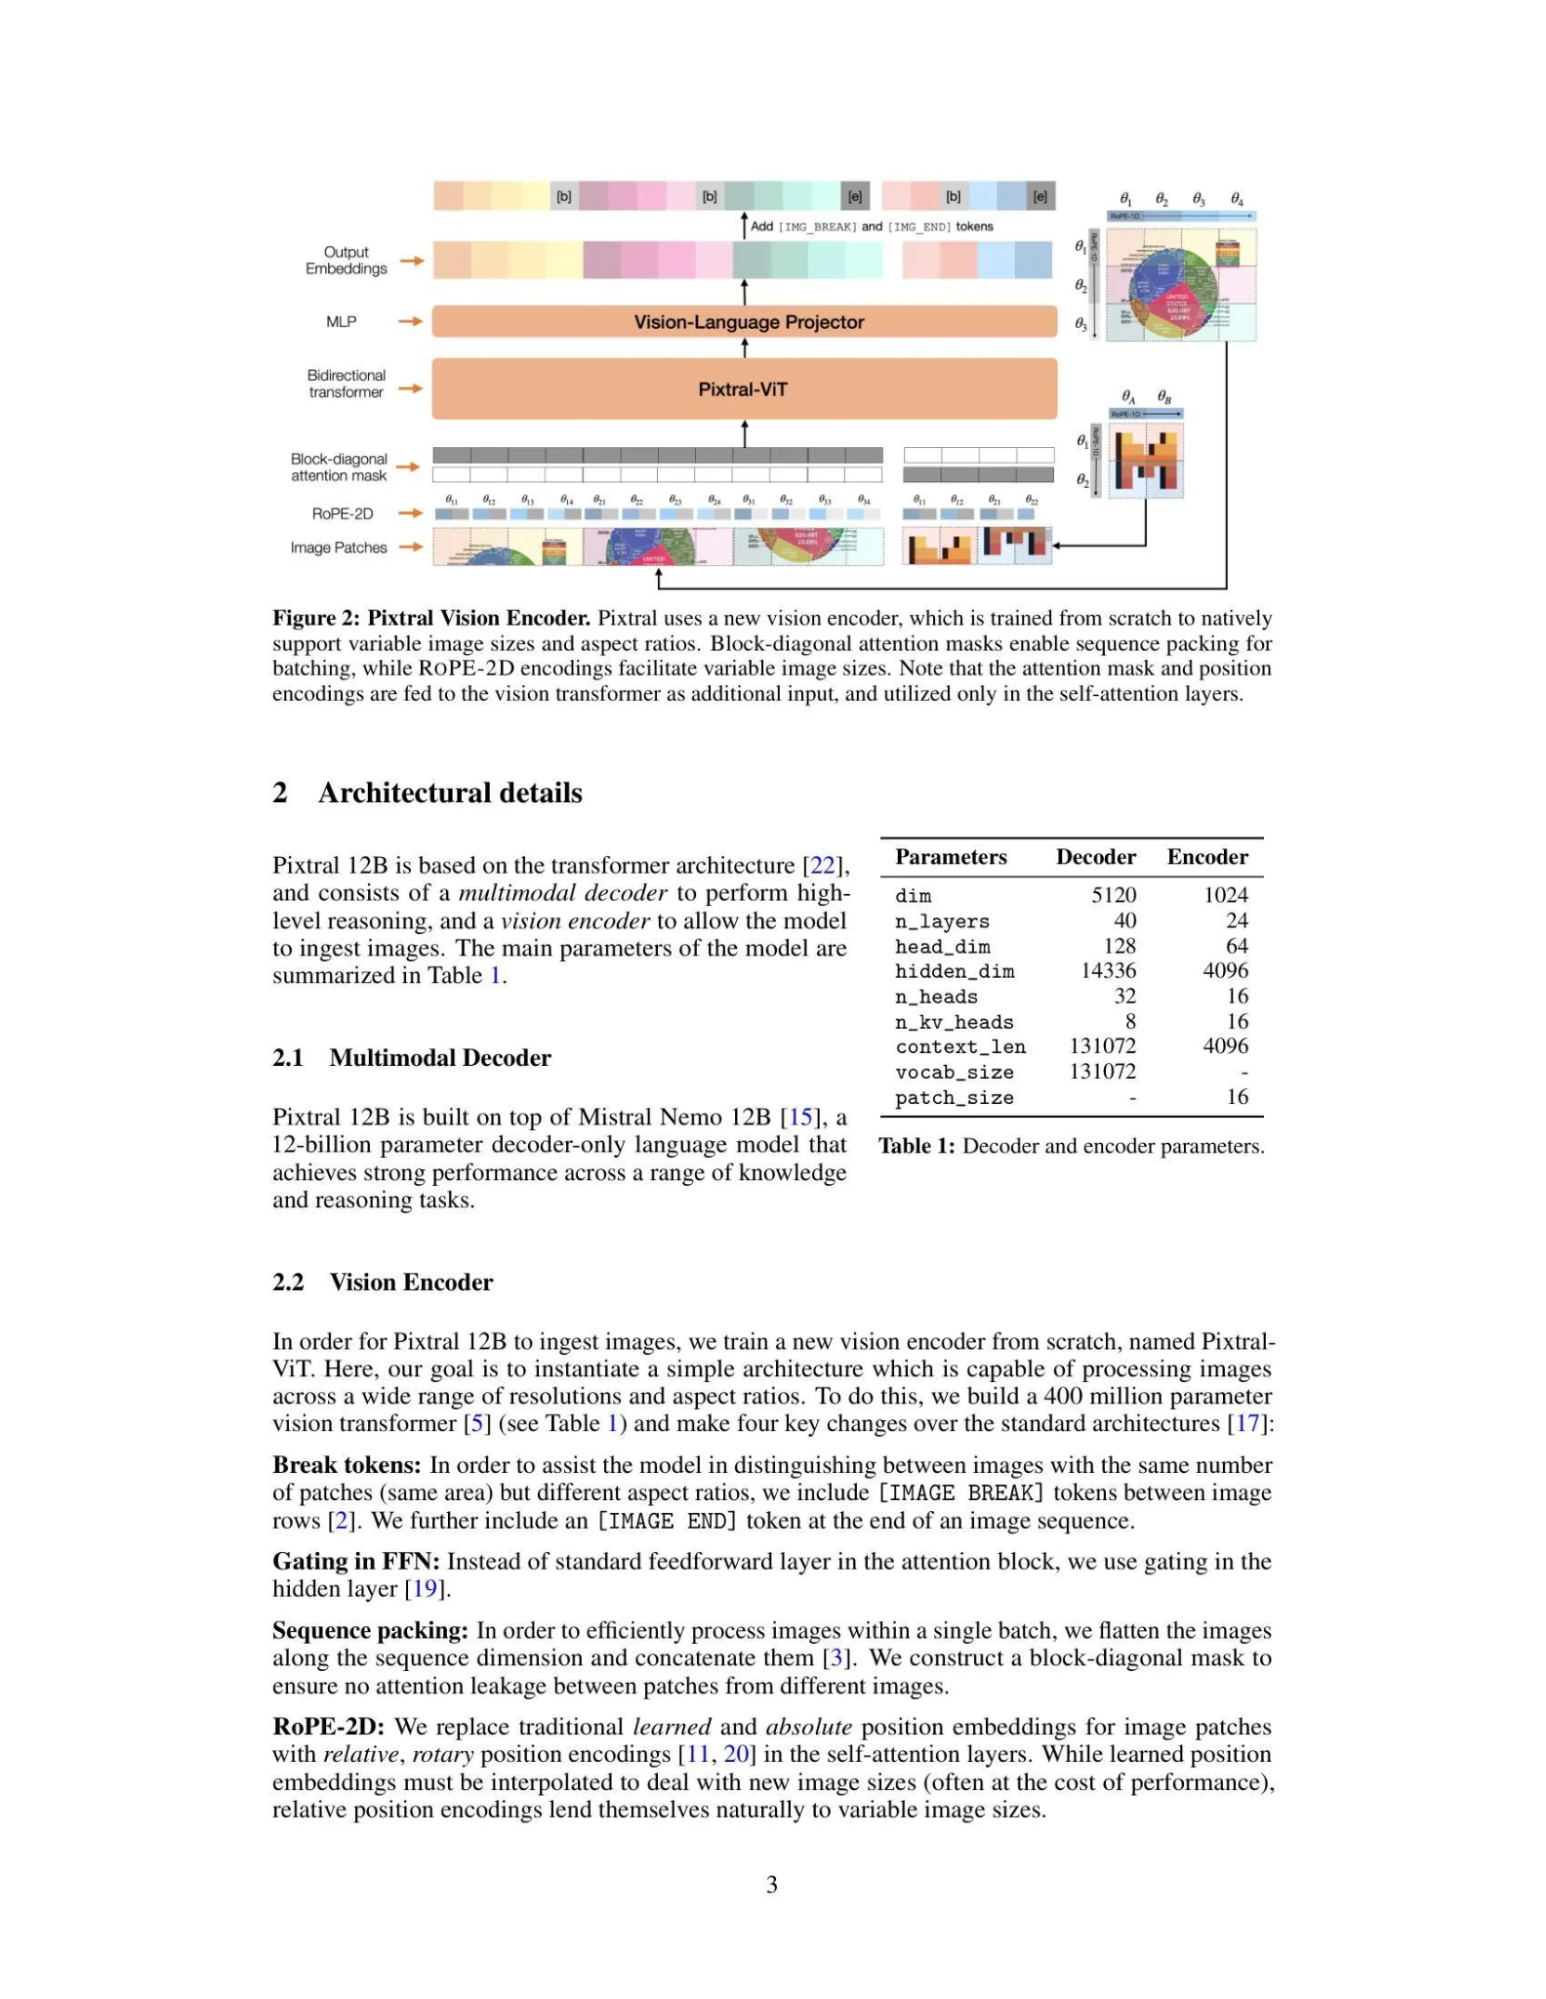
Introducción general magic-html es una biblioteca de Python diseñada para simplificar el proceso de extracción del contenido de la región del cuerpo a partir de HTML. Tanto si se trata de estructuras HTML complejas como de páginas web sencillas, esta biblioteca pretende proporcionar una interfaz cómoda y eficiente a los usuarios. Soporta la extracción multimodal...













 Español
 简体中文
 English
 日本語
 한국어
 Русский