Xiaomi-OCR-0 - 小米开源的轻量级文档理解模型

Xiaomi-OCR-0是什么
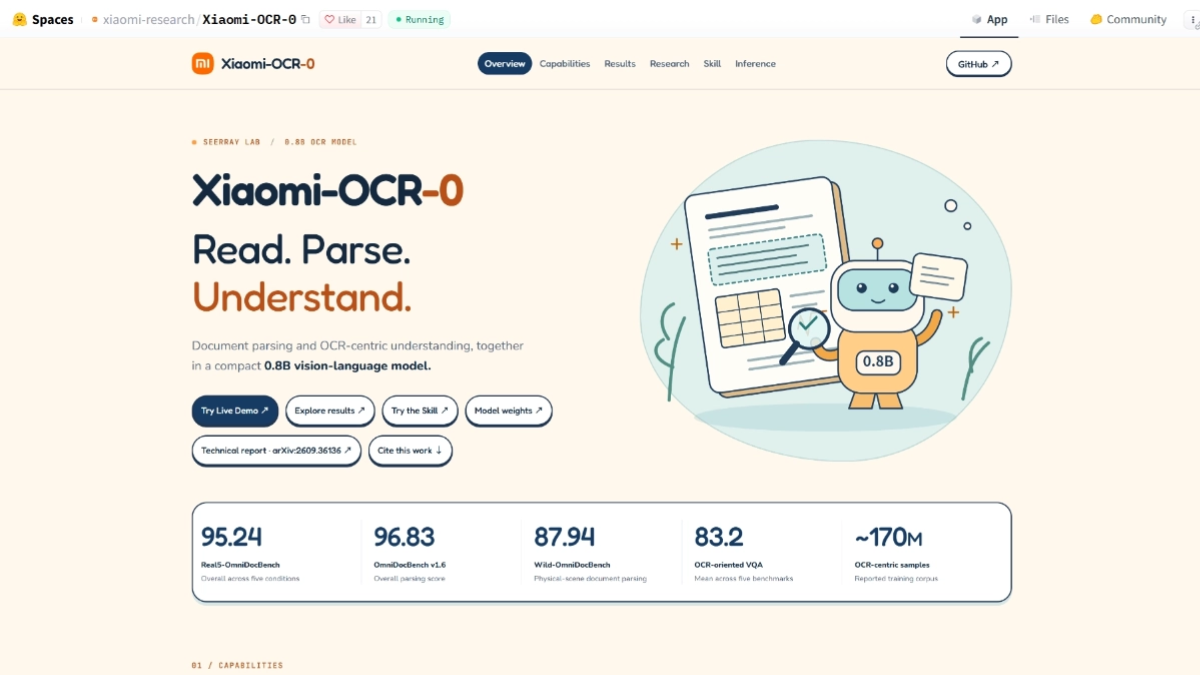
Xiaomi-OCR-0 是小米开源的 0.8B 轻量级多模态文档理解模型,基于 Qwen3.5-0.8B 训练,用约 1.7 亿条样本。Xiaomi-OCR-0 把文档解析、关键信息抽取和 OCR 视觉问答整合进单一模型,能按指令输出 Markdown/LaTeX 或 JSON 结构化结果。在真实拍摄鲁棒性榜单 Real5-OmniDocBench 上以 95.24 分居首,OmniDocBench v1.6 得 96.83 排第二,仅落后阿里 TeleOCR 约 0.04 分。
Xiaomi-OCR-0的功能特色
- разрешение документа:整页或按区域识别正文、表格与公式,输出带 HTML 表格和 LaTeX 公式的 Markdown。
- Извлечение ключевой информации:对发票、卡证等半结构化文档按指定字段输出 JSON,替代手工录入。
- OCR 视觉问答:不止转写文字,还能对文档和图表做跨元素检索、数值计算与语义推理。
- Agent 工具链:自带 MCP 服务和 Agent Skill,可接入智能体跑"识别—提取—执行"的自动化流程。
- Гибкость развертывания:支持 SGLang、vLLM 和实验性 Оллама 后端,配浏览器 Demo 即开即用,社区已有 GGUF 量化版。
- 区域识别模式:可外接 PP-DocLayoutV3 检测版面后并行切块识别,适合规整印刷文档。
- 中文特色能力:古籍与书法文字识别达 Chronicles-OCR 成熟书体 73 分。
- 端侧落地:技术已进入小米手机"超级小爱",覆盖取餐码、账单、卡证、日程、航班提醒等场景。
Xiaomi-OCR-0的核心优势
- 参数效率极致:0.8B 参数跑出 OmniDocBench v1.6 96.83 分,与其同场的 1.2B TeleOCR基本持平,参数量却少了三分之一。
- 真实拍摄场景最稳:在含扫描、弯曲、翻拍、光照不均、倾斜五种干扰的 Real5-OmniDocBench 上 95.24 分居首,领先第二名 PaddleOCR-VL-1.6 超过 2 分,是全场最大分差。
- 三任务一体化:解析、KIE、OCR 视觉问答共享一个模型和同一套指令接口,省掉多模型拼接的成本与误差累积。
- 数据引擎替代堆参数:1.7 亿样本由专家共识投票、渲染校验、失败驱动合成自动化产出,用数据质量弥补模型规模,0.8B 的成本能覆盖更多部署场景。
- 训练方法有论文级细节:Q-Mask 锚定、课程式 CPT、DAPO 式 Mix-RL 三段渐进,消融实验还揭示了"理解任务反哺解析"的时机效应,方法可复现、可借鉴。
- 中文场景稀缺能力:古籍与书法识别达 Chronicles-OCR 成熟书体 73 分,追平 Seed 2.0 Pro,在同类小模型中少见。
- Agent 原生配套:自带 MCP 服务与 Agent Skill,浏览器 Demo 即开即用,可直接嵌入"识别—提取—执行"的自动化链路。
Xiaomi-OCR-0官网是什么
- Веб-сайт проекта:https://huggingface.co/spaces/xiaomi-research/Xiaomi-OCR-0
- Репозиторий GitHub:https://github.com/xiaomi-research/Xiaomi-OCR-0
- Библиотека моделей HuggingFace:https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
- Технический документ arXiv:https://arxiv.org/pdf/2609.36136
Xiaomi-OCR-0的使用步骤
- Pull Code:克隆仓库
SeerRay-Lab/Xiaomi-OCR-0,按 requirements 装好 Python 3.10+ 环境。 - 获取权重:从 Hugging Face 或 ModelScope 下载 0.8B 模型文件,首次启动推理服务时会自动缓存。
- Запуск службы рассуждений:任选 SGLang 或 vLLM 把模型起在本地 8000 端口;想走 Ollama 的话可用社区 GGUF 包。
- 打开浏览器 Demo:另起终端运行
demo/server.py,访问 8787 端口即可在线体验整页/区域解析、KIE、VQA 和 PDF 解析。 - 需要区域模式时:额外安装 PaddlePaddle、PaddleX 和 PP-DocLayoutV3,用于先做版面检测再切块识别。
- 接智能体:按仓库示例配置 MCP 服务或 Agent Skill,实现"识别屏幕/文档—提取字段—执行下一步"的自动化流程。
- 自行构造请求时:统一用 image–instruction–response 格式写提示词,并标明解析、KIE 或 VQA 任务类型。
Xiaomi-OCR-0的适用人群
- 智能硬件/端侧开发者:想在手机、平板等资源受限设备上集成文档识别能力,不愿为 OCR 单独塞一个大模型。
- Agent 与自动化开发者:需要"识别屏幕或文档—提取字段—执行下一步"的链路,可直接复用其 MCP 服务和 Agent Skill。
- 后端/业务系统工程师:发票、卡证、账单等半结构化文档要结构化入库,KIE 的 JSON 输出能替代人工录入。
- 古籍与中文文献研究者:书法、历史文献识别是它相对同类小模型的差异化能力,73 分的成熟书体成绩可供参考。
- AI 模型研究者:三阶段渐进训练、专家共识数据引擎等方法细节完整写在技术报告里,适合做复现与借鉴。
Xiaomi-OCR-0的常见问题
Q1:模型多大,需要什么配置?
A1:识别模型 0.8B,配 SGLang 或 vLLM 单卡即可跑;区域模式还需加载 PP-DocLayoutV3 版面检测器。
Q2:0.8B 是完整系统吗?
A2:不是,解析类成绩均为两阶段系统——检测器切块 + 0.8B 识别,检测器不计入参数量。
Q3:没有 GPU 能用吗?
A3:可以走实验性的 Ollama 路线加载社区 GGUF 量化包,官方验证过 Apple Silicon 上的输出对齐,但量化版精度未获官方背书。
Q4:能识别手写和古籍吗?
A4:能,官方建议这类场景用整页解析而非区域模式,区域边界切错会丢上下文。
Q5:商用有限制吗?
A5:开源协议类型文章未提及,商用前需到 GitHub 仓库自行确认许可证条款。
© заявление об авторских правах
Авторское право на статью Круг обмена ИИ Пожалуйста, не воспроизводите без разрешения.
Похожие статьи

Нет комментариев...
 Русский
 简体中文
 English
 日本語
 한국어
 Español