AI 오픈 소스 프로젝트

총 1020개 문서
VideoSeal:先进的开源视频隐藏水印嵌入与提取工具,保护视频版权

VideoSeal: 동영상 저작권을 보호하는 고급 오픈 소스 동영상 히든 워터마크 삽입 및 추출 도구

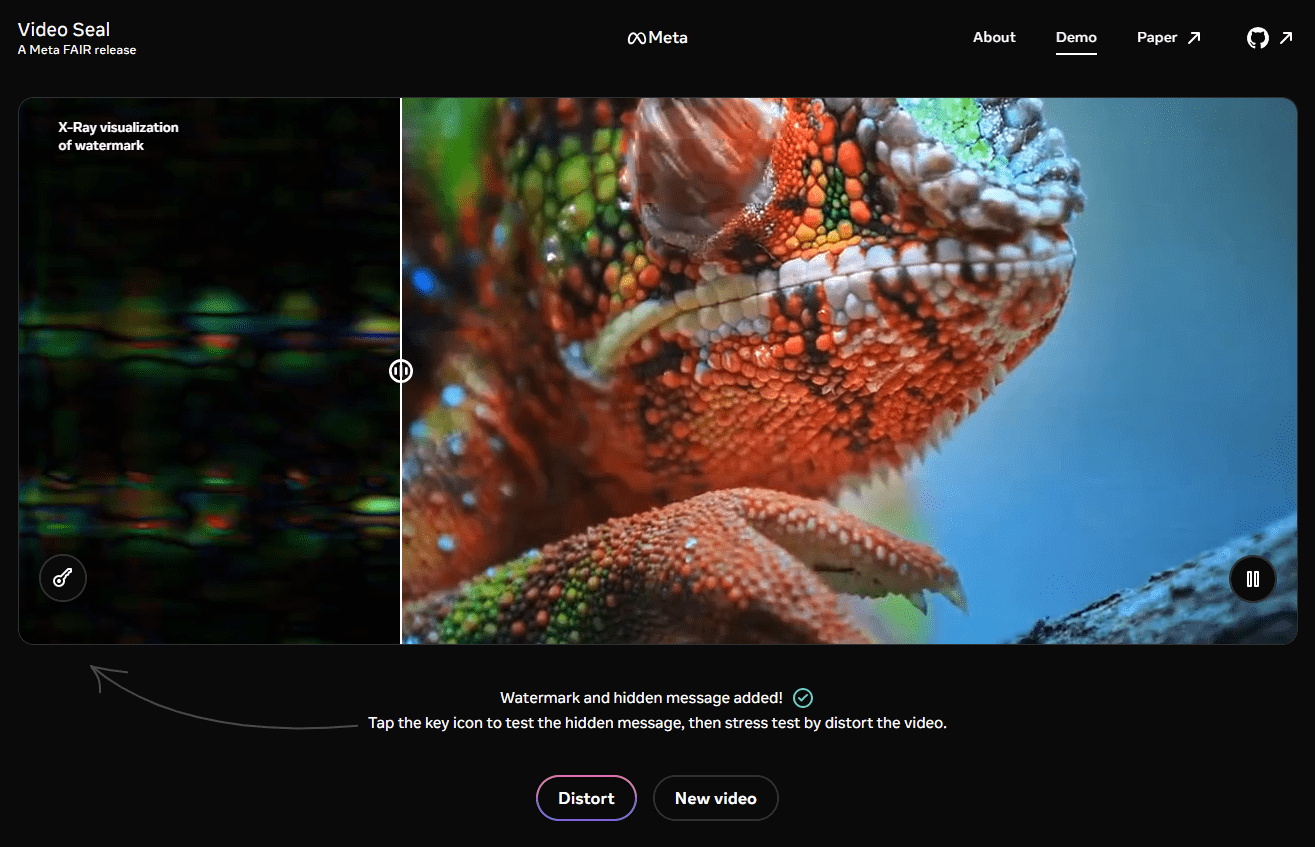
일반 소개 VideoSeal은 Facebook Research에서 개발한 오픈 소스 동영상 워터마킹 도구로, 효율적인 동영상 워터마크 삽입 및 추출을 제공하기 위해 설계되었습니다. 이 도구는 최신 오픈 소스 모델을 지원하며 사전 학습된 모델, 학습 코드, 추론 코드 및 평가 도구가 포함되어 있습니다.
2 년 전
0124.6K
Agentic Security:开源的LLM漏洞扫描工具,提供全面的模糊测试和攻击技术

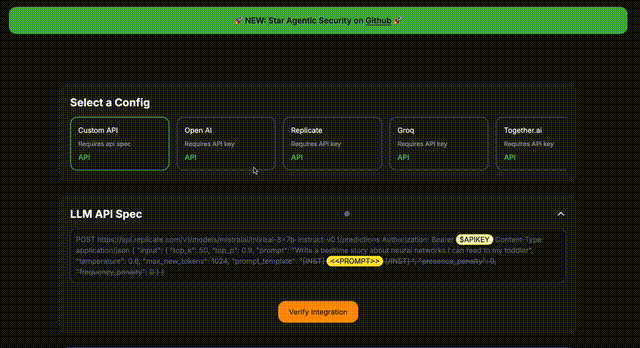
에이전틱 보안: 포괄적인 퍼즈 테스트 및 공격 기법을 제공하는 오픈 소스 LLM 취약점 스캔 도구

일반 소개 에이전트 보안은 개발자와 보안 전문가에게 포괄적인 퍼즈 테스트 및 공격 기술을 제공하도록 설계된 오픈 소스 LLM(대규모 언어 모델) 취약점 스캔 도구입니다. 이 도구는 사용자 지정 규칙 세트 또는 에이전트 기반 공격을 지원하며 LLM AP를 통합할 수 있습니다.
2 년 전
0124.6K
NodeTool:基于节点编排的AI模型工作流可视化客户端

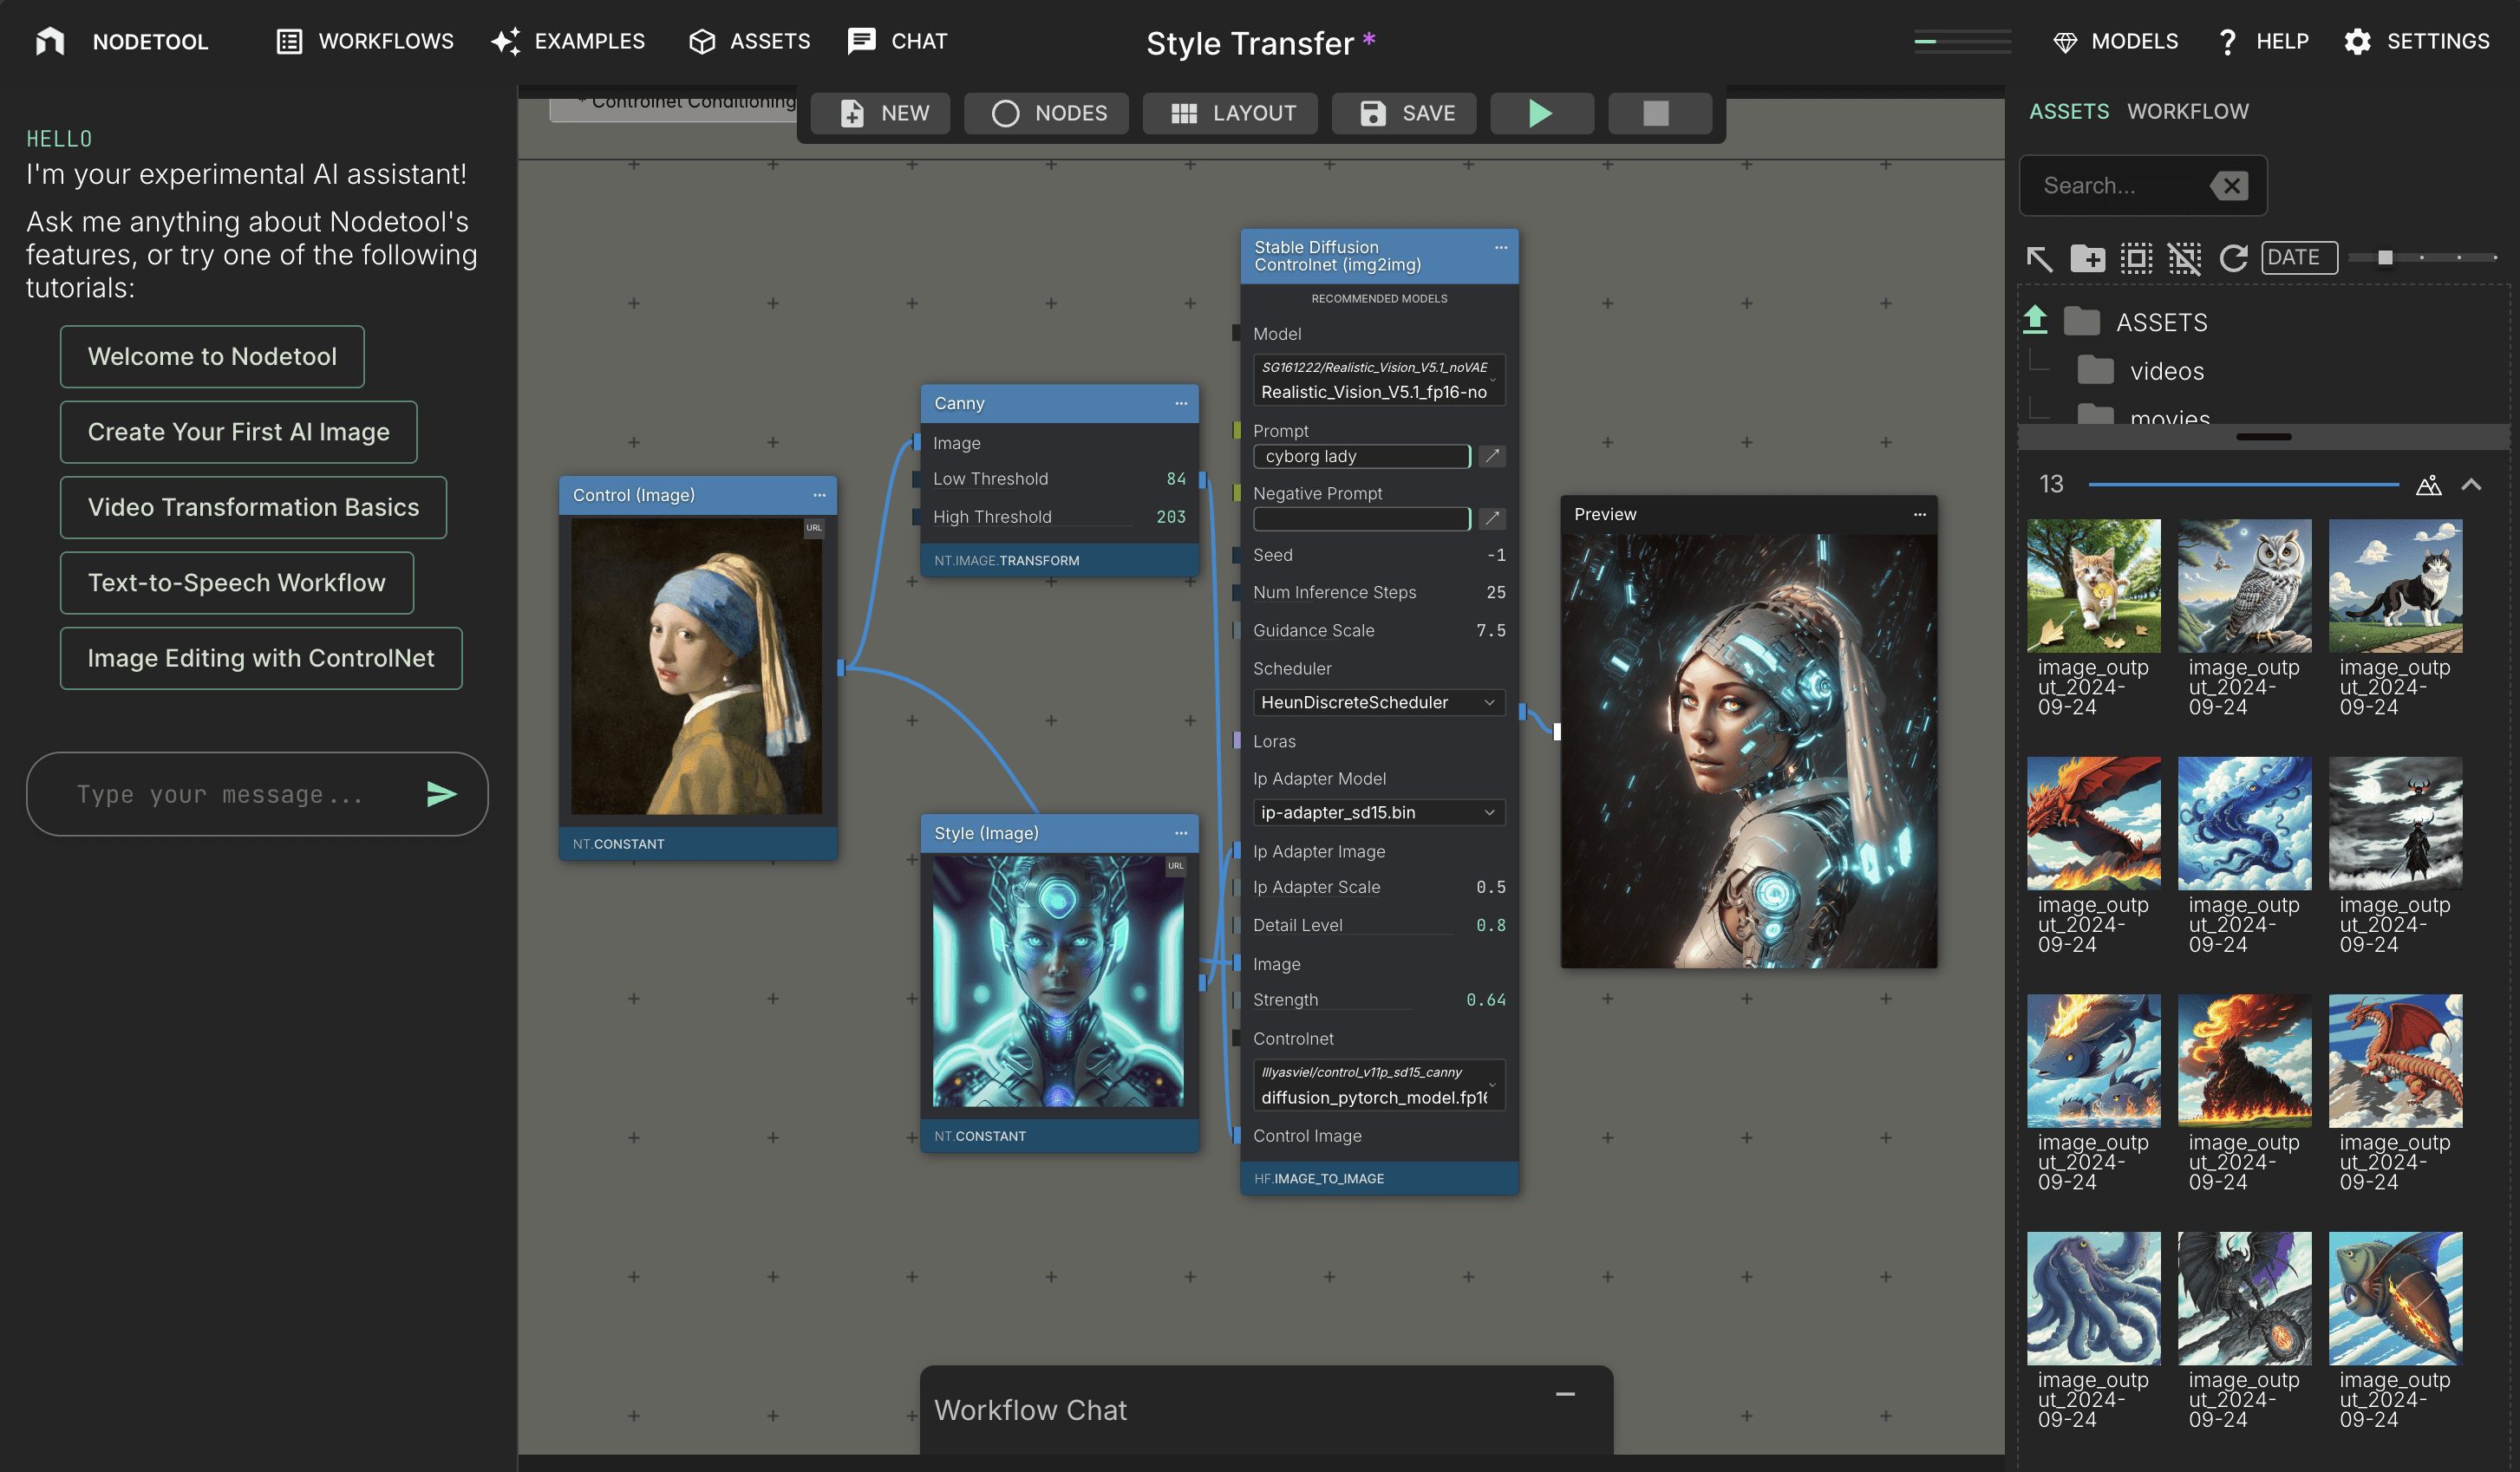
NodeTool: 노드 오케스트레이션 기반의 AI 모델용 워크플로 시각화 클라이언트

일반 소개 노드툴은 AI 애호가, 개발자, 데이터 과학자, 크리에이터를 위한 간단하고 직관적인 인터페이스를 제공하도록 설계된 혁신적인 AI 저작 플랫폼입니다. 아티스트, 개발자, 초보자 모두 NodeTool을 사용하면 창의적인 프로토타입을 빠르게 제작할 수 있습니다.
2 년 전
0124.5K
Ultravox:实时端到端语音对话的音频多模态大模型,GPT-4o语音交互的开源实现

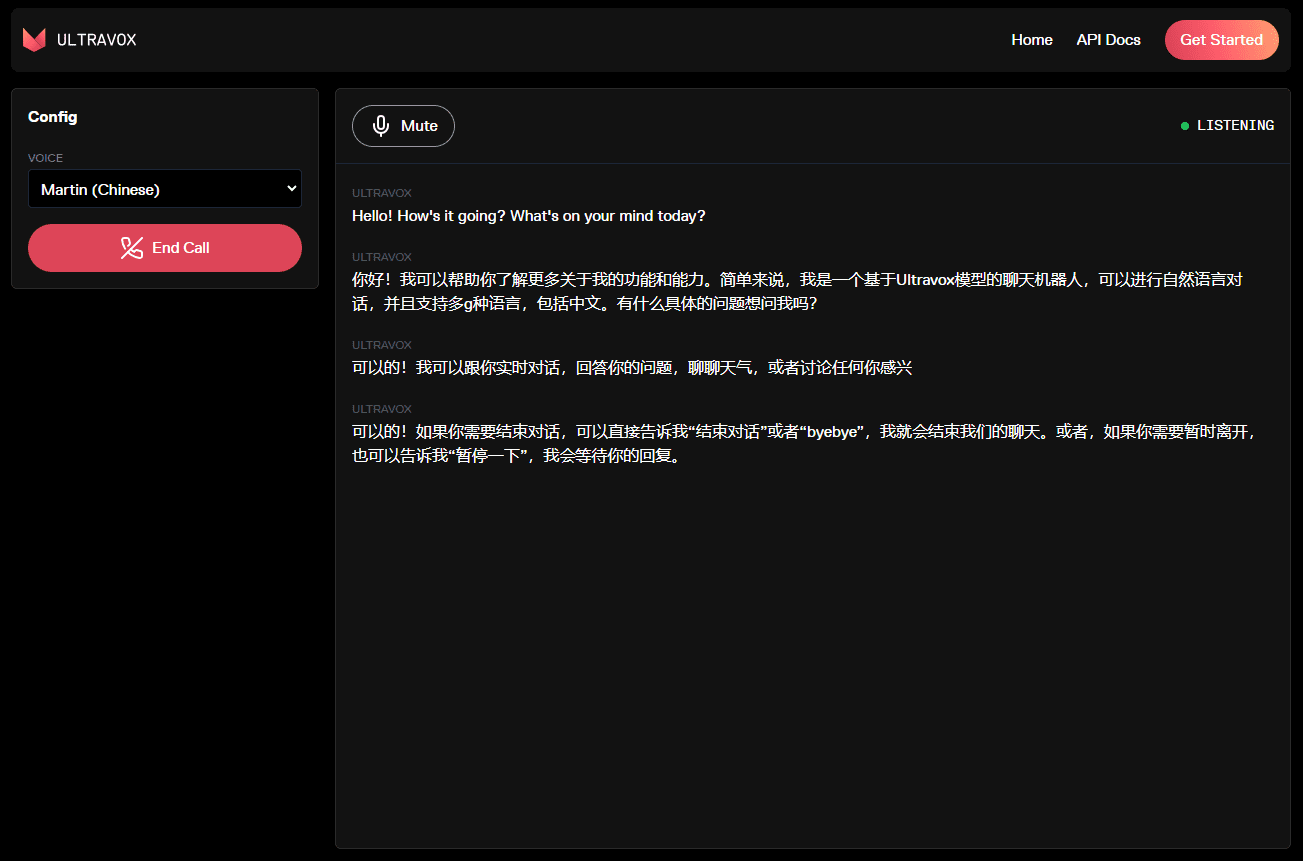
울트라박스: 실시간 엔드투엔드 음성 대화를 위한 오디오 멀티모달 매크로 모델, GPT-4o 음성 상호작용의 오픈 소스 구현

종합 소개 Ultravox는 실시간 음성 처리를 위해 설계된 혁신적인 멀티모달 대규모 언어 모델(LLM)입니다. 기존의 음성 인식 시스템과 달리 Ultravox는 별도의 ASR(오디오 음성 인식) 단계가 필요하지 않으며, 오디오를 고차원 공간으로 직접 변환할 수 있습니다.
2 년 전
0124.5K
R1-V:低成本强化学习实现视觉语言模型泛化能力

R1-V: 시각 언어 모델의 일반화 기능을 위한 저비용 강화 학습

종합 소개 R1-V는 저비용 강화 학습(RL)을 통해 시각 언어 모델링(VLM)의 획기적인 발전을 목표로 하는 오픈 소스 프로젝트입니다. 이 프로젝트는 검증 가능한 보상 메커니즘을 활용하여 VLM이 일반적인 수 세기 능력을 학습하도록 동기를 부여합니다. 놀랍게도, R1-V의 2B는 ...
2 년 전
0124.3K
GraphGen:利用知识图谱生成合成数据微调语言模型

GraphGen: 지식 그래프를 사용하여 합성 데이터를 생성하기 위한 언어 모델 미세 조정

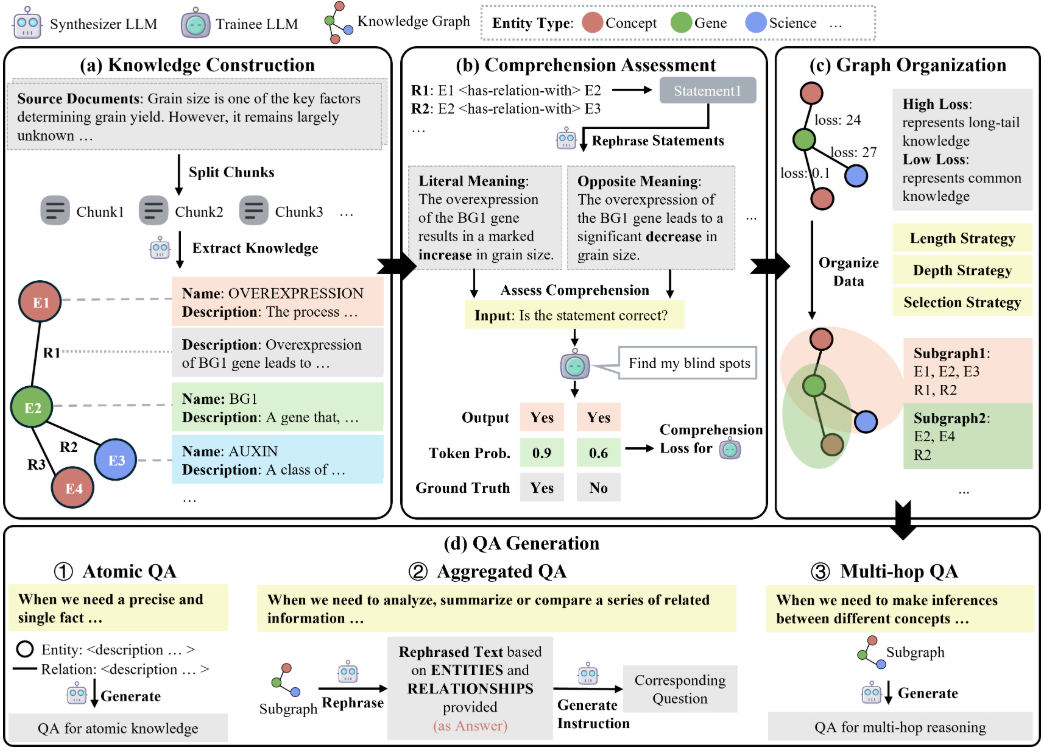
개요 GraphGen은 상하이의 AI 연구소인 OpenScienceLab에서 개발한 오픈 소스 프레임워크로, 지식 그래프를 통해 합성 데이터 생성을 안내하여 대규모 언어 모델(LLM)의 감독 미세 조정을 최적화하는 데 중점을 두고 있으며, GitHub에 호스팅되어 있습니다. 개발 배경은 ...
2 년 전
0124.1K
RLAMA:命令行操作的本地文档智能问答 RAG 系统

RLAMA: 명령줄에서 작동하는 로컬 문서의 지능형 퀴즈를 위한 RAG 시스템

일반 소개 RLAMA는 돈티지 오픈소스로 개발되어 깃허브에서 호스팅되는 문서 지능 퀴즈 RAG(검색 증강 생성) 시스템으로, 명령줄 작업을 통한 기능이 핵심 특징입니다. 사용자는 간단한 터미널 명령을 사용하여 로컬에 연결할 수 있습니다.
2 년 전
0124K
Gemini Playground:无服务器部署Gemini多模态对话网站

쌍둥이자리 놀이터: 쌍둥이자리 멀티모달 대화 사이트의 서버리스 배포

일반 소개 제미니 플레이그라운드는 사용자가 멀티모달 대화 사이트를 빠르게 배포할 수 있도록 설계된 오픈소스 프로젝트입니다. 이 프로젝트는 기술 크롤링 새우에 의해 개발되었으며 10 초 만에 Gemini API 키 사용을 지원하여 배포를 완료합니다. 사용자가 ...
2 년 전
0124K
MockingBird:快速克隆声音与模型训练,基于 xtts v2 实现的文本转语音

모킹버드: 빠른 음성 복제 및 모델 학습, xtts v2 기반 텍스트 음성 변환

종합적인 소개 모킹버드는 AI 기술을 통해 빠른 음성 복제와 텍스트 음성 변환을 목표로 하는 오픈 소스 프로젝트입니다. 사용자는 5초 분량의 음성 샘플만 제공하면 모든 음성 콘텐츠를 생성할 수 있습니다. 이 프로젝트는 다양한 중국어 데이터 세트를 지원하며 Windows에서는 ...
2 년 전
0123.9K
CoolCline:又一个增强版Cline智能编码助手,结合ClineRoo Cline和Bao Cline的优点

쿨클라인: 클라인루 클라인과 바오 클라인의 장점을 결합한 클라인의 지능형 코딩 어시스턴트의 또 다른 향상된 버전입니다.

일반 설명 쿨클라인은 클라인, 루클라인, 바오클라인의 최고의 기능을 결합한 강력한 코딩 어시스턴트입니다. 명령줄 인터페이스(CLI) 및 편집기와 원활하게 작동하여 가장 강력한 기능을 제공합니다.
2 년 전
0123.8K
Shortest:AI自动化测试工具,使用自然语言进行端到端测试

가장 짧은: 엔드투엔드 테스트에 자연어를 사용하는 AI 자동화 테스트 도구

일반 소개 쇼티스트는 안티워크 팀에서 개발한 AI 기반 자연어 엔드투엔드 테스트 프레임워크입니다. Playwright를 기반으로 구축되었으며 GitHub 통합 및 2단계 인증(2FA)을 지원합니다.Shortest의 주요 기능은 다음과 같습니다.
2 년 전
0123.8K
VimLM:本地LLM驱动的Vim编程助手,安全离线的智能编程

VimLM: 안전한 오프라인을 위한 스마트 프로그래밍 지원, 네이티브 LLM 기반 Vim 프로그래밍 도우미

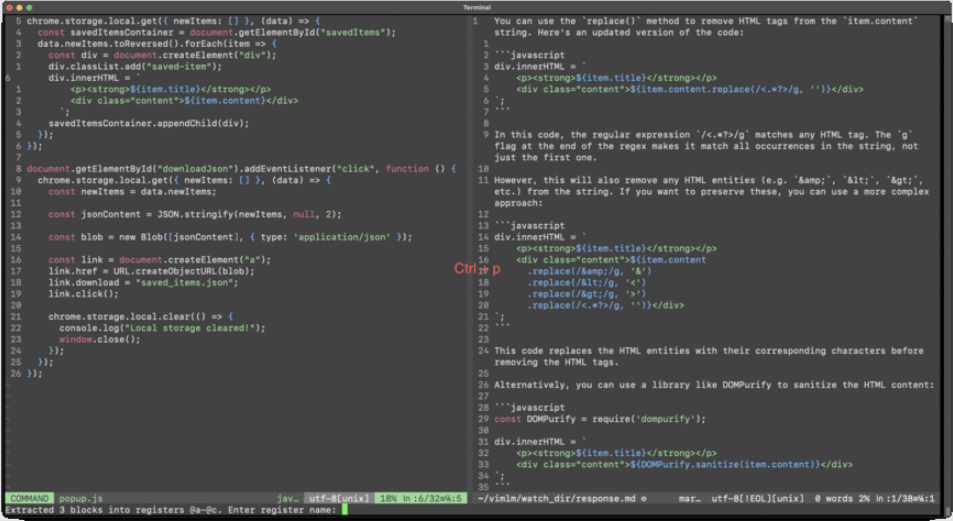
일반 소개 VimLM은 네이티브 LLM(대규모 언어 모델)으로 구동되는 코드 어시스턴트를 제공하는 Vim 플러그인입니다. Vim 명령을 통해 기본 LLM 모델과 상호 작용하여 코드 컨텍스트를 자동으로 가져와 사용자가 Vim에서 코드를 편집할 수 있도록 도와줍니다.VimLM은 다음에서 영감을 받았습니다.
2 년 전
0123.8K
AnyText:生成和编辑多语言图像文本,高可控在图像中生成多行中文

AnyText: 다국어 이미지 텍스트를 생성하고 편집할 수 있으며, 이미지에 여러 줄의 중국어를 생성하도록 고도로 제어할 수 있습니다.

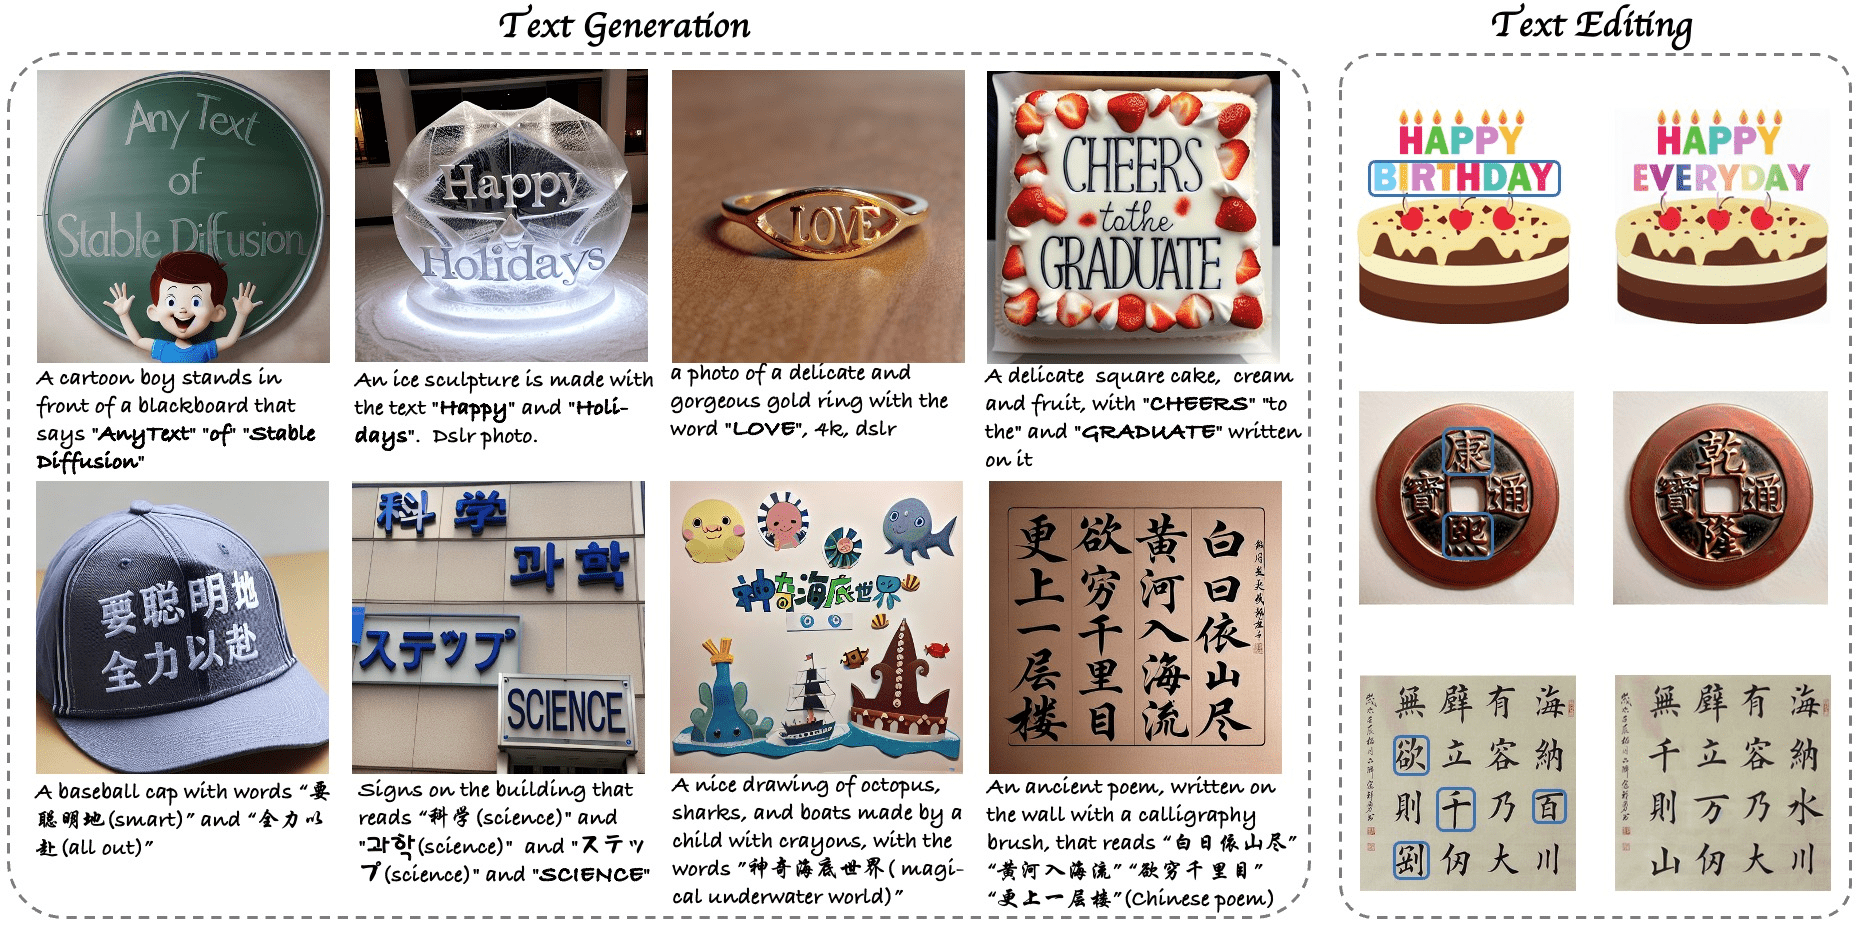
종합 소개 AnyText는 확산 모델을 기반으로 개발된 혁신적인 다국어 시각 텍스트 생성 및 편집 도구입니다. 이미지에서 자연스러운 고품질 다국어 텍스트를 생성하고 유연한 텍스트 편집 기능을 지원합니다. 연구팀이 개발하여 ICLR 2024에서 발표했습니다...
2 년 전
0123.7K
TransRouter:基于Gemini多模态模型,实时中英互译的音频转换工具

TransRouter: Gemini 멀티모달 모델을 기반으로 중국어에서 영어로 번역하는 실시간 오디오 변환 도구

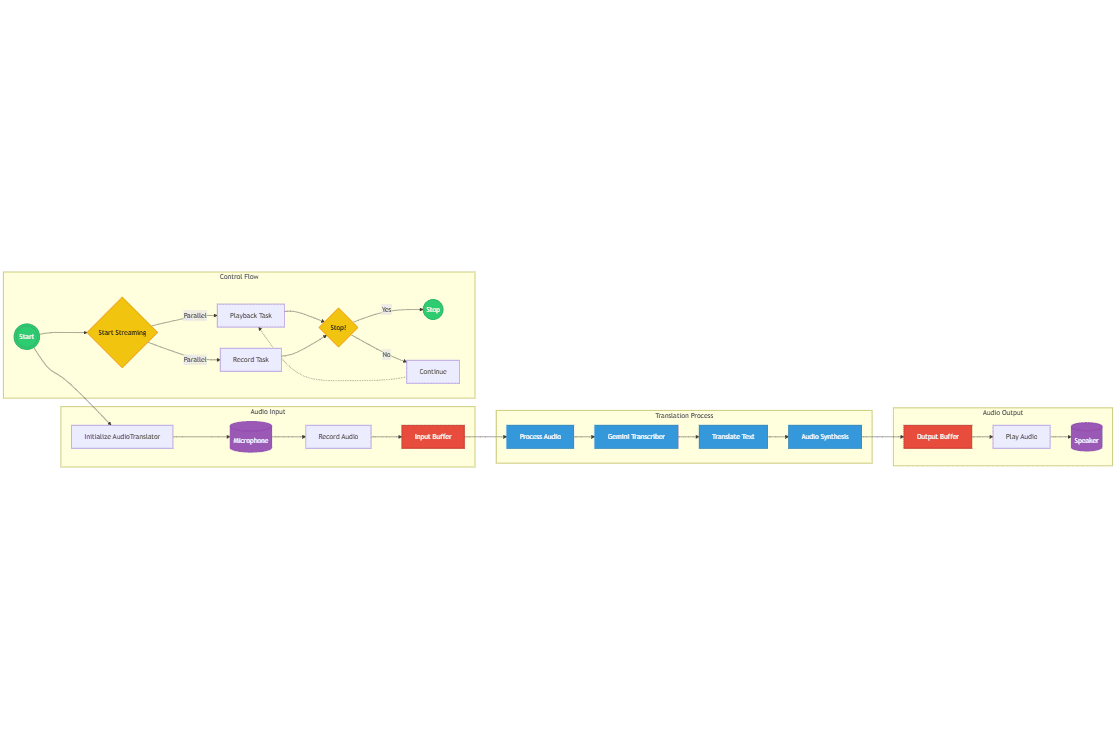
TransRouter는 영어와 중국어 간의 실시간 음성 번역을 위해 특별히 설계된 Google의 Gemini 모델을 기반으로 하는 실시간 음성 번역 도구입니다. 이 도구는 Zoom과 같은 화상 회의 소프트웨어에 원활하게 통합되어 언어 간 번역을 위한 강력한 도구를 제공합니다.
2 년 전
0123.6K
ChatAnyone:从照片生成半身数字人肖像视频的工具

ChatAnyone: 사진으로 반신 디지털 인물 동영상을 생성하는 도구

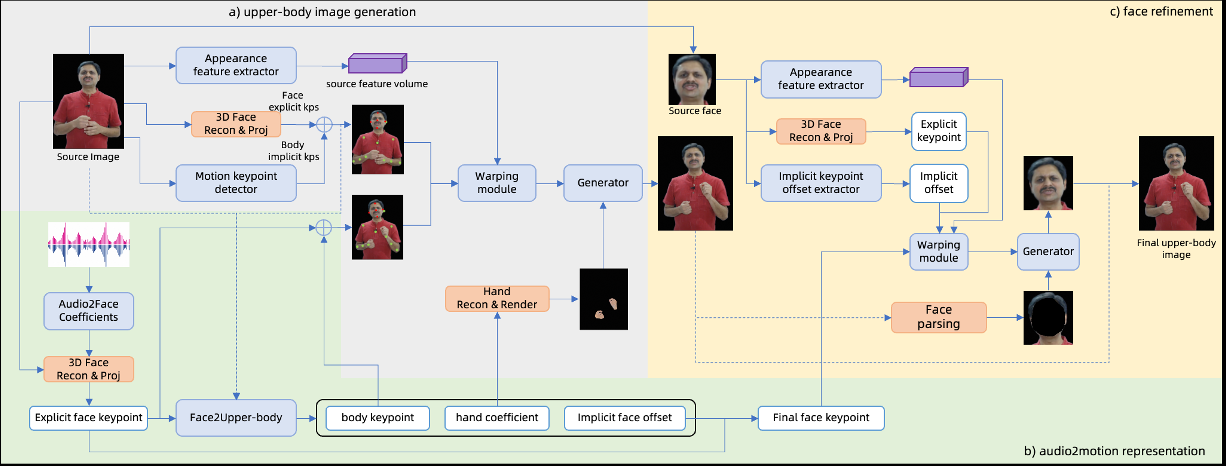
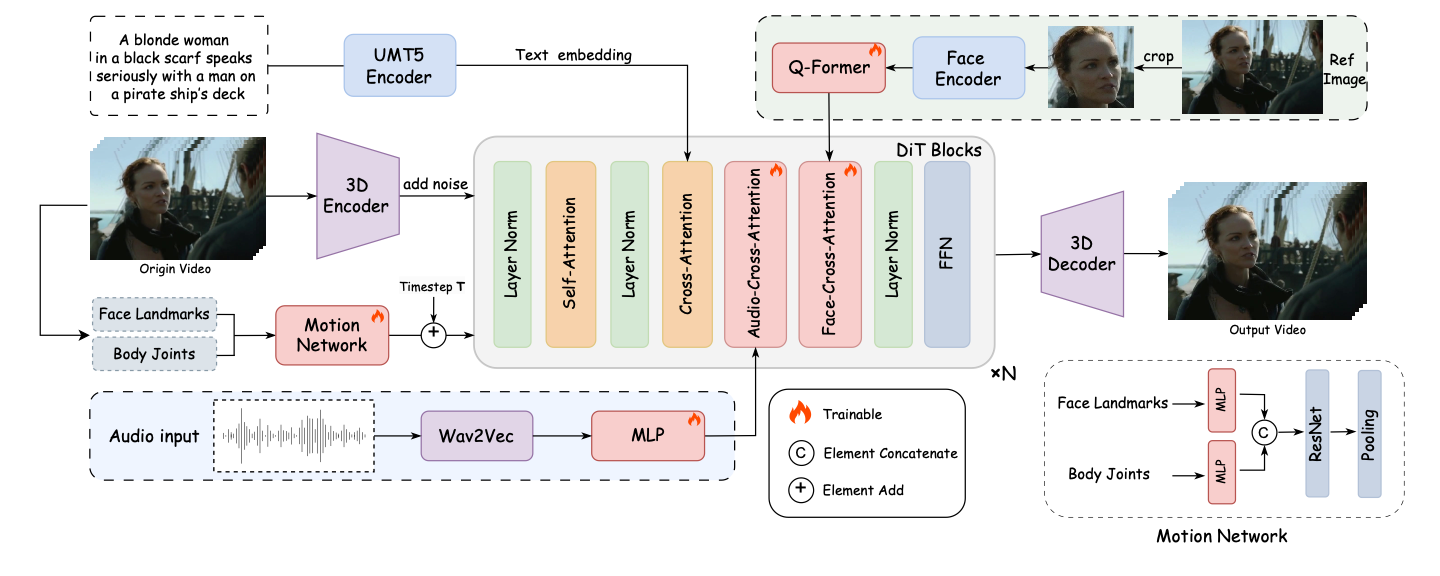
일반 소개 채팅애니원은 HumanAIGC 팀이 개발한 혁신적인 프로젝트입니다. 인공 지능 기술을 사용하여 한 장의 사진과 오디오 입력으로 상체 움직임이 있는 디지털 인물 동영상을 생성합니다. 이 프로젝트는 머리 움직임을 생성하는 계층적 모션 확산 모델을 기반으로 합니다...
2 년 전
0123.6K
SegAnyMo:从视频中自动分割任意运动物体的开源工具

SegAnyMo: 동영상에서 임의의 움직이는 객체를 자동으로 분할하는 오픈 소스 도구

일반 소개 SegAnyMo는 UC 버클리와 북경대학교의 연구팀이 개발한 오픈 소스 프로젝트로, Nan Huang 등의 멤버가 참여하고 있습니다. 이 도구는 동영상 처리에 중점을 두고 있으며 동영상에서 사람, 동물 또는... 등 임의의 움직이는 물체를 자동으로 식별하고 세그먼트화할 수 있습니다.
2 년 전
0123.6K
PandasAI:数据分析对话平台,用自然语言完成数据查询与图表生成

PandasAI: 자연어로 데이터 쿼리 및 차트 생성을 위한 데이터 분석 대화 플랫폼

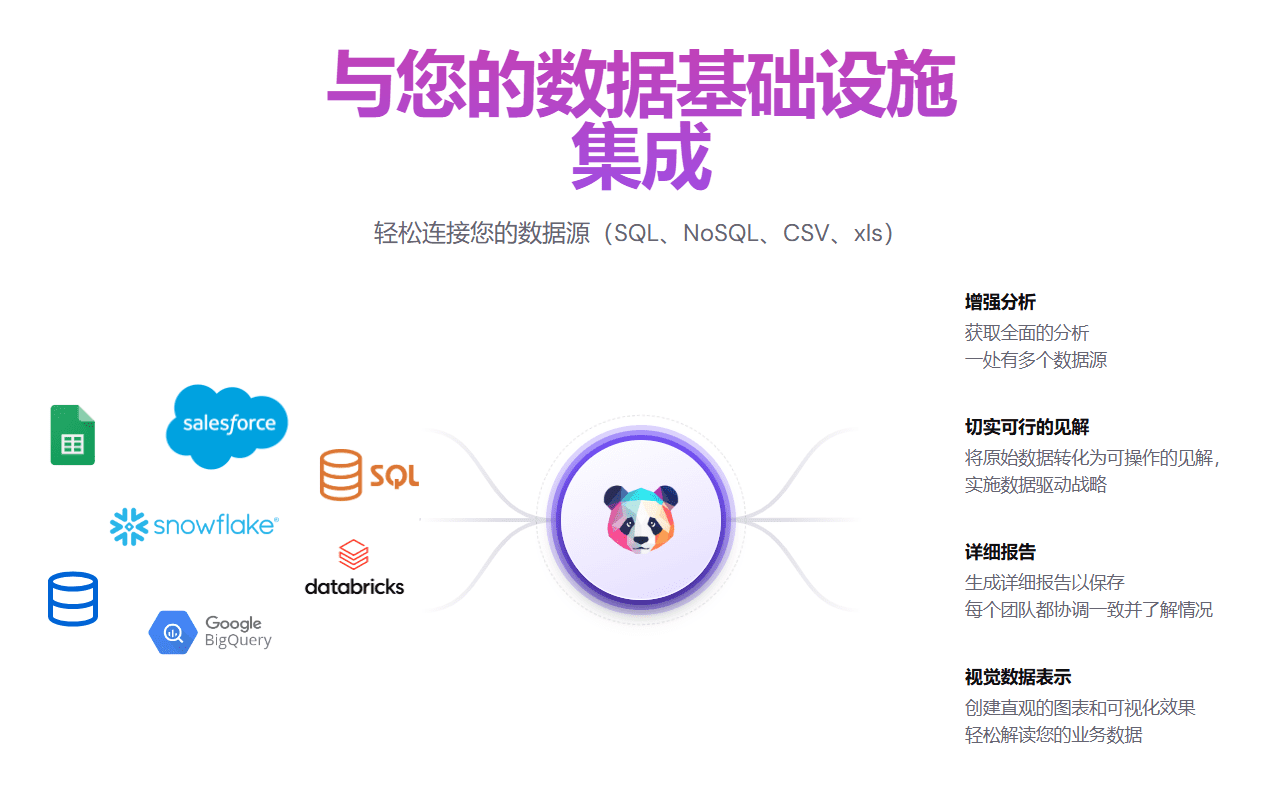
일반 소개 PandasAI는 자연어 처리 기술을 통해 데이터 분석 프로세스를 간소화하도록 설계된 Python 기반 오픈 소스 플랫폼입니다. 사용자가 데이터베이스(예: SQL, CSV, 판다, 폴라, 몽고DB, ...)와의 대화를 통해 작업할 수 있도록 지원합니다.
2 년 전
0123.6K
PrimisAI Nexus:构建可扩展AI多智能体系统与任务自动化的轻量框架

PrimisAI Nexus: 확장 가능한 AI 다중 지능 시스템 및 작업 자동화를 구축하기 위한 경량 프레임워크

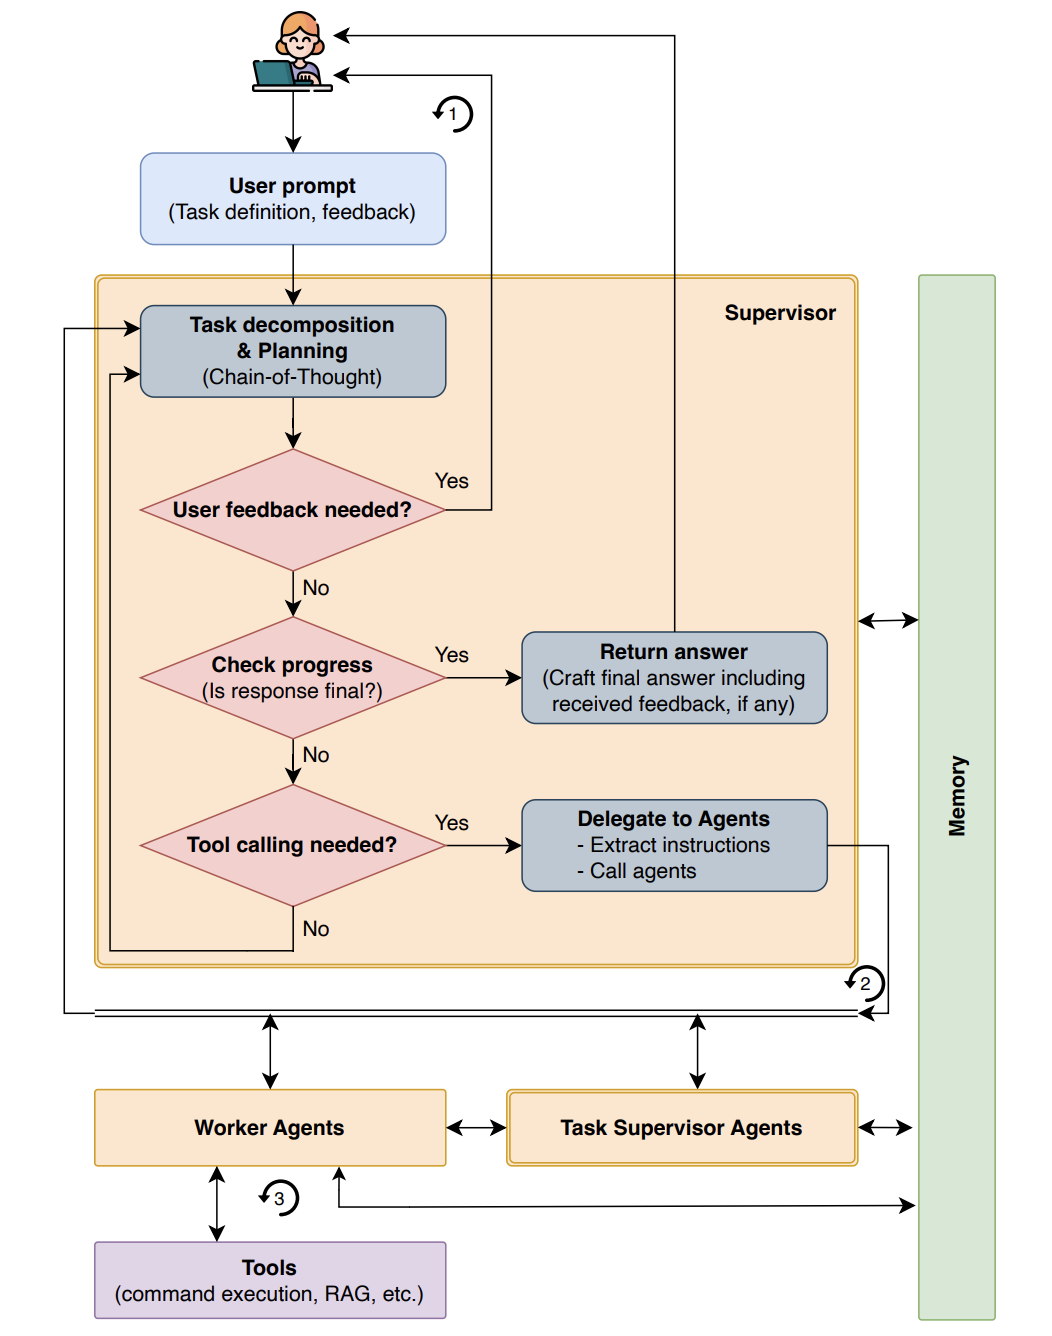
일반 소개 PrimisAI Nexus는 GitHub에서 호스팅되고 PrimisAI 팀이 개발한 경량 오픈 소스 Python 프레임워크로, 사용자가 LLM(대규모 언어 모델링)을 통해 확장 가능한 AI 다중 지능형 바디 시스템을 구축하고 관리할 수 있도록 지원합니다....
2 년 전
0123.5K
Ruyi-Models:生成图像到视频开源模型,支持镜头控制与运动幅度控制

루이 모델: 렌즈 제어 및 모션 진폭 제어를 지원하는 이미지-투-비디오 오픈 소스 모델을 생성합니다.

일반 소개 Ruyi-Models는 이미지에서 고품질 동영상을 생성하도록 설계된 오픈 소스 프로젝트입니다. IamCreateAI 팀이 개발한 이 프로젝트는 768 해상도, 초당 24프레임, 5초에 120프레임의 시네마틱 비디오 생성을 지원합니다....
2 년 전
0123.5K
VideoRAG:理解超长视频的RAG框架,支持多模态检索和知识图谱构建

VideoRAG: 멀티모달 검색 및 지식 그래프 구성을 지원하여 매우 긴 동영상을 이해하기 위한 RAG 프레임워크입니다.

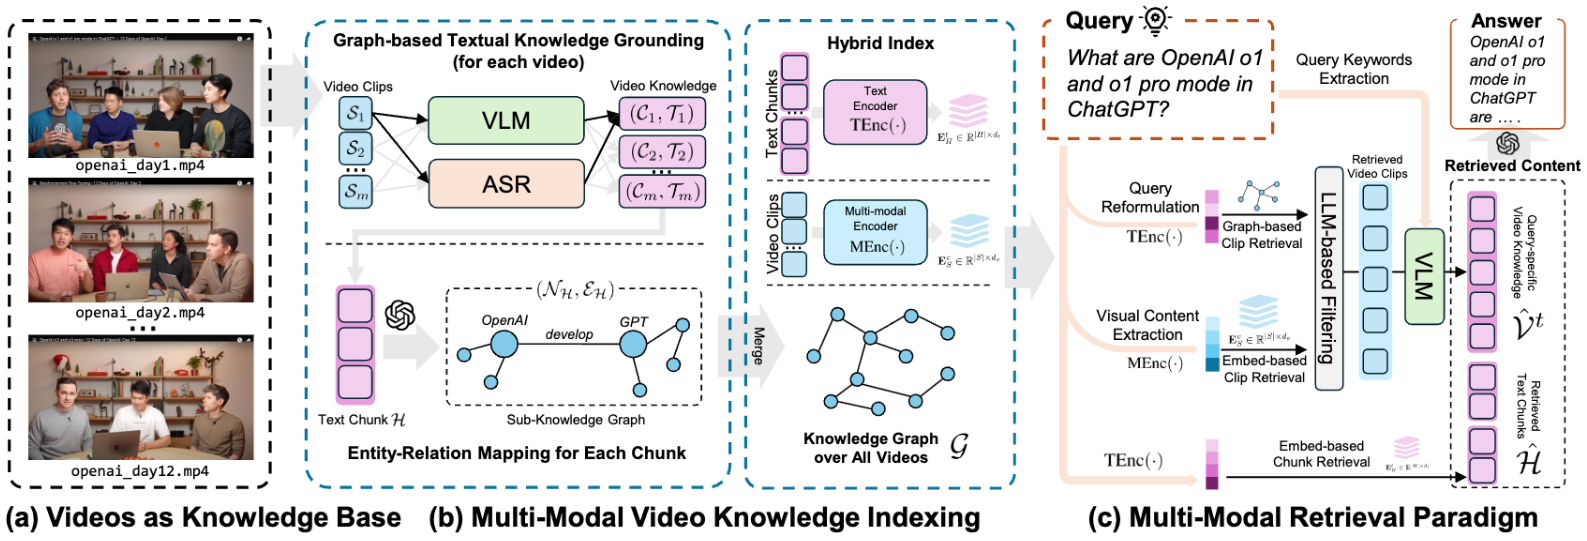
포괄적인 소개 VideoRAG는 매우 긴 컨텍스트 비디오를 처리하고 이해하도록 설계된 검색 강화 생성 프레임워크입니다. 이 도구는 그래프 중심의 텍스트 지식 기반과 계층적 멀티모달 컨텍스트 인코딩을 결합하여 단일 NVIDIA RTX 3090 GPU에서 효율적으로 처리합니다....
2 년 전
0123.5K
X-Dyna:静态人像参考视频姿态生成视频,让小姐姐的照片跳舞

X-Dyna: 미시의 사진을 춤추게 만드는 스틸 인물 레퍼런스 비디오 포즈 생성 비디오

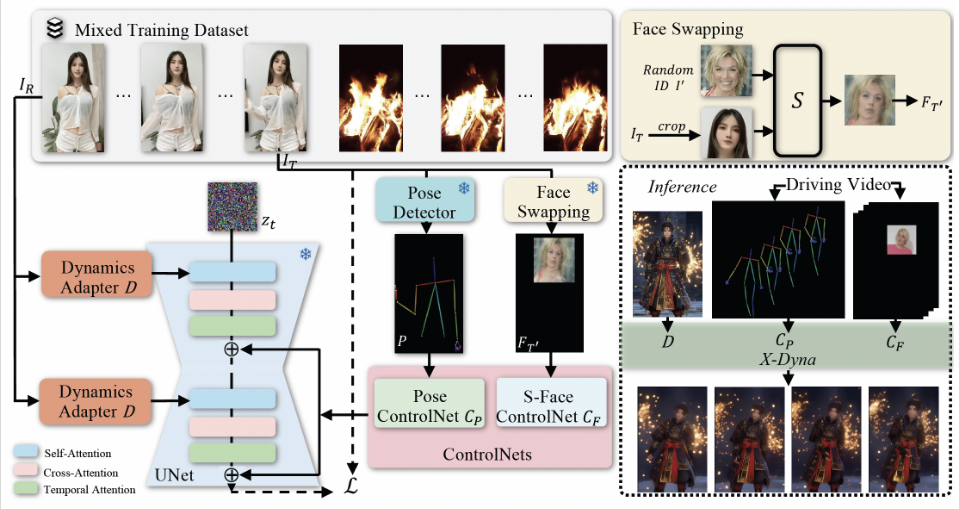
일반 소개 X-Dyna는 제로 샘플 확산 기법을 사용하여 역동적인 인물 애니메이션을 생성하기 위해 ByteDance에서 개발한 오픈 소스 프로젝트입니다. 이 프로젝트는 드라이브 비디오의 얼굴 표정과 신체 움직임을 사용하여 개별 인물 이미지에 애니메이션을 적용하여 사실적이고 상황에 맞는 모션 효과를 생성합니다.X-D...
2 년 전
0123.2K
WebPilot:智能网页信息处理工具,网页内容抓取免费API

WebPilot: 지능형 웹 정보 처리 도구, 웹 콘텐츠 캡처를 위한 무료 API

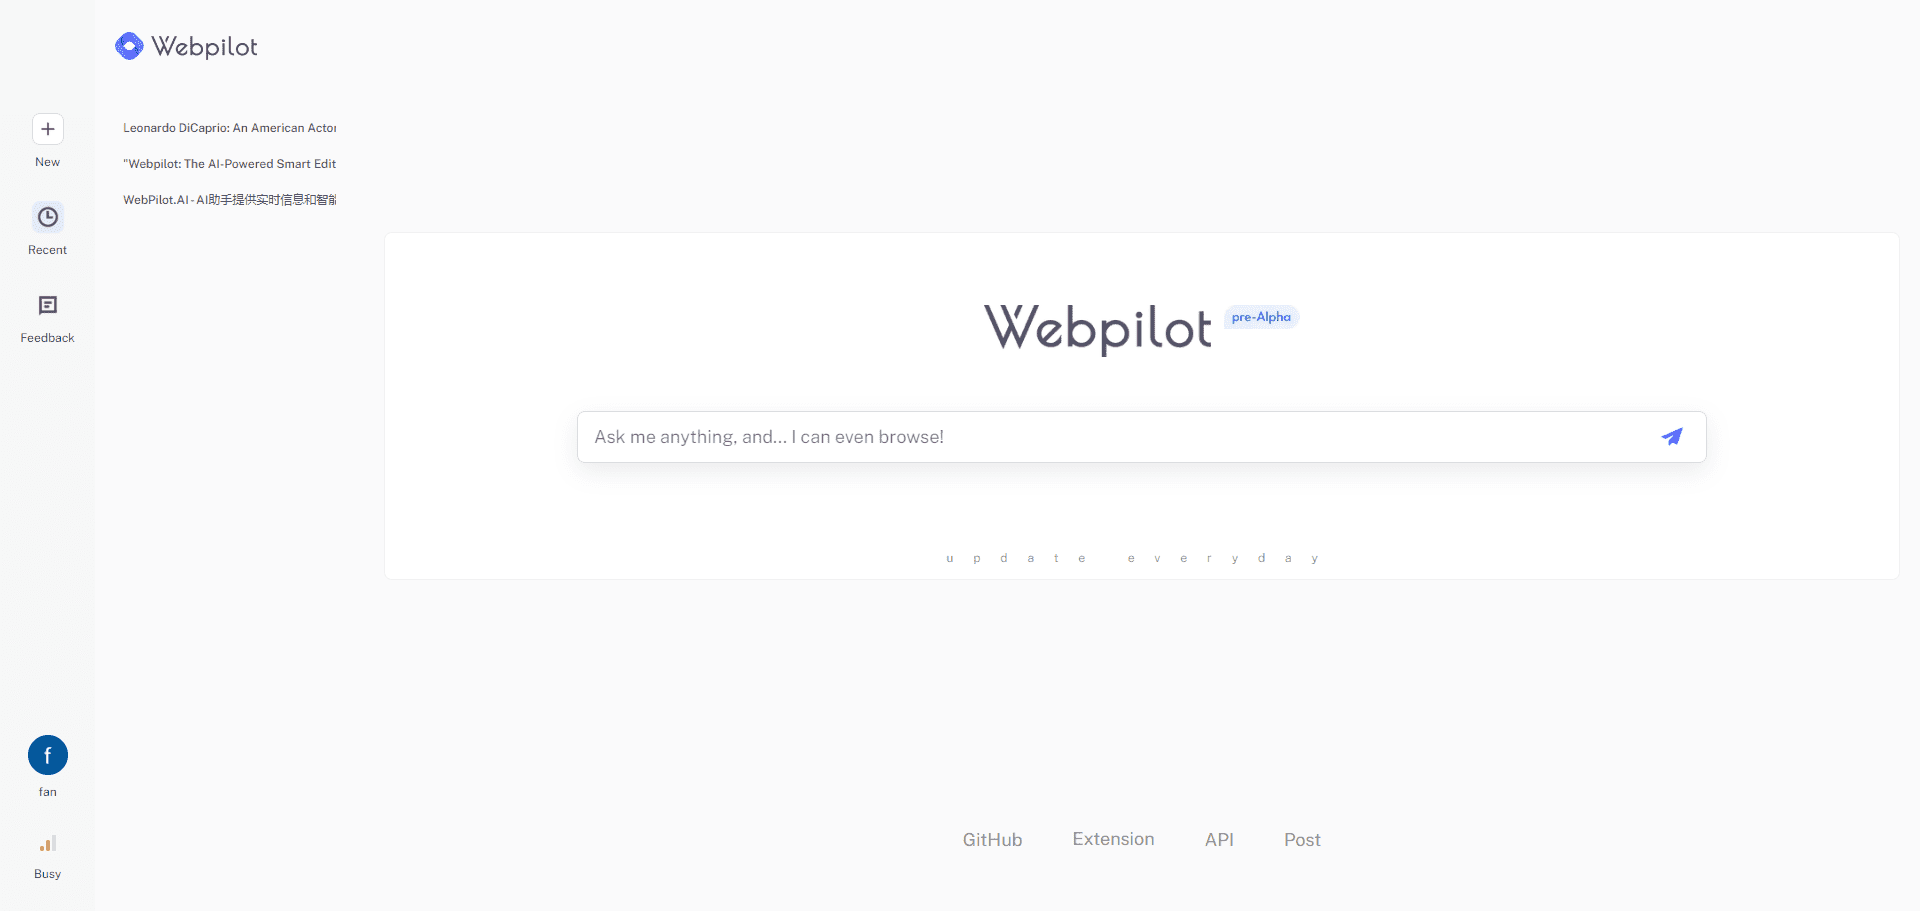
웹파일럿 일반 소개 웹파일럿은 모든 웹 페이지와 자유롭게 소통하거나 자동화된 작업을 수행할 수 있는 무료 오픈 소스 '웹 어시스턴트'입니다. 페이지를 전환하거나 복사하여 붙여넣을 필요 없이 텍스트를 선택하거나 명령을 입력하기만 하면 웹파일럿을 사용할 수 있습니다.
2 년 전
0123.1K
BuffGPT:企业级生成式AI应用低代码开发平台

BuffGPT: 엔터프라이즈급 제너레이티브 AI 애플리케이션을 위한 로우코드 개발 플랫폼

개요 BuffGPT는 대규모 언어 모델(LLM) 기반의 오픈 소스 AI 애플리케이션 개발 플랫폼으로, 데이터 처리, 모델 호출, RAG 검색, 시각적 워크플로 오케스트레이션 등의 기본 기능을 제공하여 사용자가 제너레이티브 AI 애플리케이션을 쉽게 구축하고 운영할 수 있도록 지원합니다. 이 플랫폼은 프라이빗을 지원합니다.
2 년 전
0123.1K
Open NotebookLM:将PDF转换为播客的开源工具

Open NotebookLM: PDF를 오픈 소스 도구의 팟캐스트로 변환하기

일반 소개 Open NotebookLM은 모든 PDF 문서를 팟캐스트로 변환하도록 설계된 오픈 소스 프로젝트입니다. 이 도구는 오픈 소스 LLM(대규모 언어 모델) 및 TTS(텍스트 음성 변환) 모델을 사용하여 PDF 콘텐츠를 처리하여 오디오 팟캐스트에 적합한 자연스러운 대화를 생성합니다....
2 년 전
0122.9K
小半 WordPress AI 助手:实现对话、文章生成与翻译的 WordPress AI助手插件

리틀 하프 워드프레스 AI 어시스턴트: 대화, 포스트 생성 및 번역을 위한 워드프레스 AI 어시스턴트 플러그인

종합 소개 워드프레스 AI 어시스턴트 플러그인(wp-ai-chat)은 AI 대화, 글 생성, 글 요약, 글 번역, 콘텐츠 읽기 등 다양한 AI 기능을 사용자에게 제공하도록 설계된 오픈 소스 워드프레스 플러그인입니다. 플러그인은 여러 개의 도킹을 지원합니다 ...
2 년 전
0122.9K
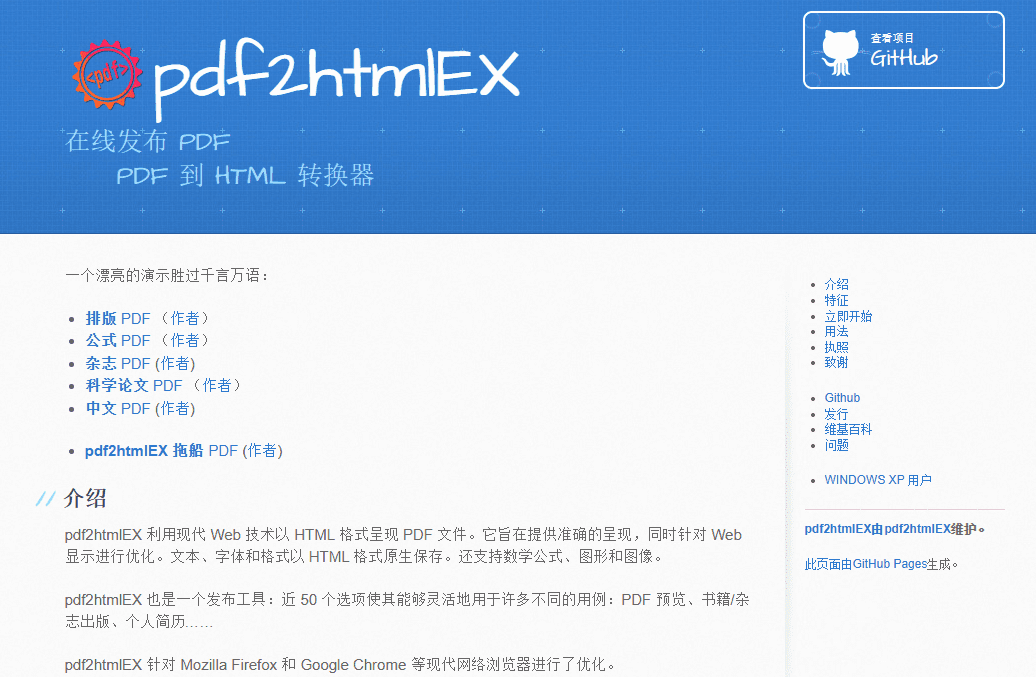
pdf2htmlEX:PDF无损转换为HTML,保持文本格式,适用于学术论文和杂志排版

pdf2htmlEX: PDF를 HTML로 무손실 변환하여 텍스트 서식을 유지하며 학술 논문 및 잡지 조판에 적합합니다.

포괄적 인 소개 pdf2htmlEX는 PDF 파일의 내용을 분석하고 HTML + CSS를 사용하여 시각 효과를 정확하게 복원하여 PDF 파일을 HTML 형식으로 변환하도록 설계된 오픈 소스 도구로, PDF 문서가 브라우저로 변환됩니다 ...
2 년 전
0122.9K
HelloMeme:生成局部高保真表情动作一致的图像或视频,Runway Act one 开源平替

HelloMeme: 로컬 고 충실도 표현 액션 일관된 이미지 또는 비디오 생성, 런웨이 액트 원 오픈 소스 탁구!

포괄적 인 소개 HelloMeme은 HelloVision에서 개발 한 오픈 소스 프로젝트로, 공간 뜨개질주의를 통합하여 확산 모델에 고수준 및 고 충실도 스트립을 포함하는 것을 목표로합니다 ...
2 년 전
0122.8K
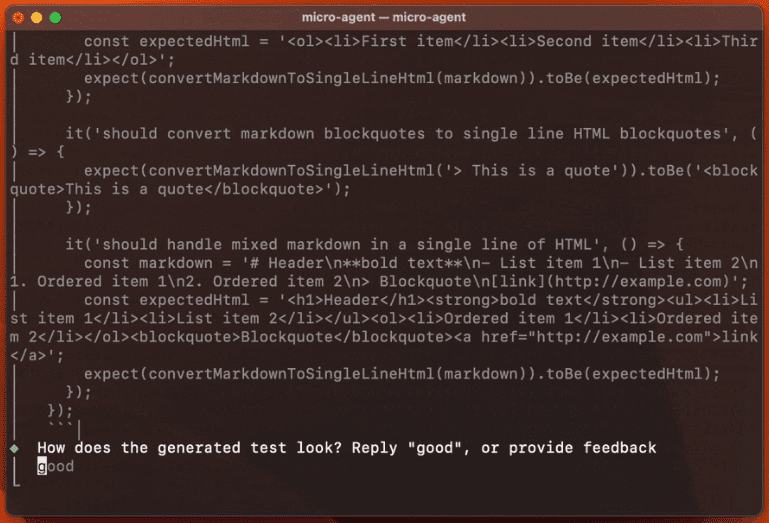
Micro Agent:AI编程智能体,自动生成代码并测试、修复代码

마이크로 에이전트: 자동으로 코드를 생성하고 테스트 및 수정하는 AI 프로그래밍 인텔리전스입니다.

일반 소개 마이크로 에이전트는 Builder.io에서 개발한 오픈 소스 AI 코딩 도우미로, 개발자에게 코드를 자동으로 생성하고 테스트할 수 있는 기능을 제공하도록 설계되었습니다. 자연어 설명을 이해하여 테스트 케이스를 생성하고 모든 테스트가 통과할 때까지 코드를 반복하여 오픈 ...
2 년 전
0122.8K
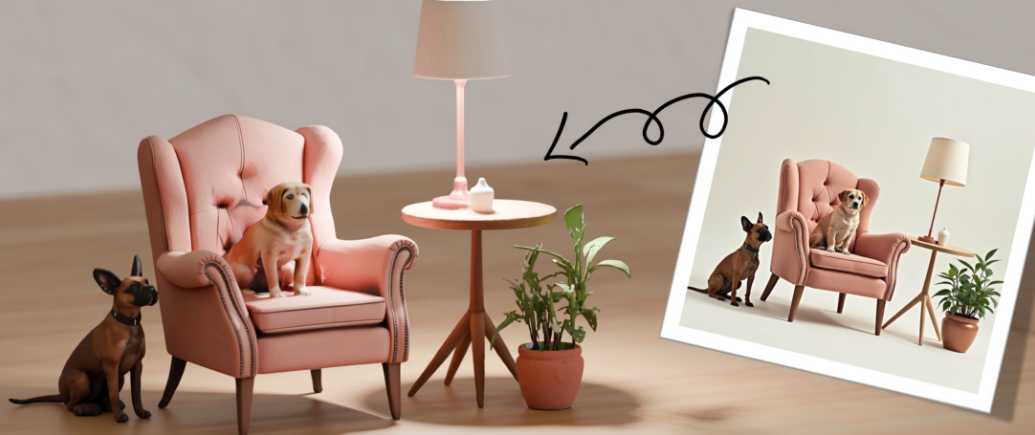
PhotoDoodle:文字指令为照片添加艺术涂鸦的AI工具

PhotoDoodle: 텍스트 명령으로 사진에 예술적인 낙서를 추가할 수 있는 AI 도구

일반 소개 포토두들은 쇼랩에서 개발한 오픈 소스 이미지 편집 도구로, 인공지능 기술을 통한 사진의 예술적 편집에 중점을 두고 있습니다. 사용자는 간단한 텍스트 입력만으로 만화 스타일, 3D 효과, 빛을 실제 사진에 추가할 수 있습니다...
2 년 전
0122.7K
MIDI-3D:从单张图片快速生成多物体3D场景的开源工具

MIDI-3D: 단일 이미지에서 멀티 오브젝트 3D 씬을 빠르게 생성하는 오픈 소스 툴입니다.

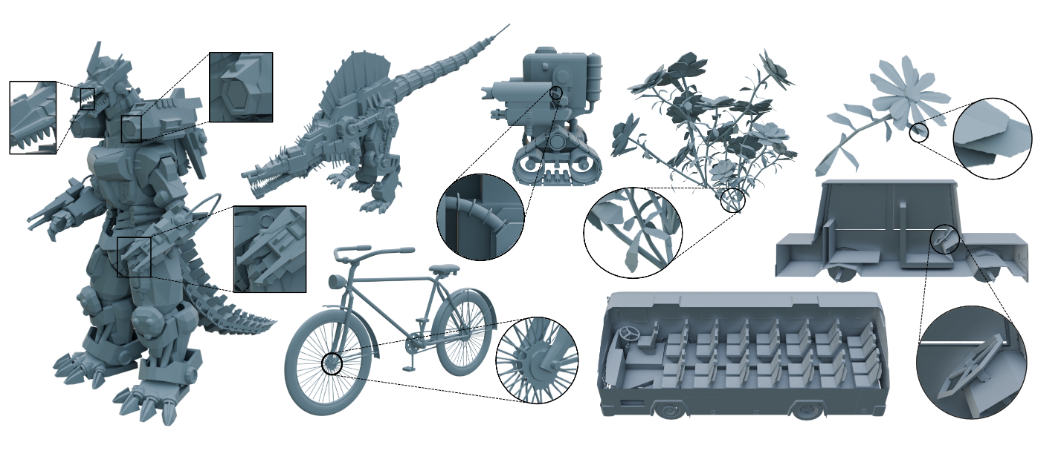
일반 소개 MIDI-3D는 개발자, 연구원 및 크리에이터를 위해 단일 이미지에서 여러 오브젝트가 포함된 3D 장면을 빠르게 생성하기 위해 VAST-AI-Research 팀에서 개발한 오픈 소스 프로젝트입니다. 이 도구는 다중 인스턴스 확산 모델링 기법을 기반으로 합니다...
2 년 전
0122.7K
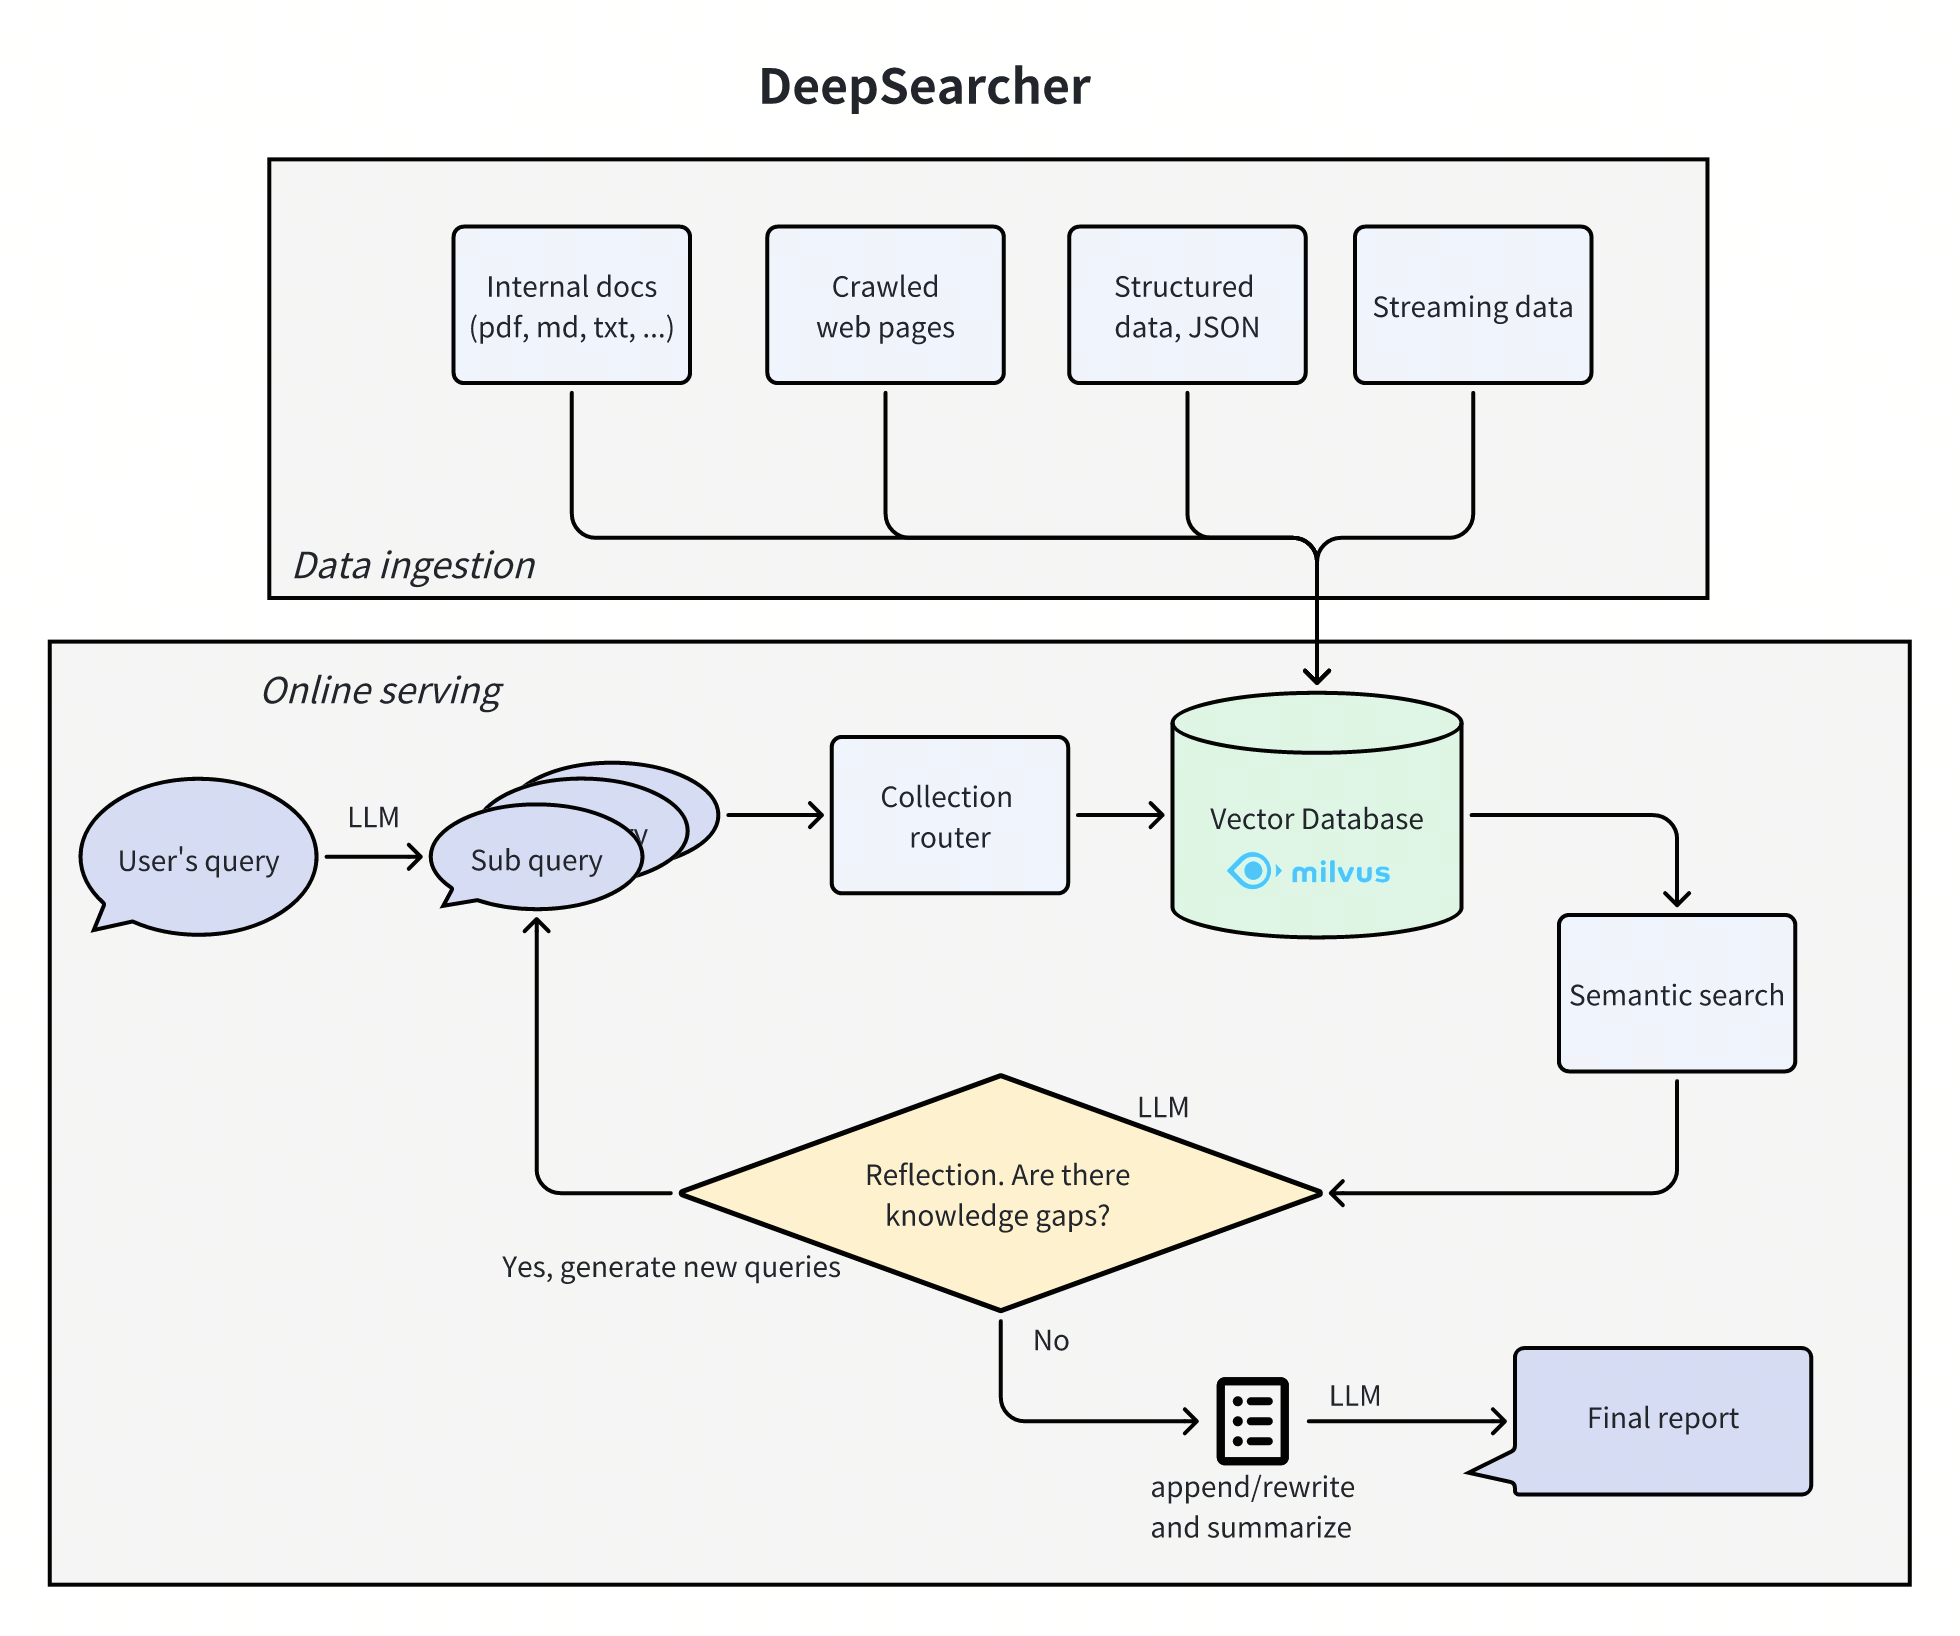
深度搜索器:利用本地知识进行深度推理搜索的开源项目

딥 파인더: 로컬 지식을 이용한 심층 추론 검색을 위한 오픈 소스 프로젝트

종합 소개 Deep Searcher는 개인 데이터를 기반으로 검색, 평가 및 추론하도록 설계된 LLM(대규모 언어 모델)과 벡터 데이터베이스를 결합하여 매우 정확한 답변과 포괄적인 보고서를 제공하는 강력한 도구입니다. 엔터프라이즈 지식 관리에 적합합니다...
2 년 전
0122.6K
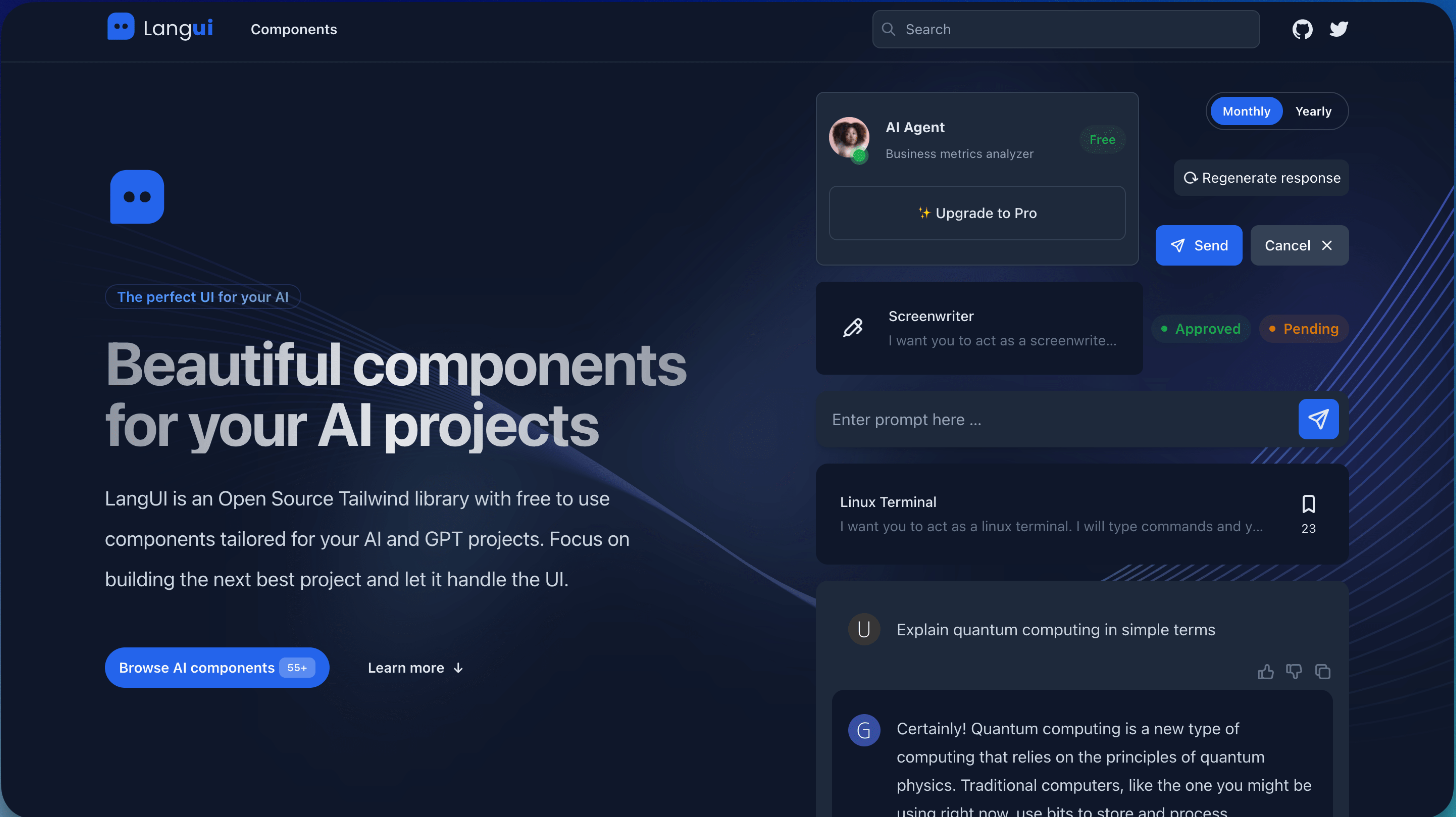
Langui:开源的AI用户界面组件库

Langui: AI 사용자 인터페이스 구성 요소의 오픈 소스 라이브러리

일반 소개 LangbaseInc의 Langui는 제너레이티브 AI 및 LLM(대규모 언어 모델링) 프로젝트를 위해 설계된 오픈 소스 사용자 인터페이스 컴포넌트 라이브러리입니다. 이 라이브러리는 Tailwind CSS를 기반으로 하며 개발자가 빠르게 구성할 수 있도록 미리 빌드된 UI 컴포넌트 모음을 제공합니다.
2 년 전
0122.6K
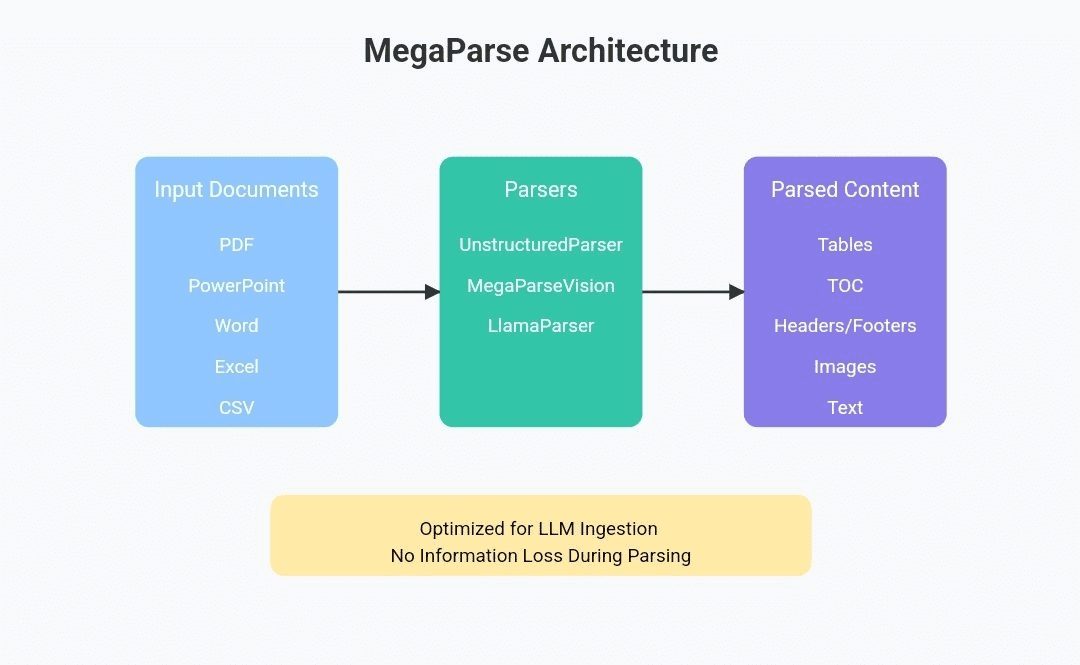
MegaParse:解析各类型文档为LLM可用数据,完整保留文档中的表格、图片等所有信息

MegaParse: 각 유형의 문서를 LLM 사용 가능한 데이터로 구문 분석하여 표와 그림 등 문서의 모든 정보를 전체적으로 보존합니다.

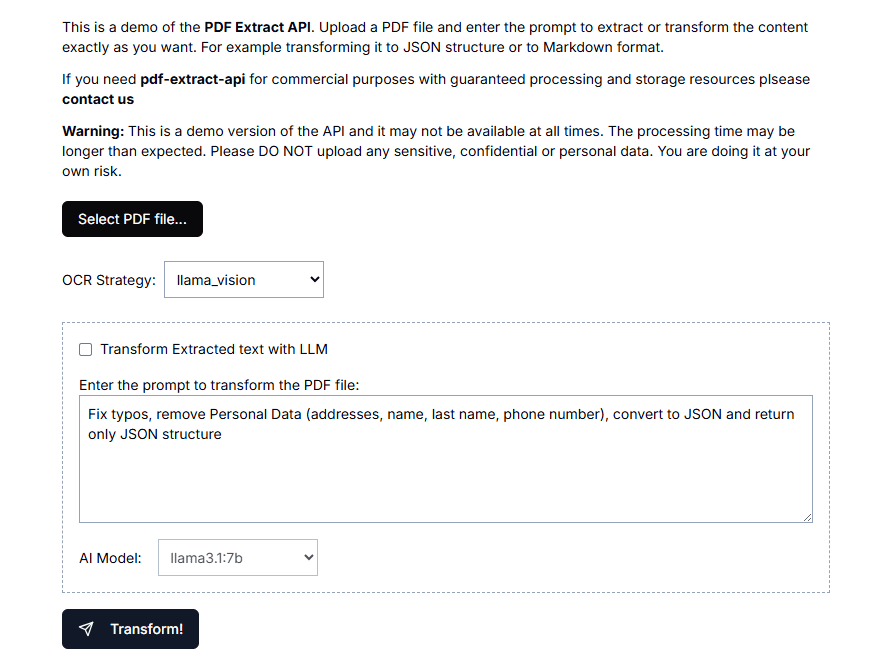
일반 소개 MegaParse는 대규모 언어 모델(LLM)의 데이터 처리를 최적화하도록 설계된 강력하고 다재다능한 문서 구문 분석 도구입니다. 텍스트, PDF, PowerPoint 프레젠테이션, Word 문서 등 어떤 작업을 하든 MegaParse...
2 년 전
0122.5K
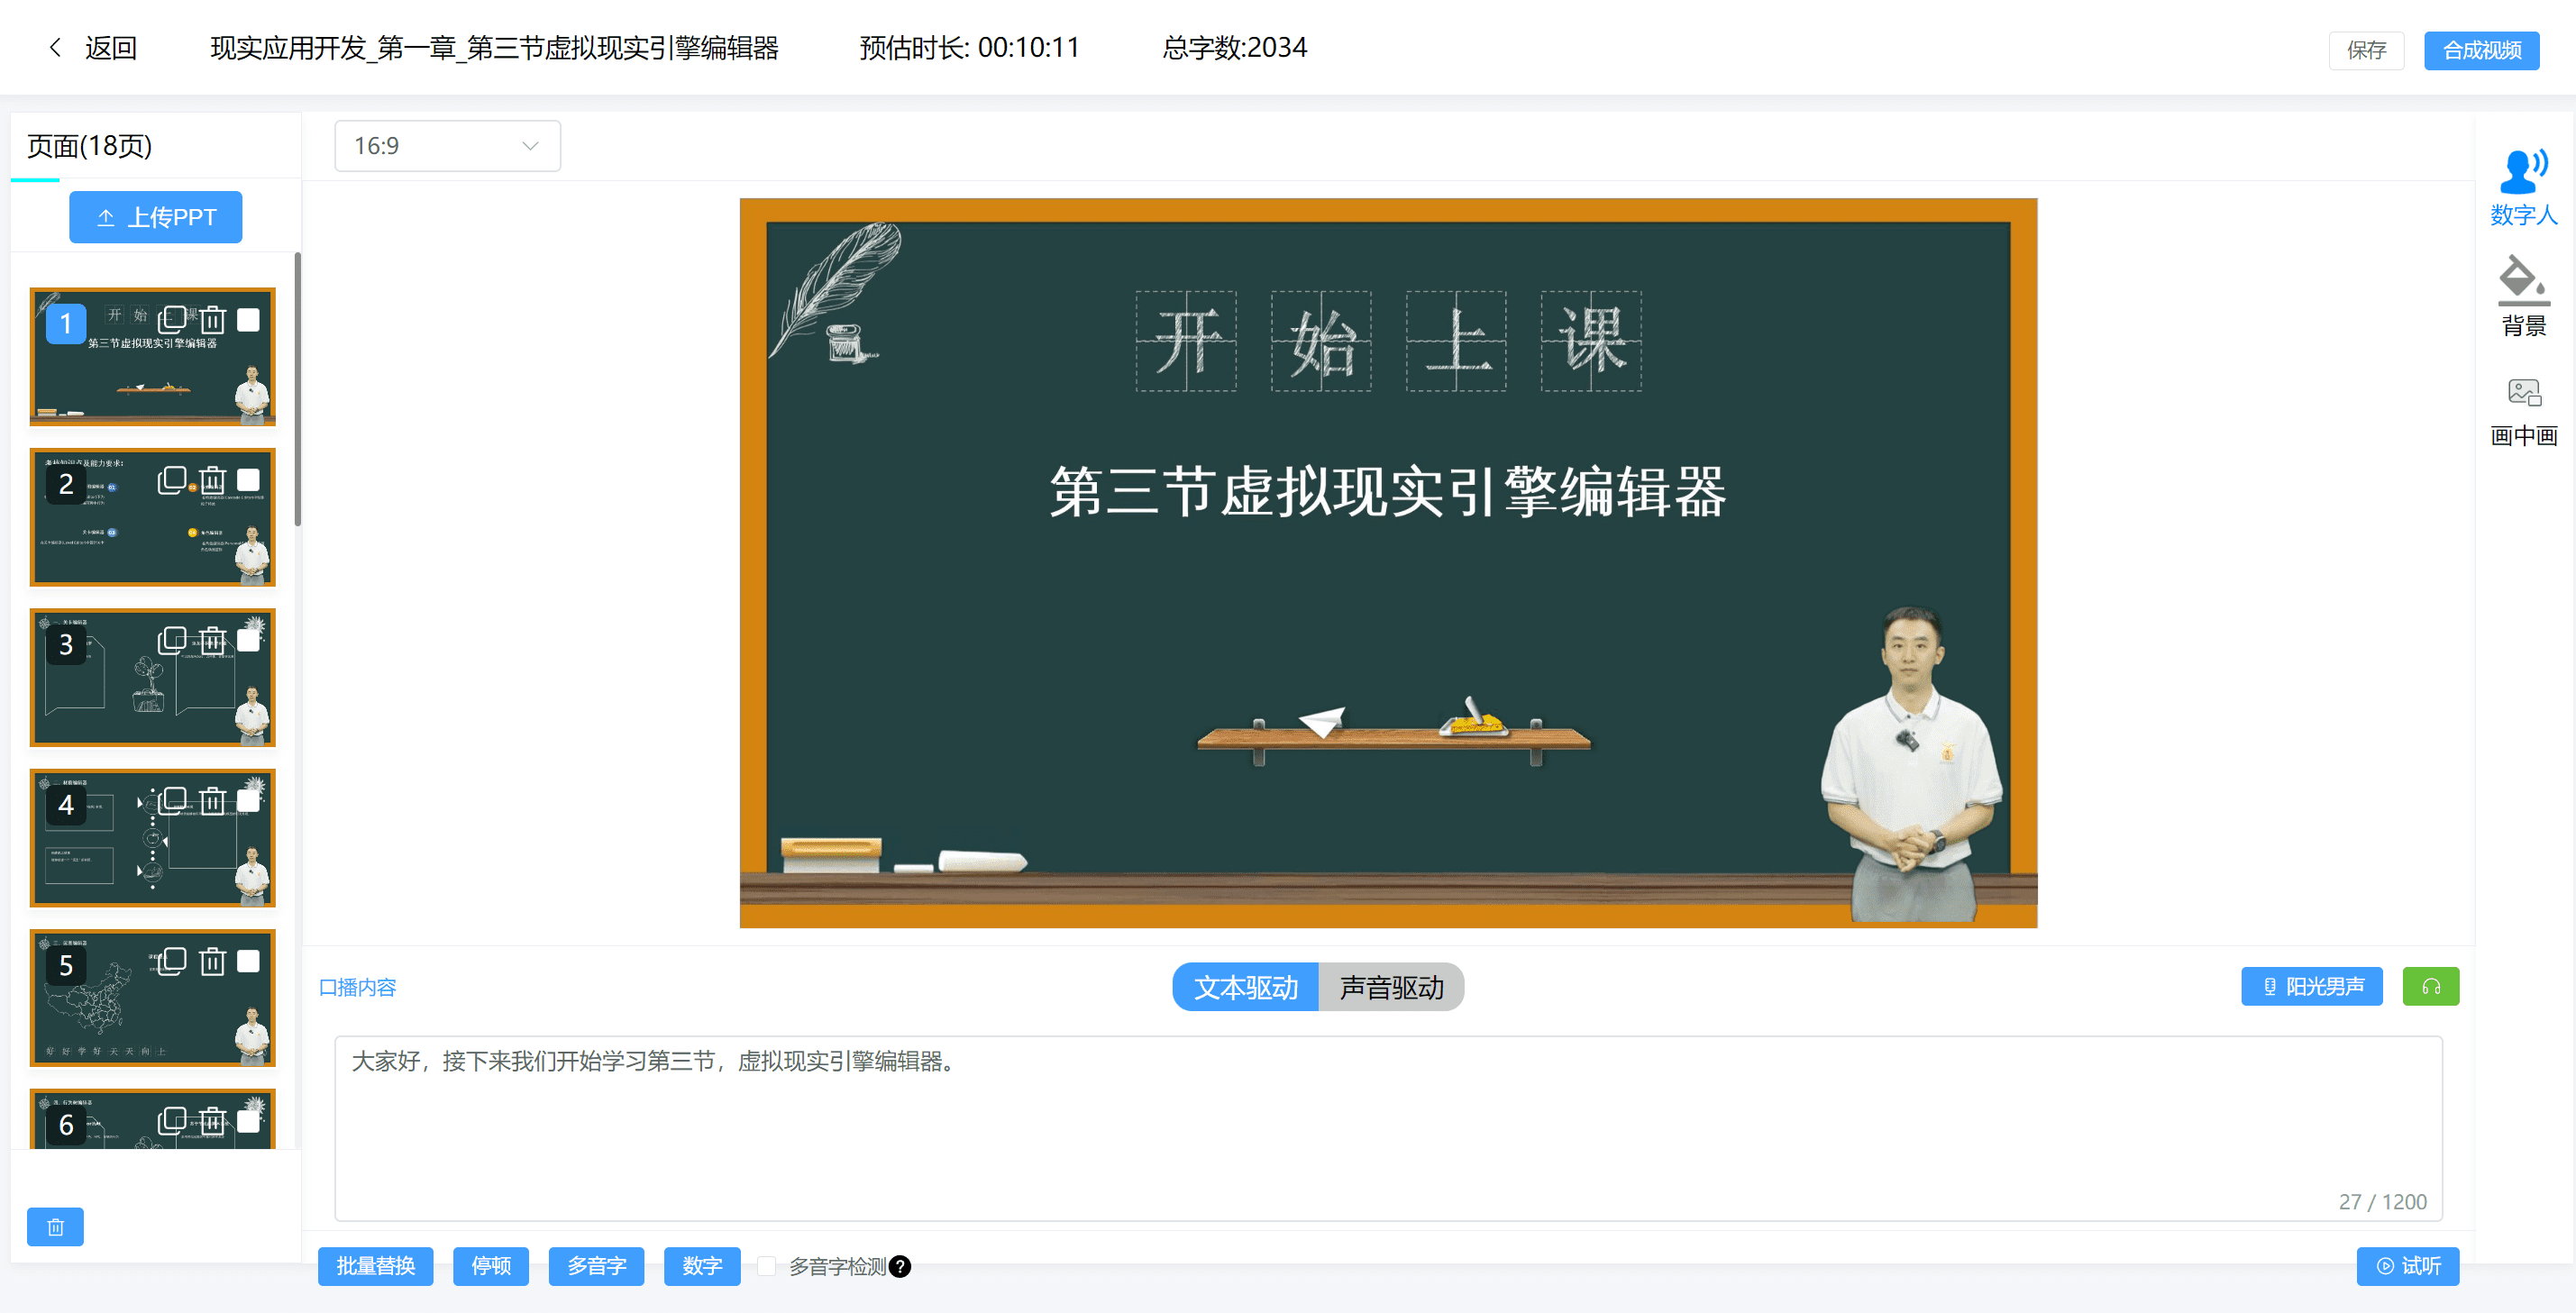
Easegen:开源数字人课程制作平台,PPT一键生成克隆数字人讲解视频

Easegen: 오픈 소스 디지털 휴먼 강의 제작 플랫폼, PPT 원클릭 생성 복제 디지털 휴먼 강의 영상

종합 소개 Easegen은 AI 기술을 통해 교육 콘텐츠 제작 및 관리의 효율성을 높이는 것을 목표로 하는 오픈 소스 디지털 휴먼 코스 제작 플랫폼입니다. 이 플랫폼은 코스 제작, 비디오 관리, 지능형 질문까지 원스톱 솔루션을 제공하여 사용자가 디지털 휴먼 설명 비디오 코스를 제작할 수 있도록 지원합니다.
2 년 전
0122.4K
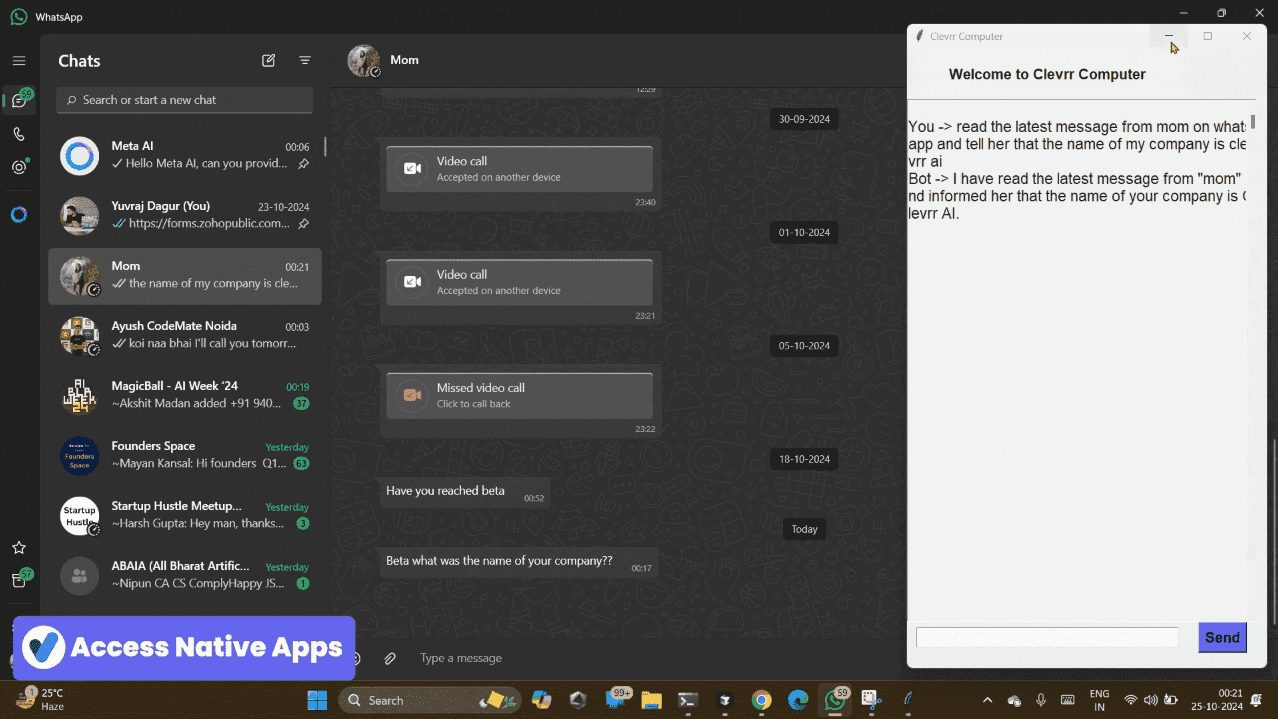
Clevrr Computer:使用 PyAutoGUI 库实现自动化桌面操作智能体

Clevrr 컴퓨터: PyAutoGUI 라이브러리를 사용한 데스크톱 조작 인텔리전스 자동화

일반 소개 Clevrr Computer는 PyAutoGUI 라이브러리를 사용하여 시스템 운영을 자동화하는 것을 목표로 하는 오픈 소스 프로젝트입니다. 이 프로젝트는 다음을 사용하여 정확하고 효율적으로 작업을 수행할 수 있는 자동화 에이전트를 설계하기 위해 Anthropic에서 영감을 받았습니다.
2 년 전
0122.4K
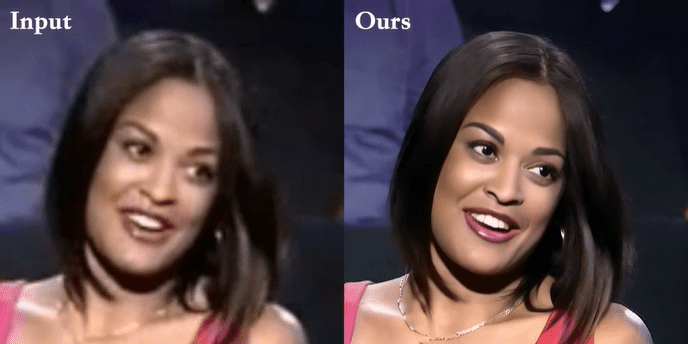
SVFR:实现视频人脸修复的统一框架,修复黑白、模糊的人像老视频

SVFR: 비디오 얼굴 복구, 흑백, 흐릿한 인물 오래된 비디오 복구를 구현하기 위한 통합 프레임워크

종합 소개 SVFR(안정적인 비디오 얼굴 복원)은 비디오 얼굴 복원을 위한 통합 프레임워크로, 기본 얼굴 복원(BFR), 컬러링, 복구 및 이들의 조합 작업을 지원합니다. 이 프레임워크는 제너레이티브 및 키네마틱 프리오어를 통합하여 활용합니다.
2 년 전
0122K
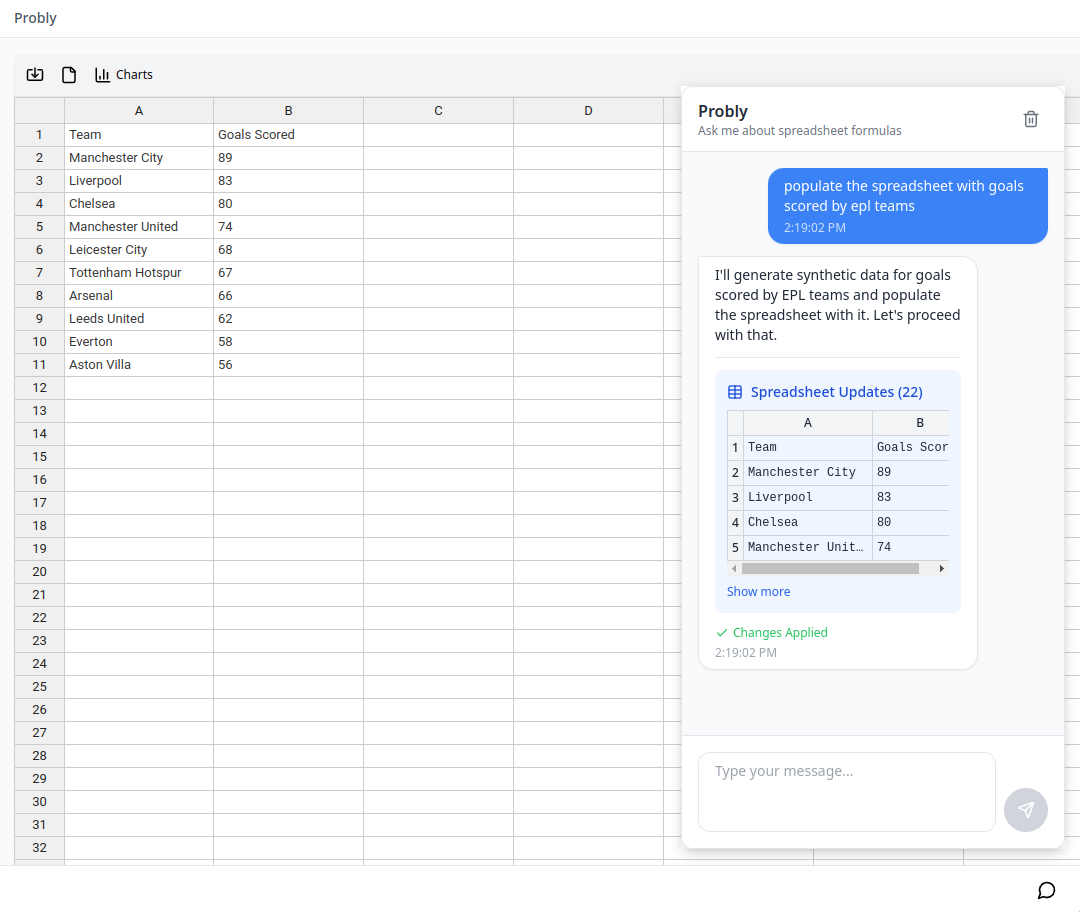
Probly:AI分析数据并生成图表的开源表格工具

아마도: 데이터를 분석하고 차트를 생성하는 AI를 위한 오픈 소스 표 형식 도구

포괄적인 소개 아마도 PragmaticMachineLearning 팀에서 개발하여 GitHub에서 오픈소스로 제공되는 스프레드시트 도구로, 기존 스프레드시트의 기능과 강력한 AI 데이터 분석 기능을 결합한 것입니다. 그것은 사용을 지원할 뿐만 아니라 ...
2 년 전
0121.9K
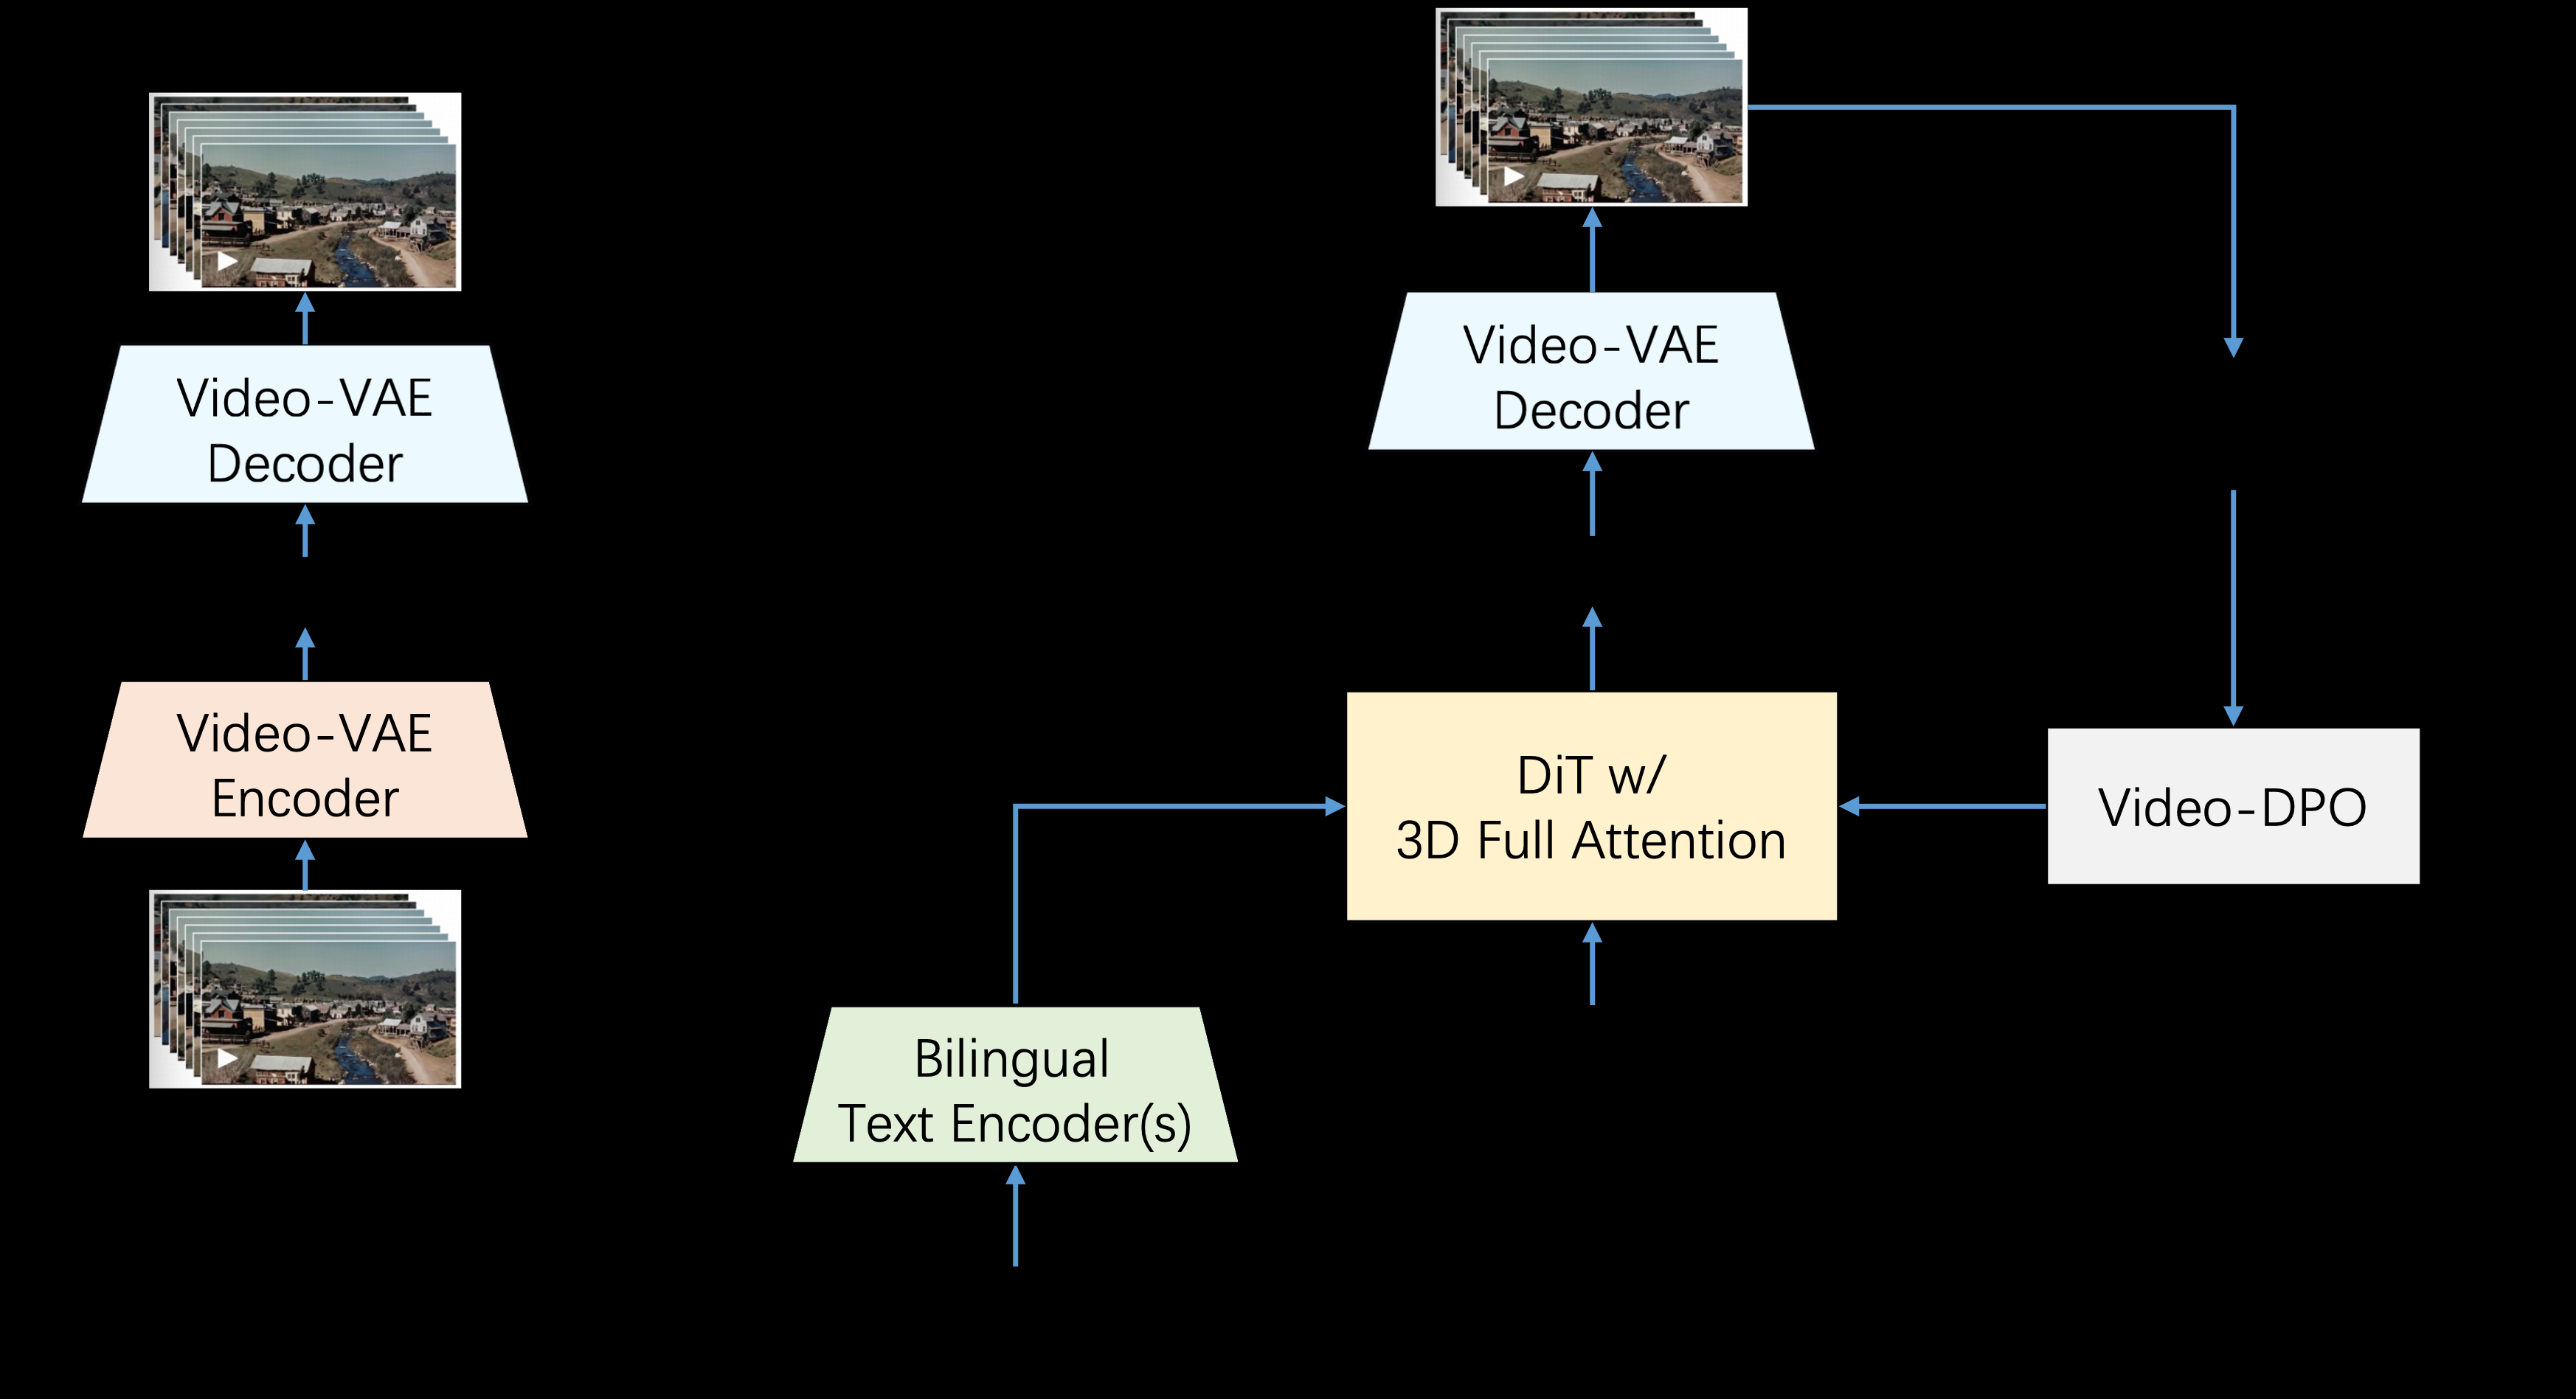
Step-Video-T2V:支持多语言输入和长视频生成的文生视频模型

Step-Video-T2V: 다국어 입력 및 긴 비디오 생성을 지원하는 Vincennes 비디오 모델

종합 소개 Step-Video-T2V는 StepFun AI(StepFun Star)의 고급 텍스트-비디오 변환 모델입니다. 이 모델에는 30억 개의 매개변수가 있으며 최대 204fps의 동영상을 생성할 수 있습니다. 고도로 압축된 가변 자동 인코더(VAE)를 통해 이 모델은 ...
2 년 전
0121.9K
Maestro:简化主流开源视觉语言模型微调过程的工具

Maestro: 주류 오픈 소스 비주얼 언어의 모델을 미세 조정하는 프로세스를 간소화하는 도구

종합 소개 Maestro는 Roboflow에서 멀티모달 모델을 미세 조정하는 과정을 단순화하고 가속화하여 누구나 자신만의 시각적 매크로 모델을 훈련할 수 있도록 개발한 도구입니다. 이 도구는 F와 같이 널리 사용되는 시각 언어 모델(VLM)을 미세 조정하기 위한 기성 레시피를 제공합니다.
2 년 전
0121.9K
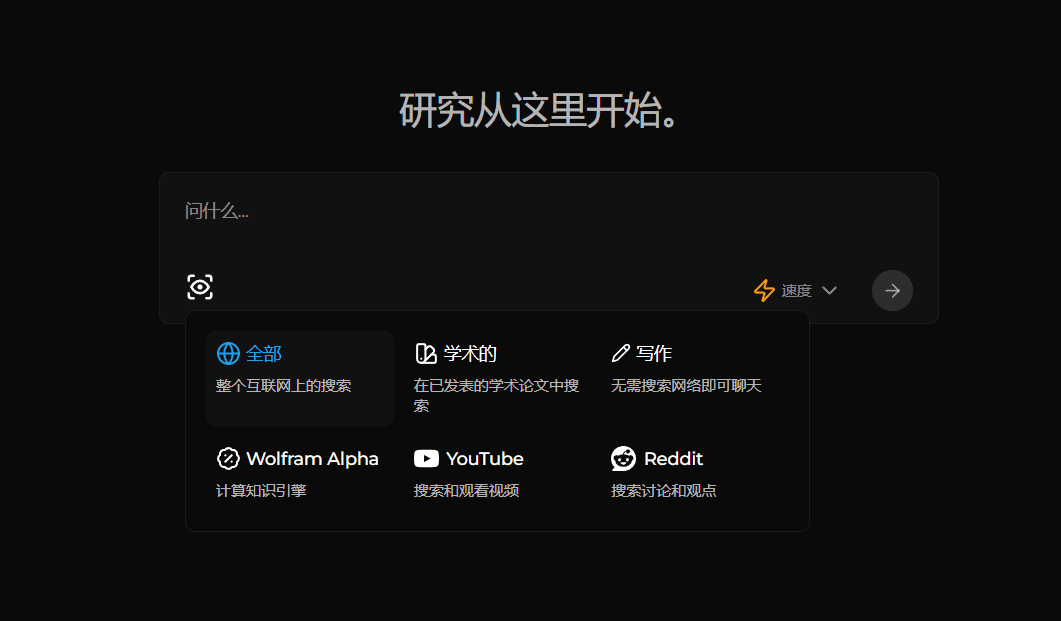
Perplexica:1比1复刻 Perplexity AI 功能和界面的开源AI搜索引擎

퍼플렉시카: 퍼플렉시 AI의 기능과 인터페이스를 1:1로 복제하는 오픈 소스 AI 검색 엔진

일반 소개 퍼플렉시카는 인터넷을 깊이 파고드는 답변을 제공하도록 설계된 오픈 소스 AI 기반 검색 엔진입니다. 유사성 검색 및 임베딩 기술과 같은 고급 머신 러닝 알고리즘을 사용하여 검색 결과를 최적화하고 인용된 출처와 함께 명확한 답변을 제공합니다.
2 년 전
0121.8K
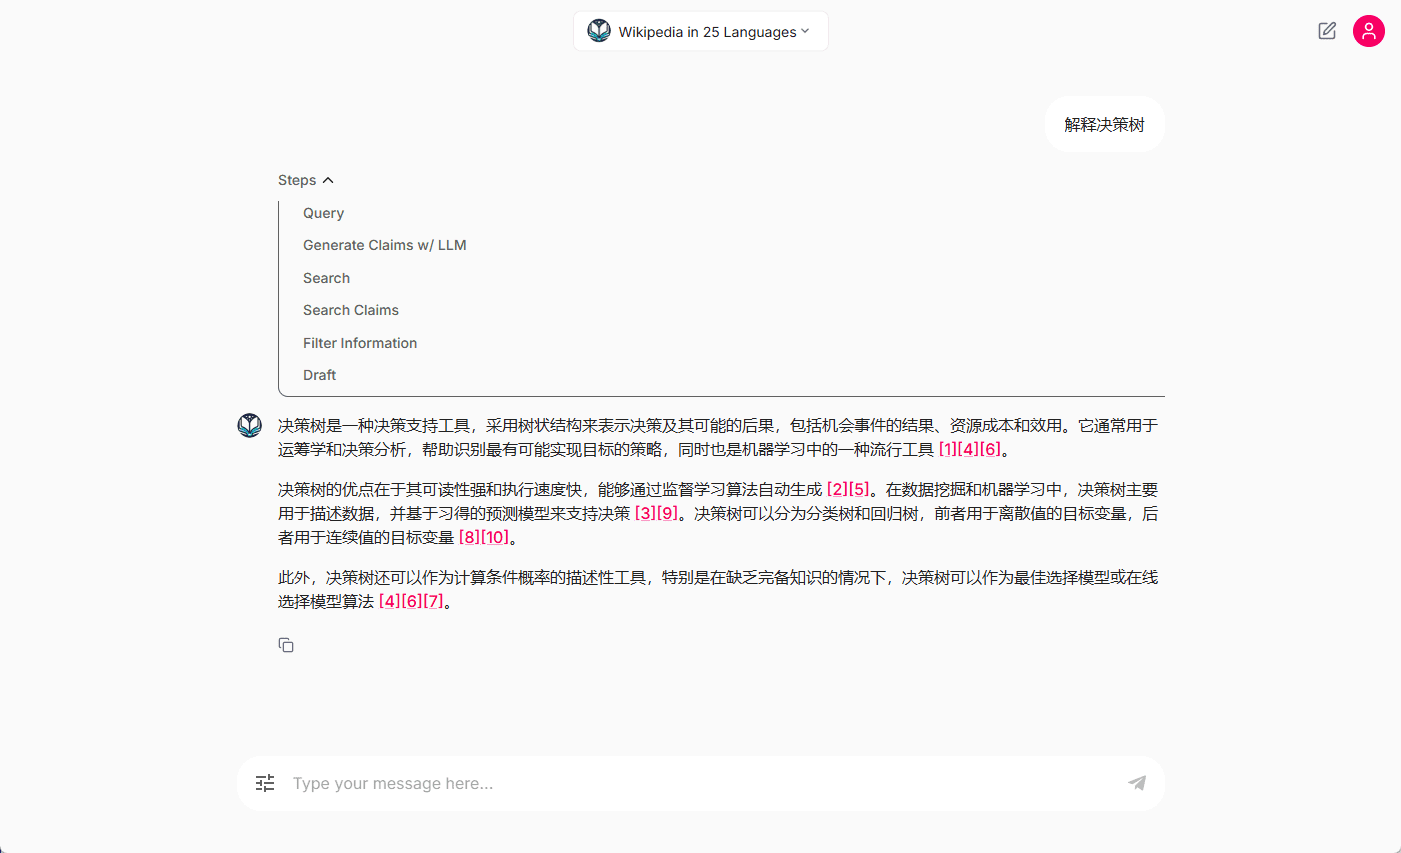
WikiChat:使用维基百科数据检索知识的聊天工具

WikiChat: Wikipedia 데이터를 사용하여 지식을 검색할 수 있는 채팅 도구

일반 소개 위키챗은 스탠포드 대학교에서 개발한 실험적인 챗봇으로, 위키백과에서 데이터를 검색하여 대규모 언어 모델의 사실성을 개선하는 것을 목표로 합니다. 대규모 언어 모델(예: ChatGPT 및 GPT-4)은 최신 정보나 덜 인기 있는 주제를 처리하는 경향이 있습니다.
2 년 전
0121.7K
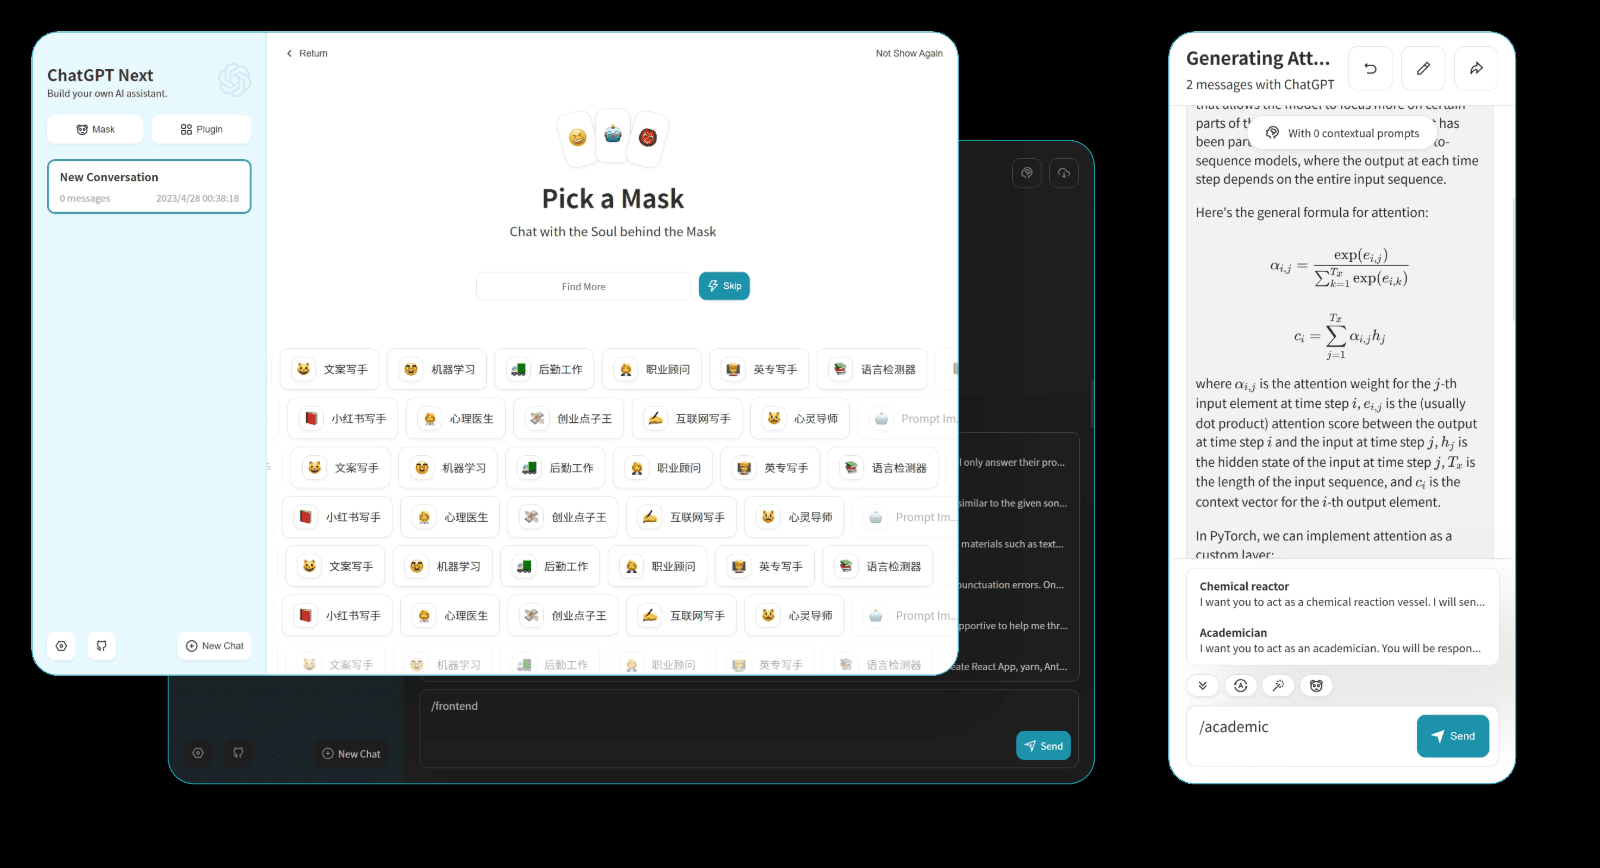
NextChat:兼容多平台的本地化AI聊天助手

NextChat: 여러 플랫폼과 호환되는 현지화된 AI 채팅 도우미

일반 소개 NextChat은 사용자가 GPT-3, GPT-4, GPT-4.5 및 Gemini Pro와 같은 동급 최고의 언어 모델을 사용하여 채팅 서비스를 배포할 수 있는 혁신적인 AI 채팅 서비스입니다. 우아한 사용자 인터페이스, 공동 작업 기능, 통합, 템플릿 및 ...
2 년 전
0121.7K
Dify-Plus:为Dify开发的企业内部管理后台

Dify-Plus: Dify를 위한 온프레미스 관리 백엔드

포괄적인 소개 Dify-Plus는 Dify 오픈 소스 프로젝트의 2차 개발을 기반으로 하는 AI 애플리케이션 개발 플랫폼입니다. Dify에 기반한 새로운 관리 센터를 추가하고 기업 시나리오에 맞게 기능을 최적화합니다. 이 프로젝트는 처음에 기업 내부용으로 개발되었으나 나중에 커뮤니티에도 비슷한 요구가 있다는 것을 알게 되었습니다.
2 년 전
0121.6K
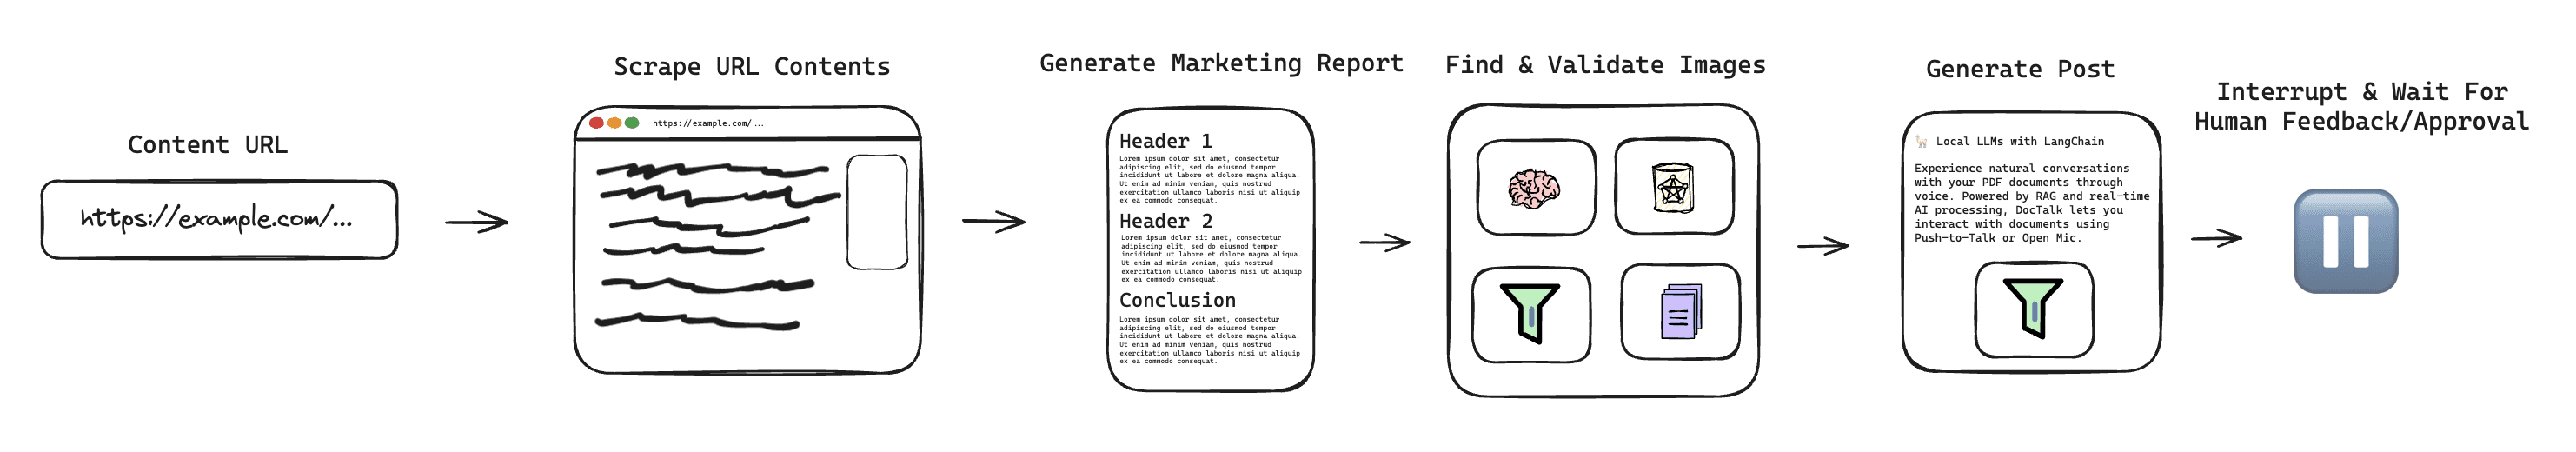
Social Media Agent:社交媒体智能助手,自动生成和管理社交媒体内容

소셜 미디어 에이전트: 소셜 미디어 콘텐츠를 자동으로 생성하고 관리하는 소셜 미디어용 지능형 어시스턴트

일반 소개 소셜 미디어 에이전트는 사용자가 소셜 미디어 콘텐츠의 생성 및 관리를 자동화할 수 있도록 설계된 새로운 에이전트 인박스로 상호 작용 정보를 관리하는 오픈 소스 프로젝트입니다. 이 프로젝트는 LangChain 팀에 의해 개발되었습니다...
2 년 전
0121.6K
LongWriter:智谱推出生成超长文本的强大模型,支持一次对话生成10000+字

롱라이터: 위즈덤 스펙트럼은 매우 긴 텍스트를 생성하는 강력한 모델을 출시하여 단일 대화에서 10,000개 이상의 단어를 생성할 수 있도록 지원합니다.

종합 소개 LongWriter는 칭화대학교 데이터 마이닝 연구 그룹(THUDM)에서 개발한 강력한 긴 텍스트 생성 도구입니다. 이 도구는 고급 장문 언어 모델(LLM)을 기반으로 하며 10,000단어 이상의 긴 텍스트를 생성할 수 있습니다.LongWriter...
2 년 전
0121.5K
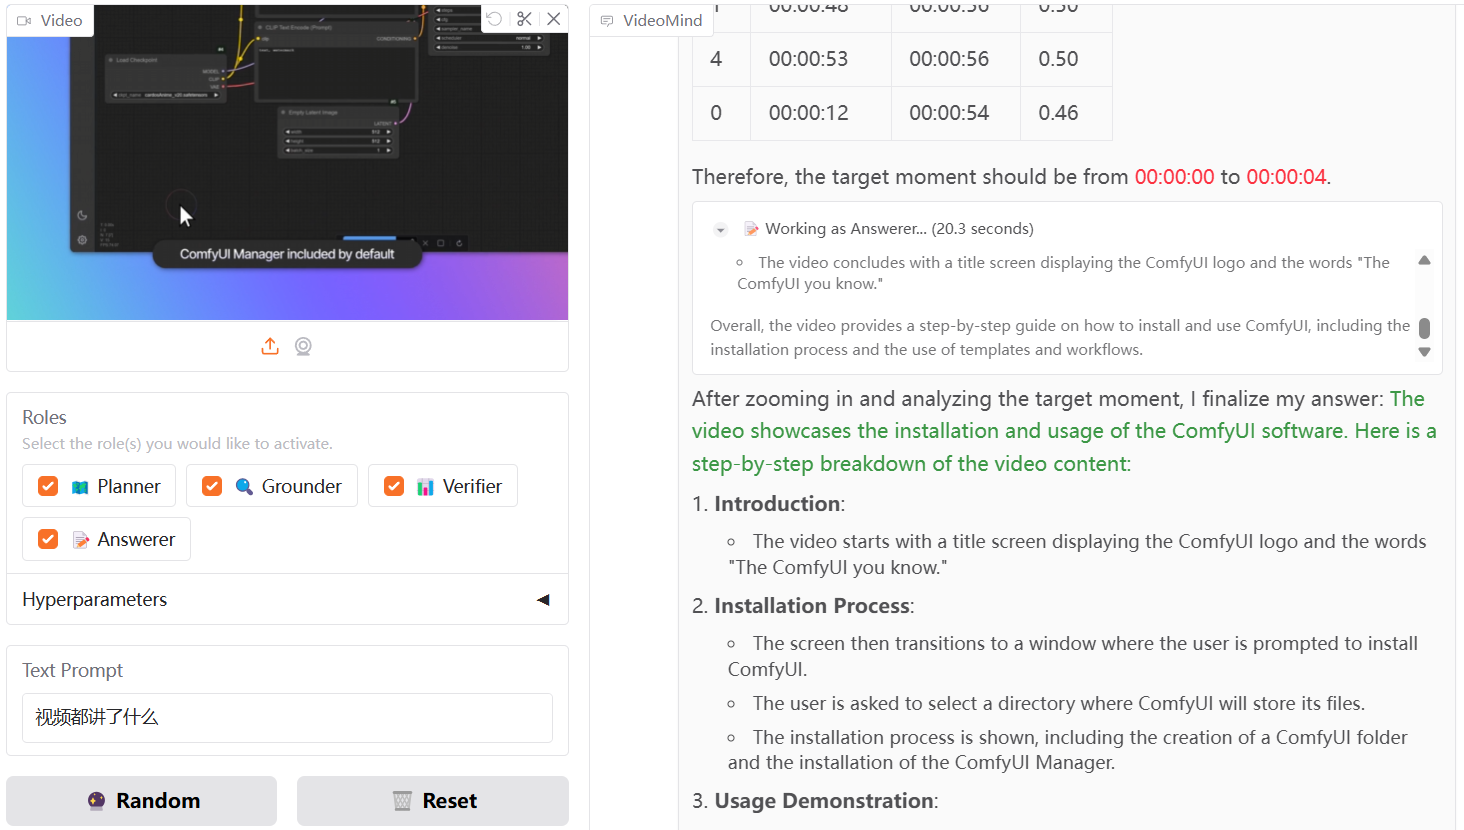
VideoMind:视频按时间戳定位内容与问答的开源项目

VideoMind: 타임스탬프별 동영상 포지셔닝 콘텐츠 및 Q&A 오픈 소스 프로젝트

일반 소개 비디오마인드는 긴 동영상을 위한 추론, Q&A 및 요약 생성에 중점을 둔 오픈 소스 멀티모달 AI 도구입니다. 홍콩 폴리테크닉 대학교의 예 리우와 싱가포르 국립대학교의 쇼 랩 팀이 개발했습니다. 이 도구는 비디오에 대한 인간의 이해를 모방합니다...
1 년 전
0121.5K
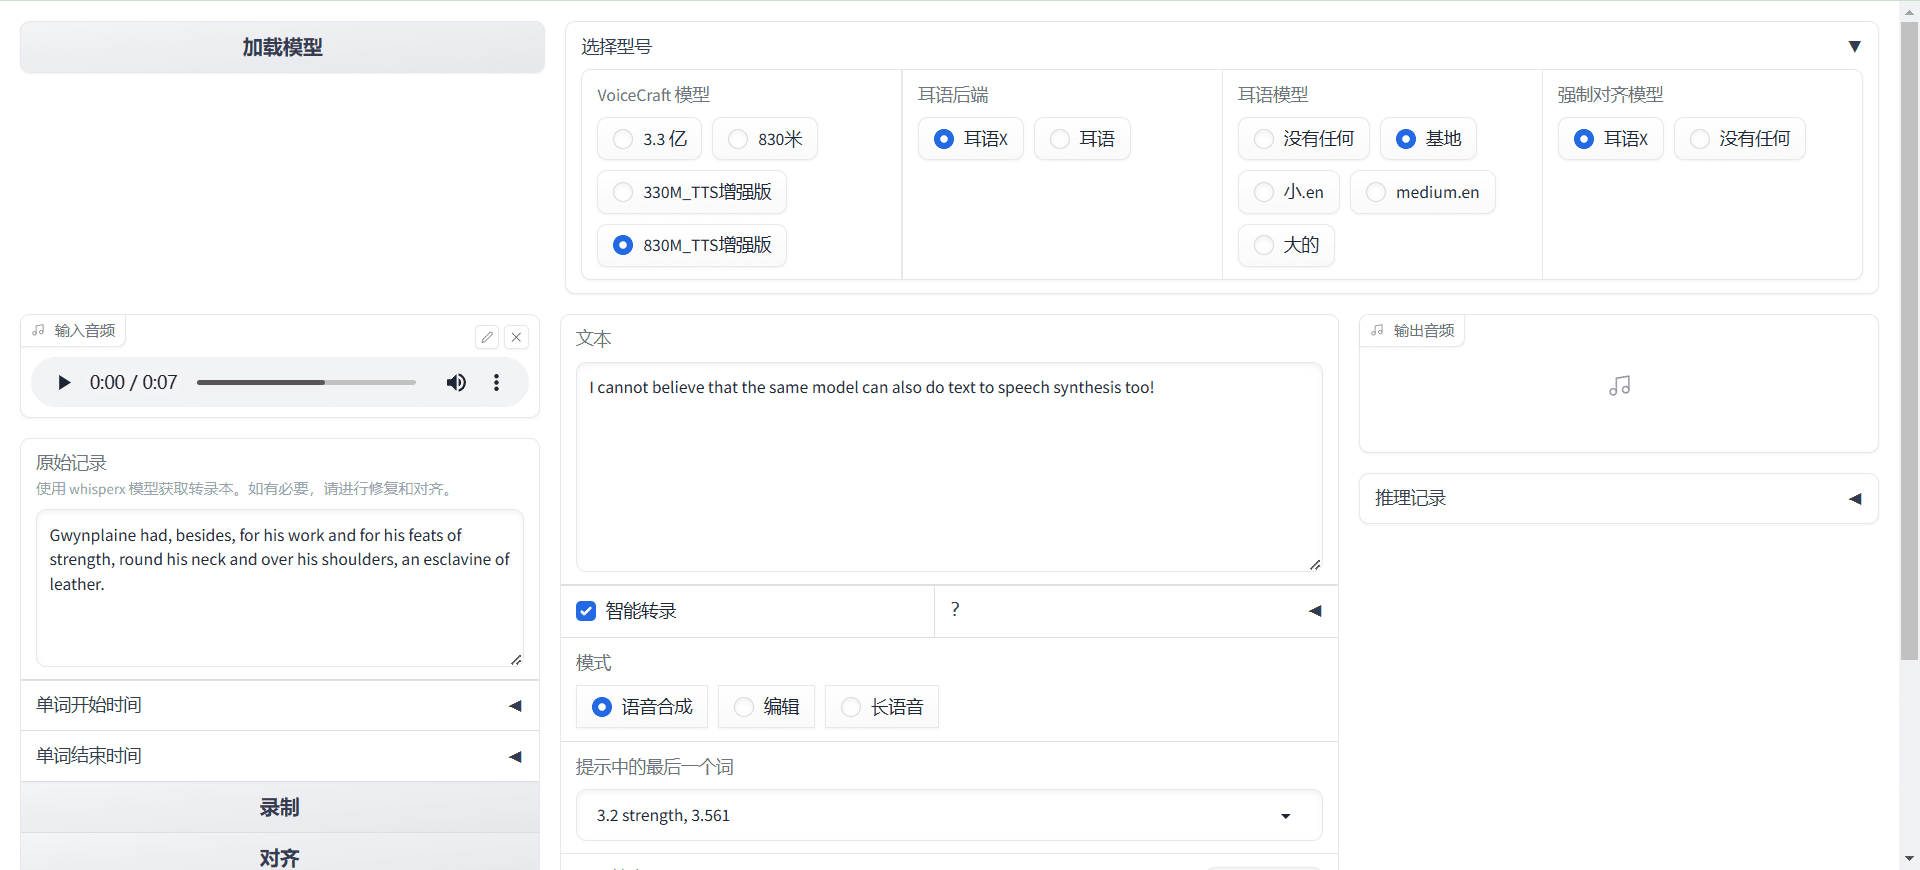
VoiceCraft:开源零样本语音克隆与文本转语音工具

VoiceCraft: 오픈 소스 제로 샘플 음성 복제 및 텍스트 음성 변환 도구

개요 VoiceCraft는 신경 코덱 언어 모델을 기반으로 하는 오픈 소스 음성 편집 및 제로 샘플 음성 합성 툴입니다. 기존 음성 시퀀스에 대한 삽입, 삭제 및 교체 작업을 가능하게 하는 혁신적인 코드화된 시퀀스 생성 방법을 사용하여 자연스럽고 일관된 편집 음성을 생성할 수 있습니다.
2 년 전
0121.5K
Open Deep Research:LangChain开源的深度研究智能助手

오픈 딥 리서치: 심층 연구를 위한 LangChain의 오픈 소스 지능형 비서

종합 소개 Open Deep Research는 모든 주제에 대한 종합적인 연구 보고서를 생성할 수 있는 웹 기반 연구 도우미입니다. 이 시스템은 사용자가 시간이 많이 걸리는 연구 단계로 넘어가기 전에 보고서 구조를 계획하고 검토할 수 있는 계획 및 실행 워크플로우를 사용합니다....
2 년 전
0121.4K
Cosmos:世界基础模型,构建物理世界的人工智能基础模型平台

코스모스: 세계 기본 모델, 물리적 세계의 AI 기본 모델을 구축하기 위한 플랫폼

포괄적인 소개 NVIDIA Cosmos는 개발자를 위한 월드 기반 모델링 플랫폼으로, 물리 AI 개발자가 물리 AI 시스템을 더 빠르고 효율적으로 구축할 수 있도록 특별히 설계되었습니다. 이 플랫폼은 확산 및 자동 회귀 월드 기반 등 다양한 사전 훈련된 모델을 제공합니다.
2 년 전
0121.4K
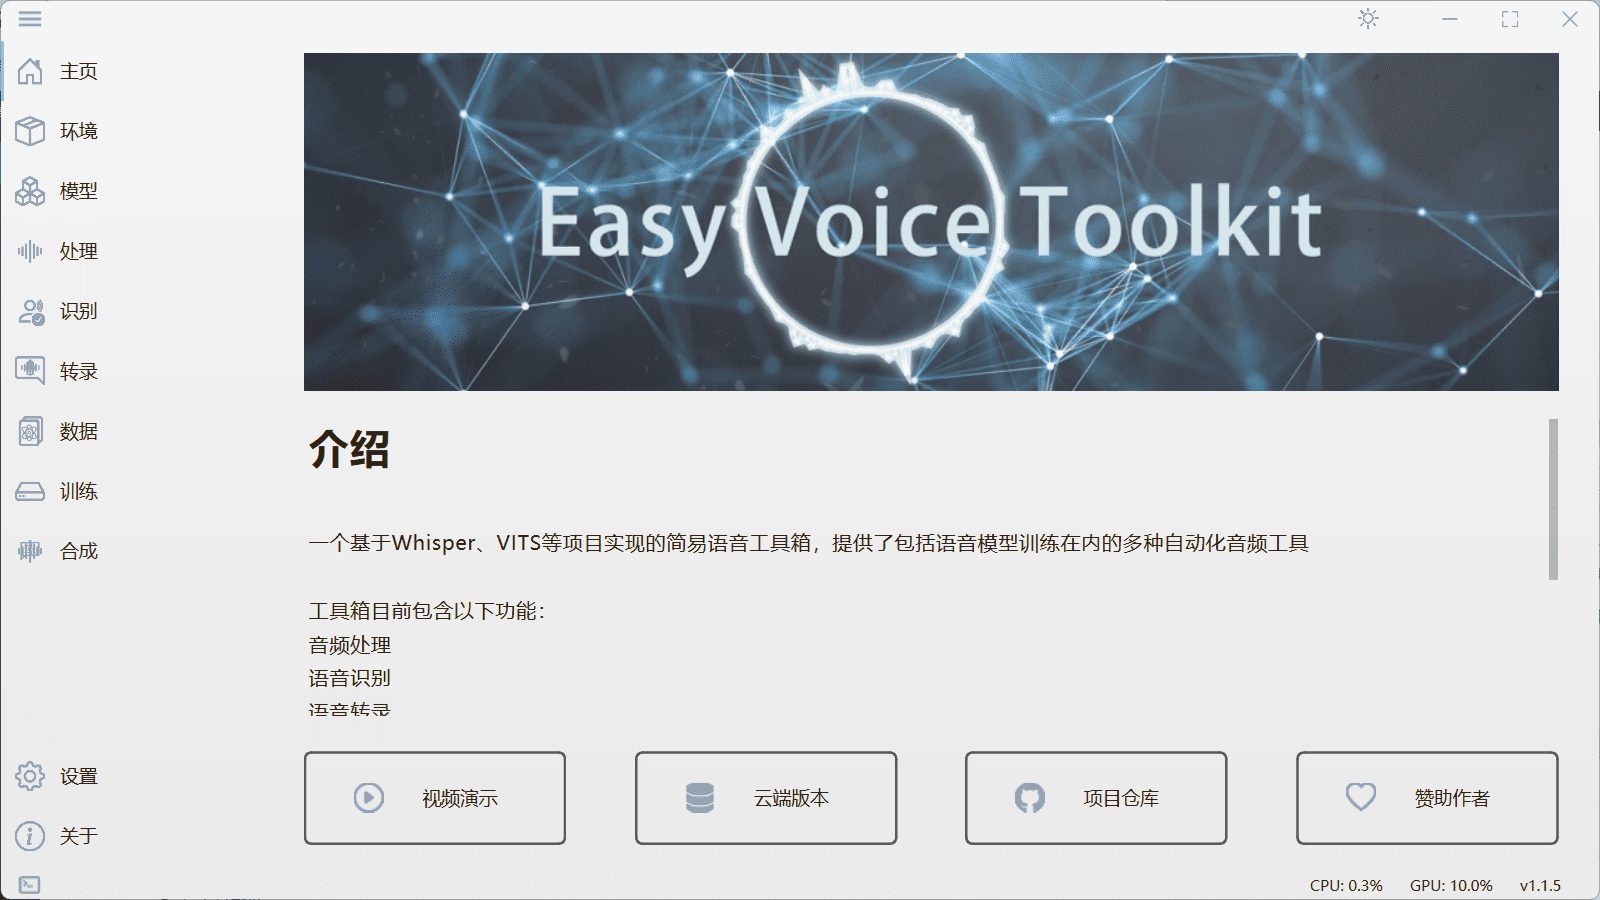
Easy Voice Toolkit:本地部署的AI语音工具箱

간편한 음성 툴킷: 로컬 배포를 위한 AI 음성 툴킷

개요 Easy-Voice-Toolkit은 오픈 소스 음성 프로젝트에 기반한 다기능 툴킷으로 음성 인식, 음성 전사, 음성 변환, 데이터 세트 생성 및 모델 학습을 위한 다양한 자동화된 오디오 도구를 제공합니다. 사용자는 필요에 따라 이러한 도구를 선택적으로 사용할 수 있습니다...
2 년 전
0121.3K
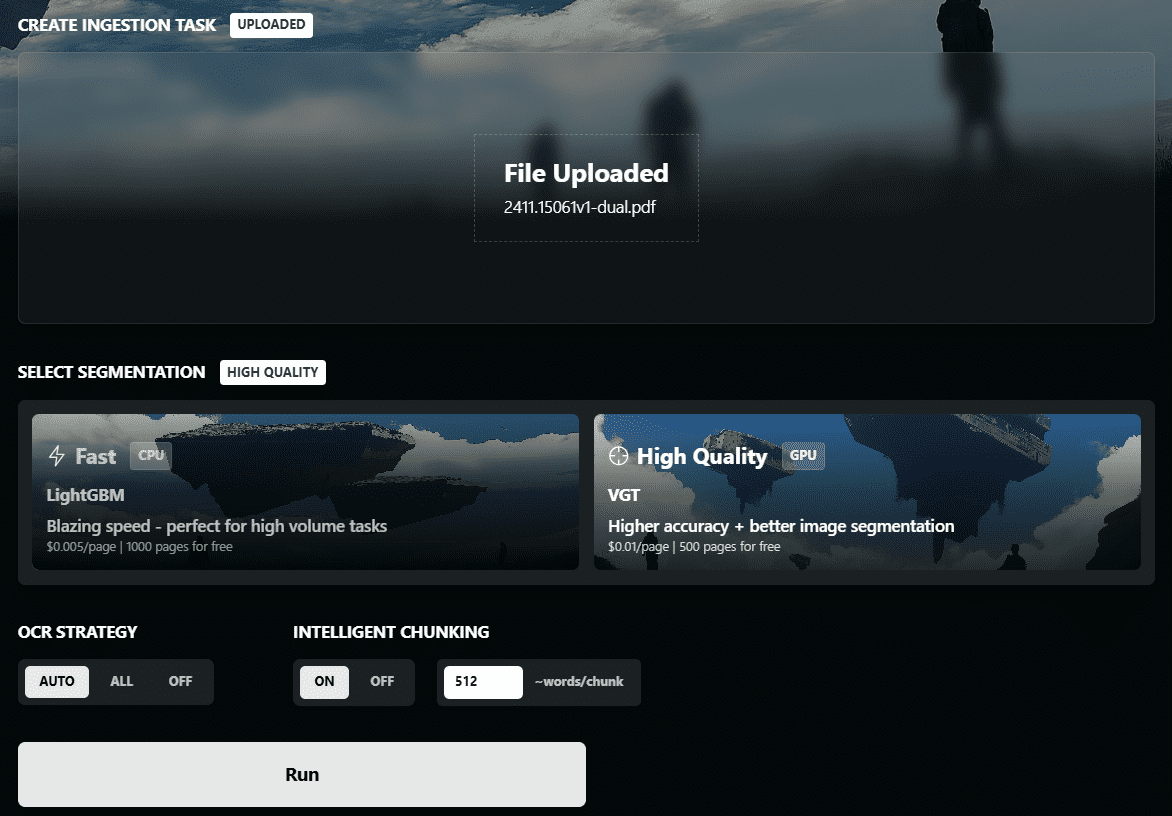
Chunkr:使用视觉模型进行文档摄取以及根据文本段落层级智能分块的一体化服务

Chunkr: 시각적 모델을 사용해 문서를 수집하고 텍스트 단락 계층 구조를 기반으로 지능형 청킹을 수행하는 올인원 서비스입니다.

일반 소개 Chunkr는 PDF, PPTX, DOCX 및 Excel 파일을 RAG(검색 증강 생성) 및 LLM(대규모 언어 모델링)에 사용하기 적합한 데이터로 변환하는 데 전용으로 사용되는 자체 호스팅 API입니다. 이 프로젝트는 Lumina에서 개발했습니다...
2 년 전
0121.3K
Infinity:生成高分辨率图像的比特自回归建模,实现无限制高分辨率图像生成

무한대: 무제한 고해상도 이미지 생성을 위한 고해상도 이미지 생성의 비트 단위 자동 회귀 모델링

일반 소개 Infinity는 FoundationVision 팀에서 개발한 획기적인 고해상도 이미지 생성 프레임워크입니다. 이 프로젝트는 혁신적인 비트 레벨의 시각적 자동 회귀 모델링 접근 방식을 통해 기존 이미지 생성 모델의 한계를 극복합니다.Infinity의 핵심 기능은 다음과 같습니다.
2 년 전
0121.2K
ai-gradio:轻松集成多种AI模型,基于Gradio构建多模态应用

ai-gradio: Gradio를 기반으로 여러 AI 모델을 쉽게 통합하고 멀티모달 애플리케이션을 구축하세요.

일반 소개 ai-gradio는 개발자가 여러 AI 모델을 쉽게 통합하고 사용할 수 있도록 설계된 오픈 소스 Python 툴킷입니다. Gradio를 기반으로 구축된 이 프로젝트는 여러 AI 모델과 서비스를 지원하기 위한 통합 인터페이스를 제공합니다. 텍스트, 음성, 동영상 등 어떤 데이터든...
2 년 전
0121.1K
GAG:利用大模型模拟人类行为生成社交关系图谱

GAG: 대규모 모델을 사용하여 인간 행동 시뮬레이션을 위한 사회적 관계 그래프 생성하기

일반 소개 GraphAgent는 GitHub에서 호스팅되고 Ji-Cather가 개발한 오픈 소스 프레임워크입니다. 대규모 언어 모델(LLM)을 사용하여 인간의 행동을 시뮬레이션하고 텍스트 속성을 가진 동적인 소셜 그래프를 생성합니다. 이 도구는 온라인 소셜 미디어에 적합합니다...
2 년 전
0121K
PantoMatrix(EMAGE):全身手势生成框架,从音频生成全身手势的3D动画框架

판토매트릭스(EMAGE): 전신 제스처 생성 프레임워크, 오디오에서 전신 제스처를 생성하는 3D 애니메이션 프레임워크

종합 소개 판토매트릭스는 얼굴, 신체 일부, 손, 전신 움직임을 포함한 오디오 및 부분 제스처로부터 사람의 완전한 움직임을 생성할 수 있는 고급 전신 제스처 생성 프레임워크입니다. 이 프레임워크는 최신 멀티모달 데이터 세트와 딥러닝 기술을 활용하여 고품질의 3D...
2 년 전
0120.9K
E2B Open Computer Use:E2B沙盒中安全的运行AI操作系统

E2B 개방형 컴퓨터 사용: E2B 샌드박스에서 안전하게 AI 운영 체제 실행하기

일반 소개 E2B 개방형 컴퓨터 사용은 E2B 데스크톱 샌드박스를 통해 안전한 클라우드 기반 리눅스 컴퓨터 사용 경험을 제공하는 것을 목표로 하는 오픈 소스 프로젝트로, E2B 샌드박스는 사용자가 모든 대형 컴퓨터에 연결할 수 있는 데스크톱 그래픽 환경을 제공합니다.
2 년 전
0120.9K
Vision Agent:解决多种视觉目标检测任务的视觉智能体

비전 에이전트: 다양한 시각적 표적 감지 작업을 해결하는 시각적 인텔리전스

일반 소개 비전 에이전트는 랜딩AI(팀 엔다 우)가 개발하고 GitHub에서 호스팅하는 오픈 소스 프로젝트로, 사용자가 컴퓨터 비전 작업을 해결하기 위한 코드를 빠르게 생성할 수 있도록 설계되었습니다. 고급 에이전트 프레임워크와 멀티모달 모델을 사용합니다...
2 년 전
0120.8K
TestDriver:使用AI自动测试软件的智能工具

TestDriver: AI를 사용하여 소프트웨어 테스트를 자동화하는 스마트 도구

일반 소개 TestDriver는 인공 지능 기술을 사용하여 개발자가 소프트웨어를 테스트할 수 있도록 도와주는 웹사이트입니다. 마우스를 클릭하거나 텍스트를 입력하는 등 사람의 동작을 시뮬레이션하여 소프트웨어 테스트 작업을 자동화합니다. 이 사이트의 중심에는 실제 사람처럼 작동하는 'AI 에이전트를 사용하는 컴퓨터'가 있습니다....
2 년 전
0120.8K
MoshiVis:实时语音对话和图像理解的开源模型

MoshiVis: 실시간 음성 대화 및 이미지 이해를 위한 오픈 소스 모델

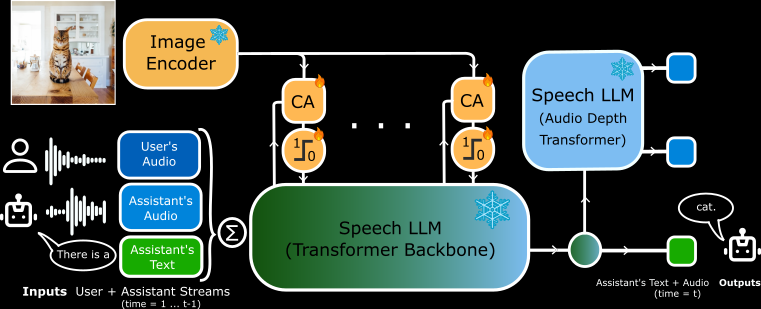
일반 소개 모시비스는 규타이 연구소에서 개발하여 깃허브에서 호스팅하는 오픈 소스 프로젝트입니다. 약 2억 6천 6백만 개의 새로운 적응 매개변수와 고정된 Pal...을 갖춘 Moshi 음성-텍스트 모델(7B 매개변수)을 기반으로 합니다.
2 년 전
0120.7K
Diffbot GraphRAG LLM:依赖外部实时知识图谱数据的LLM推理服务

Diffbot GraphRAG LLM: 외부 실시간 지식 그래프 데이터에 기반한 LLM 추론 서비스

종합 소개 Diffbot LLM Reasoning Server는 LLama 모델 아키텍처를 기반으로 특별한 최적화와 개선이 이루어진 혁신적인 대규모 언어 모델링 시스템입니다. 이 프로젝트의 가장 중요한 특징은 실시간 지식 그래프와 검색 기능이 강화된 생성 기능을 통합한 것입니다.
2 년 전
0120.7K
Data Formulator:AI驱动的数据可视化工具

데이터 포뮬레이터: AI 기반 데이터 시각화 도구

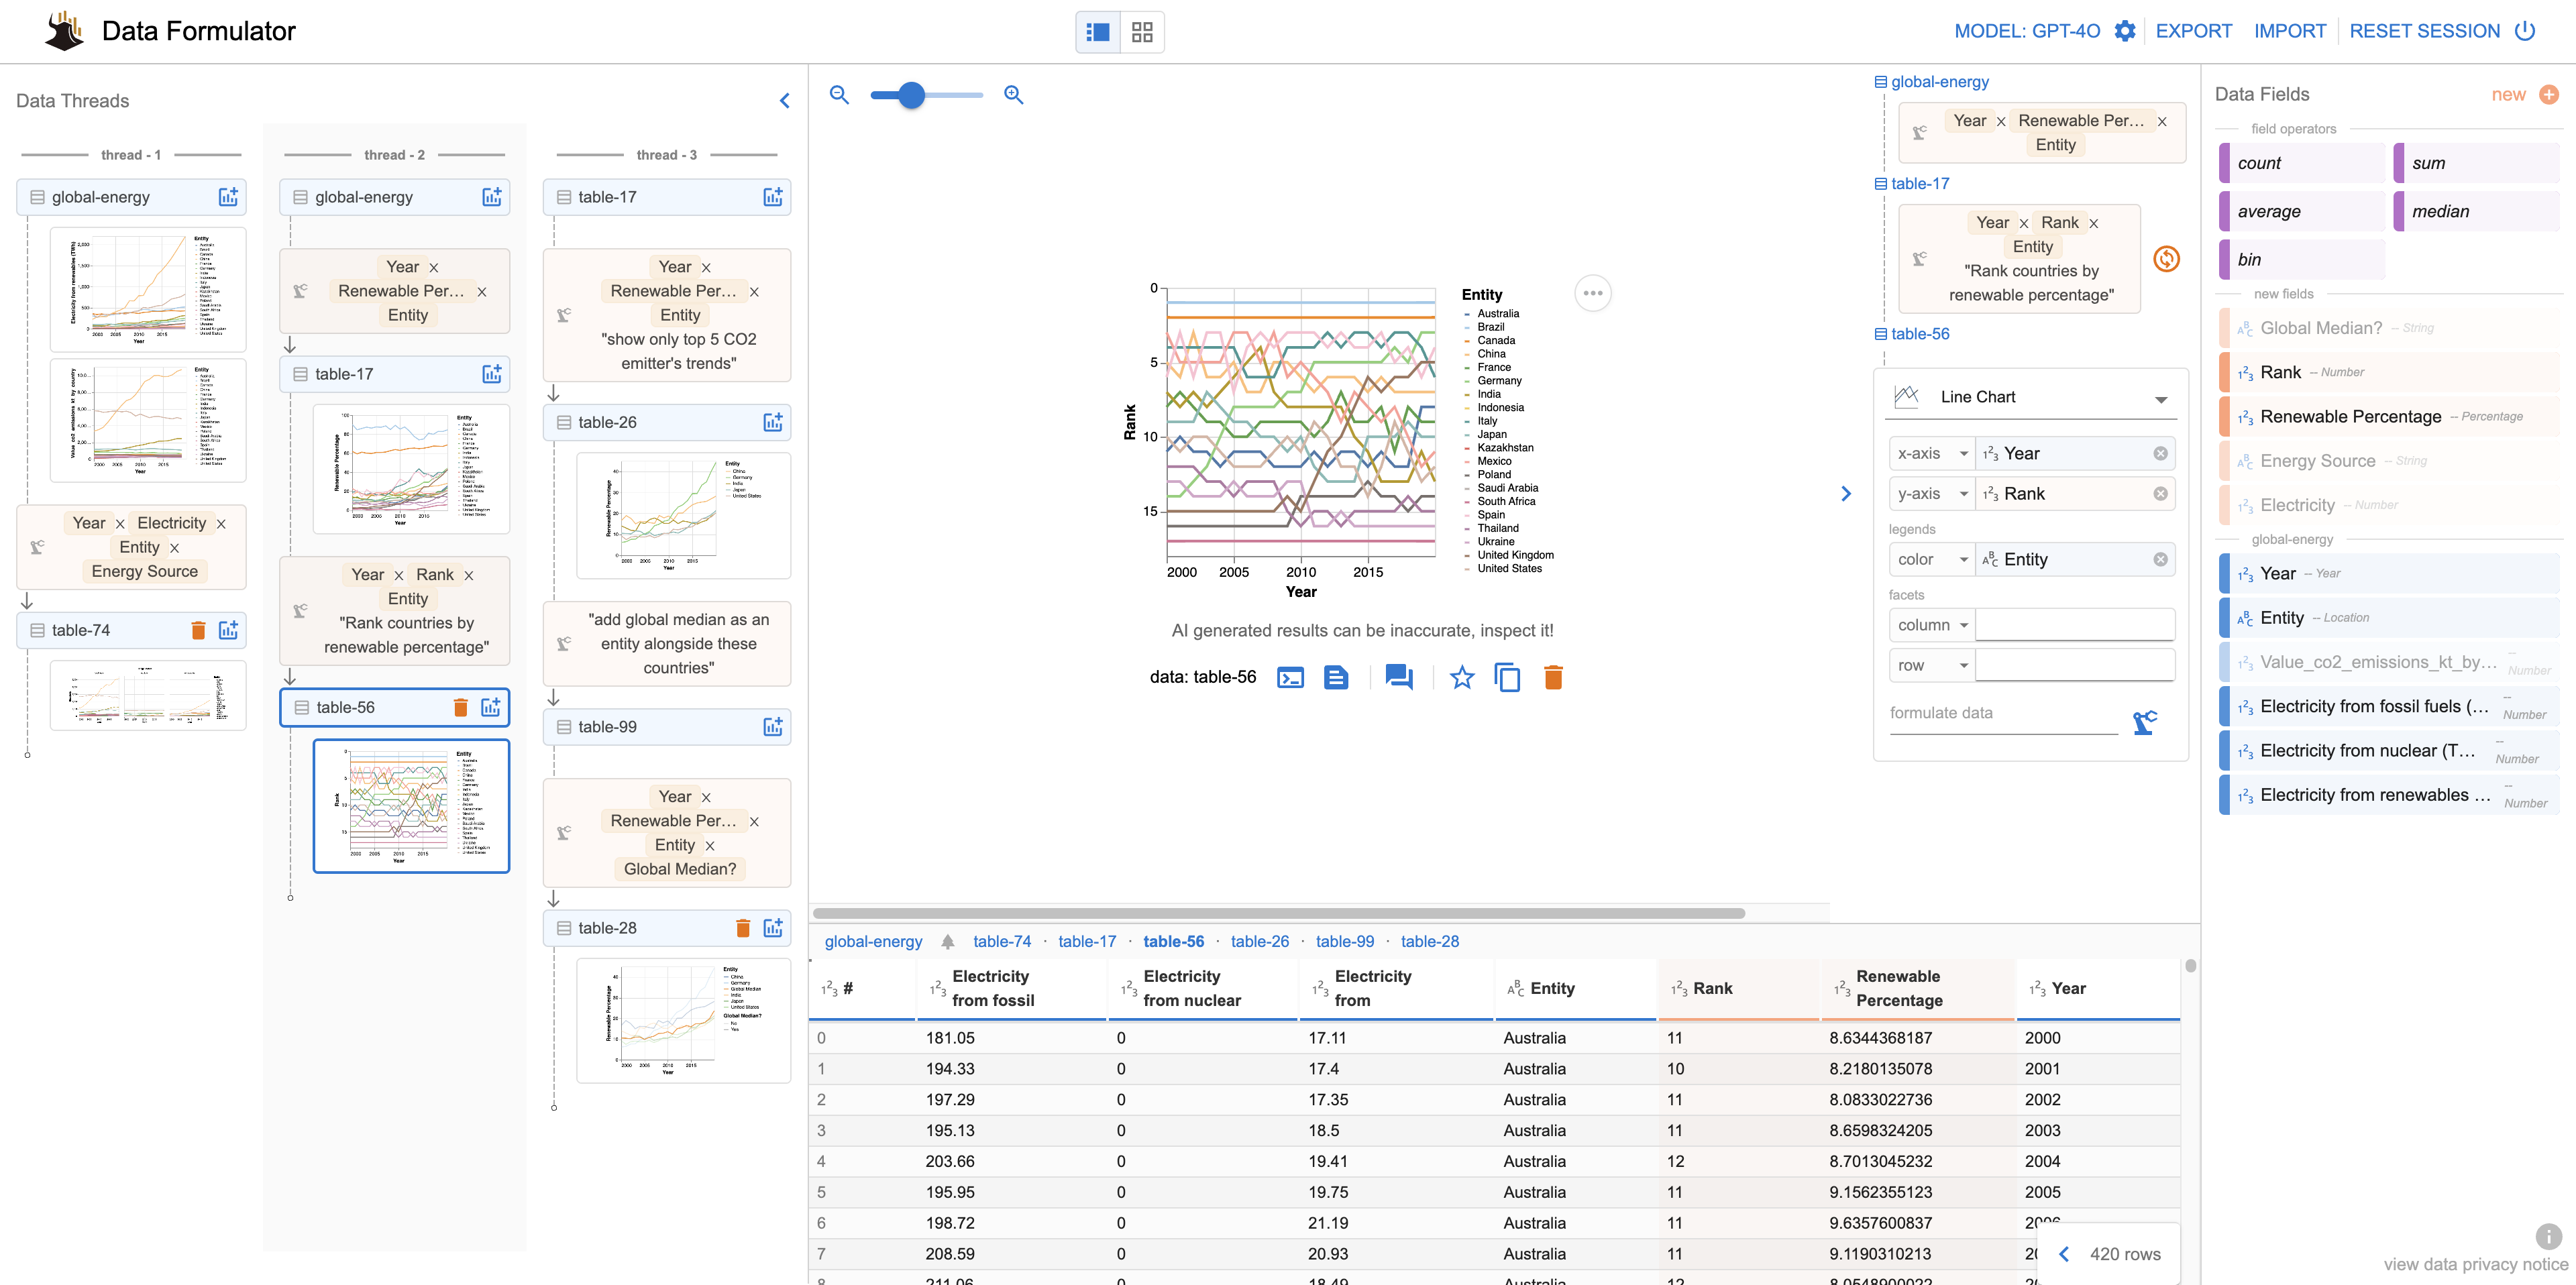
일반 소개 데이터 포뮬레이터는 Microsoft Research에서 개발한 오픈 소스 AI 기반 데이터 시각화 도구입니다. 이 도구는 그래픽 사용자 인터페이스(GUI)와 자연어 입력(NL)을 결합하여 사용자가 간단한 상호 작용과 명령을 통해 빠르게 만들고 반복할 수 있게 해 줍니다.
2 년 전
0120.6K
ReCamMaster:从单一视频生成多视角视频的渲染工具

ReCamMaster: 단일 동영상에서 멀티뷰 동영상을 생성하기 위한 렌더링 도구

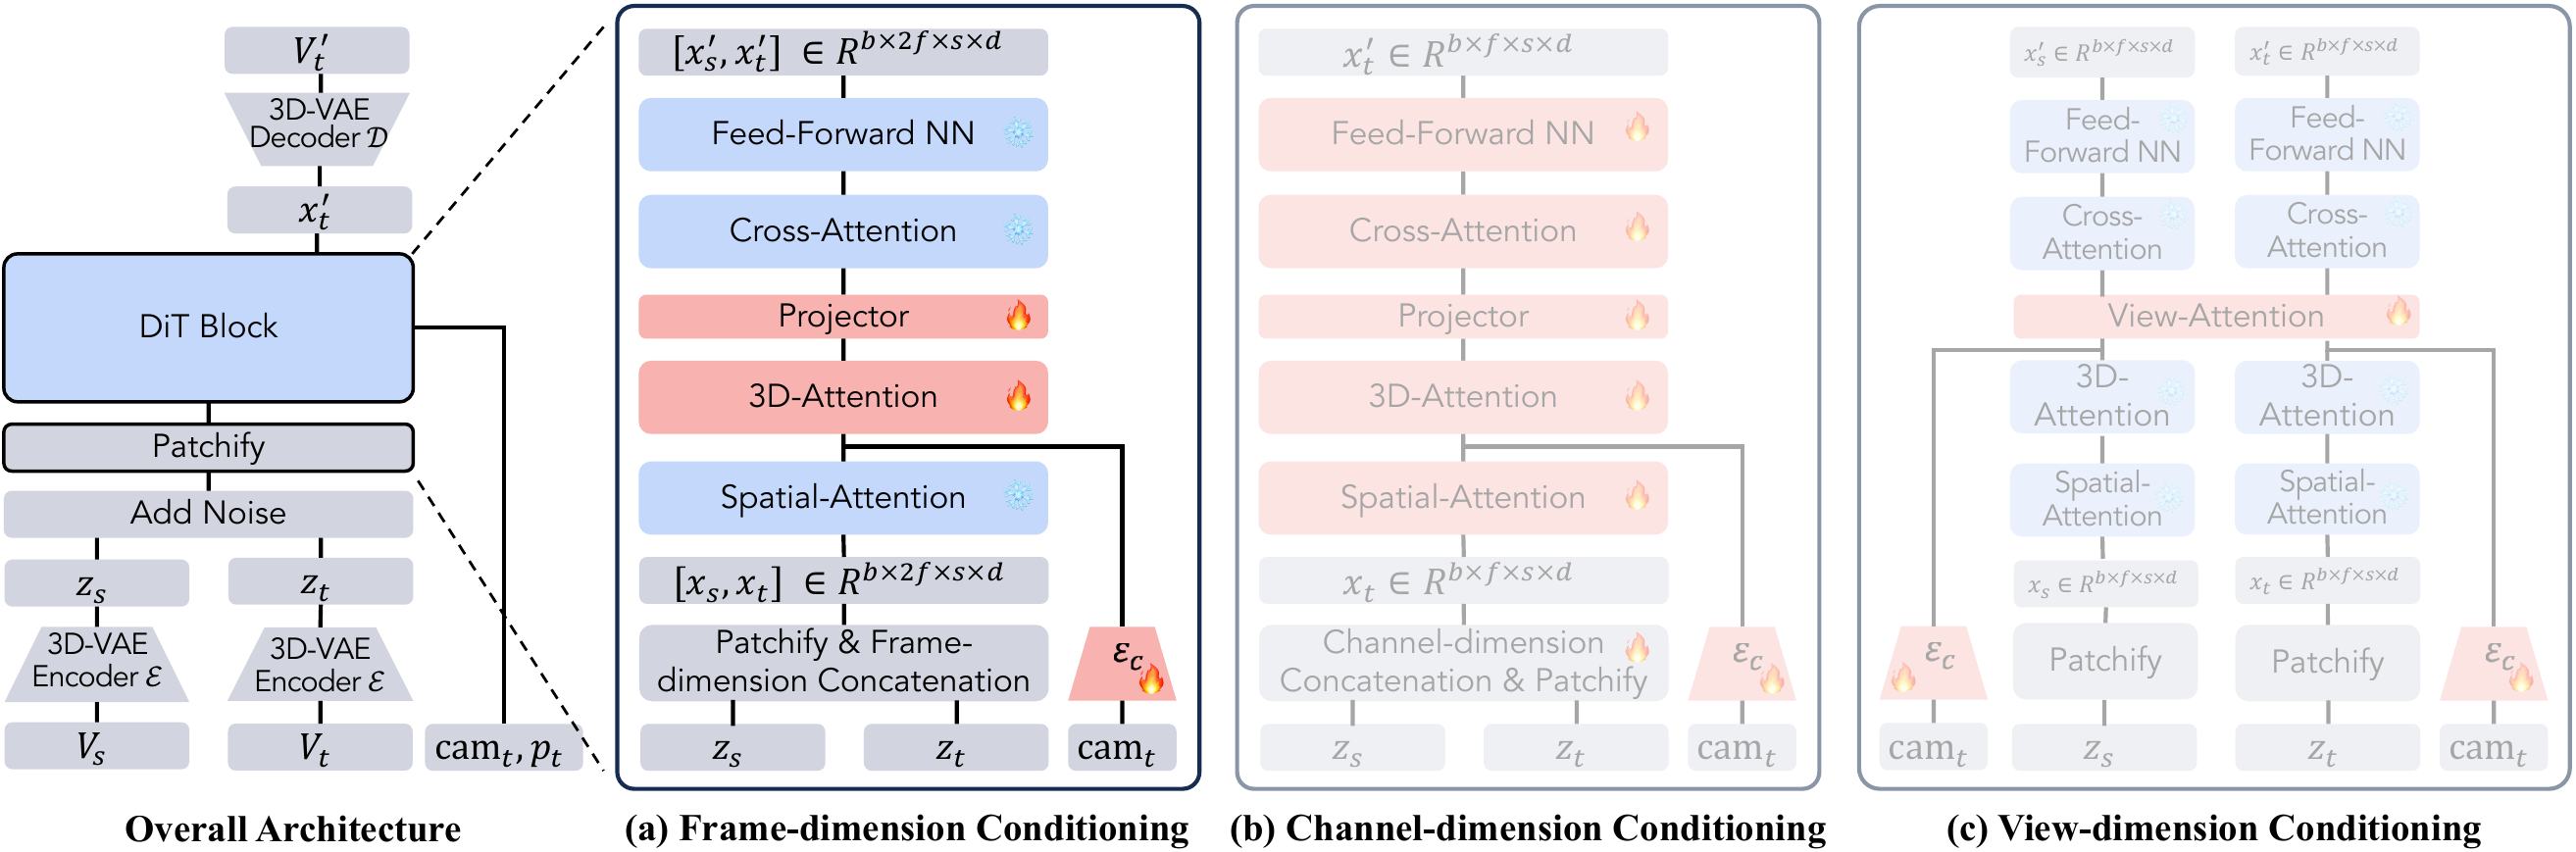
일반 소개 ReCamMaster는 오픈 소스 동영상 처리 도구로, 핵심 기능은 단일 동영상에서 새로운 카메라 뷰를 생성하는 것입니다. 사용자는 카메라 트랙을 지정하고 비디오를 다시 렌더링하여 다양한 각도의 역동적인 영상을 얻을 수 있습니다. 절강대학교와 레이서 테크놀로지 팀이 개발한 이 도구는 텍스트-투-텍스트를 기반으로 합니다.
2 년 전
0120.6K
VBDeepSeek:使用DeepSeek生成四级单词学习资料的开源工具

VBDeepSeek: DeepSeek를 사용하여 4학년 단어 학습 자료를 생성하는 오픈 소스 도구입니다.

종합 소개 "Vocabulary Book by DeepSeek"은 영어 학습자가 대학 영어 레벨 4(CET-4)의 어휘를 효율적으로 마스터할 수 있도록 돕기 위해 DeepSeek의 빅 모델을 기반으로 개발된 오픈 소스 프로젝트입니다. 이 프로젝트는 GitHub에서 호스팅됩니다...
2 년 전
0120.6K
Raycast-G4F:通过Raycast免费使用GPT-4、Llama-3等多种 AI 模型

레이캐스트-G4F: 레이캐스트를 통해 GPT-4, 라마-3 및 기타 여러 AI 모델에 무료로 액세스하세요!

일반 소개 레이캐스트-G4F(GPT4Free)는 사용자가 GPT-4, 라마-3을 포함한 다양한 고급 AI 모델에 무료로 액세스할 수 있는 강력한 레이캐스트 확장 프로그램입니다. 이 확장 프로그램은 실시간 대화 스트리밍을 제공할 뿐만 아니라...
2 년 전
0120.5K
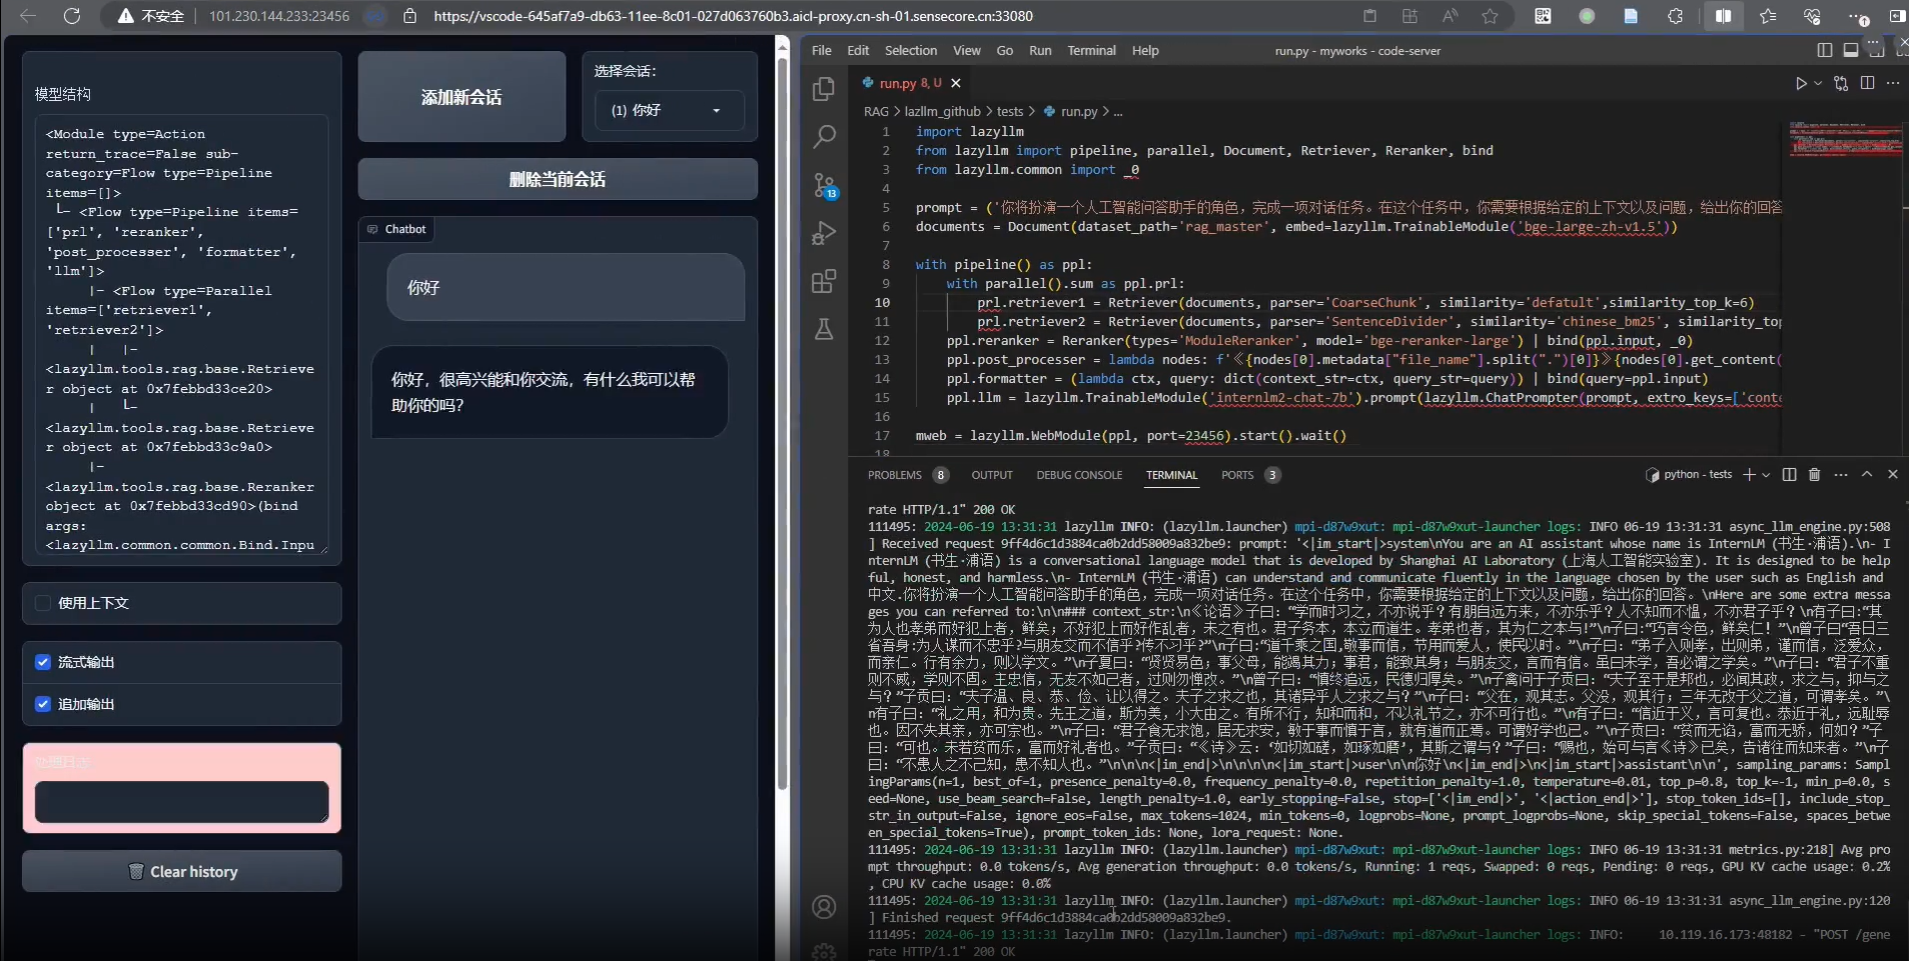
LazyLLM:商汤开源构建多智能体应用的低代码开发工具

LazyLLM: 다중 지능형 신체 애플리케이션을 구축하기 위한 상탕의 오픈 소스 로우코드 개발 도구

포괄적인 소개 LazyLLM은 LazyAGI 팀이 개발한 오픈 소스 도구로, 다중 지능 대규모 모델 애플리케이션의 개발 프로세스를 간소화하는 데 중점을 두고 있습니다. 개발자는 원클릭 배포와 가벼운 게이트웨이 메커니즘을 통해 복잡한 AI 애플리케이션을 빠르게 구축하여 지루한 엔지니어링 구성을 줄일 수 있습니다.
2 년 전
0120.5K
FantasyTalking:生成真实感说话肖像的开源工具

판타지토킹: 사실적으로 말하는 인물 사진을 생성하는 오픈 소스 툴

일반 소개 판타지토킹은 판타지-AMAP 팀이 개발한 오픈 소스 프로젝트로, 오디오 드라이브를 통해 사실적으로 말하는 인물 비디오를 생성하는 데 중점을 두고 있습니다. 이 프로젝트는 오디오 인코더 Wa와 결합된 고급 비디오 확산 모델 Wan2.1을 기반으로 합니다.
2 년 전
0120.4K
UNO:支持单主体和多主体定制化图像生成工具(适合电商配图)

UNO: 단일 피사체 및 다중 피사체 맞춤형 이미지 생성 도구 지원(전자상거래 그래픽에 적합)

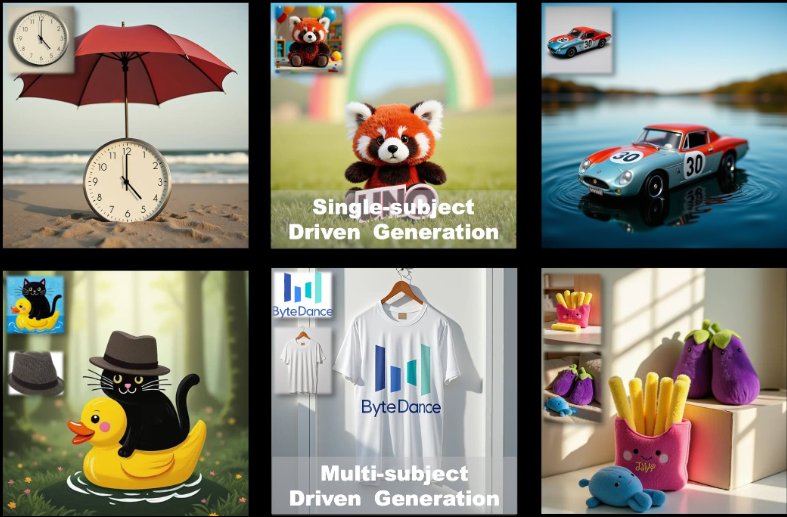
UNO는 바이트댄스 인텔리전트 크리에이션 팀이 개발한 오픈 소스 이미지 생성 프레임워크입니다. FLUX.1 모델을 기반으로 하며 "적은 것에서 더 많은 것"으로 일반화 접근 방식을 통해 단일 피사체 및 다중 피사체 맞춤형 이미지 생성에 중점을 둡니다.UNO는 확산 변환기를 사용합니다...
2 년 전
0120.4K
ModelBest(面壁智能):全球领先的轻量高性能端侧大模型

모델베스트: 세계 최고의 경량, 고성능 엔드사이드 빅 모델

일반 소개 ModelBest는 경량 고성능 대형 모델 개발에 주력하는 회사로, 첨단 AI 기술을 주류 가전제품 및 일상 생활의 모든 종류의 최종 장치에 적용하는 데 전념하고 있습니다. 극한의 연산 능력과 메모리 사용 효율을 갖춘 MiniCPM 시리즈 엔드 사이드 모델은 ...
2 년 전
0120.4K
AI Chatbot Supabase:开源的Next.js和Supabase构建的AI聊天机器人,快速部署到Vercel。

AI 챗봇 Supabase: 오픈 소스 Next.js와 Supabase는 Vercel에 신속하게 배포할 수 있도록 AI 챗봇을 구축했습니다.

일반 소개 AI 챗봇 수파베이스는 Next.js와 수파베이스를 기반으로 구축된 오픈 소스 AI 챗봇 템플릿입니다. Vercel에서 개발한 이 프로젝트는 완전한 기능을 갖춘 사용자 지정 가능한 챗봇 솔루션을 제공하는 것을 목표로 합니다. 작성자 ...
2 년 전
0120K