Proyecto AI de código abierto

Total 1020 artículos
AI no jimaku gumi:借助AI实现视频多语言字幕自动生成和翻译

AI no jimaku gumi: generación y traducción automática de subtítulos multilingües para vídeos con ayuda de la IA.

Introducción general AI no jimaku gumi (AI no subtitle group) es una potente herramienta de procesamiento de subtítulos de vídeo de línea de comandos centrada en permitir funciones automatizadas de extracción, transcripción y traducción de subtítulos de vídeo. La herramienta integra tecnologías avanzadas de inteligencia artificial, como...
hace 2 años
0124.2K
VideoSeal:先进的开源视频隐藏水印嵌入与提取工具,保护视频版权

VideoSeal: Herramienta avanzada de código abierto para incrustar y extraer marcas de agua ocultas en vídeo y proteger los derechos de autor.

Introducción general VideoSeal es una herramienta de marca de agua de vídeo de código abierto desarrollada por Facebook Research, diseñada para proporcionar una incrustación y extracción eficientes de marcas de agua de vídeo. La herramienta es compatible con los últimos modelos de código abierto y contiene modelos preentrenados, código de entrenamiento, código de inferencia y herramientas de evaluación....
hace 2 años
0124.1K
Agentic Security:开源的LLM漏洞扫描工具,提供全面的模糊测试和攻击技术

Agentic Security: herramienta de escaneo de vulnerabilidades LLM de código abierto que proporciona pruebas fuzz y técnicas de ataque exhaustivas.

Introducción general Agentic Security es una herramienta de escaneo de vulnerabilidades LLM (Large Language Model) de código abierto diseñada para proporcionar a los desarrolladores y profesionales de la seguridad pruebas fuzz completas y técnicas de ataque. La herramienta admite conjuntos de reglas personalizadas o ataques basados en agentes y es capaz de integrar LLM AP...
hace 2 años
0124.1K
Orate:集成知名语音生成、语音转录与变声模型的统一API

Orate: una API unificada para integrar la generación de voz bien conocida, la transcripción de voz y el modelado de voz

Introducción general Orate es un conjunto de herramientas de IA centrado en la generación y transcripción de voz. Proporciona una API unificada que se integra a la perfección con los principales proveedores de IA, como OpenAI, ElevenLabs y AssemblyAI, para ayudar a...
hace 2 años
0123.9K
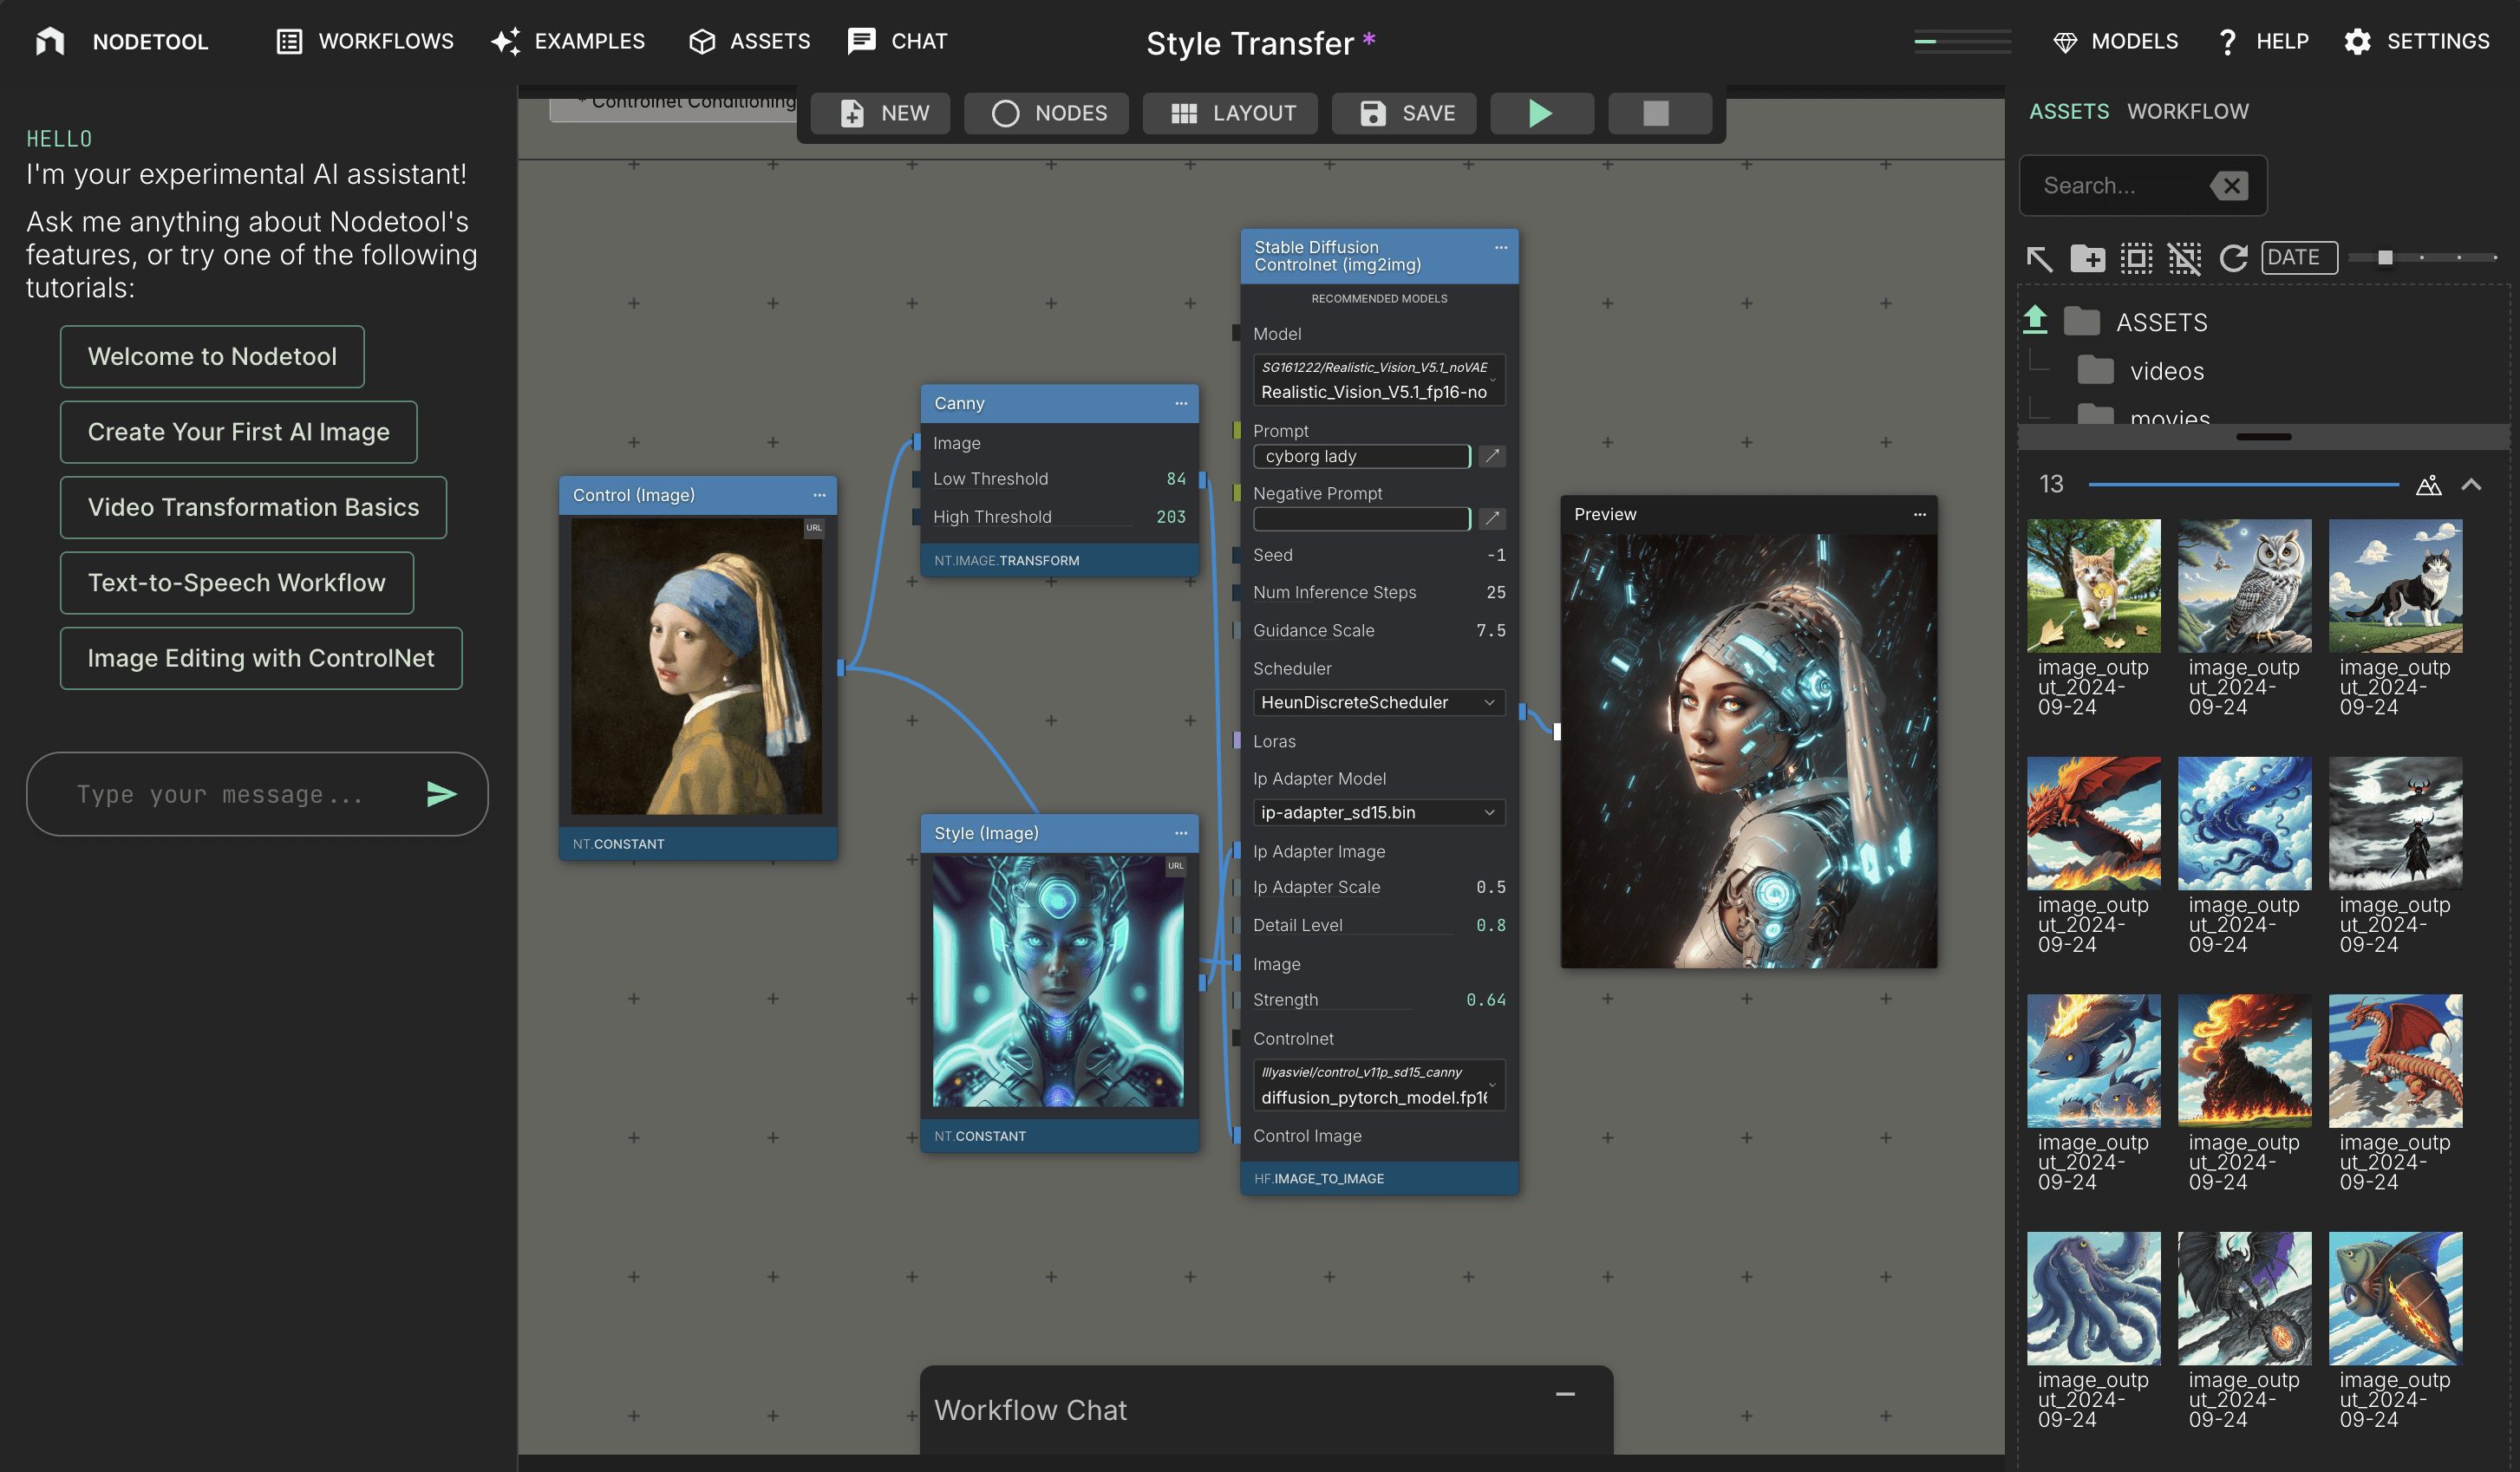
NodeTool:基于节点编排的AI模型工作流可视化客户端

NodeTool: un cliente de visualización de flujos de trabajo para modelos de IA basado en la orquestación de nodos

Introducción general NodeTool es una innovadora plataforma de creación de IA diseñada para proporcionar una interfaz sencilla e intuitiva para entusiastas de la IA, desarrolladores, científicos de datos y creativos. Tanto si eres un artista, desarrollador o principiante, NodeTool te ayuda a crear rápidamente prototipos creativos....
hace 2 años
0123.9K
R1-V:低成本强化学习实现视觉语言模型泛化能力

R1-V: Aprendizaje por refuerzo de bajo coste para la capacidad de generalización de modelos de lenguaje visual

Introducción exhaustiva R1-V es un proyecto de código abierto cuyo objetivo es lograr avances en el modelado del lenguaje visual (VLM) mediante el aprendizaje por refuerzo (RL) de bajo coste. El proyecto utiliza mecanismos de recompensa verificables para motivar a los VLM a aprender habilidades genéricas de conteo. Sorprendentemente, R1-V's 2B ...
hace 2 años
0123.9K
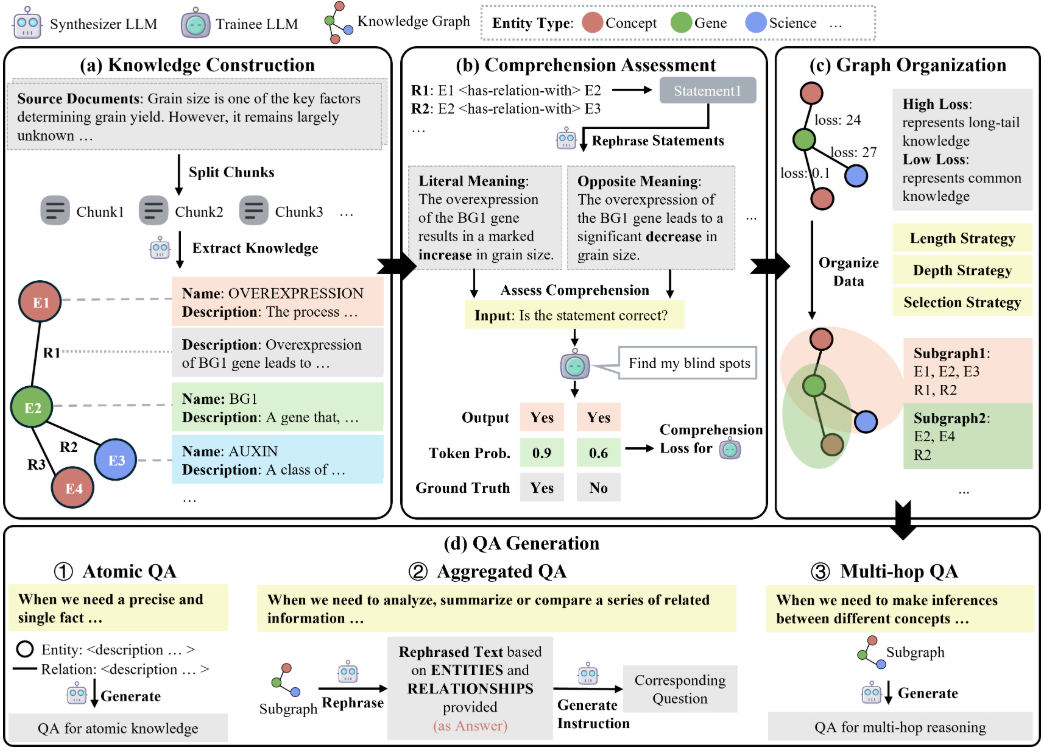
GraphGen:利用知识图谱生成合成数据微调语言模型

GraphGen: ajuste de modelos lingüísticos mediante grafos de conocimiento para generar datos sintéticos

Introducción general GraphGen es un marco de código abierto desarrollado por OpenScienceLab, un laboratorio de IA de Shanghái, alojado en GitHub, que se centra en optimizar el ajuste fino supervisado de grandes modelos lingüísticos (LLM) guiando la generación de datos sintéticos a través de grafos de conocimiento. Se desarrolló a partir de ...
hace 1 año
0123.8K
Ultravox:实时端到端语音对话的音频多模态大模型,GPT-4o语音交互的开源实现

Ultravox: un macromodelo multimodal de audio para el diálogo de voz en tiempo real de extremo a extremo, una implementación de código abierto de la interacción de voz GPT-4o

Introducción general Ultravox es un innovador modelo multimodal de lenguaje amplio (LLM) diseñado para el procesamiento del habla en tiempo real. A diferencia de los sistemas tradicionales de reconocimiento del habla, Ultravox elimina la necesidad de una etapa separada de reconocimiento del habla de audio (ASR), y es capaz de convertir directamente el audio en un espacio de alta dimensión en...
hace 2 años
0123.7K
VimLM:本地LLM驱动的Vim编程助手,安全离线的智能编程

VimLM: Asistente de programación Vim nativo basado en LLM, programación inteligente segura sin conexión

Introducción General VimLM es un plugin de Vim que proporciona un asistente de código impulsado por el LLM nativo (Large Language Model). Interactuando con el modelo LLM nativo a través de los comandos de Vim, obtiene automáticamente el contexto del código y ayuda a los usuarios a editar código en Vim.VimLM está inspirado en...
hace 2 años
0123.6K
MockingBird:快速克隆声音与模型训练,基于 xtts v2 实现的文本转语音

MockingBird: clonación de voz rápida y formación de modelos, conversión de texto a voz basada en xtts v2

Introducción completa MockingBird es un proyecto de código abierto que pretende conseguir una rápida clonación de voz y conversión de texto a voz mediante tecnología de IA. Los usuarios sólo tienen que proporcionar 5 segundos de muestras de voz, puede generar cualquier contenido de voz. El proyecto admite una gran variedad de conjuntos de datos chinos ...
hace 2 años
0123.5K
RLAMA:命令行操作的本地文档智能问答 RAG 系统

RLAMA: un sistema RAG de interrogación inteligente de documentos locales operado desde la línea de comandos

Introducción general RLAMA es un sistema RAG (Retrieval Augmentation Generation) de cuestionario de inteligencia documental desarrollado por DonTizi de código abierto y alojado en GitHub, cuya característica principal es la funcionalidad a través de operaciones de línea de comandos. Los usuarios pueden utilizar simples comandos de terminal para conectarse a ...
hace 2 años
0123.5K
Zed:Rust开发的高性能多人协作代码编辑器

Zed: un editor de código colaborativo multijugador de alto rendimiento desarrollado por Rust

Introducción general Zed es un editor de código colaborativo multiusuario de alto rendimiento desarrollado por los creadores de Atom y Tree-sitter.Escrito en el lenguaje Rust, Zed está diseñado para proporcionar una experiencia de codificación rápida y fluida. Entre sus principales características se incluye la compatibilidad con...
hace 2 años
0123.4K
Gemini Playground:无服务器部署Gemini多模态对话网站

Gemini Playground: despliegue sin servidor de un sitio de diálogo multimodal Gemini

Introducción General Gemini Playground es un proyecto de código abierto diseñado para ayudar a los usuarios a implementar rápidamente un sitio de diálogo multimodal . El proyecto es desarrollado por el camarón de rastreo técnico , apoyar el uso de Gemini API Key en 10 segundos para completar el despliegue . Si el usuario es ...
hace 2 años
0123.3K
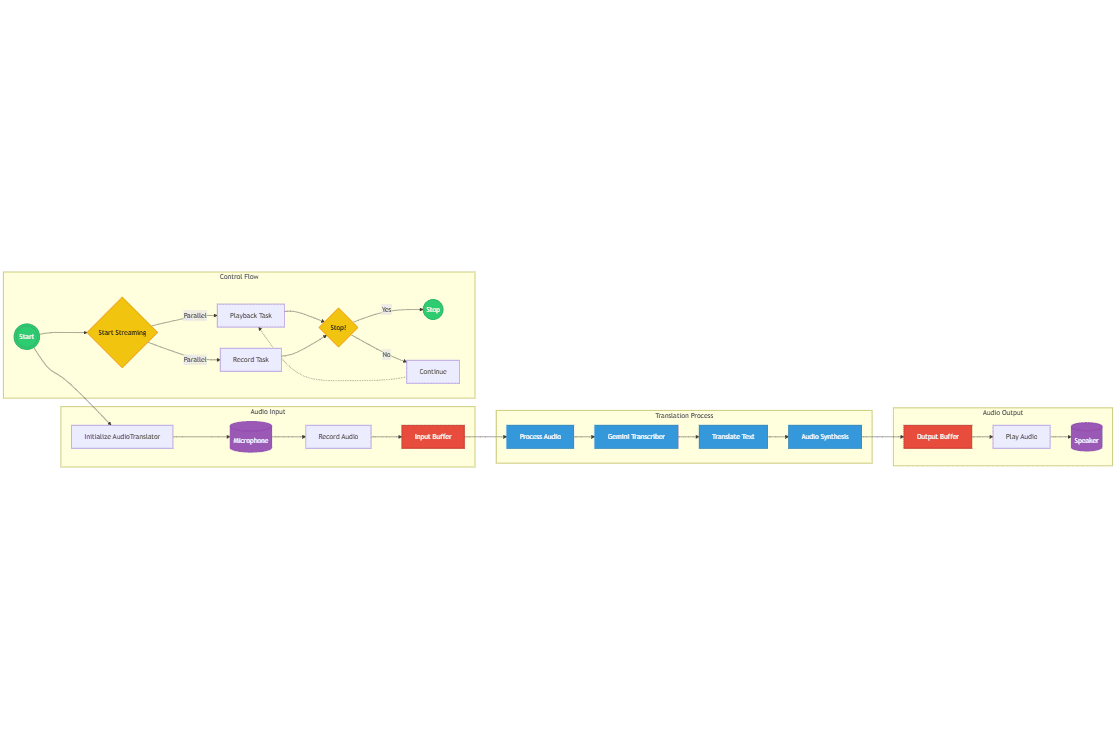
TransRouter:基于Gemini多模态模型,实时中英互译的音频转换工具

TransRouter: una herramienta de conversión de audio en tiempo real para la traducción del chino al inglés basada en el modelo multimodal Gemini.

TransRouter es una herramienta de traducción de voz en tiempo real basada en el modelo Gemini de Google, diseñada específicamente para la traducción de voz en tiempo real entre inglés y chino. La herramienta se integra perfectamente en software de videoconferencia como Zoom, proporcionando una potente herramienta para la traducción...
hace 2 años
0123.3K
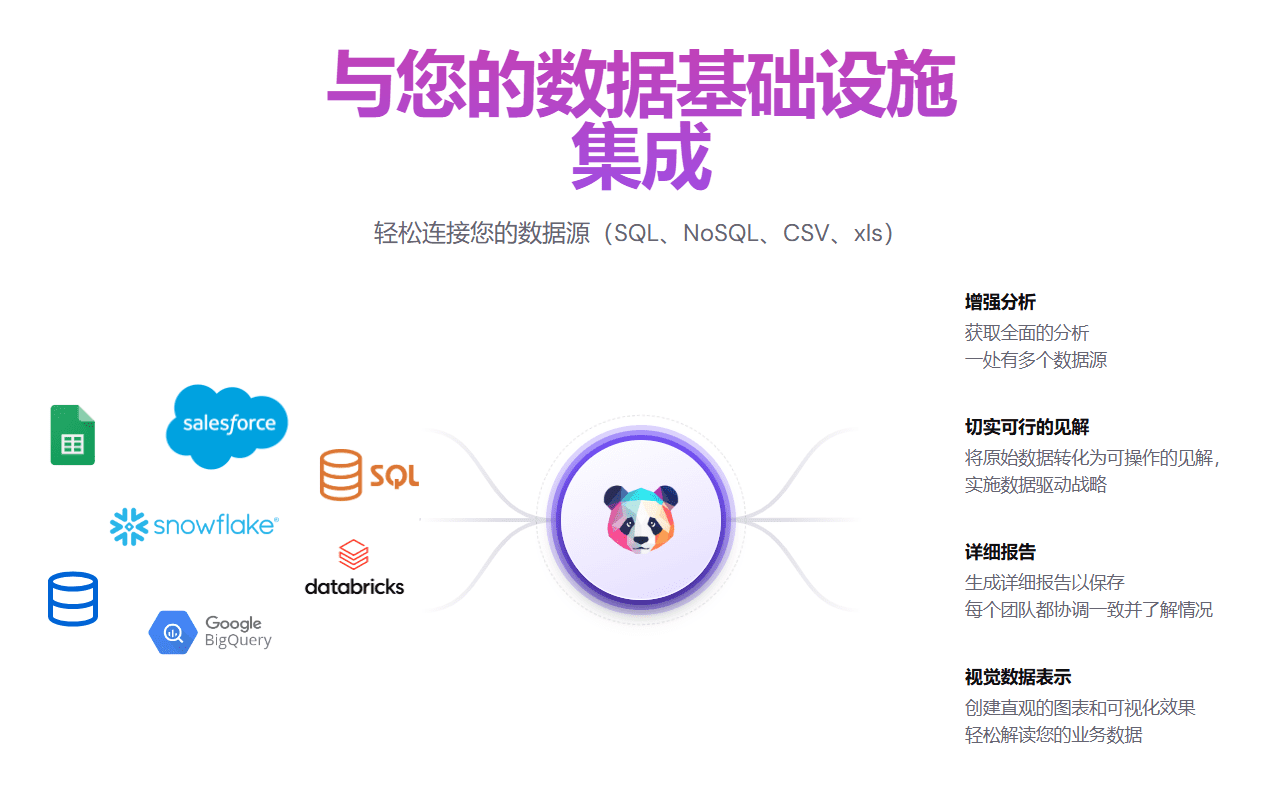
PandasAI:数据分析对话平台,用自然语言完成数据查询与图表生成

PandasAI: una plataforma de diálogo de análisis de datos para consultas de datos y generación de gráficos en lenguaje natural

Introducción general PandasAI es una plataforma de código abierto basada en Python diseñada para simplificar el proceso de análisis de datos mediante técnicas de procesamiento del lenguaje natural. Permite a los usuarios trabajar en un diálogo con bases de datos (por ejemplo, SQL, CSV, pandas, polars, mongodb, n...
hace 2 años
0123.3K
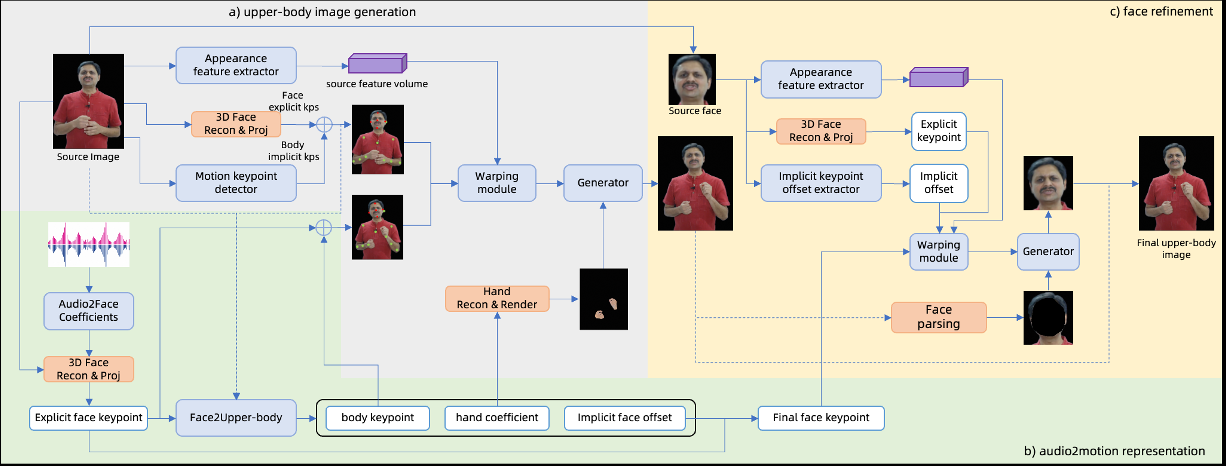
ChatAnyone:从照片生成半身数字人肖像视频的工具

ChatAnyone: una herramienta para generar vídeos de retratos humanos digitales de medio cuerpo a partir de fotos

Introducción general ChatAnyone es un proyecto innovador desarrollado por el equipo HumanAIGC. Utiliza técnicas de inteligencia artificial para generar vídeos digitales de retratos humanos con movimientos de la parte superior del cuerpo a partir de una única foto y una entrada de audio. El proyecto se basa en un modelo jerárquico de difusión del movimiento que genera movimientos de la cabeza...
hace 2 años
0123.3K
Ruyi-Models:生成图像到视频开源模型,支持镜头控制与运动幅度控制

Ruyi-Models: Genera modelos de código abierto de imagen a vídeo que admiten el control de la lente y el control de la amplitud de movimiento.

Introducción general Ruyi-Models es un proyecto de código abierto diseñado para generar vídeos de alta calidad a partir de imágenes. Desarrollado por el equipo IamCreateAI, el proyecto soporta la generación de vídeo cinemático a 768 de resolución, 24 fotogramas por segundo, 120 fotogramas en 5 segundos...
hace 2 años
0123.2K
Shortest:AI自动化测试工具,使用自然语言进行端到端测试

Shortest: una herramienta de pruebas automatizadas con IA que utiliza el lenguaje natural para realizar pruebas de principio a fin

Introducción general Shortest es un marco de pruebas de extremo a extremo en lenguaje natural basado en IA desarrollado por el equipo Anti-Work. Se basa en Playwright y admite la integración con GitHub y la autenticación de dos factores (2FA)....
hace 2 años
0123.2K
PrimisAI Nexus:构建可扩展AI多智能体系统与任务自动化的轻量框架

PrimisAI Nexus: un marco ligero para construir sistemas de inteligencia múltiple de IA escalables y automatización de tareas

Introducción general PrimisAI Nexus es un marco ligero de código abierto Python alojado en GitHub y desarrollado por el equipo PrimisAI, con el objetivo de ayudar a los usuarios a construir y gestionar sistemas de cuerpos multi-inteligentes de IA escalables a través de Large Language Modelling (LLM), permitiendo...
hace 2 años
0123.2K
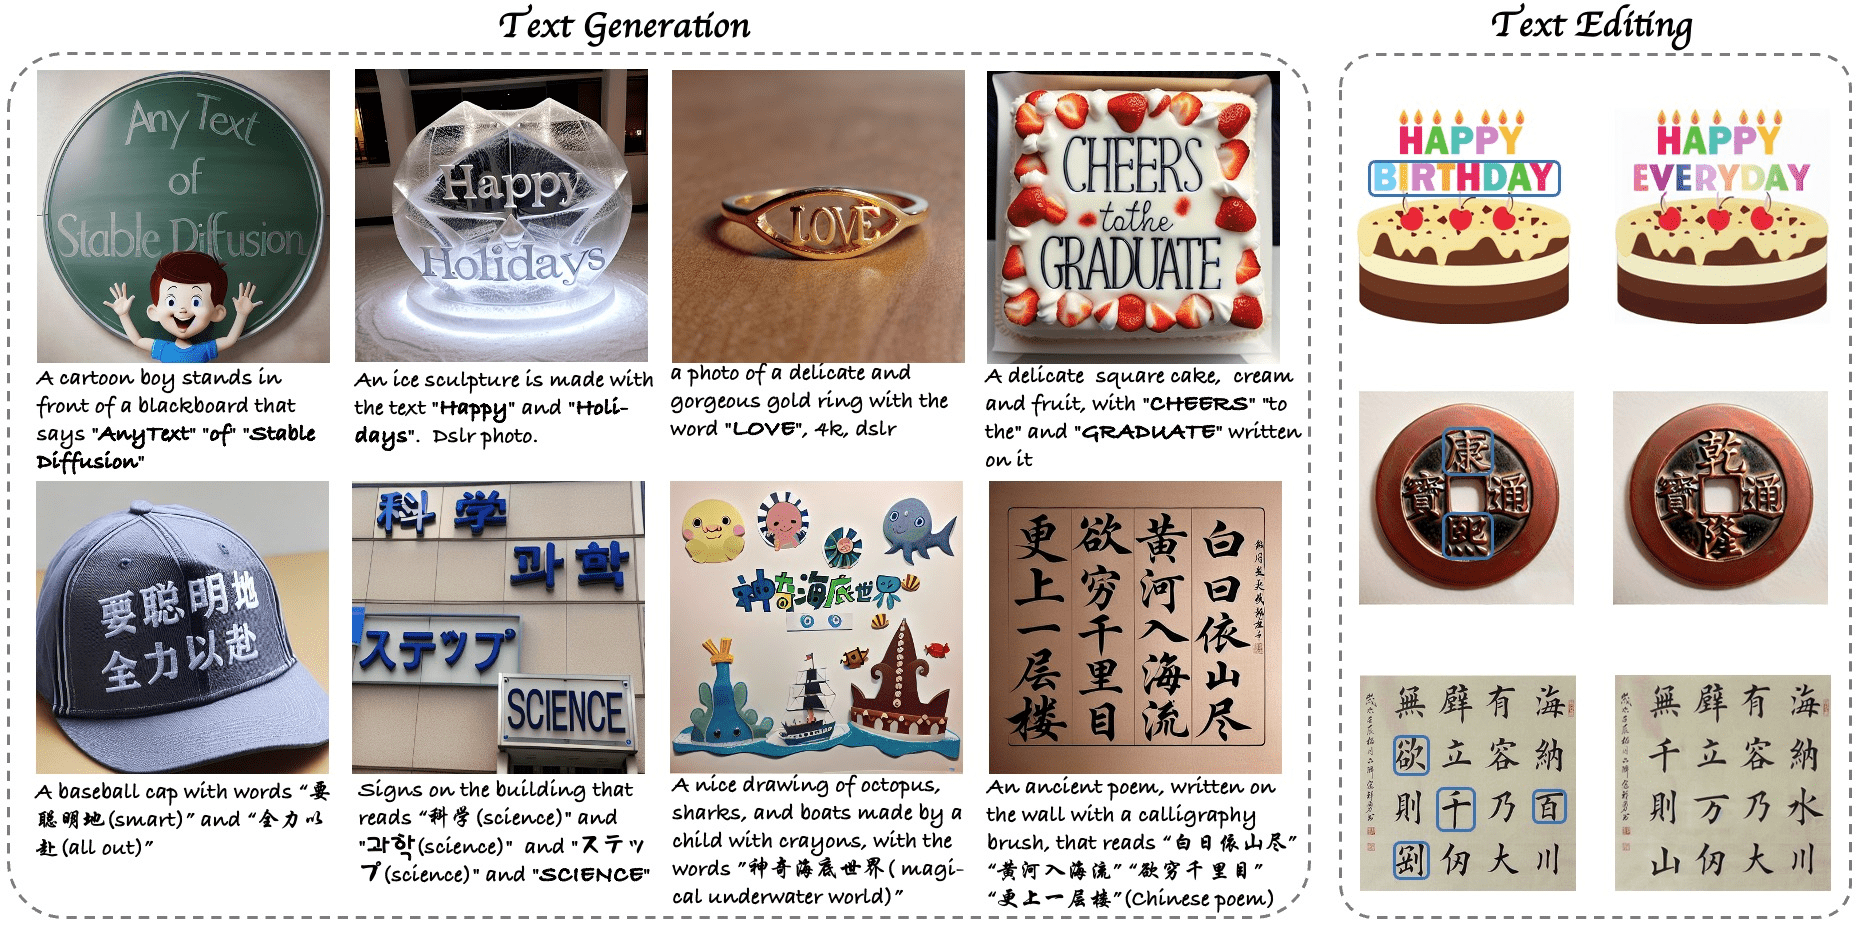
AnyText:生成和编辑多语言图像文本,高可控在图像中生成多行中文

AnyText: Genera y edita texto de imagen multilingüe, altamente controlable para generar múltiples líneas de chino en la imagen.

Introducción AnyText es una revolucionaria herramienta de generación y edición de texto visual multilingüe desarrollada a partir del modelo de difusión. Genera texto multilingüe natural y de alta calidad en imágenes y admite funciones flexibles de edición de texto. Fue desarrollada por un equipo de investigadores y presentada en ICLR 2024....
hace 2 años
0123.1K
SegAnyMo:从视频中自动分割任意运动物体的开源工具

SegAnyMo: herramienta de código abierto para segmentar automáticamente objetos arbitrarios en movimiento a partir de vídeo

Introducción general SegAnyMo es un proyecto de código abierto desarrollado por un equipo de investigadores de la UC Berkeley y la Universidad de Pekín, entre los que se encuentran miembros como Nan Huang. Esta herramienta se centra en el procesamiento de vídeo y puede identificar y segmentar automáticamente objetos arbitrarios en movimiento en un vídeo, como personas, animales o...
hace 2 años
0122.9K
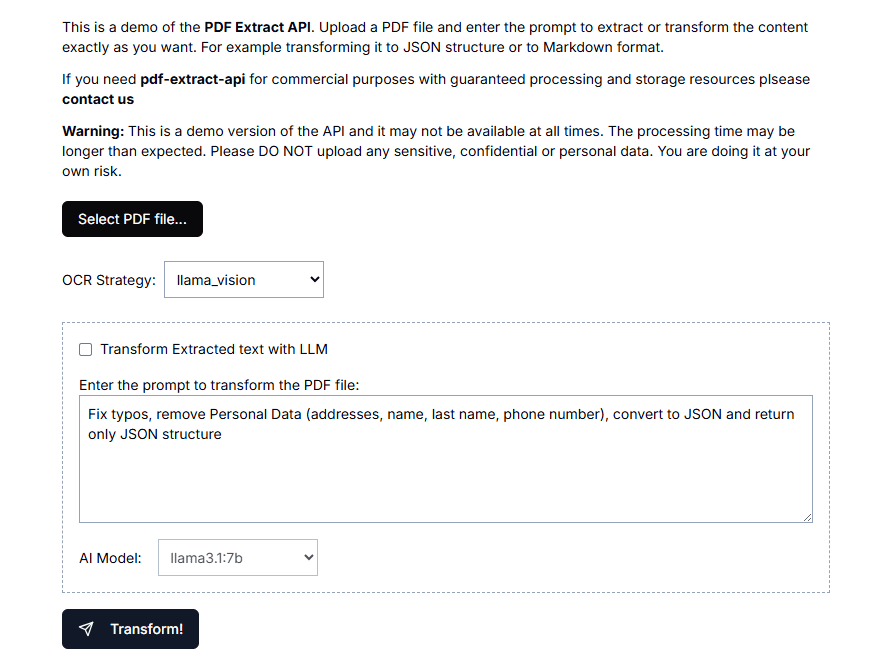
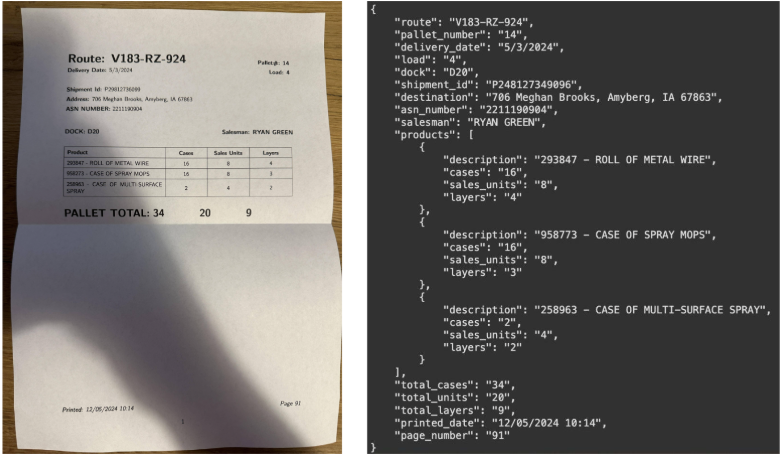
文本提取API(text-extract-api):视觉提取文本信息,匿名化的PDF提取工具

API de extracción de texto (text-extract-api): extracción visual de información textual, herramienta de extracción anónima de PDF

Introducción general La API de extracción de texto (text-extract-api) es una potente herramienta diseñada para extraer y analizar el contenido de diversos formatos de documento (por ejemplo, PDF, Word, PPTX, etc.). La API utiliza tecnología punta de reconocimiento óptico de caracteres (OCR) y Ol...
hace 2 años
0122.9K
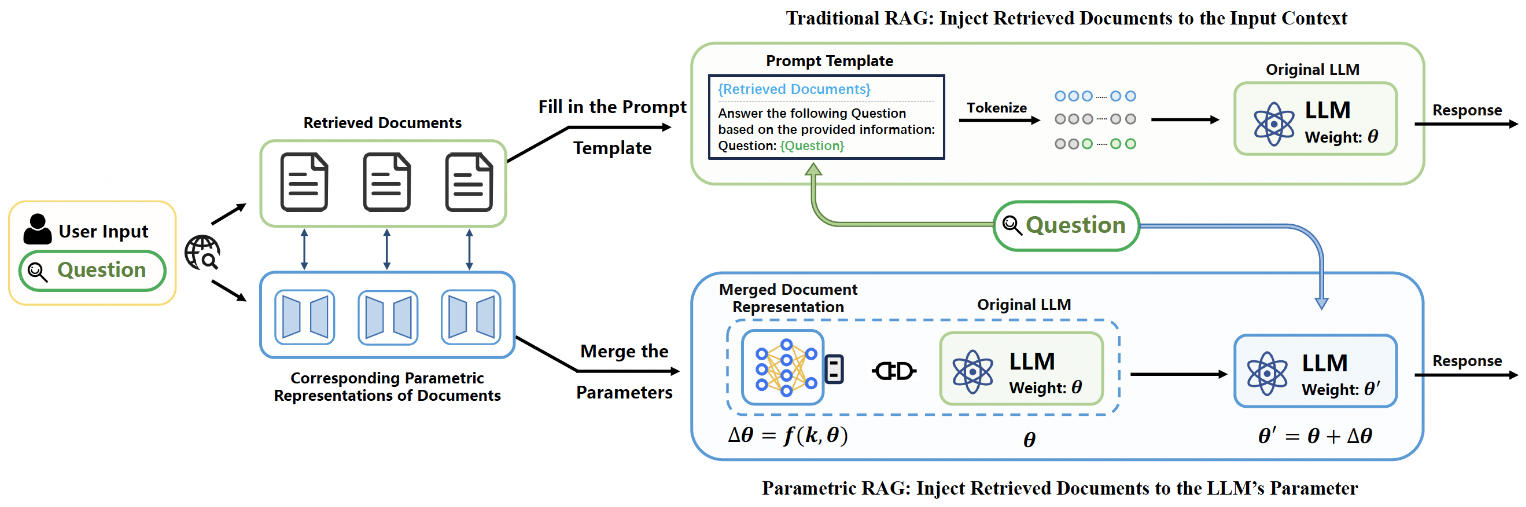
PRAG:提升问答系统性能的参数化检索增强生成工具

PRAG: Herramienta paramétrica de generación de aumentos de recuperación para mejorar el rendimiento de los sistemas de preguntas y respuestas.

Introducción exhaustiva PRAG (Parametric Retrieval-Augmented Generation) es una innovadora herramienta de generación aumentada por recuperación que pretende mejorar la generación de conocimiento externo incrustándolo directamente en el espacio de parámetros de un Large Language Model (LLM)....
hace 2 años
0122.8K
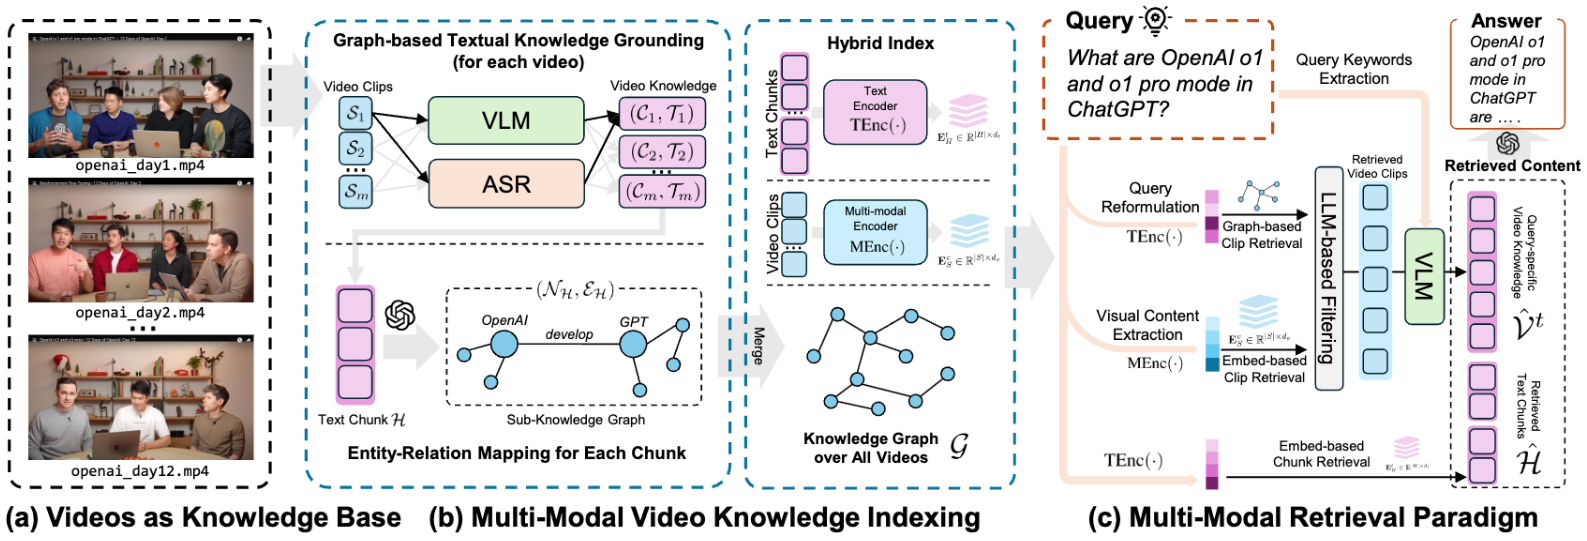
VideoRAG:理解超长视频的RAG框架,支持多模态检索和知识图谱构建

VideoRAG: un marco RAG para la comprensión de vídeos ultralargos con soporte para la recuperación multimodal y la construcción de grafos de conocimiento

Introducción VideoRAG es un marco generativo de recuperación mejorado diseñado para procesar y comprender vídeos contextuales muy largos. La herramienta combina una base de conocimiento textual basada en grafos con la codificación jerárquica multimodal del contexto para procesar eficientemente en una sola GPU NVIDIA RTX 3090....
hace 2 años
0122.8K
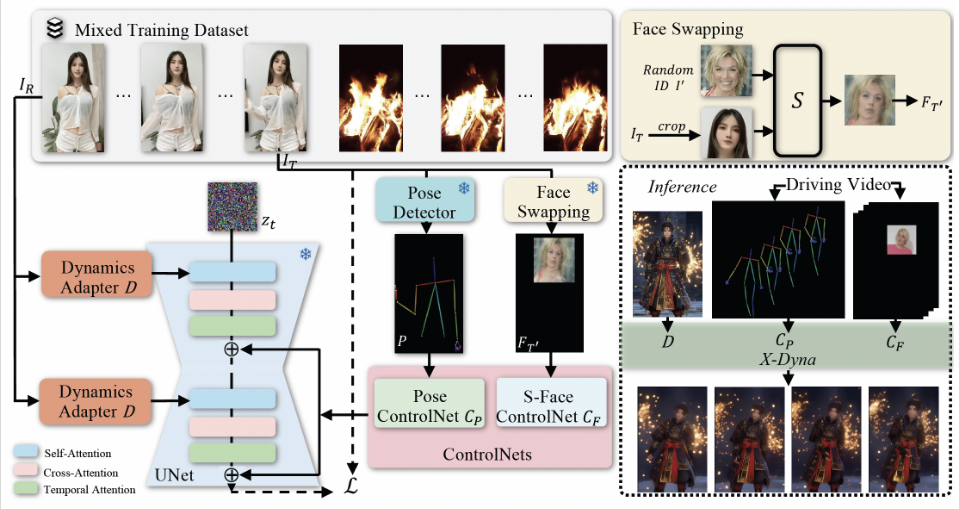
X-Dyna:静态人像参考视频姿态生成视频,让小姐姐的照片跳舞

X-Dyna: Vídeo de generación de poses para hacer bailar las fotos de Missy

Introducción general X-Dyna es un proyecto de código abierto desarrollado por ByteDance para generar animaciones dinámicas de retratos utilizando técnicas de difusión de muestra cero. El proyecto utiliza expresiones faciales y movimientos corporales en vídeo de unidad para animar imágenes de retratos individuales, generando efectos de movimiento realistas y conscientes del contexto.X-D...
hace 2 años
0122.8K
WebPilot:智能网页信息处理工具,网页内容抓取免费API

WebPilot: herramienta inteligente de procesamiento de información web, API gratuita para la captura de contenidos web

WebPilot Introducción general Webpilot es un "asistente web" gratuito y de código abierto que le permite comunicarse libremente con cualquier página web o realizar tareas automatizadas. No es necesario cambiar de página o copiar y pegar, basta con seleccionar texto o introducir comandos, webpilot...
hace 2 años
0122.8K
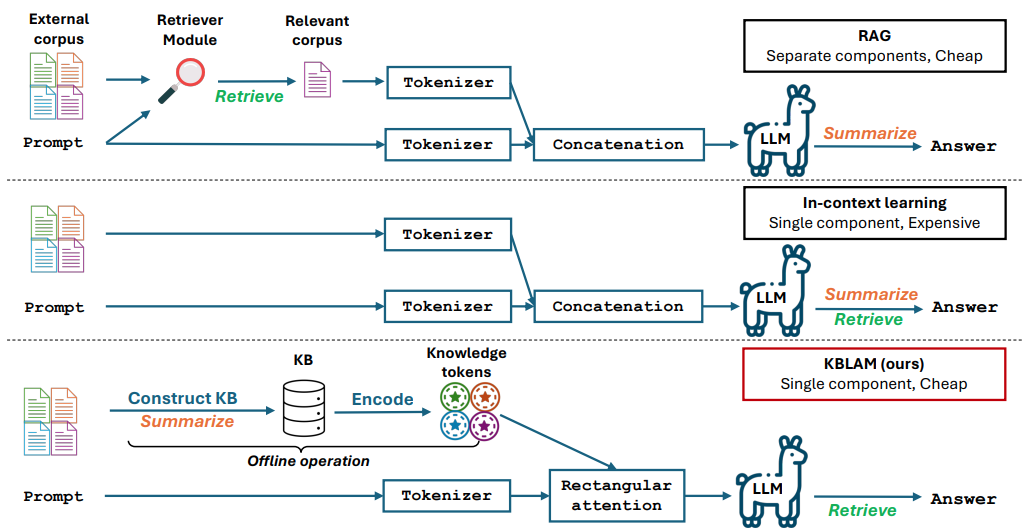
KBLaM:为大模型嵌入外部知识的开源增强工具

KBLaM: una herramienta mejorada de código abierto para incrustar conocimientos externos en grandes modelos

KBLaM es un proyecto de código abierto desarrollado por Microsoft , el nombre completo es "Knowledge Base augmented Language Model" ( Modelo de Lenguaje Aumentado de Base de Conocimiento ). Es a través de la conversión de conocimiento externo en vectores e incrustado en un gran modelo de...
hace 2 años
0122.7K
pdf2htmlEX:PDF无损转换为HTML,保持文本格式,适用于学术论文和杂志排版

pdf2htmlEX: conversión sin pérdidas de PDF a HTML, manteniendo el formato del texto, adecuado para trabajos académicos y composición de revistas.

Introducción completa pdf2htmlEX es una herramienta de código abierto diseñada para convertir archivos PDF a formato HTML , mediante el análisis del contenido del archivo PDF y el uso de HTML + CSS para restaurar con precisión su efecto visual , el documento PDF se ...
hace 2 años
0122.6K
BuffGPT:企业级生成式AI应用低代码开发平台

BuffGPT: una plataforma de desarrollo de bajo código para aplicaciones de IA generativa de nivel empresarial

Introducción BuffGPT es una plataforma de desarrollo de aplicaciones de IA de código abierto basada en el Large Language Model (LLM), que proporciona funciones listas para usar como el procesamiento de datos, la invocación de modelos, la recuperación RAG y la orquestación visual de flujos de trabajo para ayudar a los usuarios a construir y operar fácilmente aplicaciones de IA generativa. La plataforma admite...
hace 2 años
0122.6K
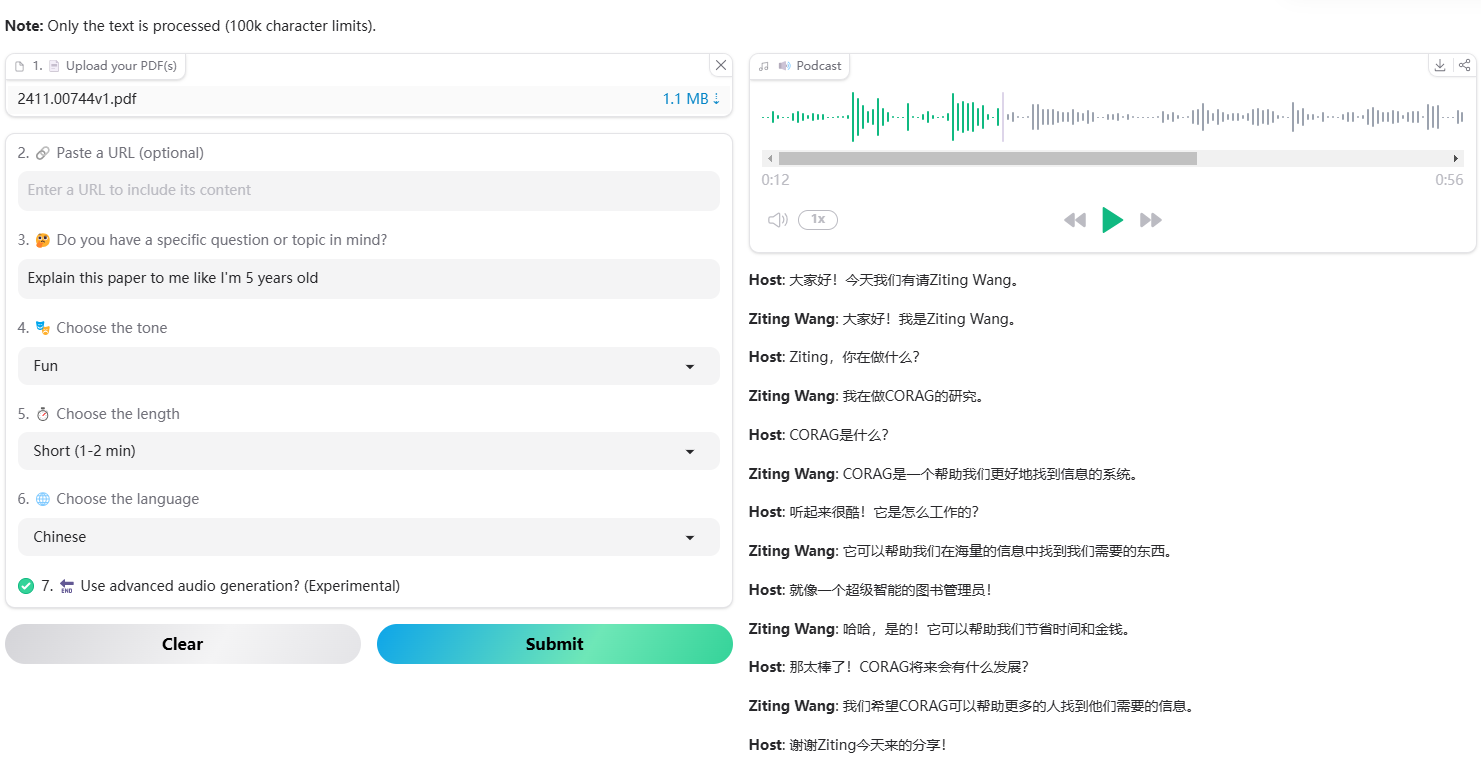
Open NotebookLM:将PDF转换为播客的开源工具

Open NotebookLM: convierta PDF en podcasts de herramientas de código abierto

Introducción general Open NotebookLM es un proyecto de código abierto diseñado para convertir cualquier documento PDF en un podcast. La herramienta utiliza modelos de código abierto Large Language Model (LLM) y Text-to-Speech (TTS) para procesar contenidos PDF y generar diálogos naturales adecuados para podcasts de audio....
hace 2 años
0122.5K
小半 WordPress AI 助手:实现对话、文章生成与翻译的 WordPress AI助手插件

Little Half WordPress AI Assistant: un plugin de WordPress AI Assistant para el diálogo, la generación de entradas y la traducción

Introducción completa WordPress AI Assistant Plugin (wp-ai-chat) es un plugin de WordPress de código abierto diseñado para proporcionar a los usuarios una variedad de características de AI, incluyendo el diálogo AI, la generación de artículos, resumen de artículos, traducción de artículos y lectura de contenidos. El plugin soporta el acoplamiento de múltiples ...
hace 2 años
0122.5K
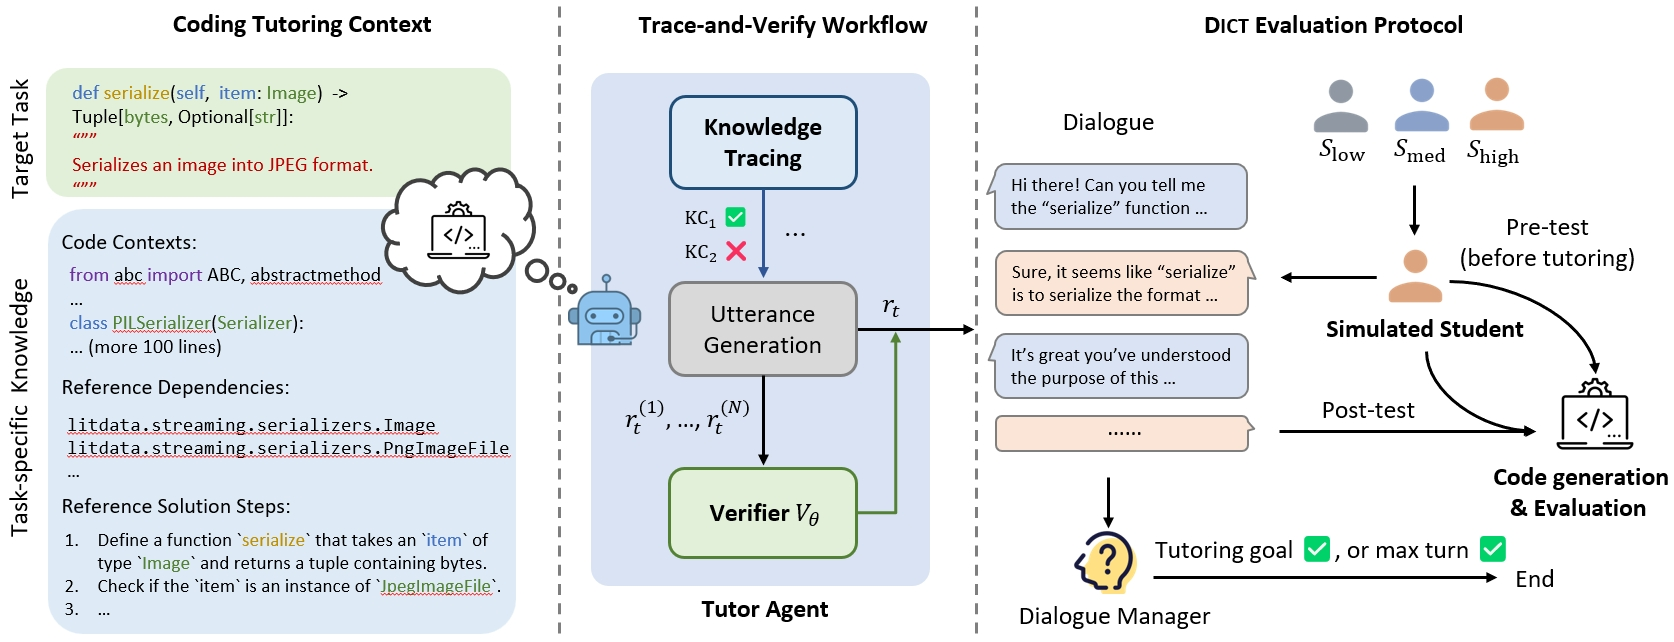
Coding-Tutor:提供个性化编程指导的智能教学助手

Coding-Tutor: un asistente pedagógico inteligente que ofrece orientación personalizada sobre programación

Introducción general Coding-Tutor es un proyecto de código abierto alojado en GitHub y creado por el desarrollador iwangjian para proporcionar a los alumnos una experiencia de enseñanza de programación personalizada. Utiliza tecnología de IA conversacional para aprender basándose en los conocimientos...
hace 2 años
0122.5K
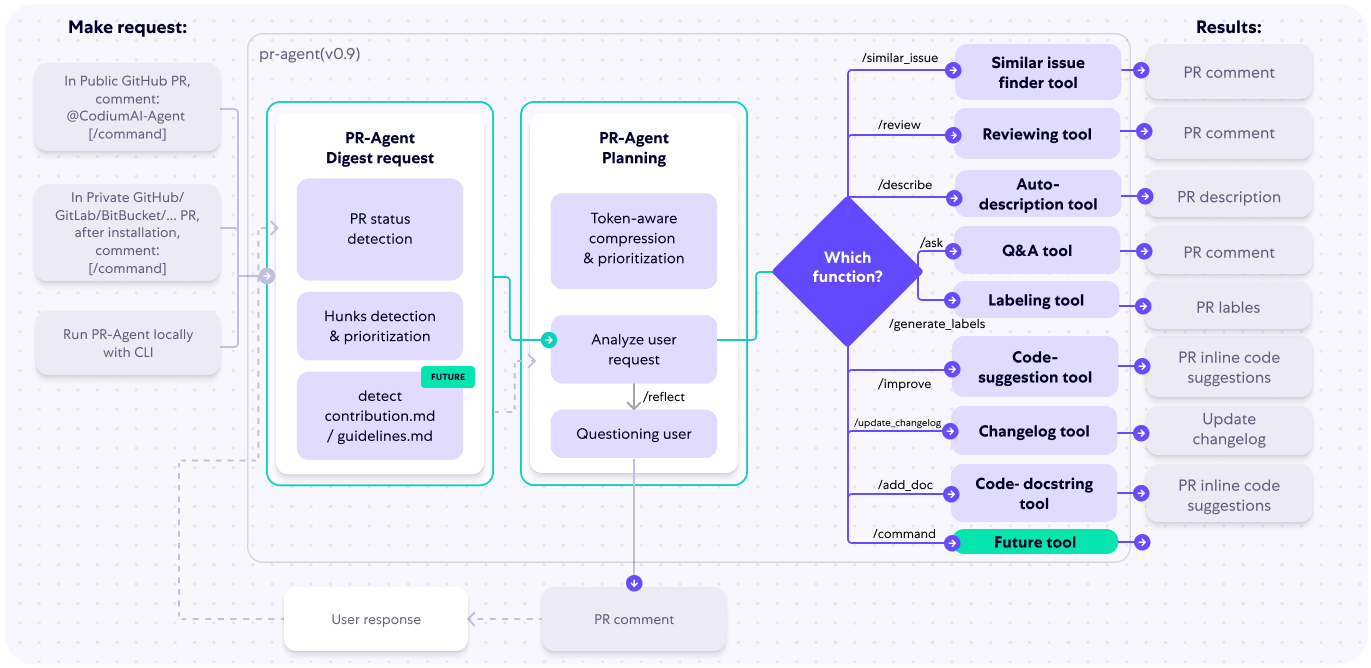
PR Agent:自动化拉取请求分析工具

PR Agent: herramienta automatizada de análisis de pull requests

Introducción general PR-Agent es una herramienta de código abierto desarrollada por Qodo para automatizar el procesamiento de pull requests (solicitudes de extracción) mediante tecnología de IA. La herramienta es capaz de proporcionar retroalimentación automatizada, sugerencias y análisis para ayudar a los desarrolladores a realizar revisiones de código de manera más eficiente....
hace 2 años
0122.4K
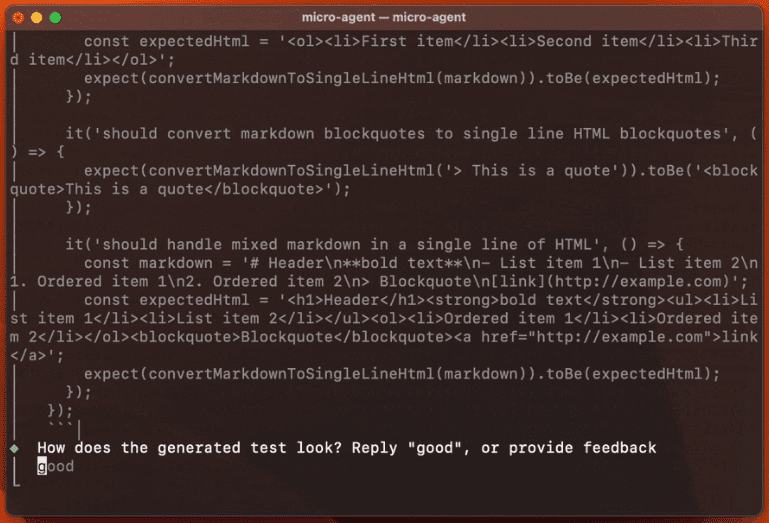
Micro Agent:AI编程智能体,自动生成代码并测试、修复代码

Microagente: inteligencia artificial de programación que genera código automáticamente y lo prueba y corrige.

Introducción general Micro-Agent es un asistente de codificación de IA de código abierto desarrollado por Builder.io, diseñado para proporcionar a los desarrolladores la capacidad de generar y probar código automáticamente. Genera casos de prueba mediante la comprensión de descripciones en lenguaje natural e itera el código hasta que todas las pruebas pasan, reduciendo...
hace 2 años
0122.4K
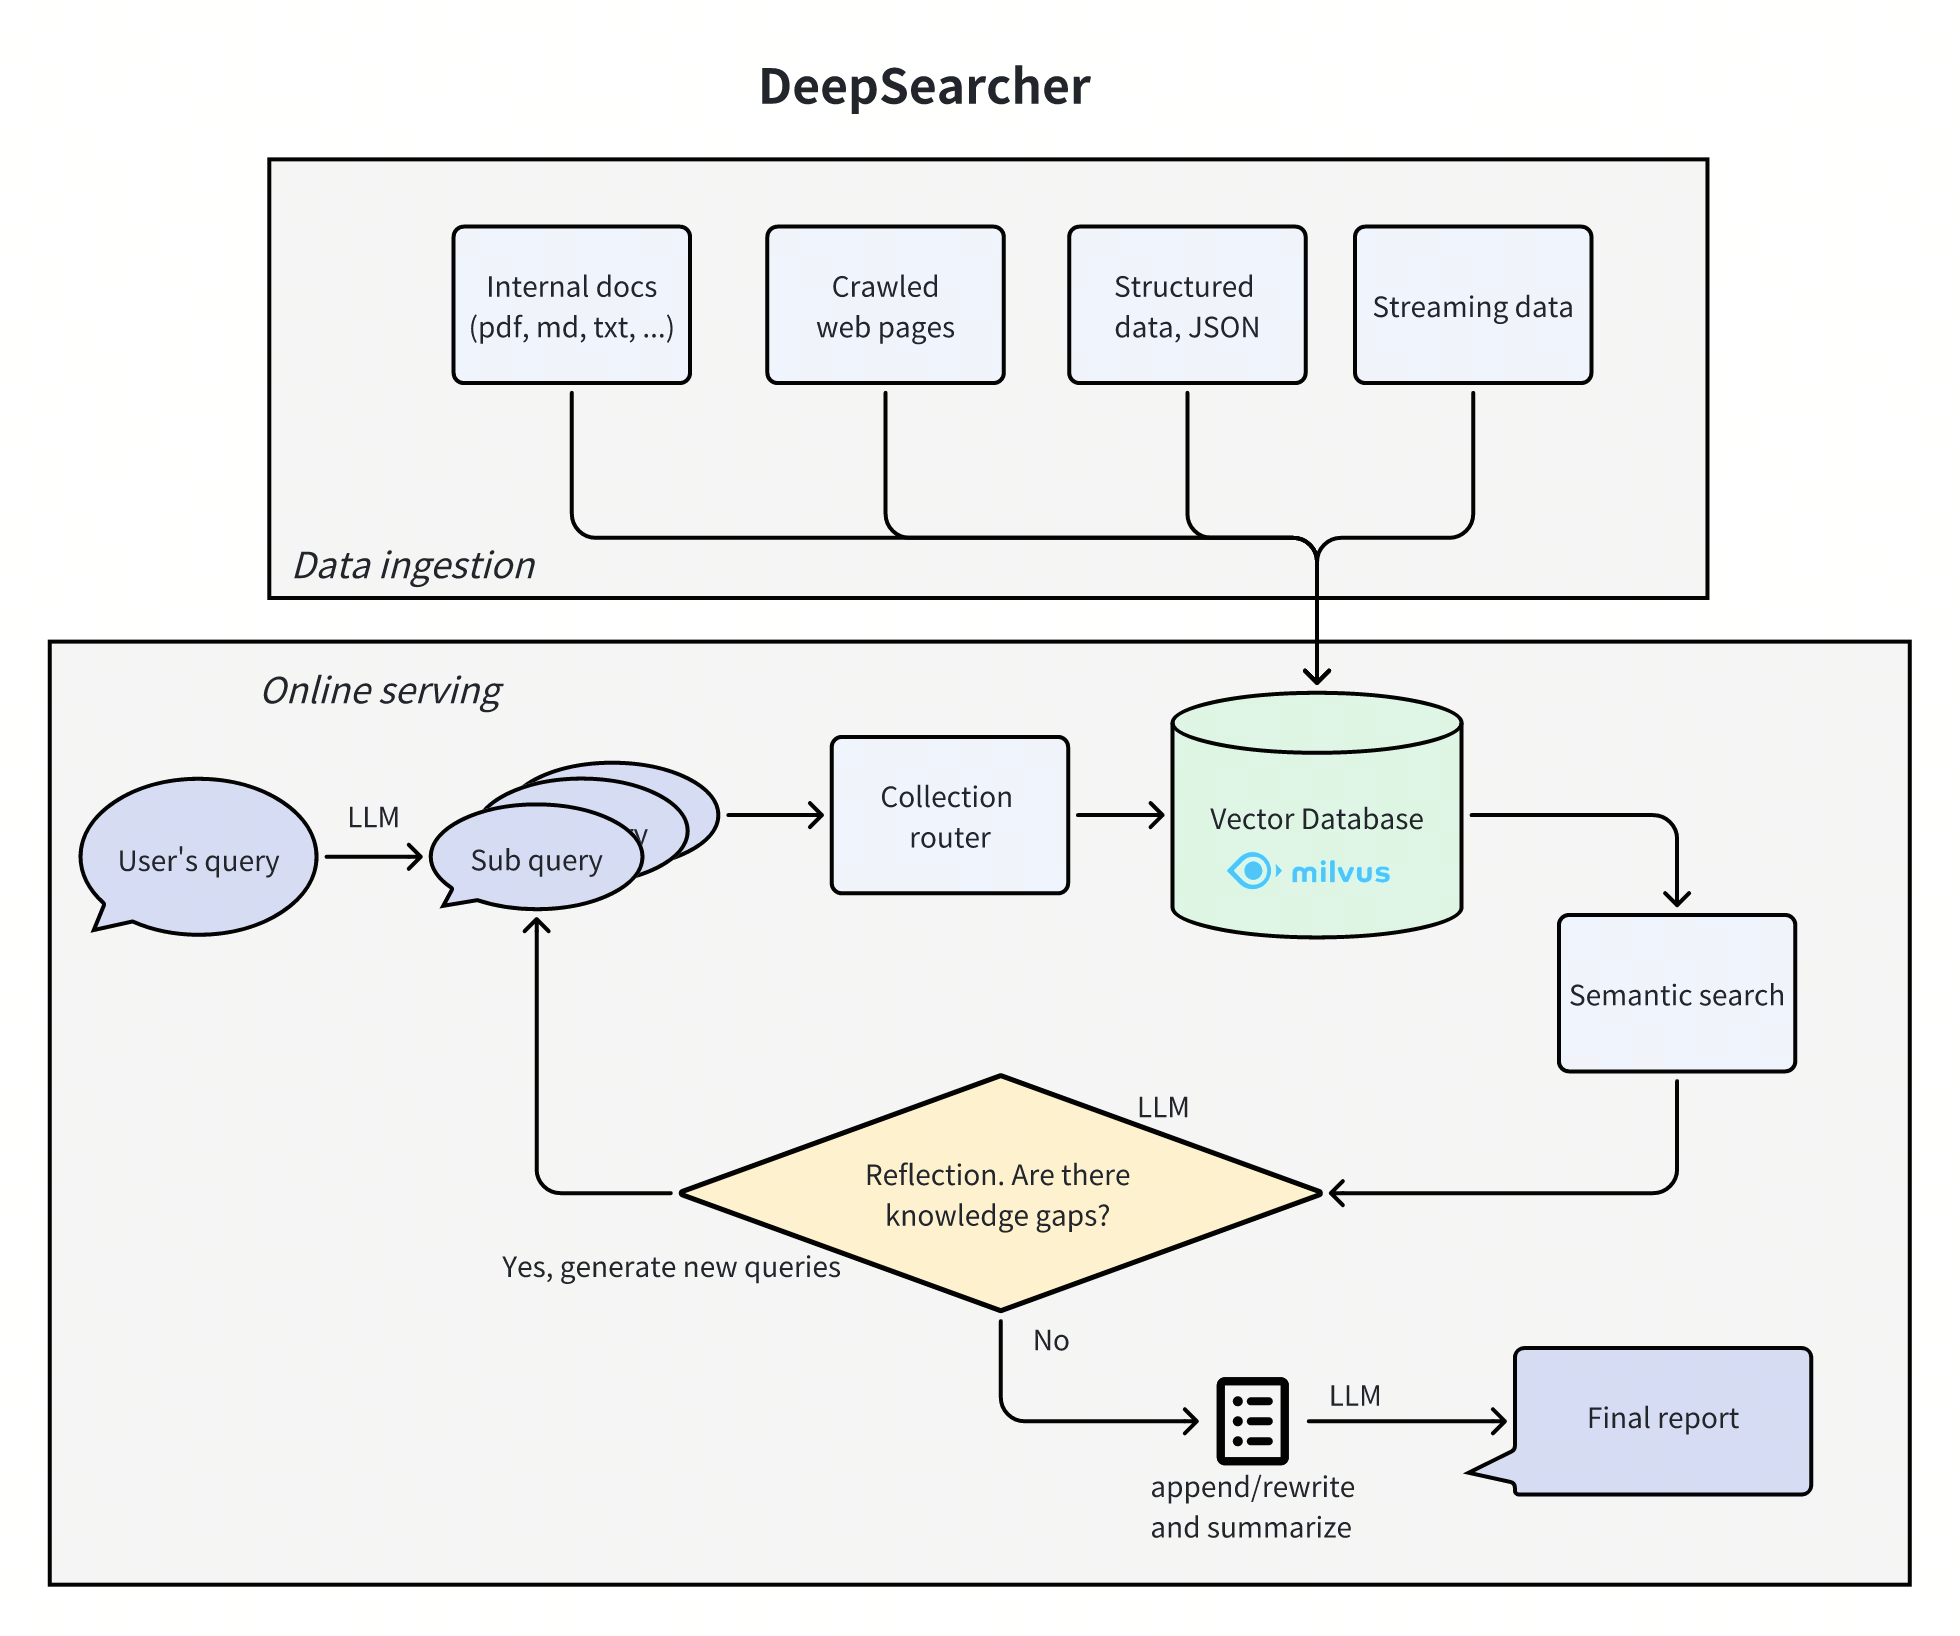
深度搜索器:利用本地知识进行深度推理搜索的开源项目

Deep Finder: proyecto de código abierto para la búsqueda por inferencia profunda mediante conocimiento local

Introducción exhaustiva Deep Searcher es una potente herramienta que combina grandes modelos lingüísticos (LLM) y bases de datos vectoriales diseñada para buscar, evaluar y razonar a partir de datos privados, proporcionando respuestas muy precisas e informes exhaustivos. Es adecuado para la gestión del conocimiento empresarial...
hace 2 años
0122.3K
MIDI-3D:从单张图片快速生成多物体3D场景的开源工具

MIDI-3D: herramienta de código abierto para generar rápidamente escenas 3D multiobjeto a partir de una sola imagen

Introducción general MIDI-3D es un proyecto de código abierto desarrollado por el equipo VAST-AI-Research para generar rápidamente escenas 3D con múltiples objetos a partir de una sola imagen para desarrolladores, investigadores y creadores. Esta herramienta se basa en la técnica de modelado de difusión multi-instancia...
hace 2 años
0122.1K
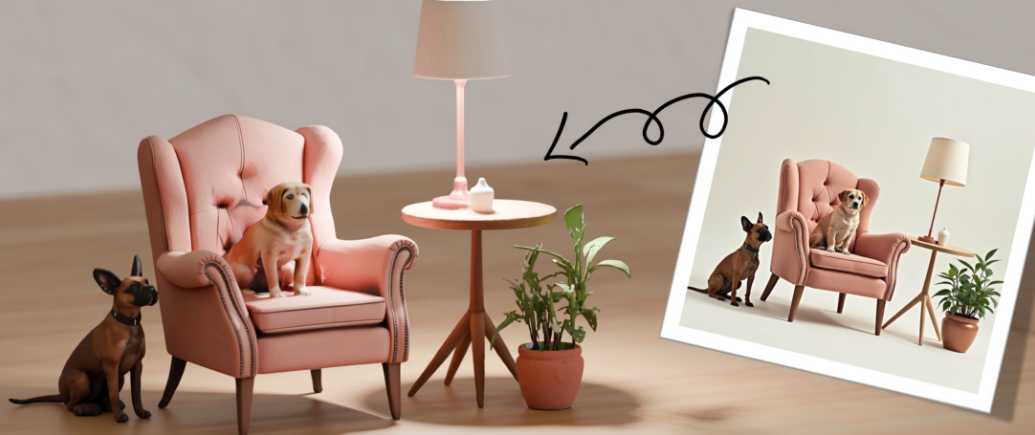
PhotoDoodle:文字指令为照片添加艺术涂鸦的AI工具

PhotoDoodle: herramienta de AI para añadir garabatos artísticos a fotos con comandos de texto

Introducción general PhotoDoodle es una herramienta de edición de imágenes de código abierto, desarrollada por ShowLab, centrada en la edición artística de fotos mediante tecnología de inteligencia artificial. Los usuarios pueden añadir un estilo de dibujos animados, efecto 3D, luz a fotos reales con sólo escribir...
hace 2 años
0122.1K
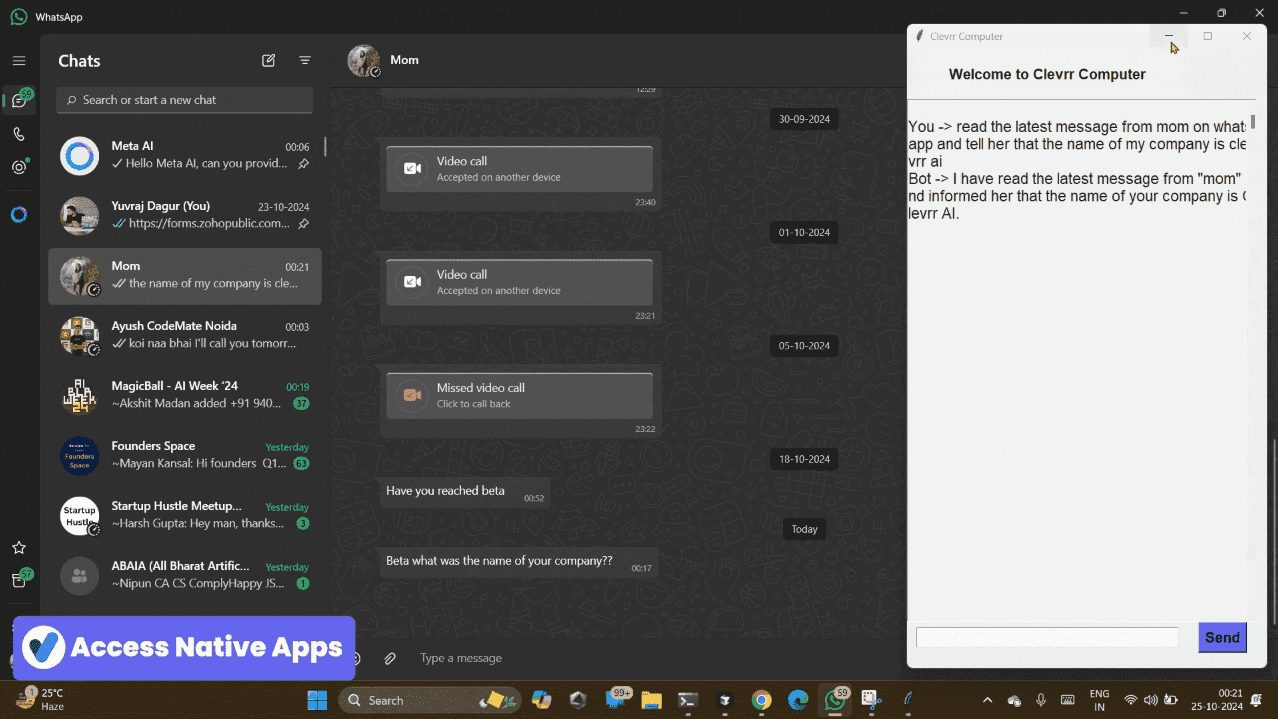
Clevrr Computer:使用 PyAutoGUI 库实现自动化桌面操作智能体

Clevrr Computer: Automatización de la inteligencia de manipulación del escritorio con la biblioteca PyAutoGUI

Introducción General Clevrr Computer es un proyecto de código abierto que tiene como objetivo automatizar las operaciones del sistema mediante el uso de la biblioteca PyAutoGUI. El proyecto se inspiró en Anthropic para diseñar un agente de automatización que pueda realizar operaciones de forma precisa y eficiente utilizando ...
hace 2 años
0122K
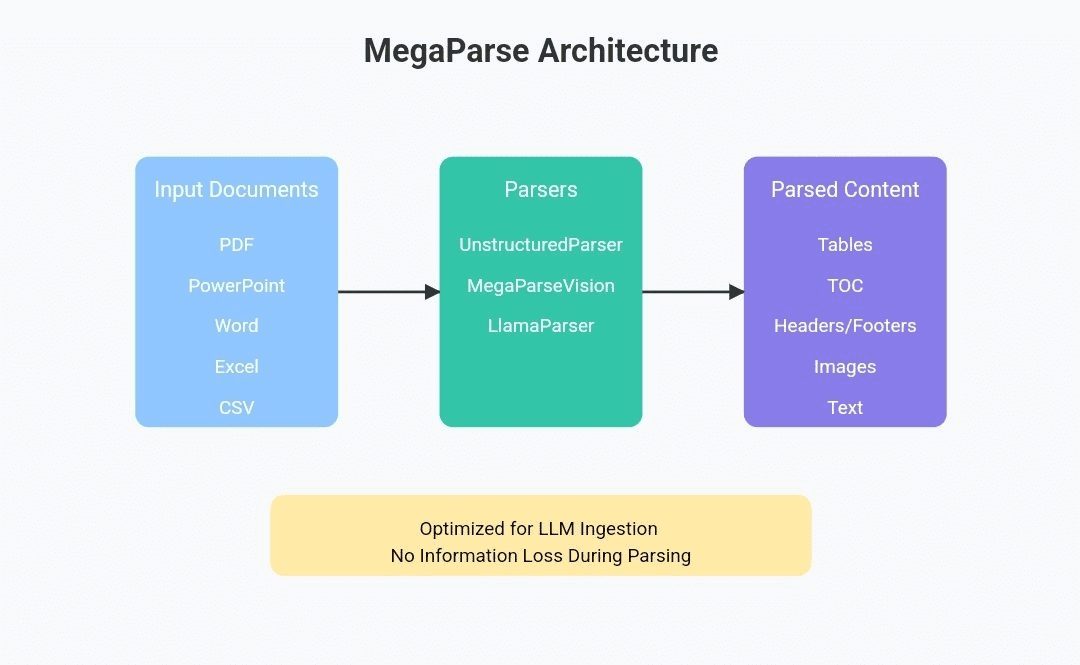
MegaParse:解析各类型文档为LLM可用数据,完整保留文档中的表格、图片等所有信息

MegaParse: analiza cada tipo de documento en datos disponibles en LLM, conservando toda la información del documento, como tablas e imágenes, en su totalidad.

Introducción general MegaParse es una potente y versátil herramienta de análisis sintáctico de documentos diseñada para optimizar el procesamiento de datos para el Large Language Model (LLM). Tanto si trabaja con texto, PDF, presentaciones de PowerPoint o documentos de Word, MegaParse...
hace 2 años
0121.9K
OpenManus-RL:微调大模型强化智能体推理与决策能力

OpenManus-RL: ajuste de grandes modelos para mejorar el razonamiento corporal inteligente y la toma de decisiones

Introducción general OpenManus-RL es un proyecto de código abierto desarrollado por UIUC-Ulab junto con el equipo OpenManus de la comunidad MetaGPT, alojado en GitHub. El proyecto mejora el modelado lingüístico a gran escala (LLM) mediante técnicas de aprendizaje por refuerzo (RL)....
hace 2 años
0121.7K
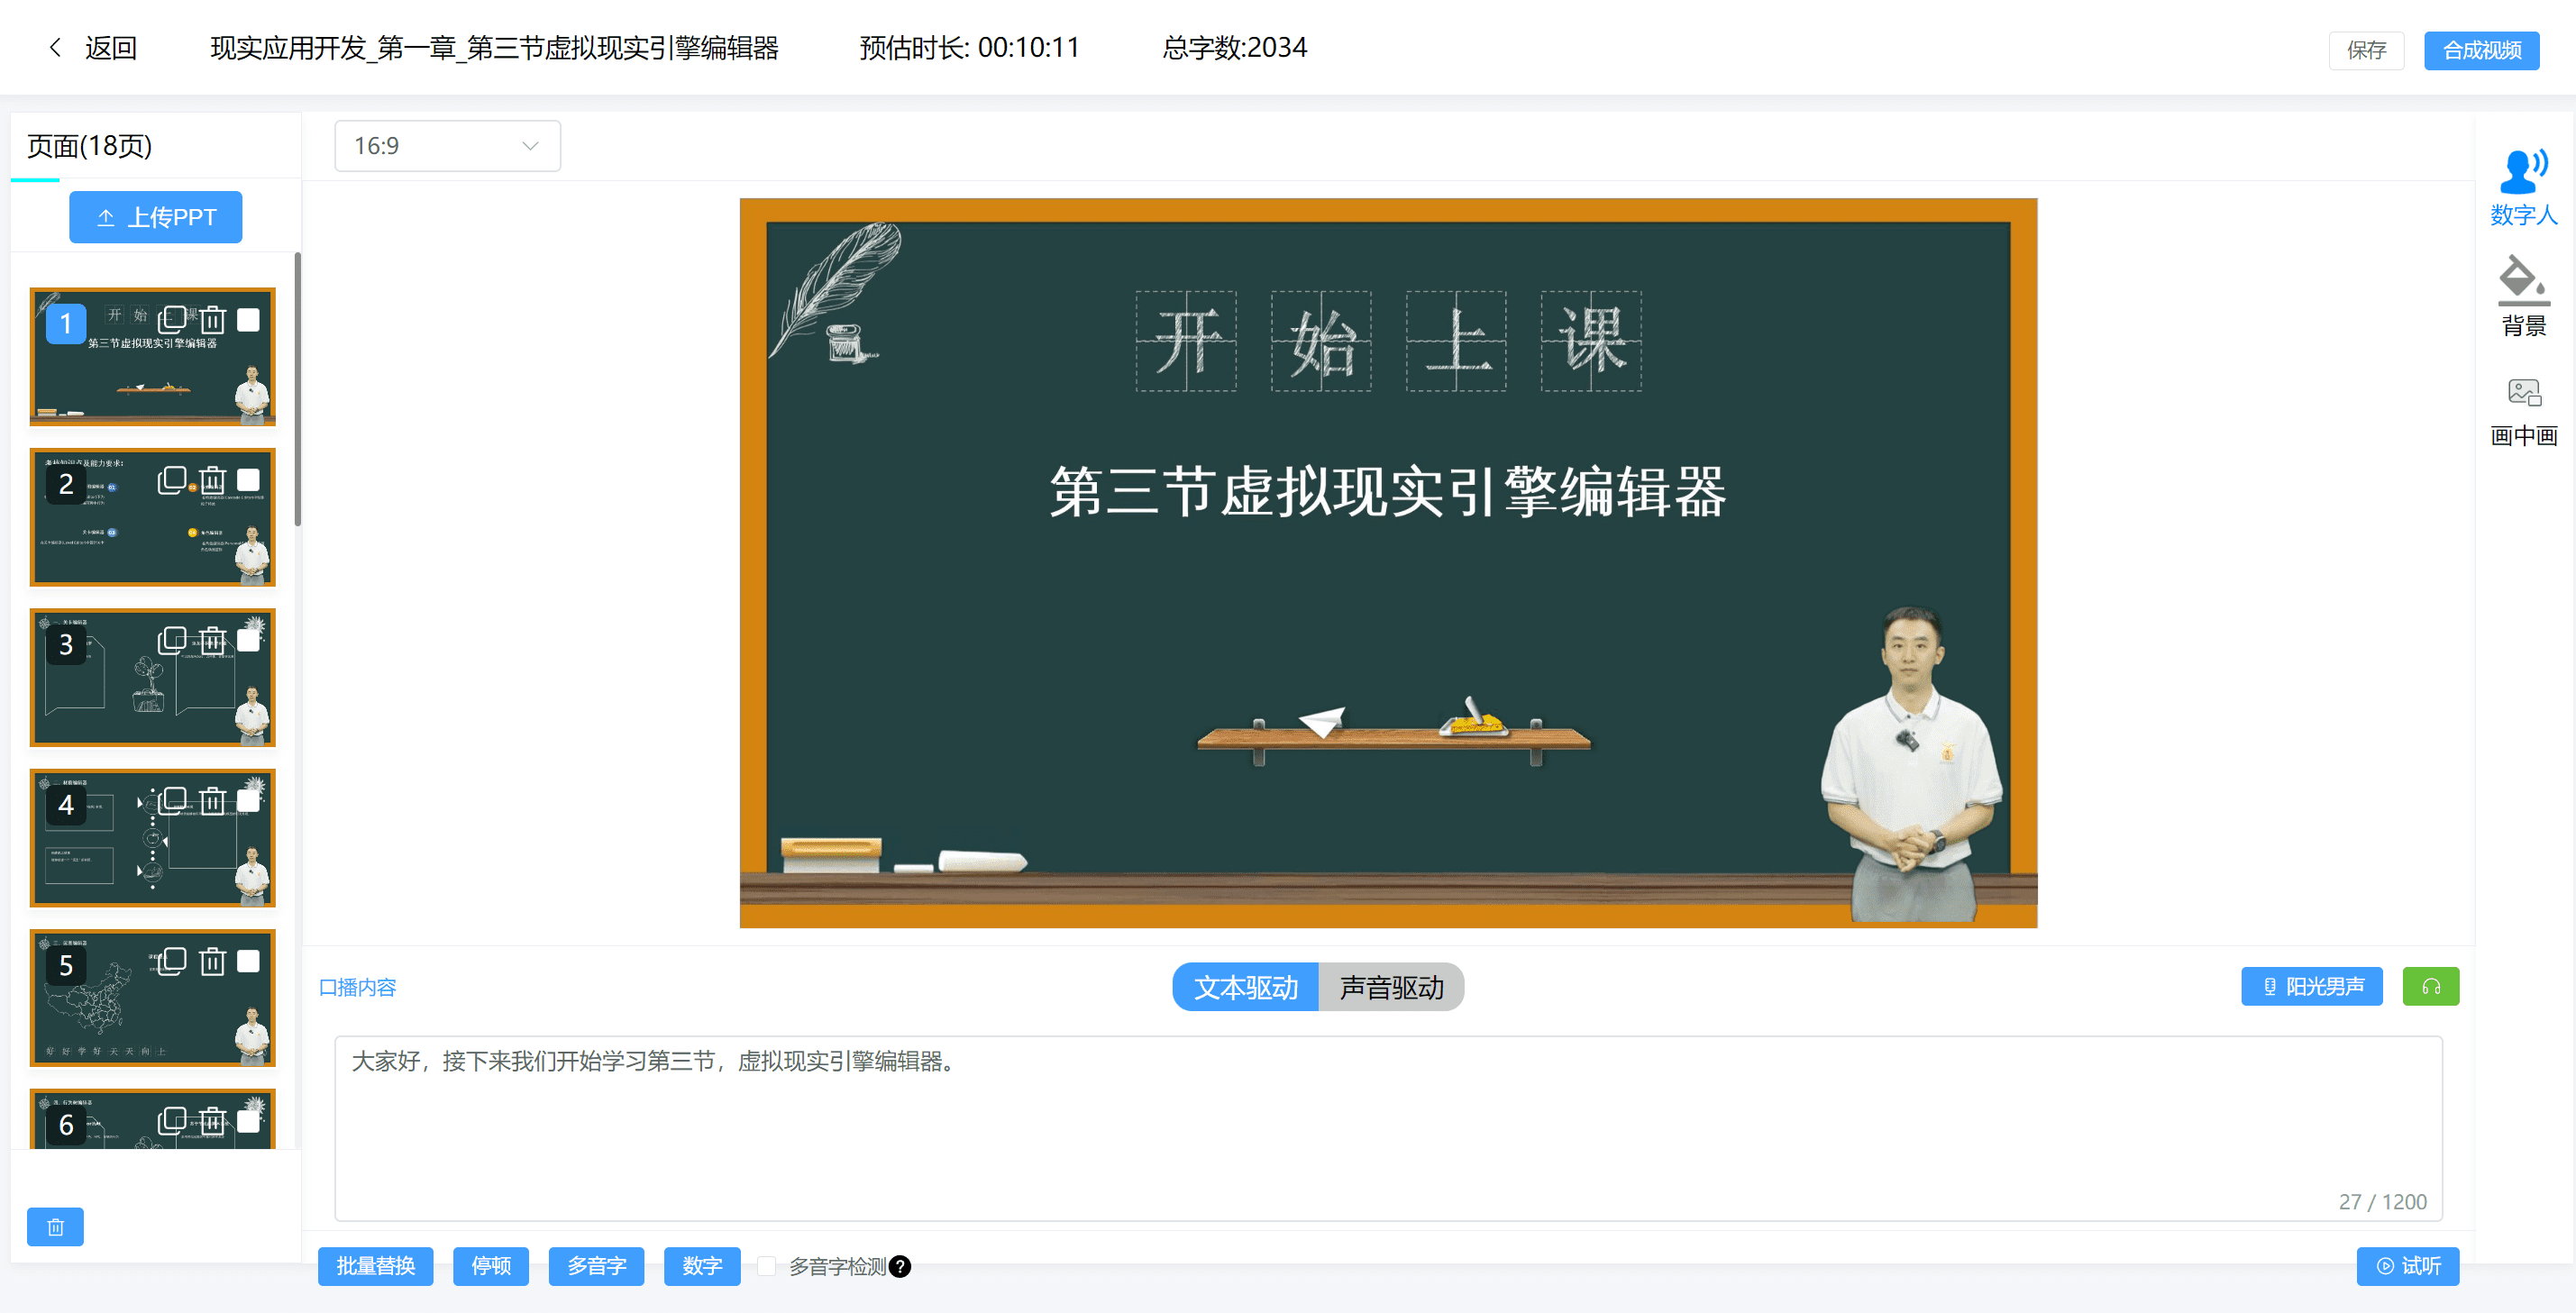
Easegen:开源数字人课程制作平台,PPT一键生成克隆数字人讲解视频

Easegen: plataforma de producción de cursos humanos digitales de código abierto, clonación de vídeos de conferencias humanas digitales de generación PPT con un solo clic

Introducción exhaustiva Easegen es una plataforma de creación de cursos humanos digitales de código abierto que tiene como objetivo mejorar la eficiencia de la producción y gestión de contenidos de enseñanza a través de la tecnología de IA. La plataforma proporciona una solución integral desde la producción de cursos, la gestión de vídeo hasta el interrogatorio inteligente, que permite a los usuarios crear cursos digitales de vídeo explicados por humanos....
hace 2 años
0121.7K
Perplexica:1比1复刻 Perplexity AI 功能和界面的开源AI搜索引擎

Perplexica: un motor de búsqueda de IA de código abierto que reproduce 1 a 1 las características y la interfaz de Perplexity AI.

Introducción general Perplexica es un motor de búsqueda de código abierto basado en IA diseñado para proporcionar respuestas que profundizan en Internet. Utiliza algoritmos avanzados de aprendizaje automático, como la búsqueda por similitud y técnicas de incrustación, para optimizar los resultados de búsqueda y ofrecer respuestas claras con fuentes citadas.Perple...
hace 2 años
0121.5K
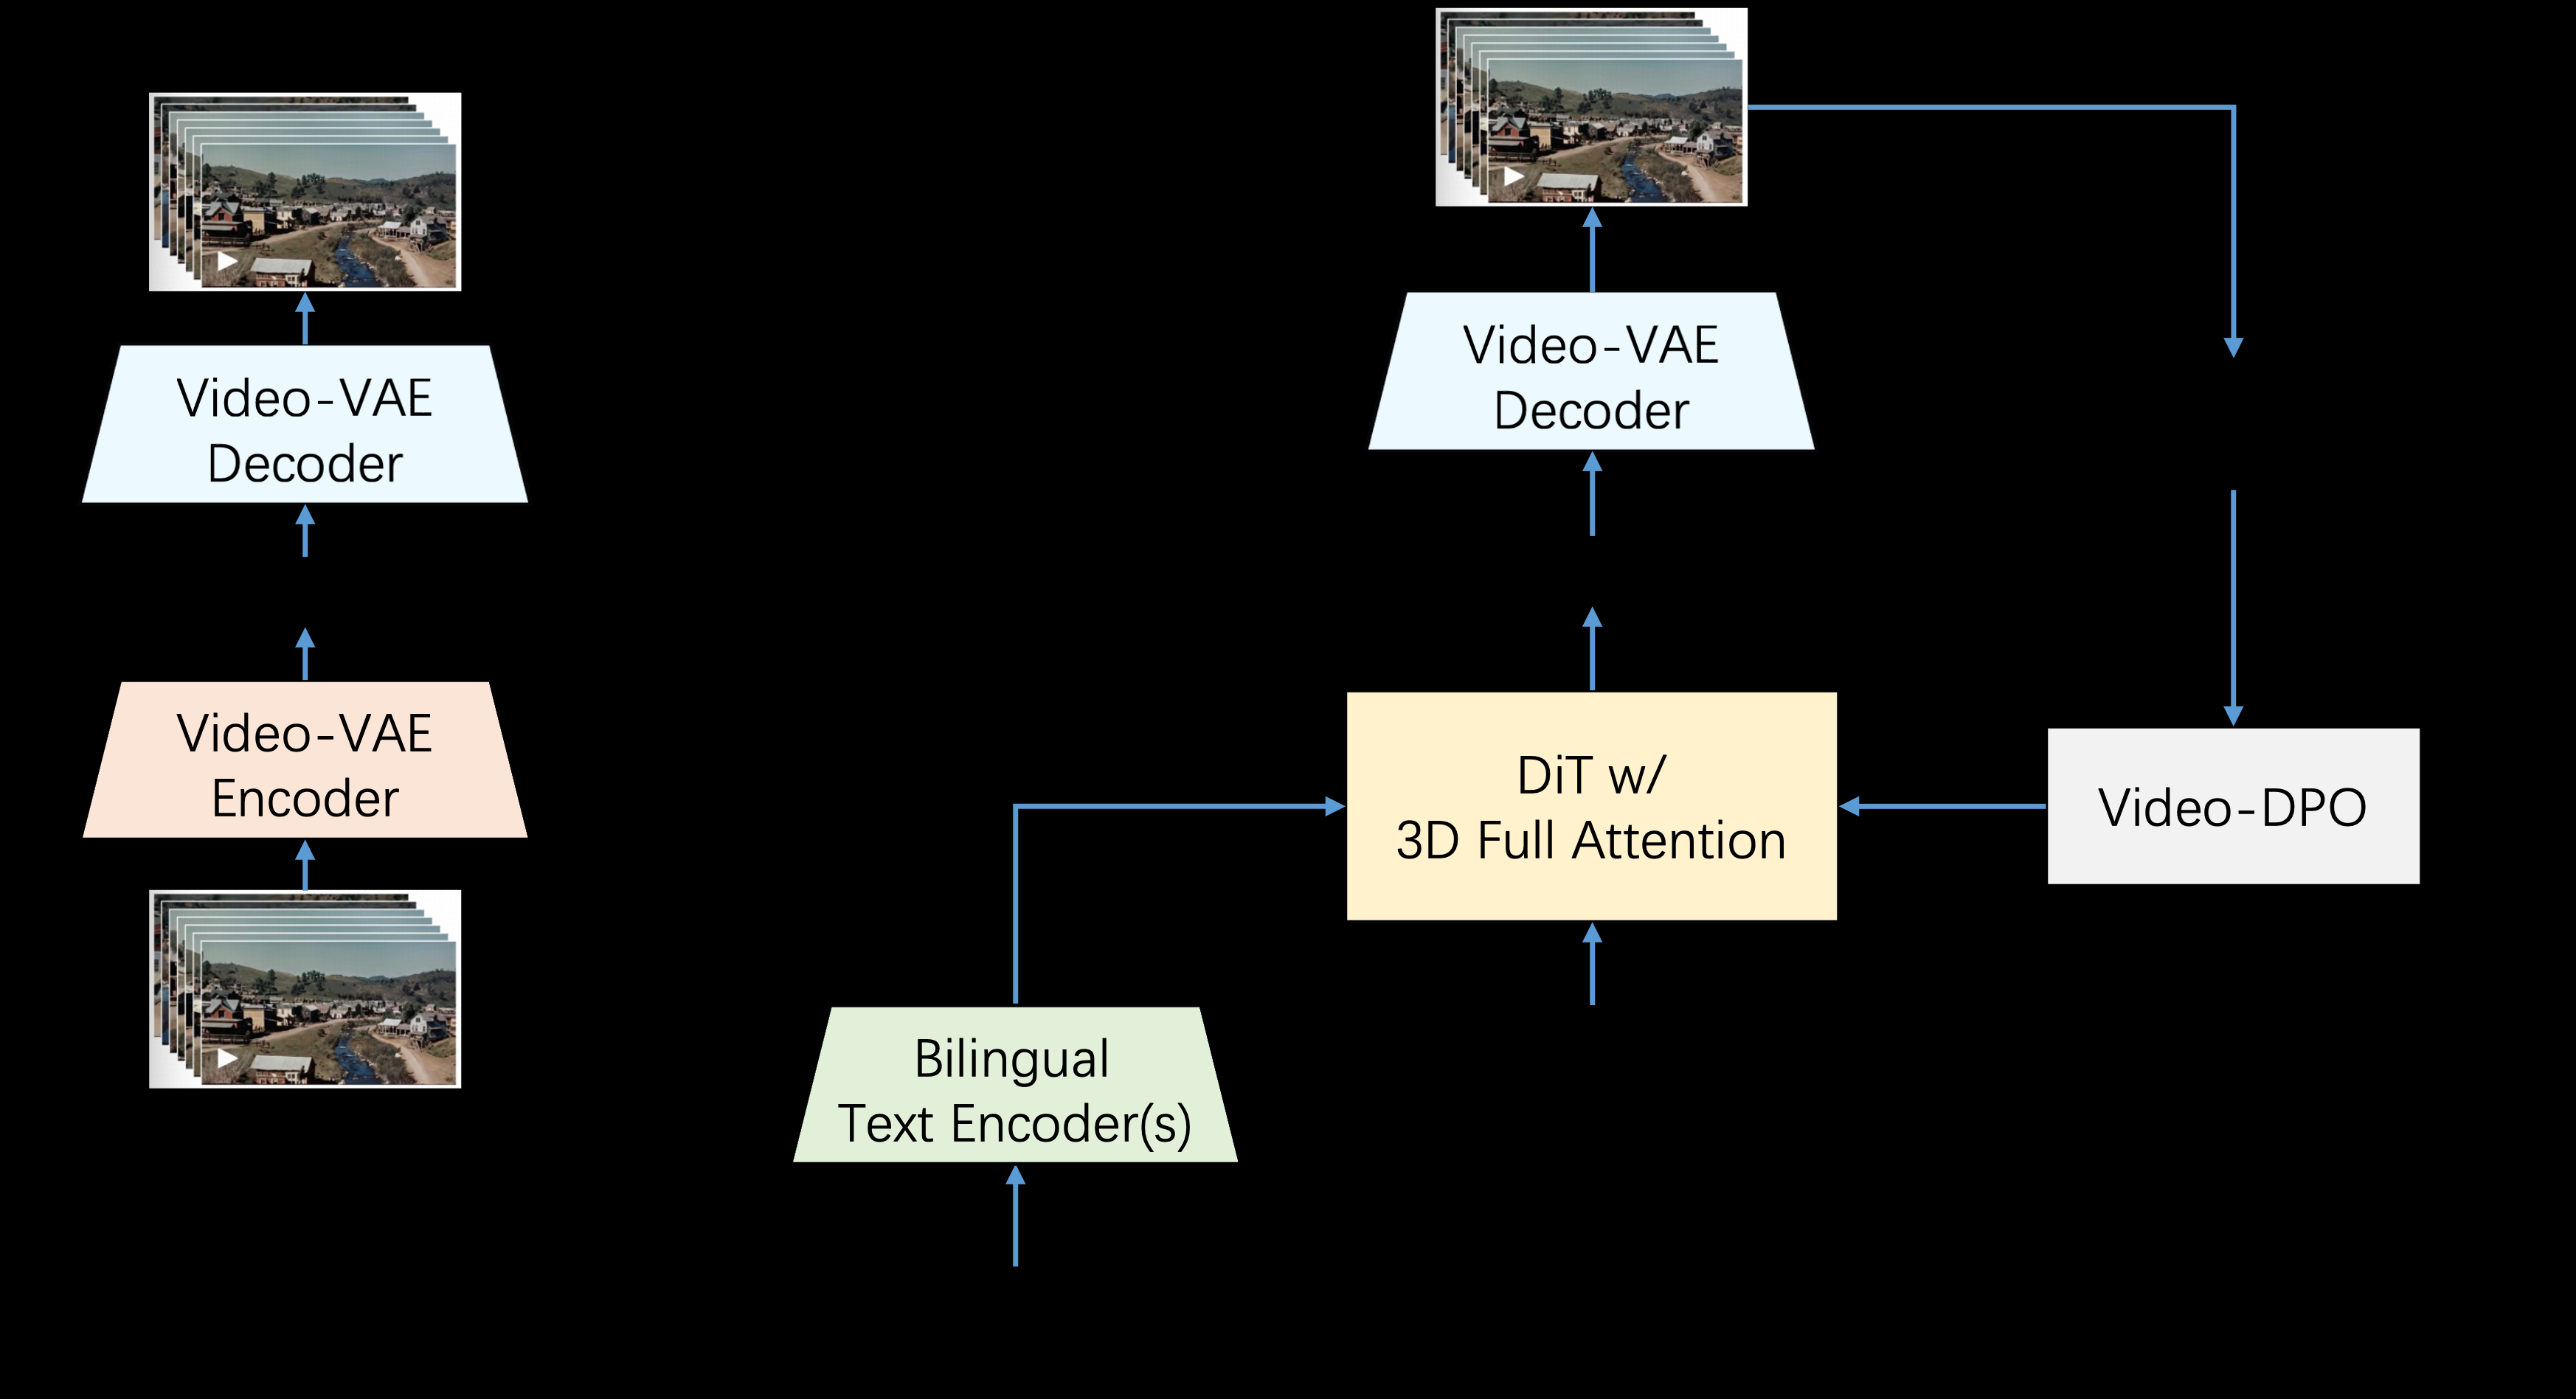
Step-Video-T2V:支持多语言输入和长视频生成的文生视频模型

Step-Video-T2V: un modelo de vídeo de Vincennes que admite la entrada multilingüe y la generación de vídeos largos

Introducción completa Step-Video-T2V es un modelo avanzado de conversión de texto a vídeo de StepFun AI (StepFun Star). El modelo tiene 3.000 millones de parámetros y es capaz de generar vídeos de hasta 204 fps. Con un Auto-Encoder Variable (VAE) profundamente comprimido, el modelo...
hace 2 años
0121.4K
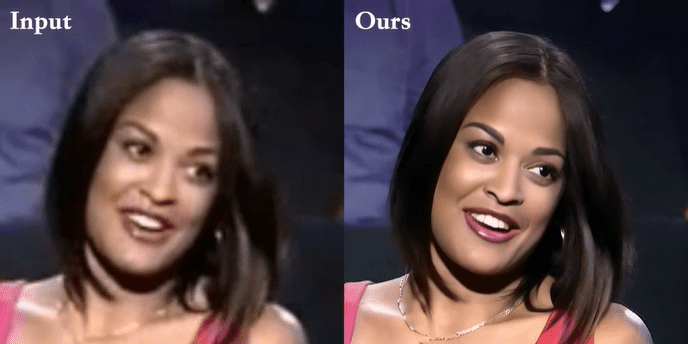
SVFR:实现视频人脸修复的统一框架,修复黑白、模糊的人像老视频

SVFR: un marco unificado para implementar la reparación de rostros en vídeo, reparar vídeos en blanco y negro, retratos borrosos y antiguos

Introducción exhaustiva SVFR (Stable Video Face Restoration) es un marco unificado para la restauración de rostros en vídeo que admite tareas de restauración básica de rostros (BFR), coloreado, reparación y su combinación. El marco utiliza priors generativos y cinemáticos unificando...
hace 2 años
0121.4K
Maestro:简化主流开源视觉语言模型微调过程的工具

Maestro: una herramienta para simplificar el proceso de ajuste de modelos de los principales lenguajes visuales de código abierto

Introducción Maestro es una herramienta desarrollada por Roboflow para simplificar y acelerar el proceso de ajuste fino de modelos multimodales, de modo que todo el mundo pueda entrenar sus propios macromodelos visuales. Proporciona recetas ya preparadas para el ajuste fino de modelos de lenguaje visual (VLM) populares como F...
hace 2 años
0121.4K
WikiChat:使用维基百科数据检索知识的聊天工具

WikiChat: una herramienta de chat para recuperar conocimientos a partir de datos de Wikipedia

Introducción general WikiChat es un chatbot experimental desarrollado en la Universidad de Stanford que pretende mejorar la factualidad de los grandes modelos lingüísticos recuperando datos de Wikipedia. Los grandes modelos lingüísticos (como ChatGPT y GPT-4) tienden a procesar información actualizada o temas menos populares cuando...
hace 2 años
0121.2K
NextChat:兼容多平台的本地化AI聊天助手

NextChat: un asistente de chat con inteligencia artificial compatible con múltiples plataformas

Introducción general NextChat es un revolucionario servicio de chat con IA que permite a los usuarios implementar servicios de chat con los mejores modelos lingüísticos de su clase, como GPT-3, GPT-4, GPT-4.5 y Gemini Pro. Ofrece una elegante interfaz de usuario, funciones de colaboración, integraciones, plantillas y...
hace 2 años
0121.2K
VoiceCraft:开源零样本语音克隆与文本转语音工具

VoiceCraft: herramienta de código abierto de clonación de voz sin muestras y conversión de texto a voz

Introducción completa VoiceCraft es una herramienta de código abierto para la edición del habla y la síntesis del habla sin muestras basada en el modelo de lenguaje del códec neural. Emplea un innovador método de generación de secuencias codificadas que permite realizar operaciones de inserción, eliminación y sustitución en secuencias de habla existentes para generar un habla editada natural y coherente....
hace 2 años
0121.1K
Social Media Agent:社交媒体智能助手,自动生成和管理社交媒体内容

Social Media Agent: un asistente inteligente para las redes sociales que genera y gestiona automáticamente los contenidos de las mismas.

Introducción general Social Media Agent (Agente de Medios Sociales) es un proyecto de código abierto que gestiona la información de interacción mediante el nuevo Agent Inbox, diseñado para ayudar a los usuarios a automatizar la generación y gestión de contenidos de medios sociales. El proyecto está desarrollado por el equipo LangChain...
hace 2 años
0121.1K
Open Deep Research:LangChain开源的深度研究智能助手

Open Deep Research: el asistente inteligente de código abierto de LangChain para la investigación profunda

Introducción exhaustiva Open Deep Research es un asistente de investigación basado en web capaz de generar informes de investigación exhaustivos sobre cualquier tema. El sistema utiliza un flujo de trabajo de "planificar y hacer" que permite a los usuarios planificar y revisar la estructura del informe antes de pasar a la fase de investigación, que lleva mucho tiempo...
hace 2 años
0121.1K
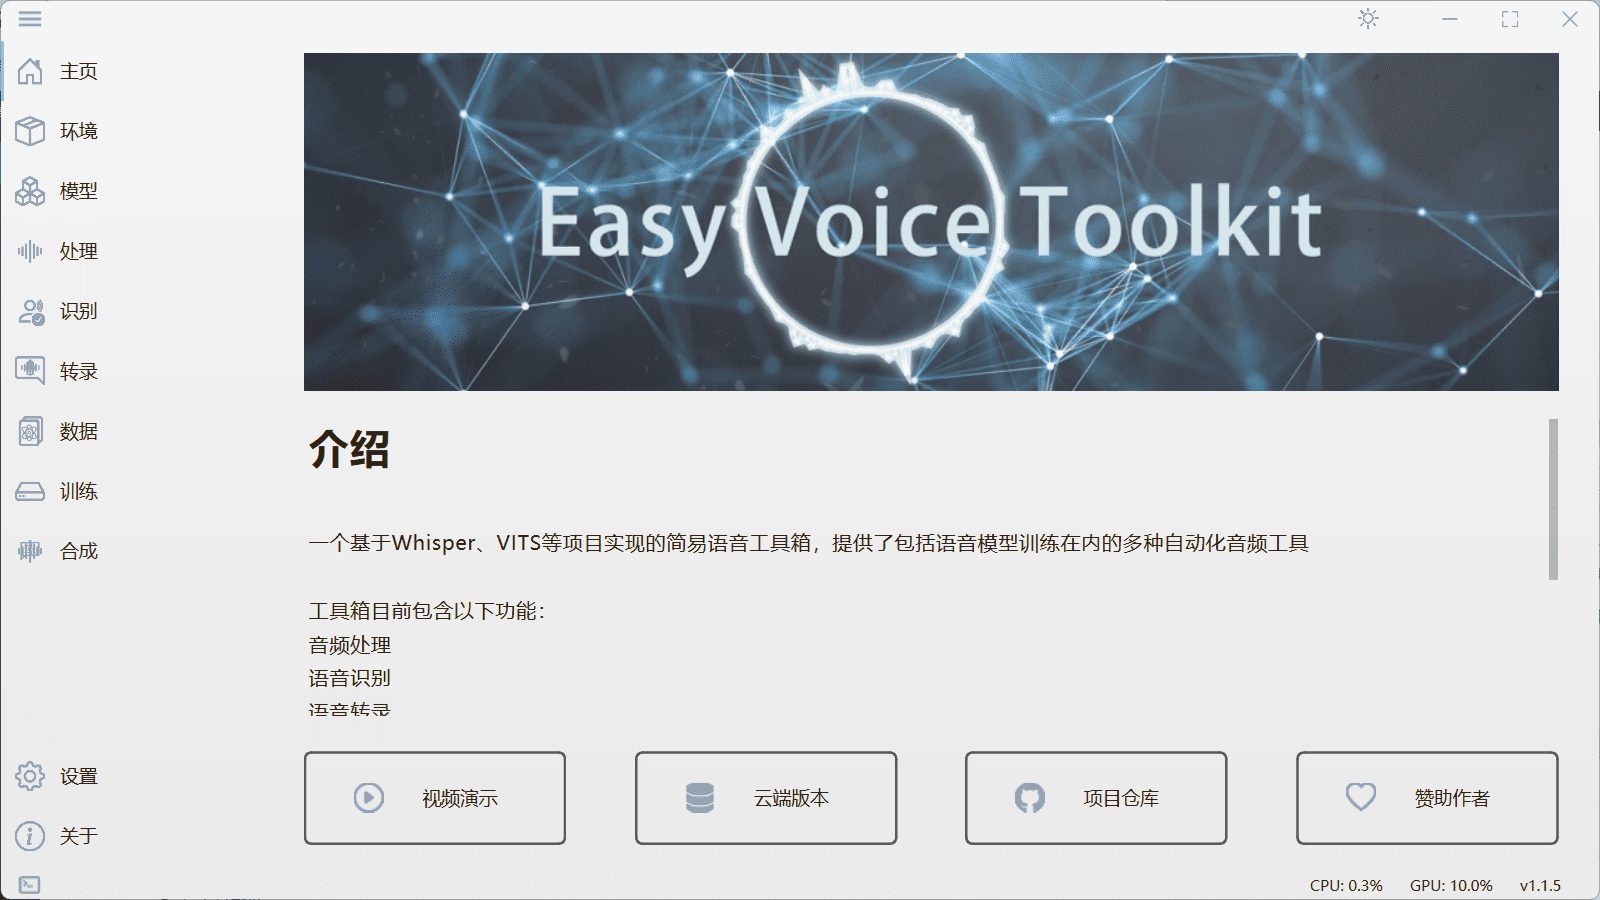
Easy Voice Toolkit:本地部署的AI语音工具箱

Easy Voice Toolkit: kit de herramientas de voz AI para implantación local

Introducción exhaustiva Easy-Voice-Toolkit es un conjunto de herramientas multifuncionales basado en el Open Source Speech Project, que proporciona una amplia gama de herramientas de audio automatizadas para el reconocimiento del habla, la transcripción del habla, la conversión del habla, la creación de conjuntos de datos y el entrenamiento de modelos. Los usuarios pueden utilizar estas herramientas de forma selectiva según sus necesidades...
hace 2 años
0121.1K
VideoMind:视频按时间戳定位内容与问答的开源项目

VideoMind: proyecto de código abierto de posicionamiento de vídeos por marcas de tiempo y preguntas y respuestas

Introducción general VideoMind es una herramienta de IA multimodal de código abierto centrada en la inferencia, las preguntas y respuestas y la generación de resúmenes para vídeos largos. Fue desarrollada por Ye Liu, de la Universidad Politécnica de Hong Kong, y un equipo del Show Lab de la Universidad Nacional de Singapur. La herramienta imita la comprensión humana del vídeo...
hace 1 año
0121K
LongWriter:智谱推出生成超长文本的强大模型,支持一次对话生成10000+字

LongWriter: Wisdom Spectrum lanzó un potente modelo de generación de textos ultralargos, que permite generar más de 10.000 palabras en una sola conversación.

Introducción LongWriter es una potente herramienta de generación de textos largos desarrollada por el Grupo de Investigación de Minería de Datos de la Universidad de Tsinghua (THUDM). La herramienta se basa en el avanzado Long Context Language Model (LLM) y es capaz de generar textos largos de más de 10.000 palabras.LongWriter...
hace 2 años
0120.8K
Dify-Plus:为Dify开发的企业内部管理后台

Dify-Plus: un backend de gestión local para Dify

Introducción completa Dify-Plus es una plataforma de desarrollo de aplicaciones de IA basada en el desarrollo secundario del proyecto de código abierto Dify. Añade un nuevo centro de gestión basado en Dify y optimiza la funcionalidad para escenarios empresariales. El proyecto fue inicialmente para uso interno de las empresas , y más tarde se encontró que la comunidad tiene necesidades similares,...
hace 2 años
0120.8K
Cosmos:世界基础模型,构建物理世界的人工智能基础模型平台

Cosmos: World Base Model, una plataforma para construir modelos base de IA del mundo físico.

Introducción completa NVIDIA Cosmos es una plataforma de modelado basada en mundos para desarrolladores, diseñada específicamente para ayudar a los desarrolladores de IA de física a crear sus sistemas de IA de física mejor y más rápido. La plataforma ofrece una amplia gama de modelos preentrenados, incluidos modelos de difusión y autorregresivos...
hace 2 años
0120.8K
Chunkr:使用视觉模型进行文档摄取以及根据文本段落层级智能分块的一体化服务

Chunkr: un servicio todo en uno que utiliza modelos visuales para la ingestión de documentos y la agrupación inteligente basada en la jerarquía de párrafos de texto.

Introducción general Chunkr es una API autoalojada dedicada a convertir archivos PDF, PPTX, DOCX y Excel en datos aptos para su uso en RAG (Retrieval Augmented Generation) y LLM (Large Language Modelling). El proyecto fue desarrollado por Lumina...
hace 2 años
0120.7K
PantoMatrix(EMAGE):全身手势生成框架,从音频生成全身手势的3D动画框架

PantoMatrix (EMAGE): marco de generación de gestos de cuerpo entero, marco de animación 3D para generar gestos de cuerpo entero a partir de audio.

Introducción exhaustiva PantoMatrix es un marco avanzado de generación de gestos de cuerpo completo capaz de generar movimientos humanos completos a partir de audio y gestos parciales, incluidos movimientos faciales, corporales parciales, de manos y de cuerpo completo. El marco utiliza los últimos conjuntos de datos multimodales y técnicas de aprendizaje profundo para proporcionar...
hace 2 años
0120.7K
Infinity:生成高分辨率图像的比特自回归建模,实现无限制高分辨率图像生成

Infinity: modelización autorregresiva por bits de la generación de imágenes de alta resolución para una generación ilimitada de imágenes de alta resolución

Introducción general Infinity es un innovador marco de generación de imágenes de alta resolución desarrollado por el equipo de FoundationVision. El proyecto rompe con las limitaciones de los modelos tradicionales de generación de imágenes a través de un innovador enfoque de modelado autorregresivo visual a nivel de bits.Las principales características de Infinity...
hace 2 años
0120.6K
GAG:利用大模型模拟人类行为生成社交关系图谱

GAG: generación de un gráfico de relaciones sociales mediante un gran modelo para simular el comportamiento humano

Introducción general GraphAgent es un framework de código abierto alojado en GitHub y desarrollado por Ji-Cather. Utiliza el Large Language Model (LLM) para simular el comportamiento humano y generar gráficos sociales dinámicos con atributos textuales. Esta herramienta es adecuada para los...
hace 2 años
0120.6K
E2B Open Computer Use:E2B沙盒中安全的运行AI操作系统

Uso de ordenadores abiertos E2B: ejecución segura de un sistema operativo de inteligencia artificial en el espacio aislado E2B

Introducción general E2B Open Computer Use es un proyecto de código abierto cuyo objetivo es proporcionar una experiencia segura de uso de ordenadores Linux basada en la nube a través de E2B Desktop Sandbox.E2B Sandbox proporciona un entorno gráfico de escritorio que los usuarios...
hace 2 años
0120.5K
DocAgent:自动生成Python代码文档的智能工具

DocAgent: una herramienta inteligente para automatizar la documentación de código Python

Introducción general DocAgent es una herramienta de código abierto de generación de documentación de código Python desarrollada por Meta AI. Utiliza la colaboración multi-inteligencia y el análisis jerárquico de código para generar automáticamente anotaciones de documentos de alta calidad y conscientes del contexto para bases de código Python (d...
hace 2 años
0120.5K
Vision Agent:解决多种视觉目标检测任务的视觉智能体

Vision Agent: una inteligencia visual para resolver múltiples tareas de detección visual de objetivos

Introducción general Vision Agent es un proyecto de código abierto desarrollado por LandingAI (Team Enda Wu) y alojado en GitHub, diseñado para ayudar a los usuarios a generar rápidamente código para resolver tareas de visión por ordenador. Utiliza un marco de agentes avanzado y modelos multimodales...
hace 2 años
0120.4K
TestDriver:使用AI自动测试软件的智能工具

TestDriver: una herramienta inteligente para automatizar las pruebas de software mediante IA

Introducción general TestDriver es un sitio web que utiliza tecnología de inteligencia artificial para ayudar a los desarrolladores a probar software. Automatiza la tarea de probar software simulando acciones humanas, como hacer clic con el ratón o teclear texto. En el corazón del sitio hay un "ordenador que utiliza un agente de IA" que funciona como una persona real...
hace 2 años
0120.4K
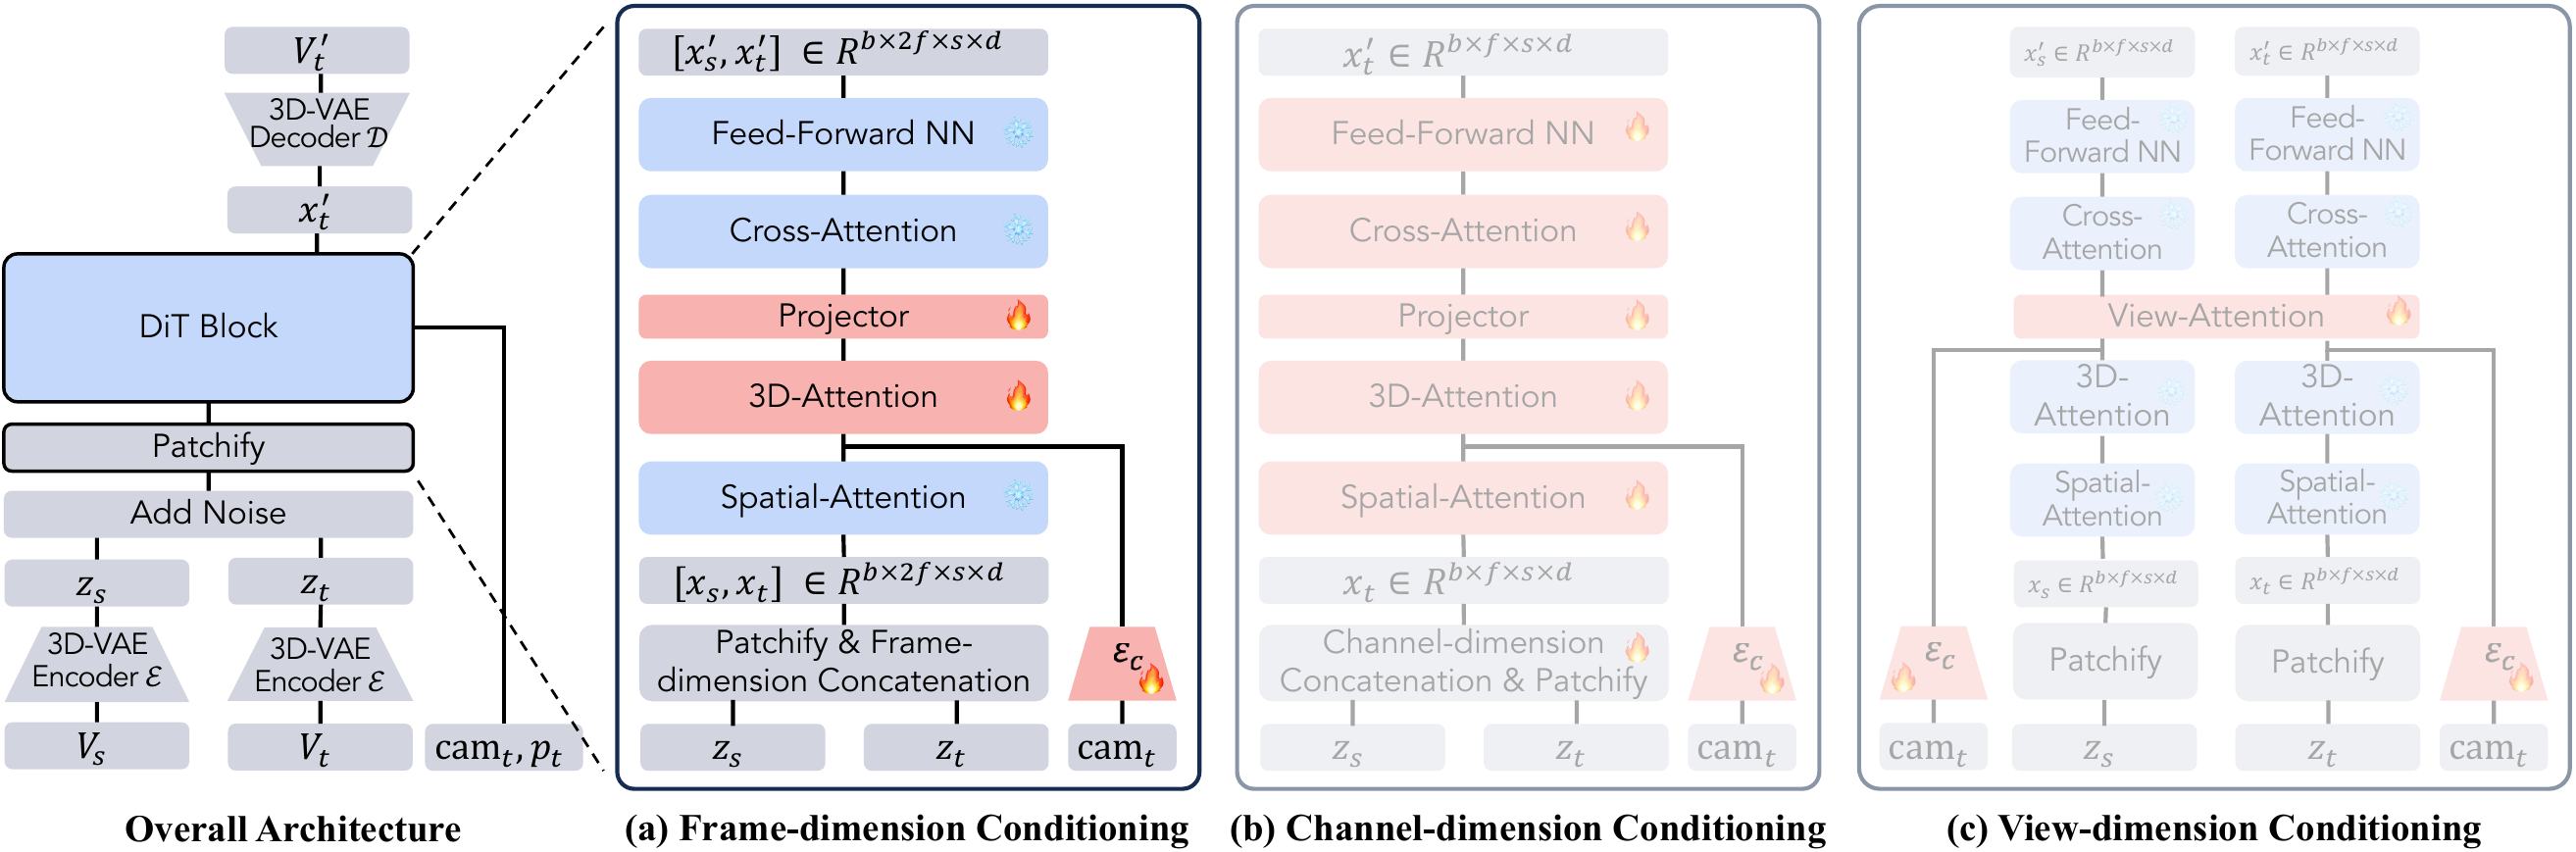
ReCamMaster:从单一视频生成多视角视频的渲染工具

ReCamMaster: herramienta de renderizado para generar vídeos multivista a partir de un único vídeo

Introducción general ReCamMaster es una herramienta de procesamiento de vídeo de código abierto, cuya función principal es generar nuevas vistas de cámara a partir de un único vídeo. Los usuarios pueden especificar la pista de la cámara y volver a renderizar el vídeo para obtener una imagen dinámica con diferentes ángulos. Está desarrollado por un equipo de la Universidad de Zhejiang y Racer Technology, basado en...
hace 2 años
0120.4K
VBDeepSeek:使用DeepSeek生成四级单词学习资料的开源工具

VBDeepSeek: una herramienta de código abierto para generar materiales de estudio de palabras de 4º curso utilizando DeepSeek.

Introducción completa "Vocabulary Book by DeepSeek" es un proyecto de código abierto desarrollado sobre la base del gran modelo de DeepSeek, con el objetivo de ayudar a los estudiantes de inglés a dominar el vocabulario del nivel 4 de inglés universitario (CET-4) de manera eficiente. El proyecto está alojado en GitHub...
hace 2 años
0120.3K
Diffbot GraphRAG LLM:依赖外部实时知识图谱数据的LLM推理服务

Diffbot GraphRAG LLM: servicio de razonamiento LLM basado en datos externos de grafos de conocimiento en tiempo real.

Introducción exhaustiva Diffbot LLM Reasoning Server es un innovador sistema de modelado lingüístico a gran escala con optimizaciones y mejoras especiales basadas en la arquitectura del modelo LLama. La característica más importante del proyecto es la integración de Knowledge Graph en tiempo real con la generación mejorada de recuperación...
hace 2 años
0120.2K
ai-gradio:轻松集成多种AI模型,基于Gradio构建多模态应用

ai-gradio: integra fácilmente múltiples modelos de IA y crea aplicaciones multimodales basadas en Gradio

Introducción general ai-gradio es un conjunto de herramientas Python de código abierto diseñado para ayudar a los desarrolladores a integrar y utilizar fácilmente múltiples modelos de IA. Construido sobre Gradio, el proyecto proporciona una interfaz unificada para soportar múltiples modelos y servicios de IA. Ya sea texto, voz o vídeo...
hace 2 años
0120.2K
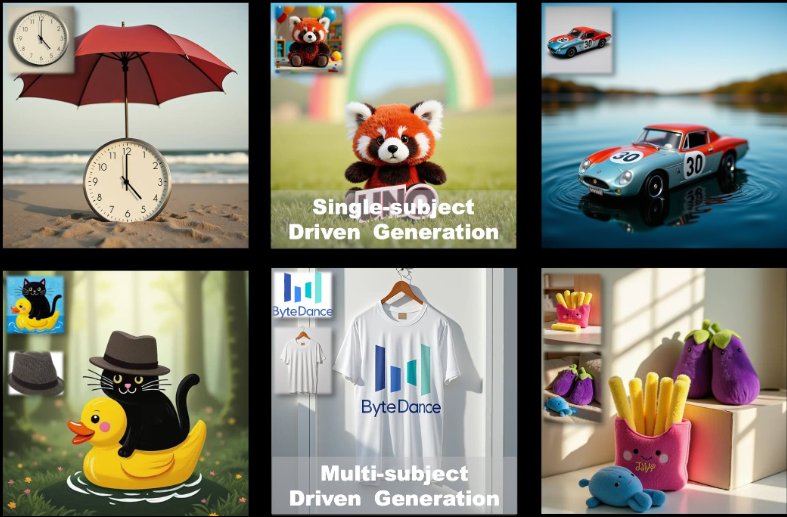
UNO:支持单主体和多主体定制化图像生成工具(适合电商配图)

UNO: compatibilidad con herramientas de generación de imágenes personalizadas mono y multisujeto (adecuadas para gráficos de comercio electrónico).

UNO es un marco de generación de imágenes de código abierto desarrollado por el equipo de creación inteligente ByteDance. Se basa en el modelo FLUX.1 y se centra en la generación de imágenes personalizadas de un único sujeto y de varios sujetos mediante un enfoque de generalización de "menos a más".UNO utiliza el transformador de difusión...
hace 2 años
0120.1K
ModelBest(面壁智能):全球领先的轻量高性能端侧大模型

ModelBest: el líder mundial en modelos grandes ligeros y de alto rendimiento de extremo a extremo

Introducción general ModelBest es una empresa centrada en el desarrollo de grandes modelos ligeros y de alto rendimiento, y se dedica a aplicar tecnologías avanzadas de IA a la electrónica de consumo convencional y a todo tipo de dispositivos finales de la vida cotidiana. Su serie MiniCPM de modelos finales con extrema potencia aritmética y eficiencia en el uso de la memoria...
hace 2 años
0120K
DeepGEMM:高效支持FP8矩阵运算的开源库(DeepSeek 开源周第三天)

DeepGEMM: Una biblioteca de código abierto con soporte eficiente para operaciones matriciales FP8 (DeepSeek Open Source Week Day 3)

Introducción general DeepGEMM es una biblioteca FP8 GEMM (Generalised Matrix Multiplication) de código abierto desarrollada por el equipo DeepSeek, centrada en proporcionar un soporte eficiente de aritmética matricial. Está dirigida específicamente a la arquitectura NVIDIA Hopper para Tensor ...
hace 2 años
0120K
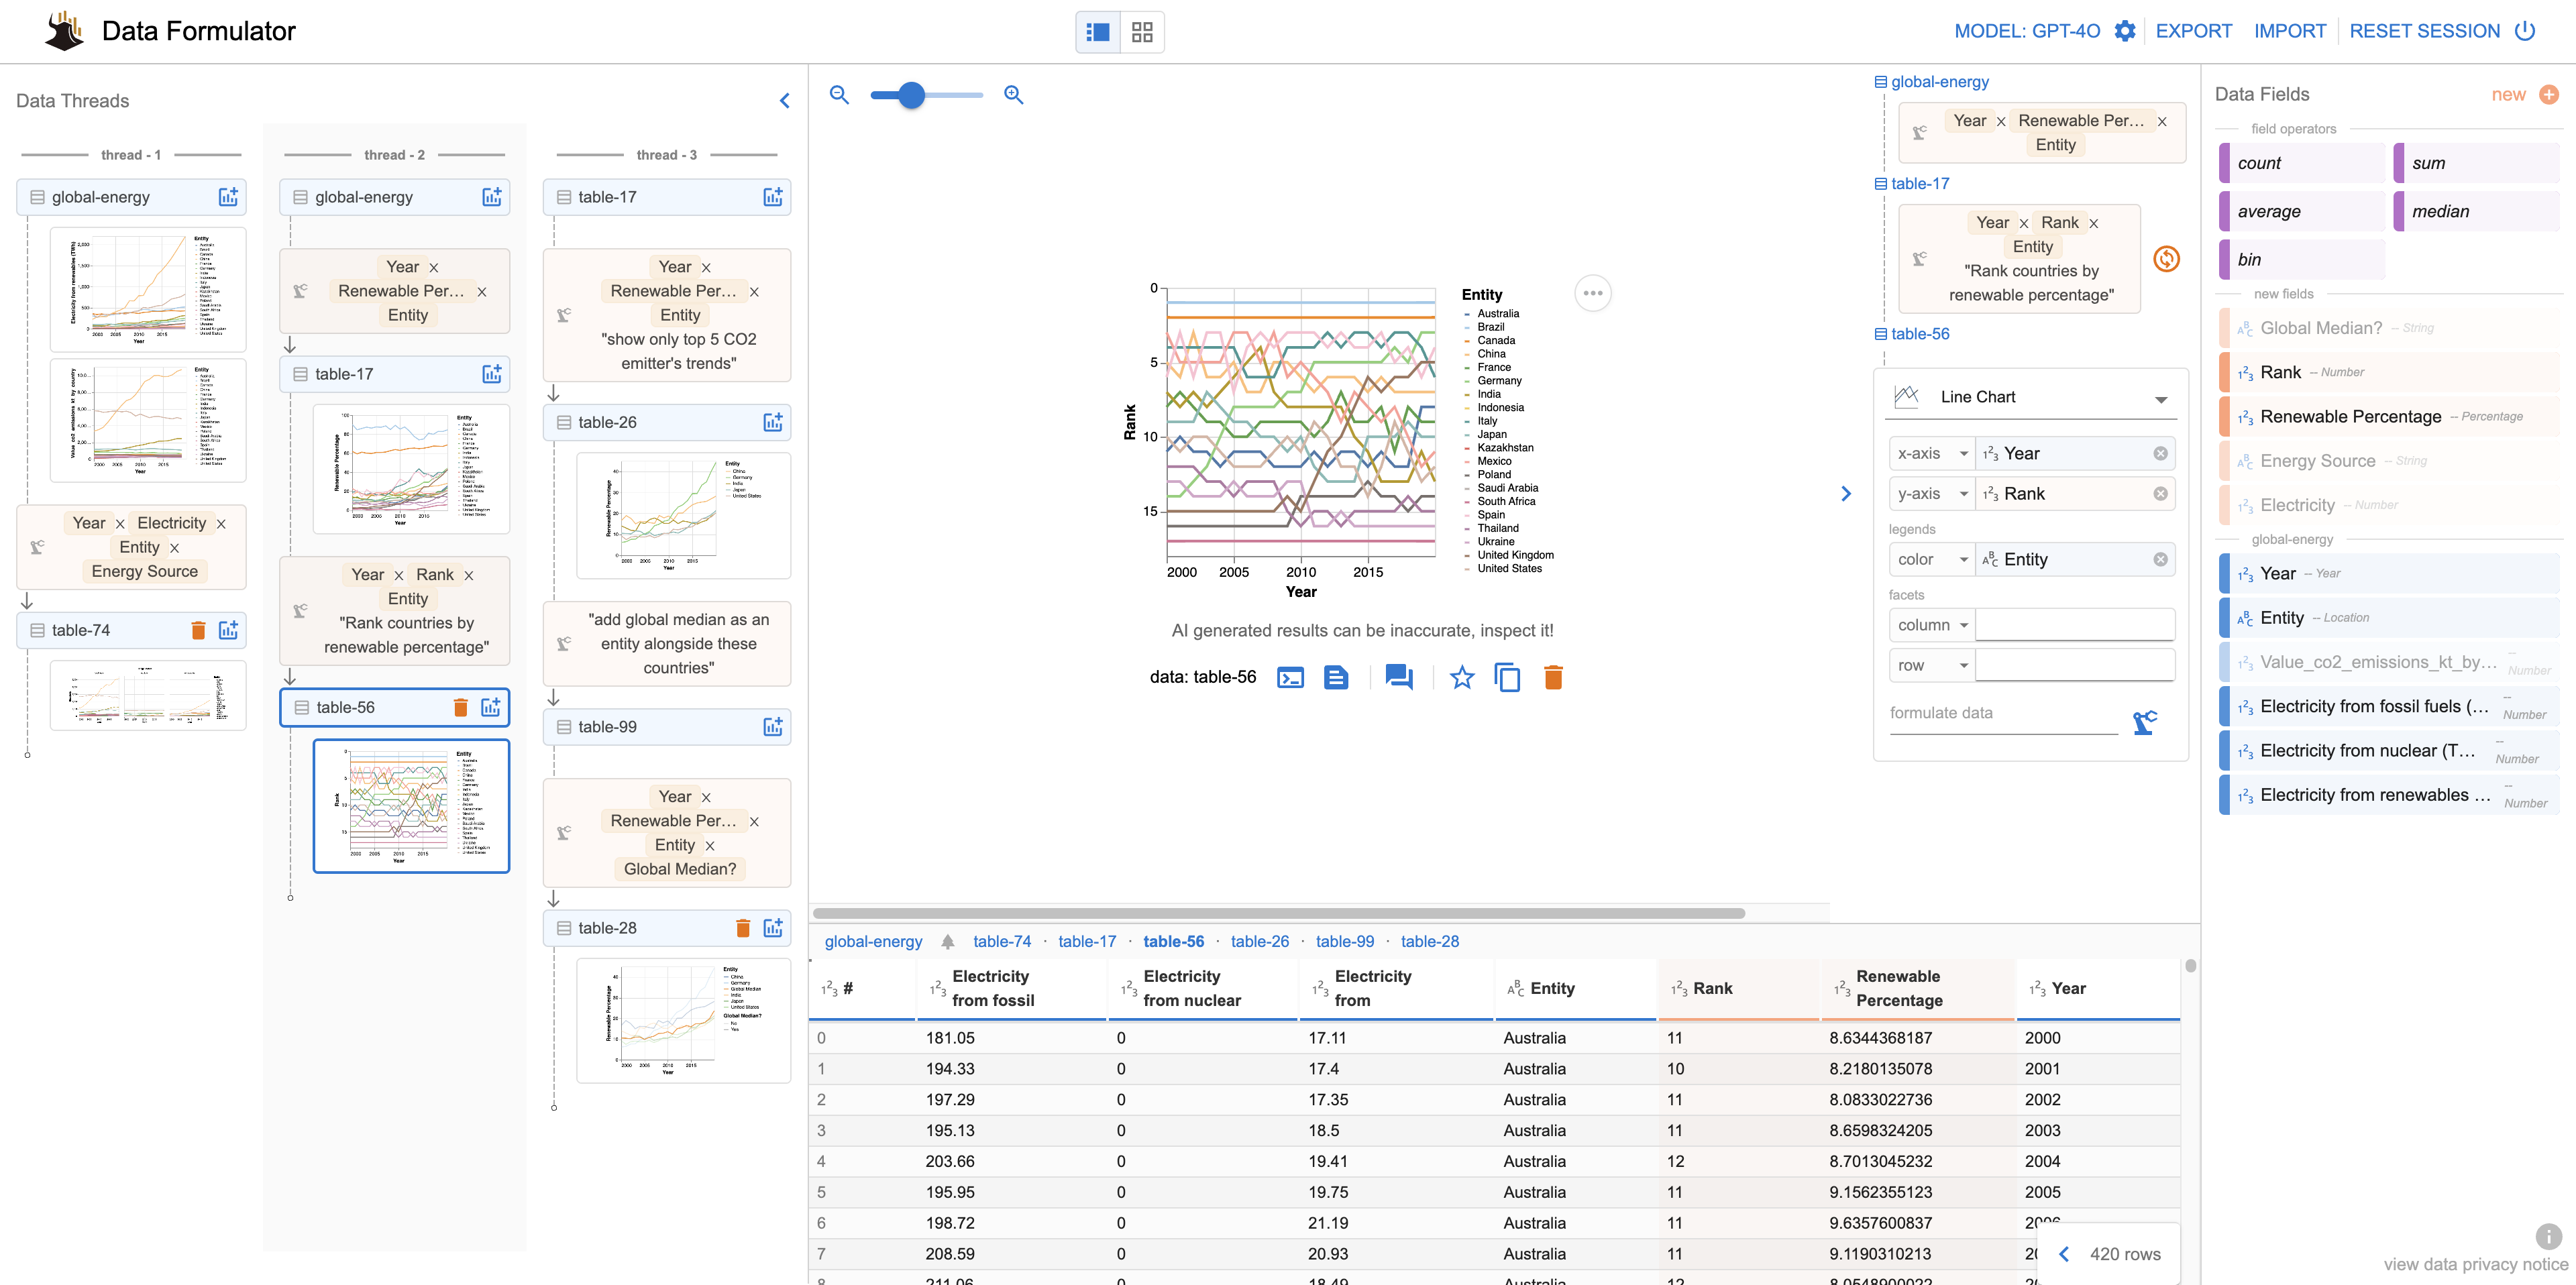
Data Formulator:AI驱动的数据可视化工具

Data Formulator: una herramienta de visualización de datos basada en IA

Introducción general Data Formulator es una herramienta de código abierto de visualización de datos basada en IA desarrollada por Microsoft Research. La herramienta combina una interfaz gráfica de usuario (GUI) y la entrada de lenguaje natural (NL) para permitir a los usuarios crear e iterar rápidamente a través de interacciones y comandos sencillos....
hace 2 años
0120K
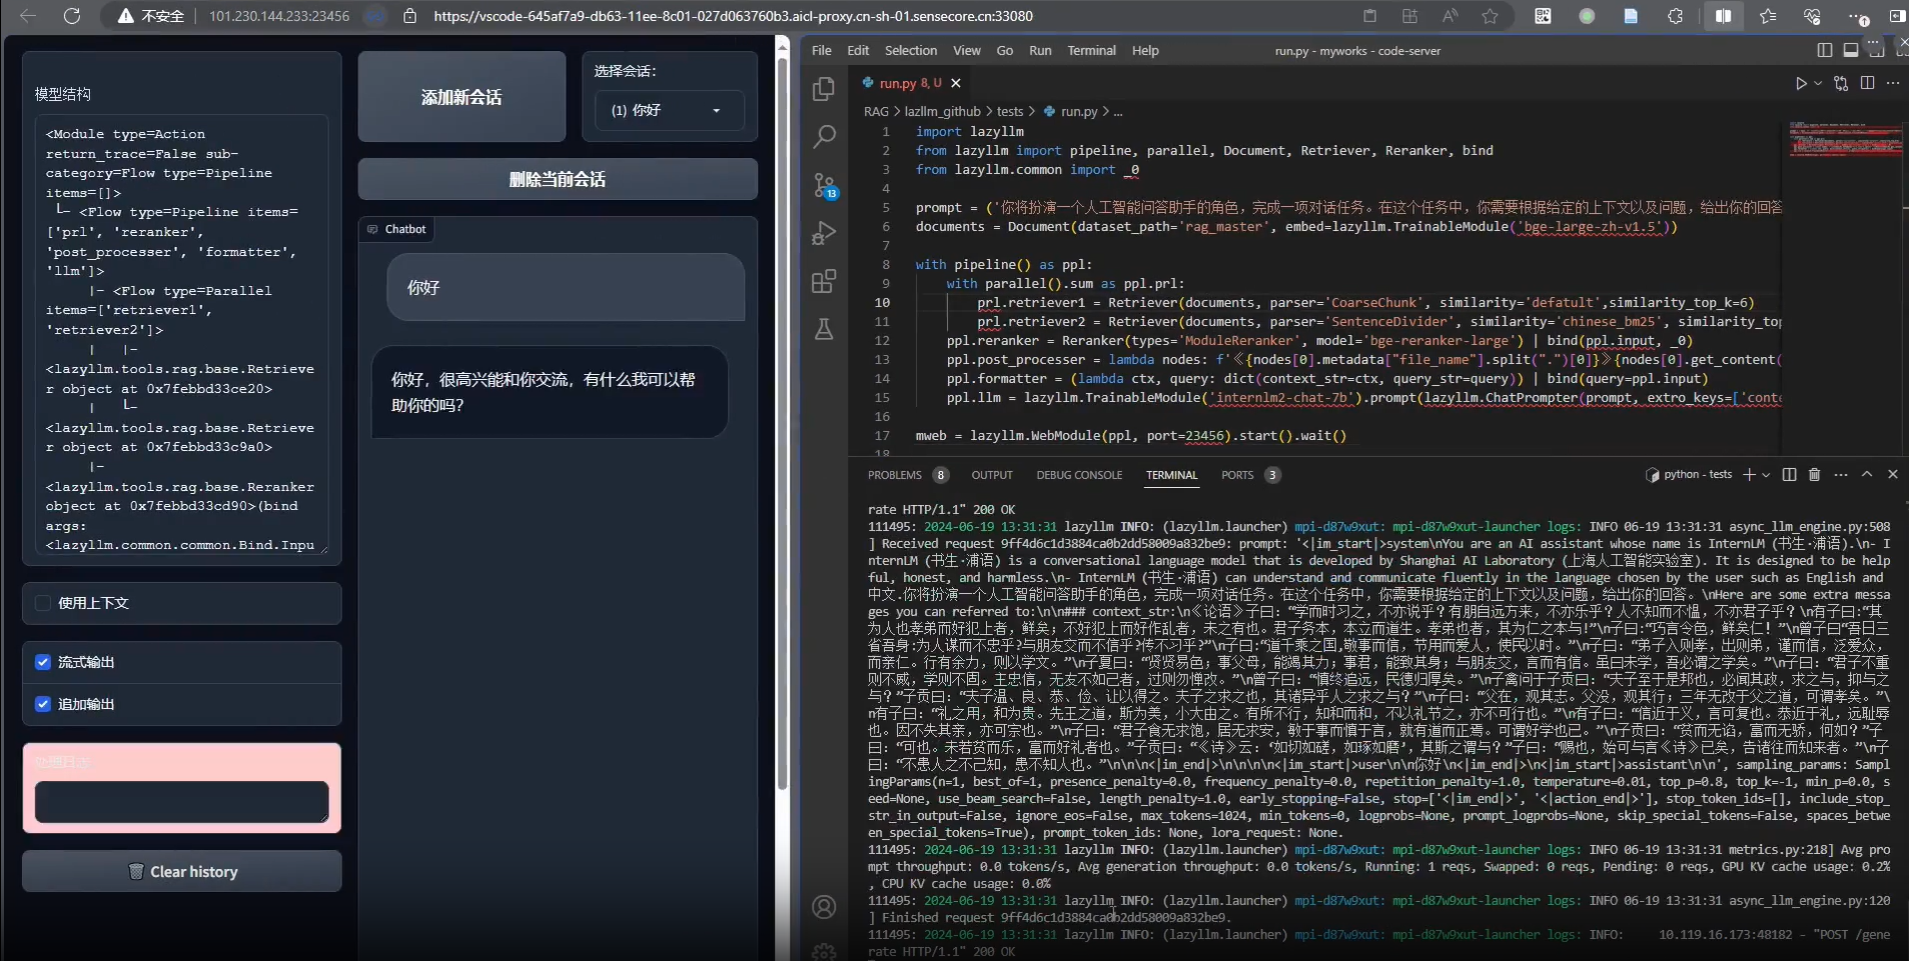
LazyLLM:商汤开源构建多智能体应用的低代码开发工具

LazyLLM: herramienta de desarrollo de código abierto de Shangtang para crear aplicaciones corporales multiinteligentes

Introducción exhaustiva LazyLLM es una herramienta de código abierto desarrollada por el equipo LazyAGI, centrada en simplificar el proceso de desarrollo de aplicaciones de grandes modelos de inteligencia múltiple. Ayuda a los desarrolladores a construir rápidamente aplicaciones complejas de IA a través de la implementación con un solo clic y mecanismos de puerta de enlace ligeros, ahorrando la tediosa configuración de ingeniería....
hace 2 años
0120K
TripoSF:快速生成高分辨率3D模型的实用工具

TripoSF: una herramienta práctica para la generación rápida de modelos 3D de alta resolución

Introducción general TripoSF es un proyecto de código abierto construido por el equipo VAST-AI-Research, diseñado específicamente para generar rápidamente modelos 3D de alta resolución a partir de una sola imagen. Utiliza una tecnología llamada SparseFlex, alta eficiencia de procesamiento, puede ser en el general...
hace 2 años
0119.8K
Raycast-G4F:通过Raycast免费使用GPT-4、Llama-3等多种 AI 模型

Raycast-G4F: ¡Acceso gratuito a GPT-4, Llama-3 y muchos otros modelos de IA a través de Raycast!

Introducción general Raycast-G4F (GPT4Free) es una potente extensión de Raycast que ofrece a los usuarios acceso gratuito a una amplia gama de modelos avanzados de IA, incluyendo GPT-4, Llama-3. La extensión no sólo proporciona transmisión de diálogos en tiempo real...
hace 2 años
0119.7K
Diffusers Image Outpaint:超强开源AI图像扩展工具,图像外绘(image outpainting)

Diffusers Image Outpaint: herramienta de extensión de imagen AI de código abierto súper potente, image outpainting (pintado de imágenes)

Introducción general Diffusers Image Outpaint es una potente herramienta de expansión de imágenes AI creada por fffiloni, miembro de la comunidad Hugging Face. La herramienta utiliza técnicas avanzadas de modelado de difusión para...
hace 2 años
0119.7K
AI Chatbot Supabase:开源的Next.js和Supabase构建的AI聊天机器人,快速部署到Vercel。

AI Chatbot Supabase: código abierto Next.js y Supabase construyeron AI chatbot para un rápido despliegue en Vercel.

Introducción general AI Chatbot Supabase es una plantilla de chatbot AI de código abierto construida sobre Next.js y Supabase. Desarrollado por Vercel, el proyecto tiene como objetivo proporcionar una solución de chatbot totalmente funcional y personalizable. Por ...
hace 2 años
0119.7K
FantasyTalking:生成真实感说话肖像的开源工具

FantasyTalking: una herramienta de código abierto para generar retratos hablados realistas

Introducción general FantasyTalking es un proyecto de código abierto desarrollado por el equipo Fantasy-AMAP, centrado en la generación de realismo hablando videos retrato a través de la unidad de audio. El proyecto se basa en el modelo avanzado de difusión de vídeo Wan2.1 , combinado con el codificador de audio Wa...
hace 1 año
0119.7K
AppAgent:利用多模态智能体自动操作智能手机

AppAgent: manejo automatizado de smartphones mediante inteligencias multimodales

Introducción AppAgent es un marco de agente multimodal basado en un modelo de lenguaje amplio (LLM) diseñado para manipular aplicaciones de teléfonos inteligentes. El marco imita interacciones humanas como toques y deslizamientos a través de un espacio de manipulación simplificado, eliminando así la necesidad de acceso al back-end del sistema y extendiendo su uso a través de diferentes aplicaciones....
hace 2 años
0119.6K