
Nemotron 3.5 Transcribe是什么
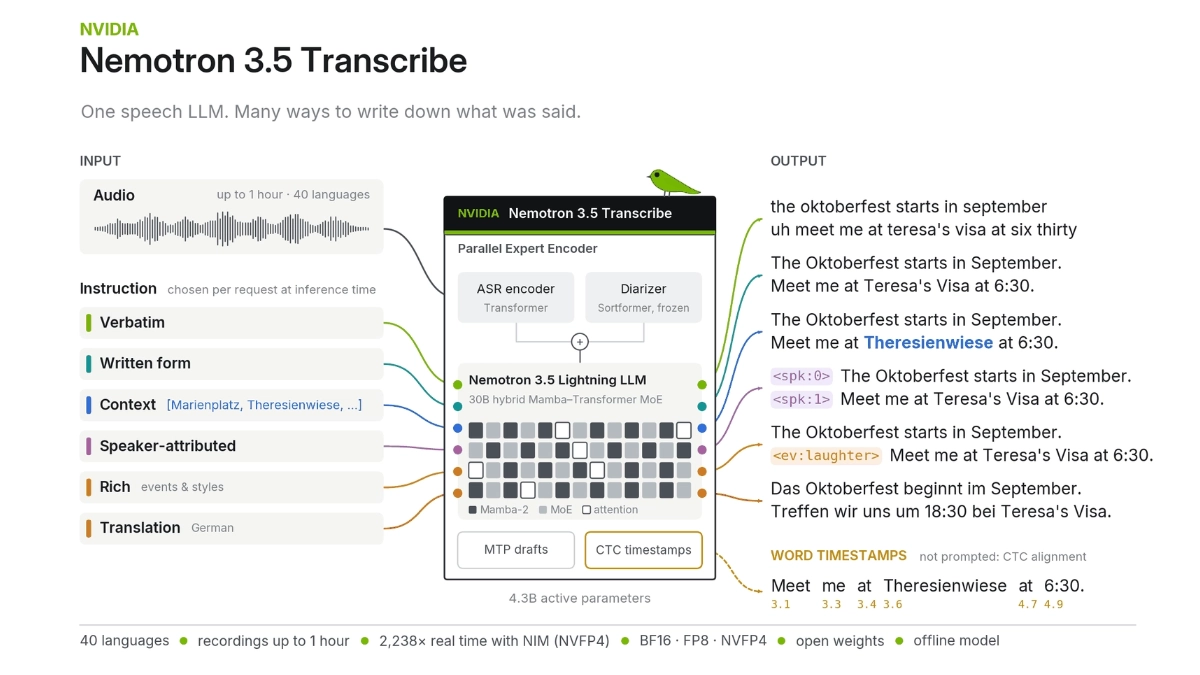
Nemotron 3.5 Transcribe 是英伟达开源的语音大模型,基于语音编码器+冻结说话人分离模型+30B 混合 MoE 语言模型的 SALM 架构,推理时仅激活约 4.3B 参数,单卡即可部署。Nemotron 3.5 Transcribe 能听懂自然语言指令,一次推理同时完成逐字转写、说话人标注、词级时间戳和翻译,支持 40 种语言、最长 1 小时录音。转写精度在 Open ASR 榜单居开放模型第一,适合会议纪要、医疗记录等场景。
Nemotron 3.5 Transcribe的功能特色
- 指令化转写:用一句自然语言能切换逐字稿、整理稿、翻译等不同输出形式,无需重新训练。
- 다국어 지원:覆盖 40 种语言转写和 31 种语言与英语的互译,能自动识别录音中的语言种类。
- 说话人区分:原生区分最多 8 位说话人,在重叠语音场景下首次超越专用级联系统。
- 긴 오디오 처리:单次可处理最长约 1 小时的录音,适合会议、访谈和课堂完整转写。
- 词级时间戳:通过轻量 CTC 适配器对齐音频与文本,每个词都能定位到具体时间点,便于回听检索。
- 上下文纠错:提供术语表、人名列表后,命名实体错误率可降低 6 倍,专业词汇不再靠猜。
- 领域微调:基于 NeMo Speech 工具包,单 GPU 用少量数据即可快速适配口音、术语和格式。
Nemotron 3.5 Transcribe的核心优势
- 单模型一体化:在一个仅激活约 4.3B 参数的 MoE 架构内一次推理完成转写、说话人标注、翻译和时间戳,替代传统五步管线。
- 최고의 정밀도:英语 Open ASR 平均 WER 4.71%、多语言 4.62%,均为开放权重模型第一。
- 명령 중심:一句自然语言可切换逐字稿、整理稿、翻译等输出形态,无需重新训练。
- 专业可定制:配合术语表命名实体错误率降 6 倍,单 GPU 微调约 14 小时即可适配自有口音和术语。
- 开放免费商用:OpenMDW-1.1 许可可完全离线部署,托管成本约 $0.002/分钟,不到商用 API 一半。
Nemotron 3.5 Transcribe官网是什么
- 허깅페이스 모델 라이브러리:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- 기술 문서:https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
Nemotron 3.5 Transcribe的使用步骤
- 가중치 다운로드:前往 Hugging Face 或魔搭搜索 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B,按 OpenMDW-1.1 许可获取模型文件。
- 구축 환경:在官方 NIM 容器、vLLM或 NeMo-Speech.cpp三种部署方式中任选其一。
- 오디오 준비:将录音文件按所用框架要求转换格式,单次最长约 1 小时。
- 撰写指令:用自然语言描述需求,例如"保留逐字原话并标注说话人"或"清理口头禅并翻译为英文"。
- 경영진 추론:向接口提交音频与指令,获取转写结果,可按需附带说话人标签和词级时间戳。
- 在线试用(可选):暂不部署可先用 Hugging Face 上的 nvidia/nemotron-transcribe 体验空间快速验证效果。
- 领域微调(可选):如需适配自有口音和术语,用 NeMo Speech 工具包准备标注数据,单 GPU 约 0.5–2.3 小时即可完成。
Nemotron 3.5 Transcribe的适用人群
- 企业与会议服务团队:需要把一小时会议录音整理成带发言人标注的纪要并提取结论待办,指令化输出可一步替代"转写+人工整理"流程。
- 媒体人与内容创作者:逐字保留受访者原话并标注说话人,确保引述准确,可按需清理口头禅。
- 教育与培训机构:用词级时间戳做课程回放检索,学生搜关键词即可跳转到对应讲解时刻。
- 医疗、法律等专业领域从业者:通过术语表和 NeMo 微调把专业对话按规范格式转成结构化文本,微调后 WER 可降至 12% 左右。
- 对数据隐私有要求的组织:政府、金融、医院等机构可完全离线部署,录音无需出内网。
- 开发者与 AI 团队:可基于同步开源的 Granary v2 数据集和微调配方,构建自有领域定制版本。
Nemotron 3.5 Transcribe的常见问题
Q1:商用收费吗?
A1:不收费。模型以 OpenMDW-1.1 许可开放权重,可自部署也可商用,仅托管推理服务按量计费,约 $0.002/分钟,明显低于主流商用 ASR API。
Q2:需要什么硬件配置?
A2:BF16 版约需 80GB 显存(一张 H100 级别),可选 FP8/NVFP4 量化或 GGUF 版本降低门槛,NeMo-Speech.cpp 支持本地 GGUF 运行。
Q3:支持实时转写吗?
A3:不支持。它定位为离线批处理模型,仅处理录制好的音频,单次最长约 1 小时;需要边说边出字幕的场景应选流式方案。
Q4:说话人区分支持所有 40 种语言吗?
A4:不是。转写覆盖 40 种语言,但说话人标注目前仅支持 13 种语言,使用前需确认目标语言在支持列表内。
Q5:官方宣称每秒处理 2238 秒音频,实际部署能达到吗?
A5:该数字基于尚未开源的 NVFP4 优化版 NIM 部署,当前公开的 vLLM 方案约为其一半,实际预期应按后者估算。
© 저작권 정책
기사 저작권 AI 공유 서클 모두 무단 복제하지 마세요.
관련 문서

댓글 없음...
 한국어
 简体中文
 English
 日本語
 Русский
 Español