Últimos recursos sobre IA

共 3199 篇文章
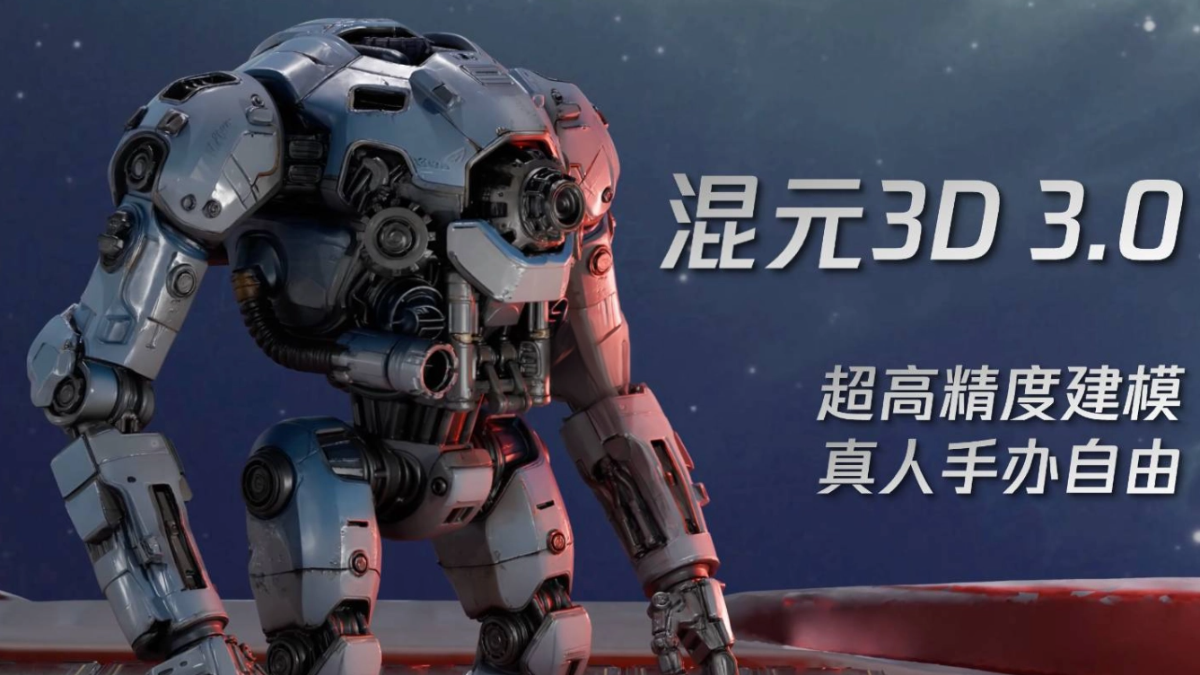
混元3D 3.0 - 腾讯推出的3D生成模型,支持超高清建模

Hybrid 3D 3.0: modelos generados en 3D de Tencent compatibles con UHD

Hybrid 3D 3.0 es un modelo avanzado de generación 3D de Tencent, basado en la tecnología de esculpido jerárquico 3D-DiT, con una resolución geométrica de hasta 1536³, capaz de generar modelos 3D de ultra alta definición y ricos en detalles, y de destacar en el modelado de personajes, con capacidad para modelar con precisión los cinco sentidos y la forma del cuerpo.
hace 1 año
085.3K
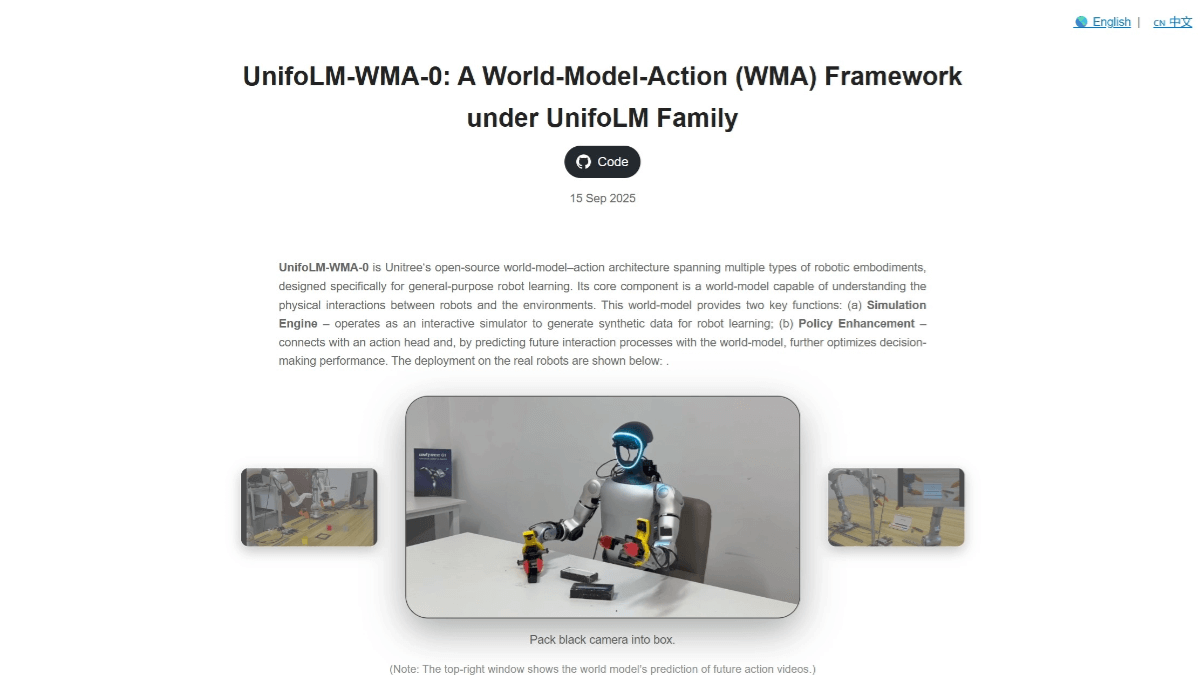
UnifoLM-WMA-0 - 宇树科技开源的世界模型动作架构

UnifoLM-WMA-0 - Arquitectura de acción del modelo mundial de código abierto de Ushu Technology

UnifoLM-WMA-0 es una arquitectura de acción-modelo del mundo de código abierto para múltiples clases de ontologías robóticas de Yu Shu Technology, diseñada para el aprendizaje general de robots. Compuesto por un modelo de mundo y una arquitectura de acción, el modelo de mundo entiende las leyes físicas de la interacción robot-entorno, y la arquitectura de acción es responsable de...
hace 1 año
093.4K
InfiniteTalk - 美团视觉AI开源的音频驱动视频生成工具

InfiniteTalk - Herramienta de código abierto de generación de vídeo basado en audio para Mission Vision AI

InfiniteTalk es una herramienta de generación de vídeo basada en audio desarrollada por el equipo de MeiGen-AI que genera vídeos hablados de duración ilimitada a partir del audio introducido. Su principal ventaja es la precisa tecnología de sincronización labial, que hace coincidir perfectamente el audio con la forma de la boca del personaje, generando...
hace 1 año
0102.2K
Lumina-DiMOO - 上海AI Lab联合华为昇腾开源的多模态大模型

Lumina-DiMOO - Un gran modelo multimodal de código abierto del Laboratorio de Inteligencia Artificial de Shanghai y Huawei Rise

Lumina-DiMOO es un modelo unificado de nueva generación para la generación y comprensión multimodal lanzado por el Laboratorio de Inteligencia Artificial de Shanghái (SAL) junto con Huawei Rise en la Conferencia Mundial sobre Inteligencia Artificial 2025. Basado en la plataforma básica de hardware y software Rise AI y en el conjunto de grandes modelos multimodales MindSpeed MM, completa la...
hace 1 año
080K
Hyprnote - 开源的本地优先AI会议笔记工具

Hyprnote - Herramienta de código abierto para tomar notas de conferencias con inteligencia artificial en primer lugar local

Hyprnote es una herramienta AI de código abierto para tomar notas en reuniones, diseñada para que los profesionales protejan la privacidad de los usuarios y mejoren la eficiencia de las reuniones. Adoptando el principio de "lo local primero", todo el almacenamiento y procesamiento de datos se realiza en el dispositivo local del usuario para garantizar la seguridad de los datos y permitir el funcionamiento sin conexión.
hace 1 año
087.7K
MobileLLM-R1 - Meta开源的专项高效推理模型系列

MobileLLM-R1 - Meta serie de modelos de inferencia eficientes especializados de código abierto

MobileLLM-R1 es la serie de código abierto de Meta de modelos de inferencia eficientes diseñados para el razonamiento matemático, de programación y científico. Contiene un modelo base y un modelo final, con versiones de 140 millones, 360 millones y 950 millones de parámetros, respectivamente. Los modelos no son modelos genéricos de chat y son modelos supervisados de ajuste fino (SFT...
hace 1 año
067.1K
MobiAgent - 上海交大开源的移动端智能体全栈构建框架

MobiAgent - framework de código abierto para la creación de cuerpos inteligentes móviles de la Universidad Jiaotong de Shanghai

MobiAgent es una cadena de herramientas de código abierto para cuerpos inteligentes móviles del Laboratorio IPADS de la Universidad Jiaotong de Shanghai, que ayuda a los usuarios a construir sus propios asistentes inteligentes móviles. Mediante el registro de la trayectoria de funcionamiento del usuario y la generación de datos de alta calidad, entrena cuerpos inteligentes capaces de entender órdenes en lenguaje natural. Entre sus principales características se incluyen...
hace 1 año
076.4K
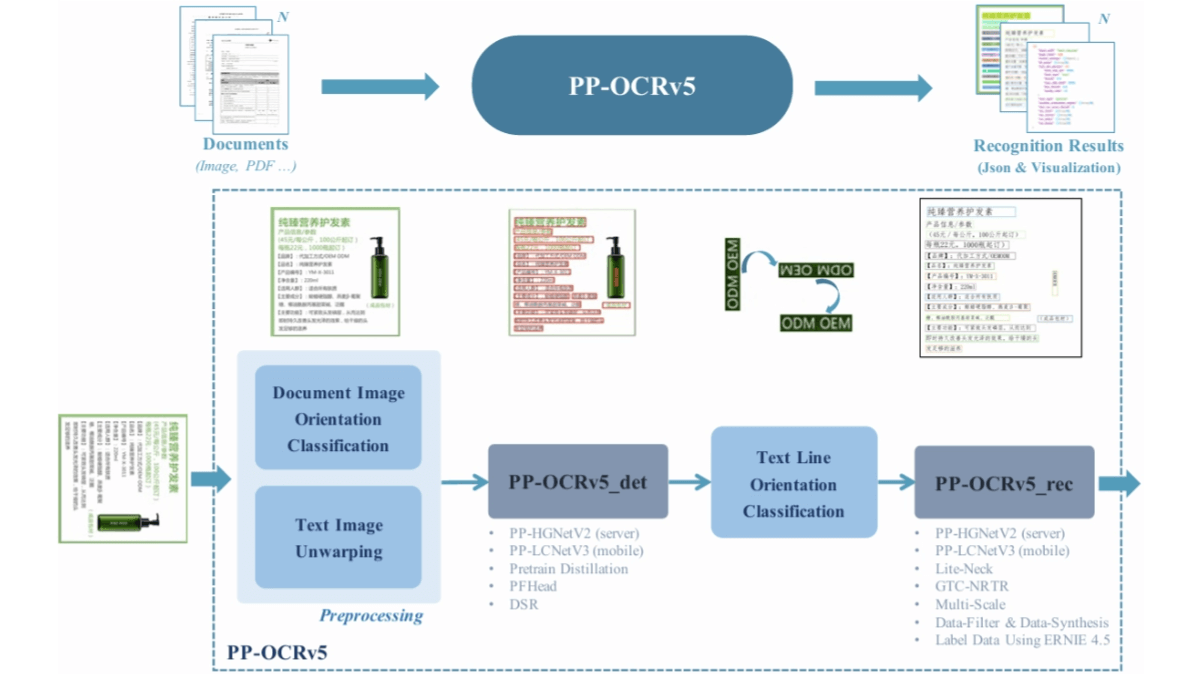
PP-OCRv5 - 百度开源的新一代文字识别AI模型

PP-OCRv5 - Modelo de IA de código abierto de Baidu para el reconocimiento de texto de nueva generación

PP-OCRv5 es el modelo de IA de reconocimiento de texto de última generación lanzado por Baidu. Con un diseño ligero y un recuento de referencias de solo 0,07 B, es apto para ejecutarse de forma eficiente en CPU y dispositivos edge, y puede procesar más de 370 caracteres por segundo. El modelo admite chino simplificado, chino tradicional, inglés, japonés y pinyin...
hace 1 año
0107.5K
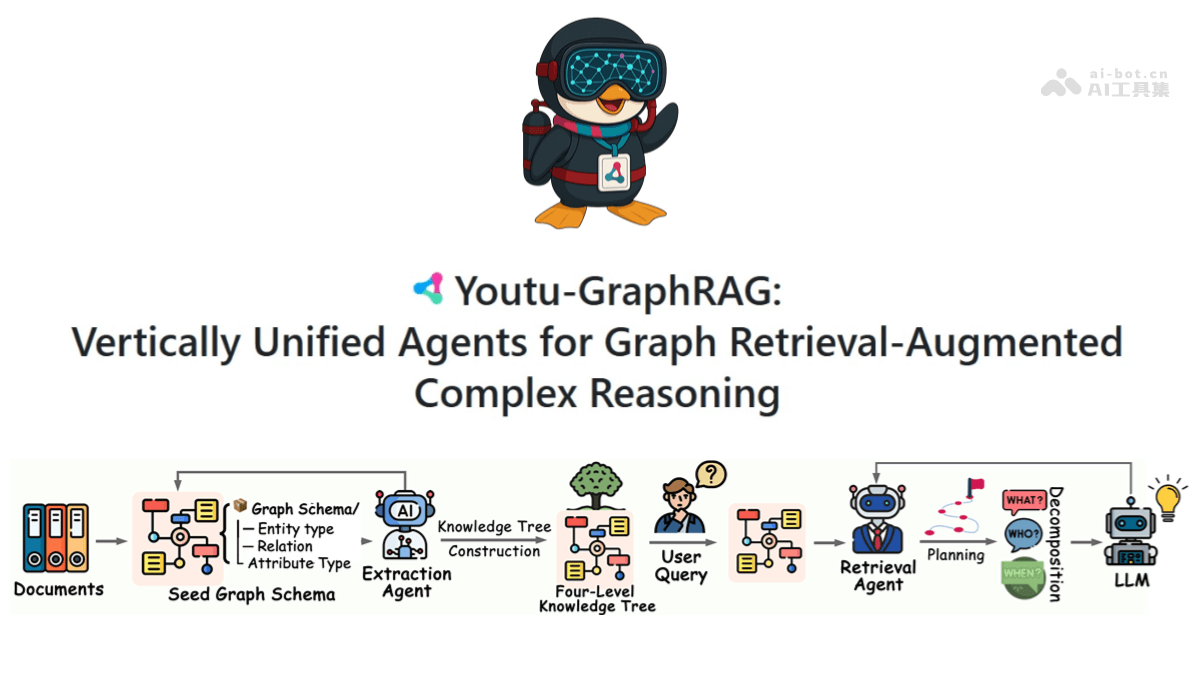
Youtu-GraphRAG - 腾讯优图实验室开源的图检索增强生成框架

Youtu-GraphRAG - Marco de generación de gráficos mejorados de código abierto de Tencent Youtu Labs

Youtu-GraphRAG es un marco de generación de aumento de recuperación de grafos de código abierto de Tencent Youtu Labs para ayudar a los grandes modelos lingüísticos a manejar tareas complejas de preguntas y respuestas con mayor precisión. Mediante la construcción de un árbol de conocimiento de cuatro capas, el conocimiento se desmonta en cuatro niveles: atributos, relaciones, palabras clave y comunidades, para lograr un conocimiento transversal del dominio propio de la act...
hace 1 año
072.9K
IndexTTS2 - B站开源的免费TTS模型,首个支持精确时长控制

IndexTTS2 - Modelo TTS gratuito de código abierto para la estación B, el primero que admite un control preciso de la duración

IndexTTS2 es un nuevo modelo libre de texto a voz (TTS) de código abierto por el equipo de voz de la estación B, que logra un gran avance en la expresión emocional y el control de la duración, el primer modelo TTS autorregresivo que soporta un control preciso de la duración. Soporta clonación de voz de muestra cero, sólo un archivo de audio puede copiar con precisión el sonido...
hace 1 año
0145.2K
MiniMax Music 1.5 - MiniMax最新推出的AI音乐生成模型

MiniMax Music 1.5 - ¡El último modelo de generación de música por IA de MiniMax!

MiniMax Music 1.5 es una herramienta avanzada de generación de música por IA que permite generar hasta 4 minutos de música a partir de la descripción en lenguaje natural del usuario. El modelo es compatible con una amplia gama de estilos musicales y personalización del estado de ánimo, y genera tonos vocales naturales y completos, transiciones suaves y arreglos ricamente estratificados....
hace 1 año
081.1K
HuMo - 清华大学联合字节开源的多模态视频生成框架

HuMo - Marco de generación de vídeo multimodal de código abierto United Bytes de la Universidad de Tsinghua

HuMo es un marco de generación de vídeo multimodal de código abierto desarrollado conjuntamente por la Universidad de Tsinghua y ByteDance Intelligent Creation Lab, que se centra en la generación de vídeo centrada en el ser humano. Puede generar vídeos humanos de alta calidad, precisos y controlables a partir de entradas multimodales como texto, imágenes y audio.
hace 1 año
0164.5K
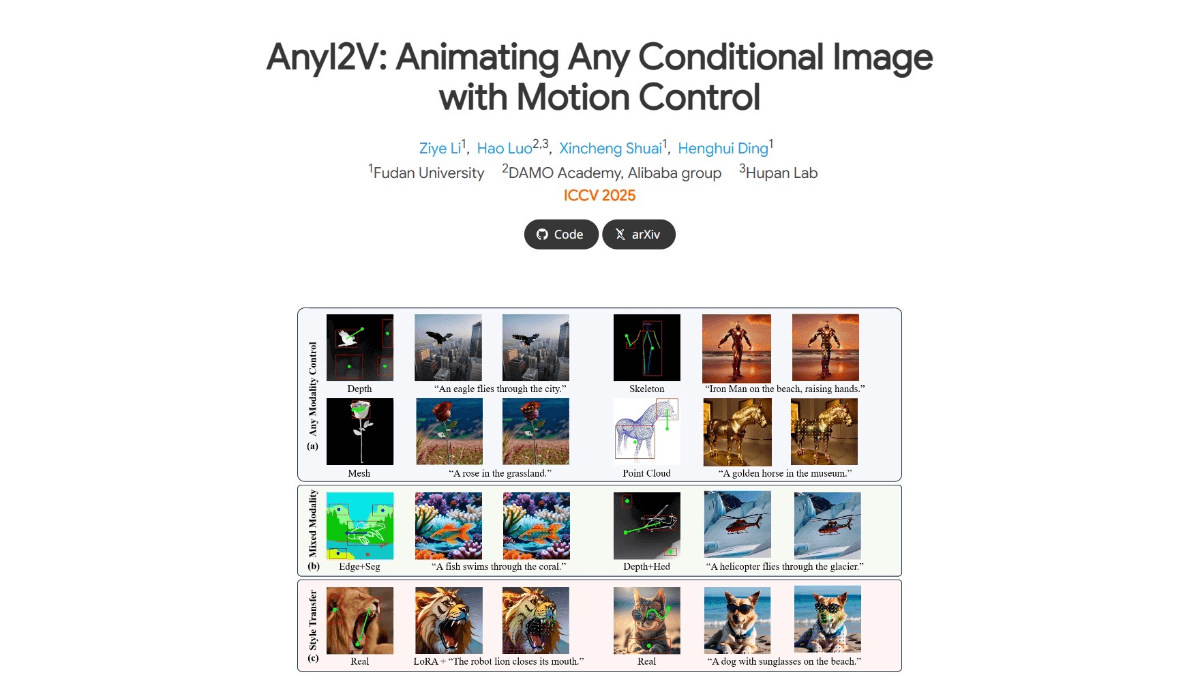
AnyI2V - 复旦联合阿里达摩院等开源的智能图像动画生成框架

AnyI2V - Fudan y Ali Dharma Institute y otro marco de generación de animación de imágenes inteligente de código abierto

AnyI2V es un marco de generación de animaciones de imágenes lanzado conjuntamente por la Universidad de Fudan, Alibaba Darmo Academy y otras entidades, que permite convertir imágenes condicionales estáticas (por ejemplo, cuadrículas, nubes de puntos, etc.) en vídeos dinámicos sin necesidad de un complejo proceso de formación y una gran cantidad de datos.
hace 1 año
071.7K
文心大模型X1.1 - 百度推出的深度思考模型,理解能力更强

Wenshin Big Model X1.1 - El modelo de pensamiento profundo de Baidu para comprender mejor

Wenxin Big Model X1.1 es un modelo de pensamiento profundo lanzado por Baidu, basado en un marco híbrido de aprendizaje por refuerzo que se centra en mejorar la comprensión y la generación de lenguaje. El modelo destaca en el manejo de preguntas complejas, el seguimiento de instrucciones y la simulación del comportamiento de las inteligencias, y puede proporcionar con precisión respuestas bien fundamentadas y contenidos de texto de alta calidad.
hace 1 año
072.5K
AntSK FileChunk - 免费的AI语义文档切片工具,动态切片调整

AntSK FileChunk - Herramienta gratuita de rebanado semántico de documentos AI, ajuste dinámico de rebanado

AntSK FileChunk es una herramienta gratuita de rebanado inteligente de documentos diseñada para aplicaciones RAG (Retrieval Augmented Generation). Semántica como núcleo, el documento será inteligentemente rebanado en segmentos semánticamente completos, coherentes, soporte para multi-idioma, ajustar dinámicamente el tamaño de la rebanada para asegurar la coherencia contextual.
hace 1 año
079.3K
WeKnora - 腾讯微信开源的文档理解与语义检索框架

WeKnora - Marco de código abierto de Tencent WeChat para la comprensión de documentos y la recuperación semántica

WeKnora es Tencent WeChat equipo de código abierto basado en el Modelo de Lenguaje Grande (LLM) comprensión de documentos y el marco de recuperación semántica , diseñado para la estructura de los escenarios de contenido de documentos complejos y heterogéneos y diseñado para utilizar una arquitectura modular , la integración de preprocesamiento multimodal , la indexación vectorial semántica , la recuperación inteligente y gran modelo de razonamiento generativo ...
hace 1 año
0132.3K
XTuner V1 - 上海AI Lab开源的大模型训练引擎

XTuner V1 - Motor de entrenamiento de grandes modelos de código abierto de Shanghai AI Lab

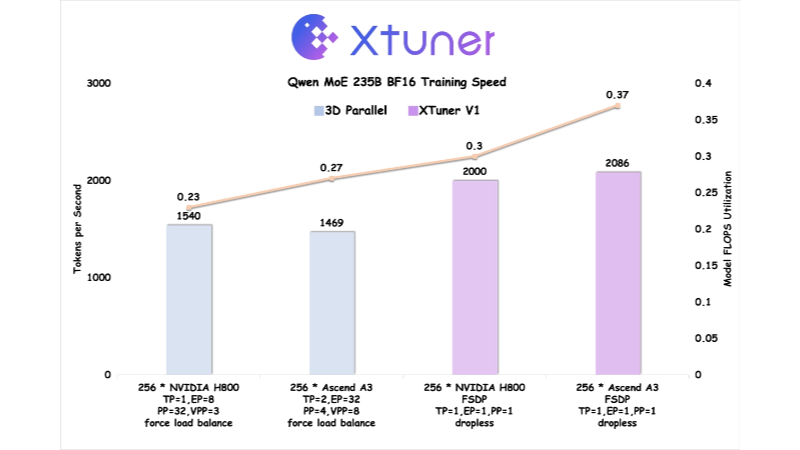
XTuner V1 es una nueva generación de motor de entrenamiento de modelos de gran tamaño de código abierto del Laboratorio de Inteligencia Artificial de Shanghai, diseñado para el entrenamiento de modelos de Expertos Mixtos (MoE) dispersos a escala ultra grande. Desarrollado sobre la base de PyTorch FSDP, logra un alto rendimiento mediante la optimización multidimensional de la memoria, la comunicación y la carga....
hace 1 año
068.2K
OneCAT - 美团联合上海交大开源的多模态模型

OneCAT - Modelo multimodal de código abierto para Meituan y la Universidad Jiaotong de Shanghai

OneCAT es un nuevo modelo multimodal unificado lanzado por Meituan junto con la Universidad Jiaotong de Shanghai, que adopta una arquitectura de descodificador puro que integra a la perfección la comprensión multimodal, la generación de texto a imagen y las funciones de edición de imágenes. El modelo abandona el diseño de los modelos multimodales tradicionales que dependen de codificadores y desambiguadores visuales externos mediante...
hace 1 año
074.5K
Kimi K2-0905 - 月之暗面推出的最新模型版本

Kimi K2-0905 - ¡El último modelo de Dark Side of the Moon!

Kimi K2-0905 es un modelo avanzado de IA de Dark Side of the Moon Technologies Ltd. que destaca en la asistencia a la programación, genera código de forma eficiente y favorece la generación de código ordenado y estandarizado en el desarrollo front-end. La longitud del contexto del modelo se amplía hasta 256K para gestionar tareas complejas.
hace 1 año
0110.1K
Step-Audio 2 mini - 阶跃星辰开源的语音大模型

Step-Audio 2 mini - Macromodelado del habla de código abierto Step-Star

Step-Audio 2 mini es un macromodelo del habla integral de código abierto de Step-Audio. Rompe con la estructura tradicional del modelo del habla y adopta una verdadera arquitectura multimodal de extremo a extremo, que transforma directamente la entrada de audio sin procesar en salida de respuesta del habla, con menor latencia, y comprende la información paralingüística y las señales no vocales.
hace 1 año
076.9K
InternVL3.5 - 上海AI实验室开源的多模态大模型

InternVL3.5 - Modelos grandes multimodales de código abierto de Shanghai AI Lab

InternVL3.5 (Shusheng-Wanxiang 3.5) es un gran modelo multimodal de código abierto del Laboratorio de Inteligencia Artificial de Shanghai, el modelo está totalmente actualizado en términos de capacidad general, capacidad de razonamiento y eficiencia de despliegue, proporcionando nueve tamaños de versiones de 1.000 millones a 241.000 millones de parámetros, cubriendo diferentes escenarios de demanda de recursos,...
hace 1 año
098.4K
Meeseeks - 美团开源的评估模型指令遵循能力的评测集

Meeseeks - Conjunto de evaluación de código abierto Meeseeks para evaluar la capacidad de seguir instrucciones de modelos.

Meeseeks es un conjunto de evaluación de grandes modelos de código abierto utilizado por el equipo M17 de Meituan para evaluar la capacidad de un modelo para seguir instrucciones.Meeseeks utiliza un marco de evaluación de tres niveles para medir de forma exhaustiva si un modelo es capaz de generar respuestas en estricta conformidad con las instrucciones del usuario desde el nivel macro al micro, y no evalúa el conocimiento del contenido de la respuesta como...
hace 1 año
075.8K
HunyuanVideo-Foley - 腾讯推出的开源视频音效生成模型

HunyuanVideo-Foley - Modelo de generación de sonido de vídeo de código abierto de Tencent

HunyuanVideo-Foley es un modelo de generación de sonido de vídeo de código abierto del equipo Tencent Mixed Yuan que permite añadir efectos de sonido adaptados con precisión a los vídeos silenciosos. El modelo se basa en un conjunto de datos a gran escala de formación , con una arquitectura de convertidor de difusión multimodal , combinado con la representación de la función de pérdida de alineación y técnicas de optimización de audio VAE....
hace 1 año
092.7K
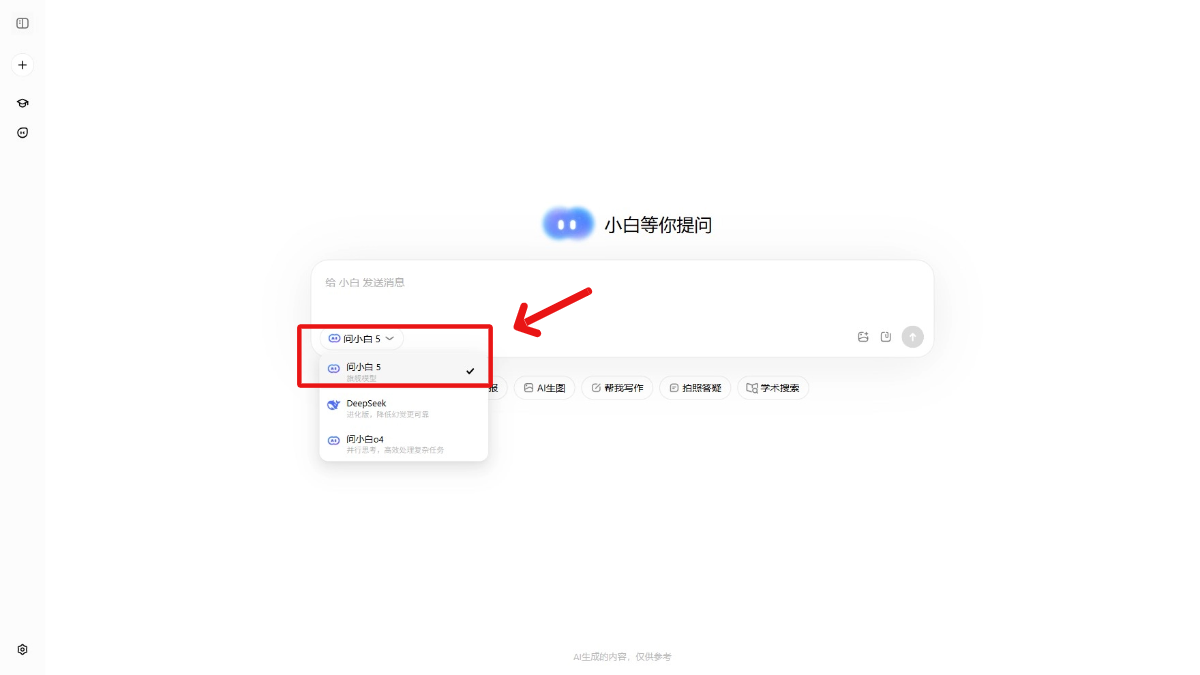
问小白5 - 问小白推出的全能AI模型

Ask White 5 - Modelo AI todo en uno de Ask White

Ask White 5 es el modelo insignia "Todo en uno" con un nivel de inteligencia muy alto. El modelo obtiene buenos resultados en muchas evaluaciones, como la puntuación de evaluación compuesta AA-Index de 64,7 y la puntuación de evaluación de la capacidad STEM de 86, que se acerca a la del líder mundial GPT-5.
hace 1 año
077.2K
问小白o4 - 问小白推出的并行思考模型,同时开启8条思考路径

Ask o4 - Un modelo de pensamiento paralelo introducido por Ask o4 que abre 8 vías de pensamiento al mismo tiempo

Ask White o4 es un innovador modelo de pensamiento paralelo que abre 8 vías de pensamiento al mismo tiempo, analiza el problema desde múltiples perspectivas y filtra automáticamente la solución óptima. El modelo incorpora técnicas avanzadas de aprendizaje por refuerzo Long-CoT y aprendizaje por recompensa de procesos, tiene potentes capacidades de razonamiento profundo y rinde bien en tareas complejas.
hace 1 año
077.2K
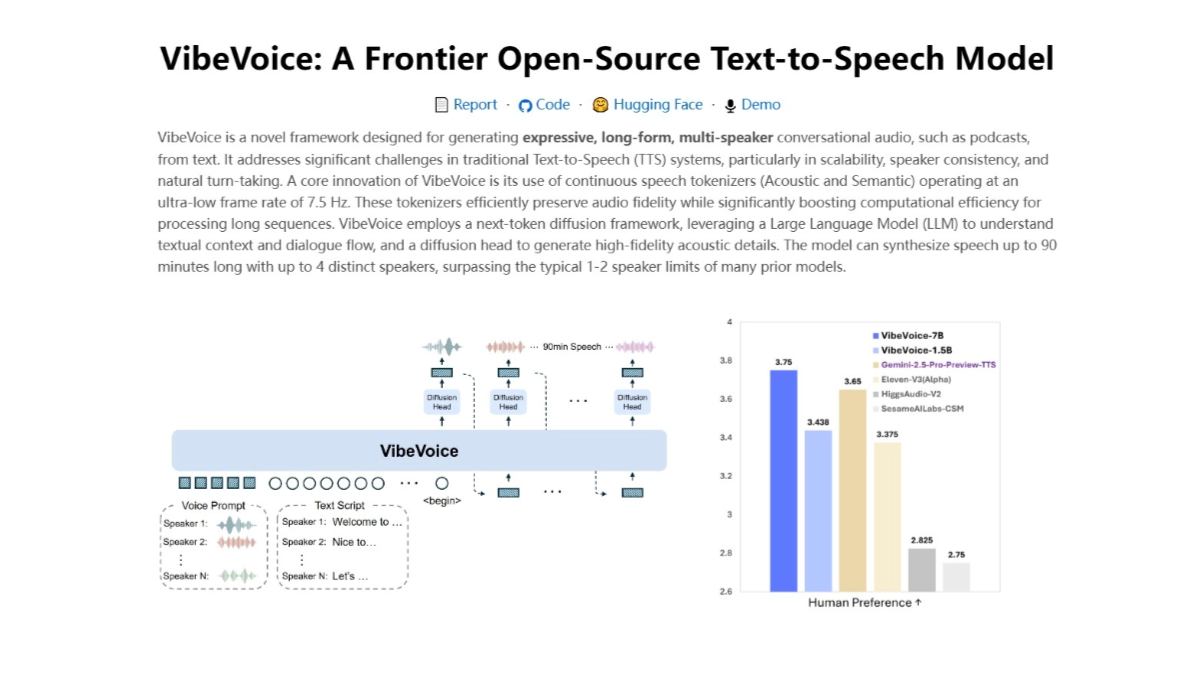
VibeVoice - 微软推出的文本到语音模型

VibeVoice - Modelado de texto a voz de Microsoft

VibeVoice es un nuevo modelo de conversión de texto a voz (TTS) de Microsoft. Este modelo genera audio conversacional a partir de hasta cuatro altavoces diferentes y admite hasta 90 minutos de emisión continua de voz, con lo que rompe las limitaciones de duración de los sistemas TTS tradicionales.
hace 1 año
0102.5K
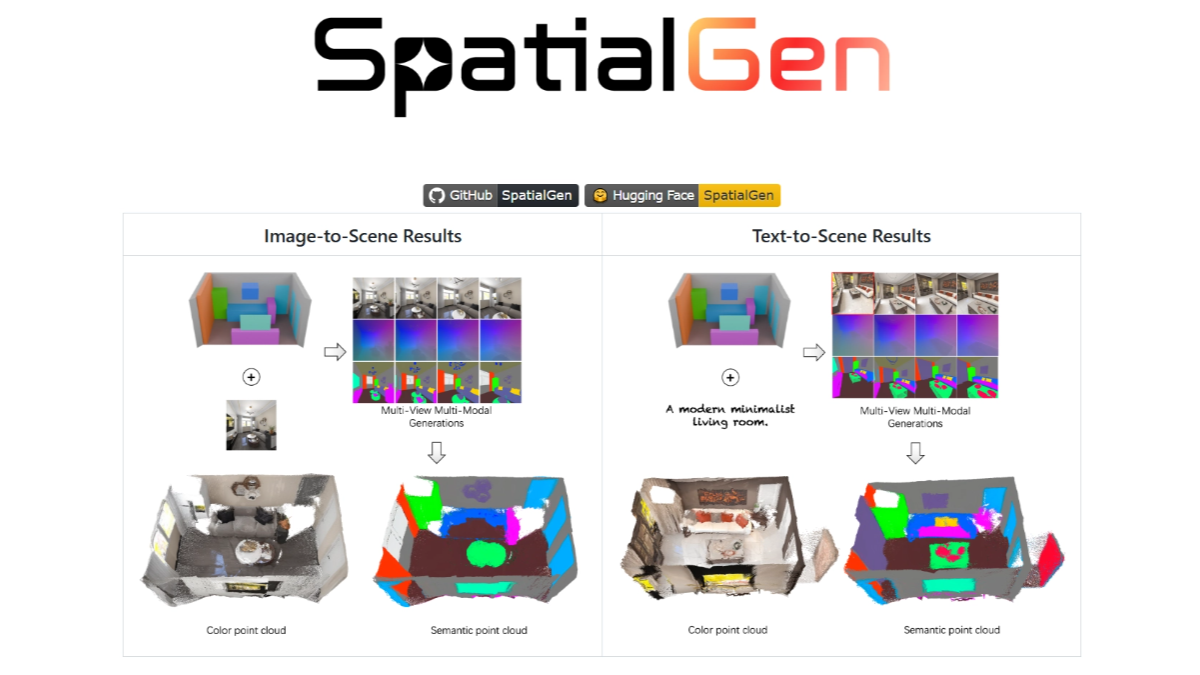
SpatialGen - 群核科技推出的开源3D场景生成模型

SpatialGen - Modelos de generación de escenas 3D de código abierto de Qunar Technologies

SpatialGen es un modelo de generación de escenas 3D de código abierto de Qunar Technology, basado en la arquitectura del modelo de difusión, que admite la generación de imágenes multivista coherentes espaciotemporalmente a partir de descripciones textuales, imágenes de referencia y disposición espacial 3D, y que además genera escenas gaussianas 3D y renderiza vídeos itinerantes.
hace 1 año
073.8K
Fun-ASR - 钉钉、通义联合推出的新一代语音识别模型

Fun-ASR: una nueva generación de modelos de reconocimiento del habla lanzada conjuntamente por Nail y Tongyi

Fun-ASR es un gran modelo de reconocimiento de voz lanzado conjuntamente por Nail y Tongyi Labs. El modelo se ha entrenado con datos de audio masivos y puede identificar con precisión terminología multisectorial, como Internet, tecnología, decoración del hogar, etc., mejorando significativamente la precisión del reconocimiento. El modelo se combina con la información empresarial de Nail para optimizar la inferencia y reducir el problema de las...
hace 1 año
0110.6K
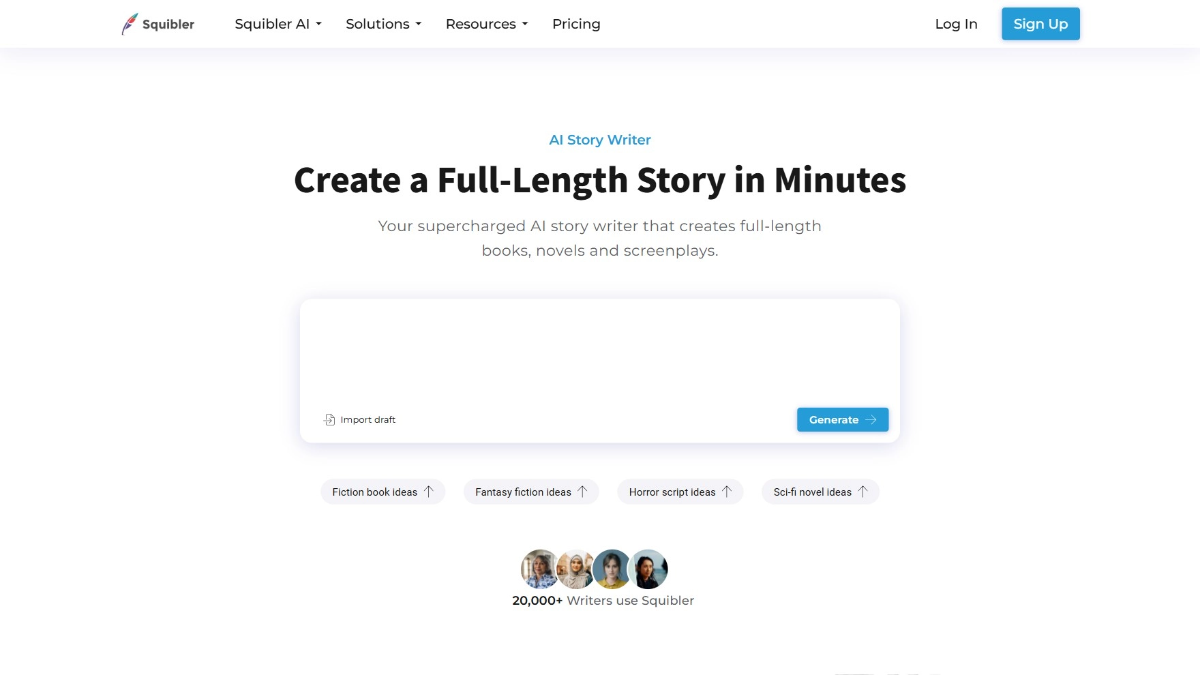
Squibler - AI小说辅助写作平台,助力构思到创作全过程

Squibler: plataforma de escritura asistida por inteligencia artificial que impulsa todo el proceso, desde la idea hasta la creación.

Squibler es una potente plataforma de escritura asistida por IA diseñada para escritores que ayuda a los usuarios en todo el proceso, desde la concepción a la creación y la publicación. La plataforma ofrece diversas plantillas de historias que abarcan novelas, guiones, relatos cortos, etc. Los usuarios solo tienen que introducir el concepto inicial, y la IA puede generar esquemas, personajes, escenas...
hace 1 año
079.9K
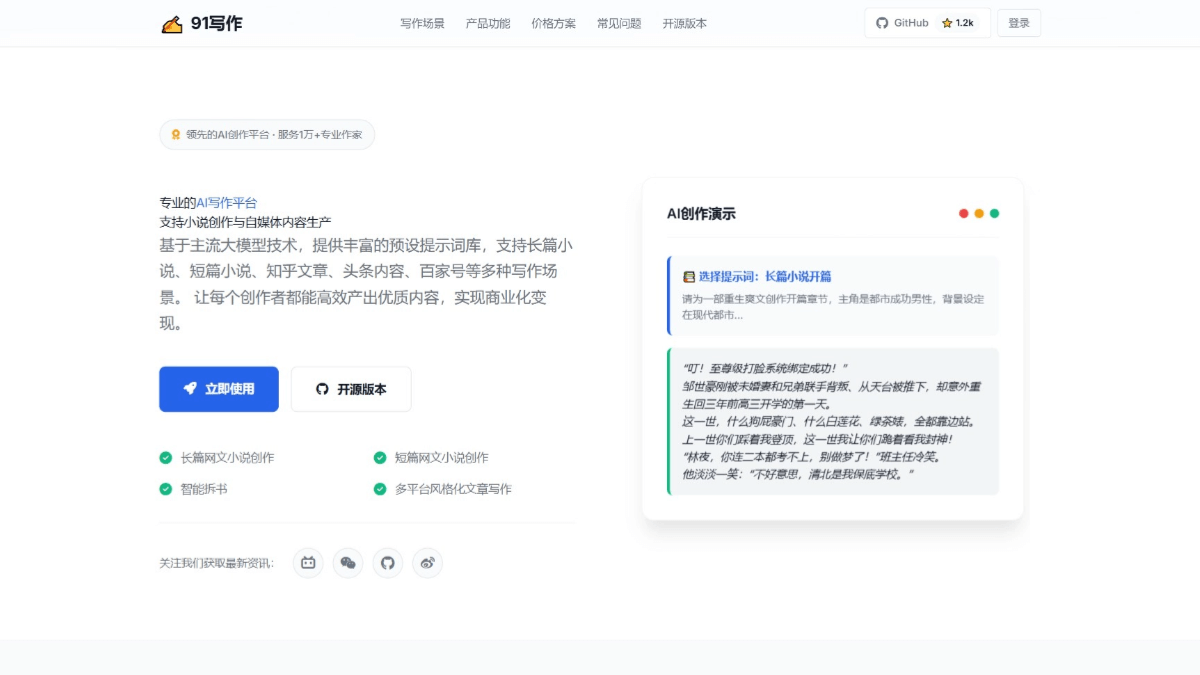
91写作 - 开源的AI智能小说创作平台

91Writing - Plataforma de creación de novelas inteligentes con IA de código abierto

91Writing es una herramienta de creación de novelas de IA totalmente de código abierto, desarrollada en base a Vue 3 y Element Plus, que integra una variedad de modelos avanzados de IA, como GPT, Claude, Gemini, etc. La herramienta proporciona a los creadores una completa cadena de herramientas de creación, desde la idea hasta el texto, incluyendo la creación de proyectos...
hace 1 año
0106K
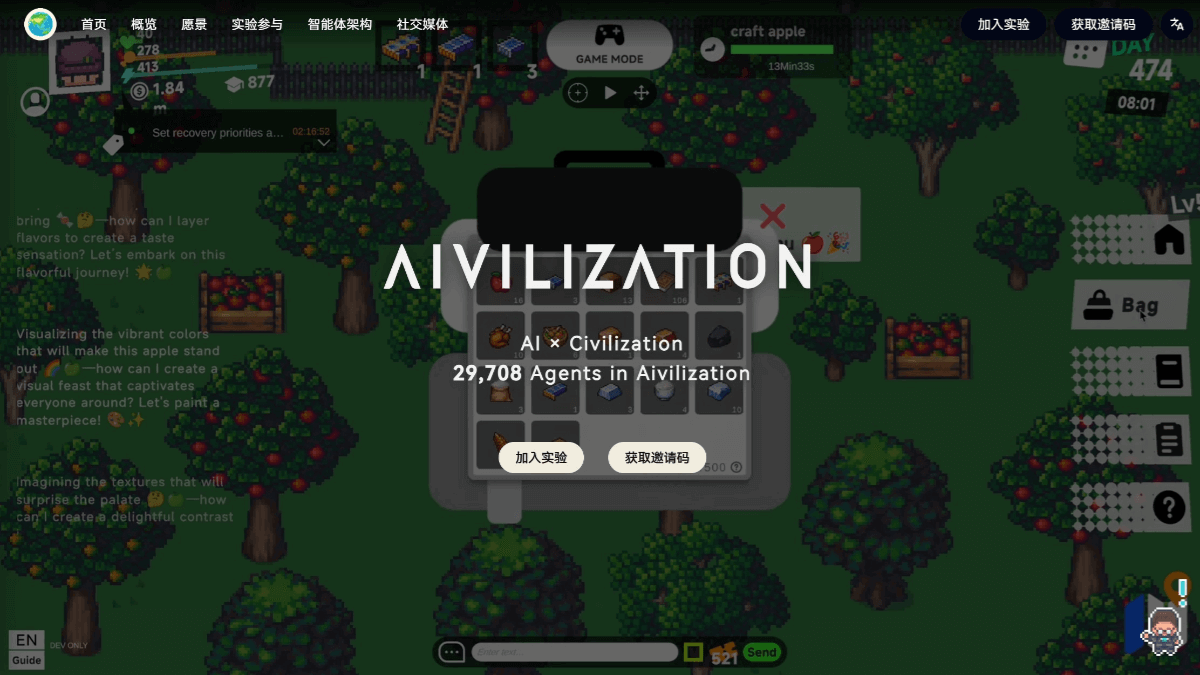
Aivilization - 港科大推出的多Agent社会模拟平台

Aivilization, una plataforma de simulación social multiagente lanzada por la HKUST

Aivilization es la primera plataforma de simulación social de cuerpos multiinteligentes de IA del mundo, desarrollada por la Universidad de Ciencia y Tecnología de Hong Kong. Construye una caja de arena digital visual donde los usuarios pueden crear y guiar a miles de inteligencias IA para observar la evolución social de la futura coexistencia entre humanos e IA. La plataforma admite...
hace 1 año
0128.1K
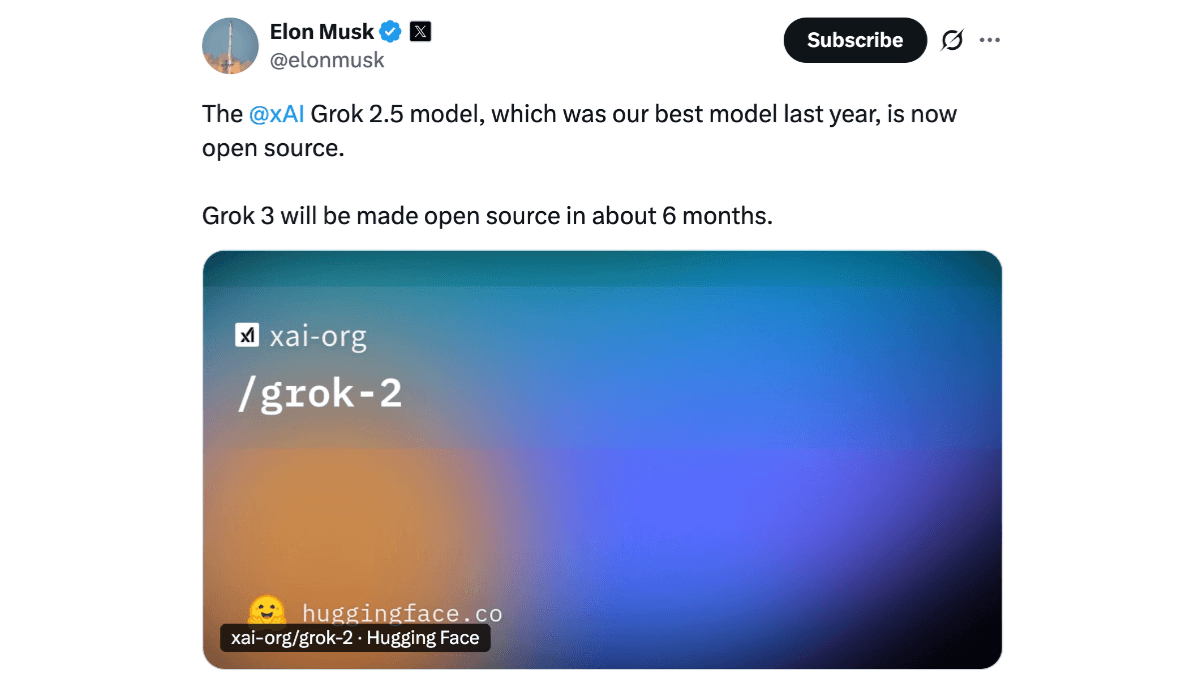
Grok 2.5 - 马斯克旗下xAI开源的人工智能模型

Grok 2.5 - El modelo de IA de código abierto xAI de Musk

Grok 2.5 es un modelo de IA de código abierto de la xAI de Elon Musk. Con 269.000 millones de parámetros, se basa en la arquitectura Mixed Expertise (MoE) para un rendimiento y una inferencia potentes. El modelo se ha probado con conocimientos científicos de nivel universitario (GPQA), conocimientos de uso general (MMLU, MM...
hace 1 año
089.8K
MIT最新报告《生成式AI鸿沟:2025年商业人工智能现状》

El nuevo informe del MIT, The Generative AI Divide: the State of Business Artificial Intelligence in 2025 (La brecha de la inteligencia artificial generativa: el estado de la inteligencia artificial empresarial en 2025)

El último informe del MIT, The Generative AI Divide: the State of Business AI in 2025, revela el núcleo del proceso de adopción de la IA generativa (GenAI) que están experimentando las empresas mediante una investigación en profundidad de más de 300 proyectos de IA, entrevistas con 52 organizaciones y una encuesta a 153 ejecutivos....
hace 1 año
0127.6K
AutoClip - 开源的AI视频切片工具,一键生成专题视频合集

AutoClip - Herramienta de código abierto para generar colecciones de vídeos temáticos con un solo clic.

AutoClip es de código abierto AI herramienta de edición de vídeo, basado en la tecnología de IA avanzada para lograr el proceso completo de procesamiento automatizado de vídeo. Las herramientas pueden identificar automáticamente los aspectos más destacados del vídeo, la extracción precisa de contenido valioso, se puede basar en la similitud del tema de la agrupación inteligente, para generar una colección de contenido.AutoClip apoyo...
hace 1 año
0104.7K
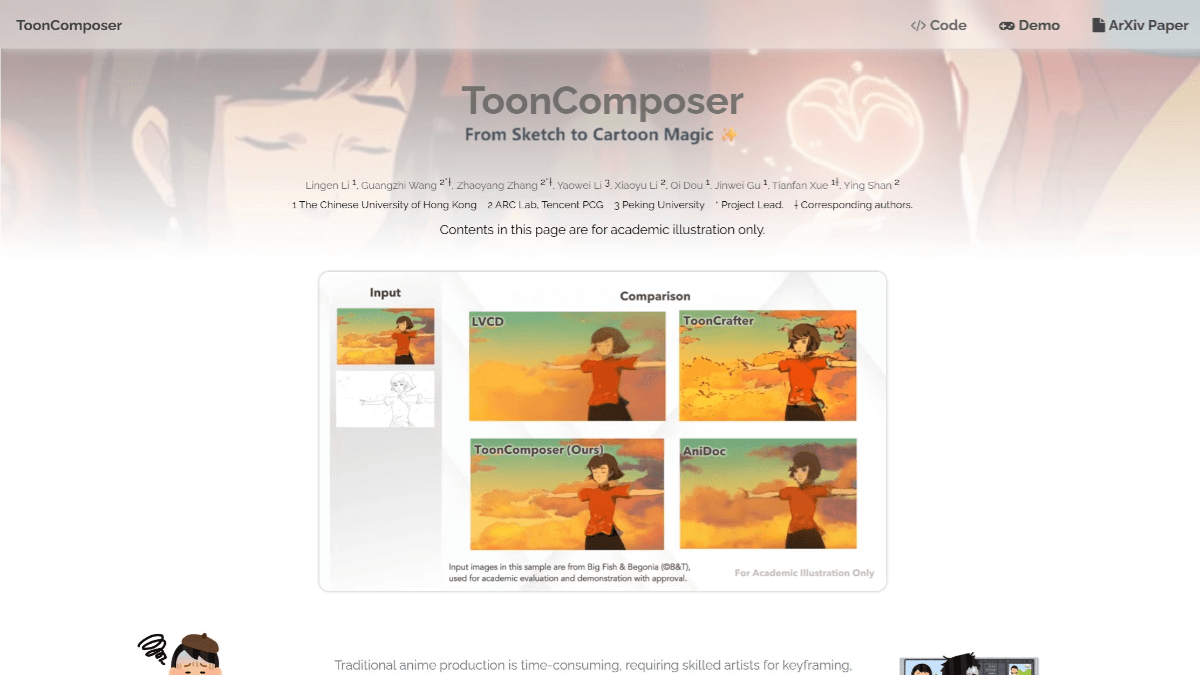
ToonComposer - 腾讯开源的生成式AI动画制作工具

ToonComposer - Herramienta de animación de IA generativa de código abierto de Tencent

ToonComposer es una herramienta de animación generativa por IA lanzada conjuntamente por la Universidad China de Hong Kong, Tencent PCG ARC Lab y la Universidad de Pekín. Gracias a la tecnología generativa de fotogramas clave posteriores, el proceso de generación de fotogramas intermedios y de coloreado se integra en un proceso automatizado que solo requiere un boceto y...
hace 1 año
091.4K
Seed-OSS - 字节跳动团队开源的全新AI模型

Seed-OSS - Un nuevo modelo de IA de código abierto del equipo de Wordpress

Seed-OSS es una familia de grandes modelos lingüísticos de código abierto del equipo Byte Jump Seed, centrada en tareas de razonamiento y textos largos. El modelo tiene un buen rendimiento en el razonamiento lógico complejo y el razonamiento en varios pasos con una gran precisión y puede resolver problemas difíciles de forma eficiente.Seed-OSS admite contextos de texto largo de hasta 512K....
hace 1 año
082.9K
Intern-S1-mini - 上海AI Lab开源的轻量化科学多模态模型

Intern-S1-mini - Modelo científico multimodal ligero de código abierto de Shanghai AI Lab

Intern-S1-mini es un macromodelo científico multimodal ligero con una escala de parámetros de 8B lanzado por el Laboratorio de Inteligencia Artificial de Shanghai (SAL).Hereda las potentes capacidades de Intern-S1, combinando tanto capacidades de propósito general como científicas especializadas, y es adecuado para un despliegue rápido y un desarrollo secundario. En términos de rendimiento, I...
hace 1 año
080.7K
CombatVLA - 淘天集团推出的高效VLA模型

CombatVLA - El eficiente modelo VLA de Amoy Group

CombatVLA es un innovador modelo 3D específico para juegos de rol de acción (ARPG) del equipo Future Life Lab del grupo Amoy.CombatVLA es un modelo de visión-lingüística-acción (VLA), construido a escala paramétrica 3B, que recoge la información del jugador humano a través del rastreador de movimiento....
hace 1 año
087.3K
MoE-TTS - 昆仑万维推出的最新语音生成框架

MoE-TTS: el último marco de generación de voz de KunlunWei

MoE-TTS es un marco de síntesis del habla introducido por KunlunWanwei, basado en la arquitectura Mixed Expert (MoE), que combina Large Language Models (LLMs) preentrenados con módulos expertos del habla.MoE-TTS conserva el potente razonamiento textual congelando los parámetros del módulo textual y actualizando sólo los parámetros del módulo del habla....
hace 1 año
081.3K
Genie Envisioner - 智元联合北航等开源的通用机器人操作平台

Genie Envisioner: la plataforma robótica de código abierto de uso general de Jiyuan con Beihang y otras entidades

Genie Envisioner (GE) es una plataforma unificada para operaciones robóticas desarrollada por el equipo de Genie Robotics en colaboración con la Universidad Nacional de Singapur, la Universidad de Aeronáutica y Astronáutica de Pekín y otras instituciones. Permite a los robots comprender y realizar mejor las tareas "imaginando primero y actuando después".
hace 1 año
078.2K
RynnEC - 阿里达摩院开源的世界理解模型

RynnEC - El modelo de comprensión del mundo de código abierto del Instituto Ali Dharma

RynnEC es un modelo de comprensión del mundo presentado por el Instituto Dharma de Alibaba, centrado en tareas de inteligencia incorporada. El modelo se basa en una tecnología de fusión multimodal que combina datos de vídeo y lenguaje natural, y puede analizar objetos de una escena desde múltiples dimensiones, lo que permite funciones como la comprensión de objetos, la percepción espacial y la segmentación de objetivos de vídeo.
hace 1 año
093.9K
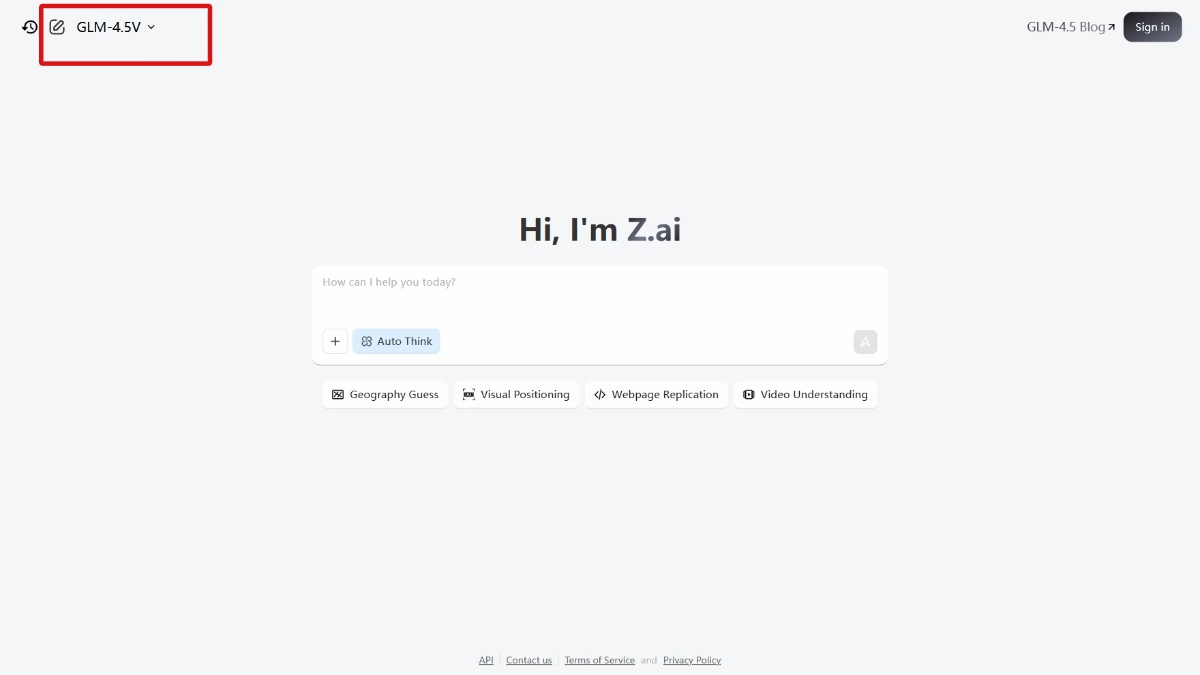
GLM-4.5V - 智谱推出的多模态开源视觉推理模型

GLM-4.5V - Modelo de razonamiento visual multimodal de código abierto de Smart Spectrum

GLM-4.5V es el modelo de inferencia visual de código abierto líder mundial presentado por Smart Spectrum, con 106.000 millones de parámetros totales y 12.000 millones de parámetros activados. El modelo se entrena a partir del modelo base de texto de nueva generación GLM-4.5-Air, con potentes capacidades de comprensión y razonamiento visual, capaz de manejar imágenes, vídeo...
hace 1 año
092.9K
SkyReels-A3 - 昆仑万维推出的音频驱动数字人创作工具

SkyReels-A3 - Herramienta de creación humana digital basada en audio de KunlunWangwei

SkyReels-A3 es una herramienta de creación humana digital basada en audio de Kunlun World Wide Group. SkyReels-A3 es una herramienta de creación humana digital basada en audio que puede generar contenidos de vídeo dinámicos de alta calidad a partir de entradas sencillas (por ejemplo, imágenes de retratos y voz), hacer que fotos estáticas "cobren vida" y sustituir líneas de vídeos existentes por nuevas sincronizaciones labiales que los personajes...
hace 1 año
082.5K
MiniMax Speech 2.5 - MiniMax推出的语音生成模型

MiniMax Speech 2.5 - Modelo de generación de voz de MiniMax

MiniMax Speech 2.5 es un modelo avanzado de generación del habla desarrollado por el equipo MiniMax. Supone un avance significativo en el campo de la síntesis del habla, especialmente en términos de expresividad multilingüe, precisión en la reproducción del timbre y cobertura lingüística. El modelo admite 40 idiomas...
hace 1 año
085.8K
GPT-5 - OpenAI推出的最强语言模型,统一智能系统

GPT-5 - El modelo de lenguaje más sólido presentado por OpenAI, sistema de inteligencia unificado

GPT-5 es el último modelo de lenguaje lanzado por OpenAI con varias actualizaciones. Es un sistema de inteligencia unificada con un enrutador en tiempo real integrado que cambia automáticamente entre los modos de pensamiento eficiente y profundo en función de la complejidad del problema, lo que permite una respuesta rápida y respuestas precisas.GPT-5 tiene varias versiones, incluyendo para pu...
hace 1 año
084K
Genie 3 - 谷歌推出的通用世界模型

Genie 3 - El modelo universal del mundo de Google

Genie 3 es una nueva generación de modelos de mundo universales de Google DeepMind que permiten generar mundos virtuales muy dinámicos y coherentes en tiempo real.Genie 3 simula fenómenos físicos, ecosistemas naturales y admite la creación de escenarios fantásticos e históricos. Con indicaciones de texto, los usuarios pueden...
hace 1 año
082.8K