K2.8 Preview - 月之暗面推出的新一代主力编码模型

K2.8 Preview是什么
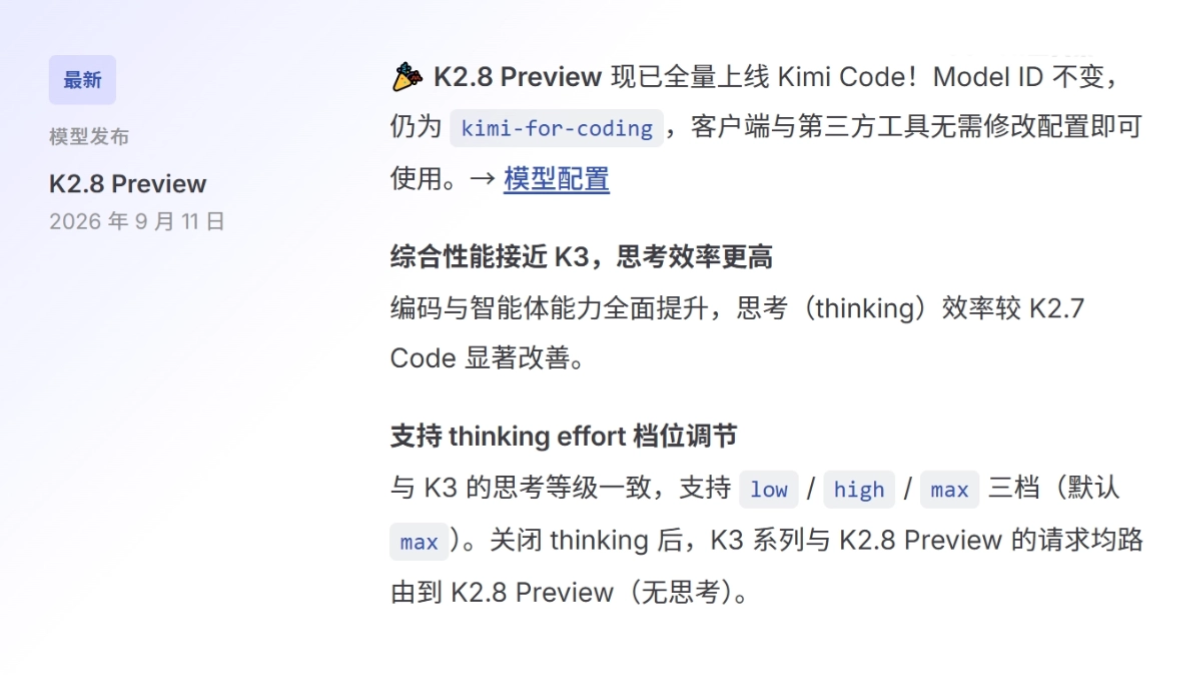
Kimi K2.8 Preview 是月之暗面推出的新一代主力编码模型,已在 Kimi Code 和 Kimi Work 平台全量上线。模型采用 kimi-for-coding 模型 ID 实现无感升级,第三方工具无需改配置。模型性能接近旗舰 K3,编码与 Agent 能力较 K2.7 全面提升,模型支持 low/high/max 三档思考强度、图片视频多模态输入,1M 超长上下文向包括免费档在内的所有会员开放。
K2.8 Preview的功能特色
- 无感升级:模型 ID 保持
kimi-for-coding不变,现有客户端和 Claude Code、Codex 等第三方工具直接换芯,零配置成本。 - 三档思考强度:支持 low / high / max 三档推理预算,与 K3 思考等级对齐,简单任务省 token、复杂任务换成功率。
- Multi-modal inputs:可识别图片和视频,适合截图报错、录屏复现 bug、参考设计稿写代码等开发场景。
- 1M 超长上下文:最高 100 万 token 上下文窗口向包括免费档在内的所有会员开放,可一次性处理整个大型代码库或超长日志。
- 智能路由分流:K3 系列关闭 thinking 后,请求自动转交 K2.8 无思考版本处理,同一入口体验无缝衔接。
- 更强的 Agent 闭环能力:编码与智能体能力较 K2.7 Code 全面提升,能自主推进跑测试、修失败用例、提 PR 等多步工程任务。
K2.8 Preview的核心优势
- 无感升级:模型 ID 保持
kimi-for-coding不变,现有客户端和 Claude Code、Codex 等第三方工具直接换芯,零配置成本。 - 三档思考强度:支持 low / high / max 三档推理预算,与 K3 思考等级对齐,简单任务省 token、复杂任务换成功率。
- Multi-modal inputs:可识别图片和视频,适合截图报错、录屏复现 bug、参考设计稿写代码等开发场景。
- 1M 超长上下文:最高 100 万 token 上下文窗口向包括免费档在内的所有会员开放,可一次性处理整个大型代码库或超长日志。
- 智能路由分流:K3 系列关闭 thinking 后,请求自动转交 K2.8 无思考版本处理,同一入口体验无缝衔接。
- 更强的 Agent 闭环能力:编码与智能体能力较 K2.7 Code 全面提升,能自主推进跑测试、修失败用例、提 PR 等多步工程任务。
K2.8 Preview的操作步骤
- Kimi Code CLI:登录账号后正常发起会话,即在用 K2.8 Preview;输入
/model可确认当前模型,输入/effort切换 low / high / max 三档思考强度。 - Kimi Work 平台:直接在 Kimi Work 中创建任务,平台会自动将请求路由到 K2.8 Preview,无需任何手动配置。
- Third-party tool access: in Claude Code、OpenCode、Codex 等工具中确认模型 ID 为
kimi-for-coding;Allegretto 及以上会员若追求速度,可改用kimi-for-coding-highspeed(。 - 会员权限确认:从免费档 Adagio 到 Allegro 所有订阅档位均可调用,且直接解锁 1M 超长上下文,不需要额外申请或付费。
- 思考档位调节:简单任务切 low 档省 token,中等任务用 high 档平衡,复杂工程任务用 max 档换取更高成功率,与旗舰 K3 的思考等级完全对齐。
K2.8 Preview的适用人群
- 预算敏感的个人开发者:免费档即可调用,零成本用上 1M 上下文和多模态输入,是体验旗舰级编程能力的最低门槛入口。
- 高频大用量开发者:K3 跑日常任务成本太高,K2.8 速度更快、行为更可控,配合订阅制和加油包,大量调用也不心疼。
- 大型代码库维护者:1M 上下文全员开放,无需高价档就能整仓分析、跨文件重构,适合处理巨型 monorepo 和遗留项目。
- Agent 工作流搭建者:Agent 能力较 K2.7 全面提升且支持三档思考切换,适合搭建自动修测试、提 PR 等多步骤自动化流水线。
K2.8 Preview的常见问题
Q1:需要手动升级或改配置才能用上 K2.8 吗?
A1:不需要。模型 ID 仍为 kimi-for-coding,已全量上线并静默换芯,现有客户端和第三方工具零改动。
Q2:免费用户能用吗?
A2:能。从 Adagio(免费档)到 Allegro 全部会员档位均可调用,且直接享有 1M 上下文,无需额外付费。
Q3:和 K3 是什么关系?选哪个?
A3:K2.8 定位日常主力,K3 定位旗舰极限能力。K3 关闭 thinking 后请求会自动路由到 K2.8 无思考版本。日常高频开发选 K2.8,复杂关键任务选 K3。
Q4:性能到底怎么样?有跑分吗?
A4:官方称综合性能接近 K3,但暂未公布 benchmark 数据。早期开发者实测:比 K3 快约三分之一、费用低约三成,但一次通过率略逊于 K3。
Q5:三档思考强度怎么用?
A5:输入 /effort 切换:low 档快且省 token 适合简单补全;high 档均衡;max 档投入更多思考换复杂任务成功率,默认即为 max。
© Copyright notes
Article copyright AI Sharing Circle All, please do not reproduce without permission.
Related posts

No comments...
 English
 简体中文
 日本語
 한국어
 Русский
 Español