シックスシグマのための5つのChatGPTヒント - プロジェクトマネジメントChatGPTプロンプトワード1. "シックスシグマにおける「DMAIC(定義、測定、分析、改善、管理)」が[特定の結果や効果]に与える影響について論じた記事の紹介文を書きなさい。要因1]、[要因2]、[要因3]などの要素を考慮し、[特定の業界]におけるその重要性を強調しなさい。" 2. ...AIユーティリティ・コマンド2年前076.4K
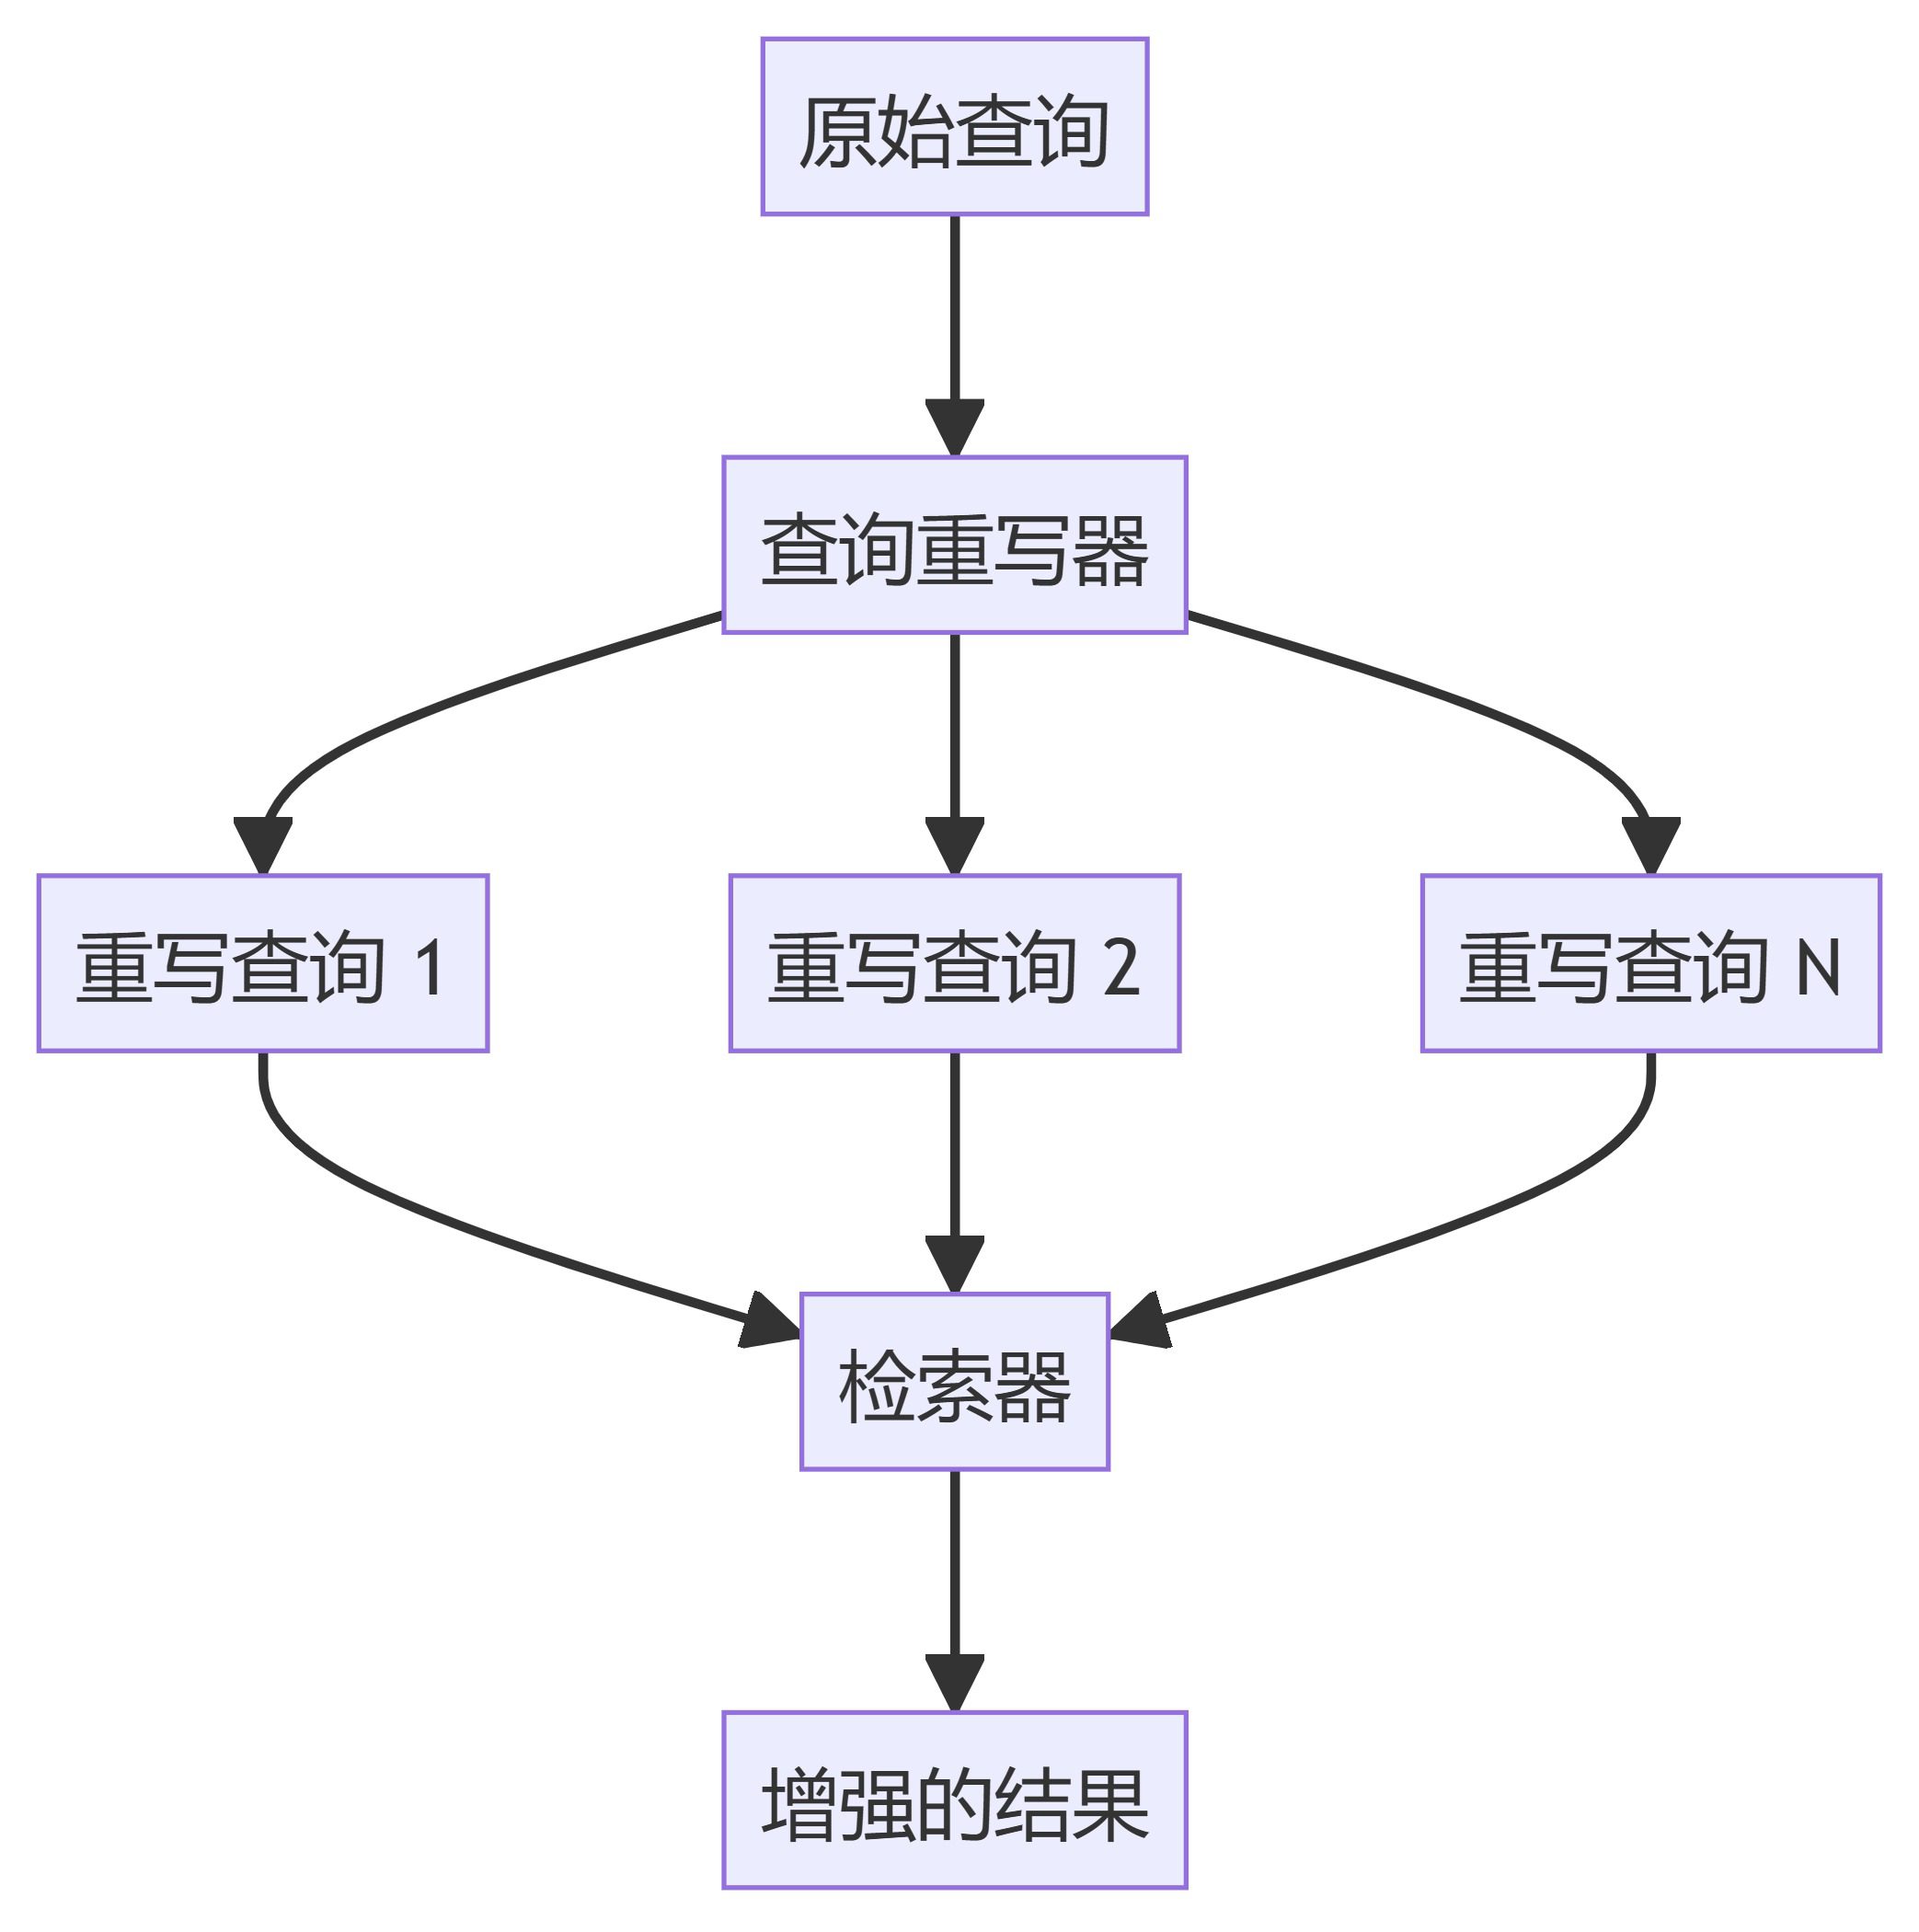
AI College of Engineering: 2.11 高度なクエリ処理(クエリ変換ユーザーマニュアル)はじめに クエリ変換ユーザーマニュアルでは、RAG(Retrieval-Augmented Generation)クエリエンジン、インテリジェンス、またはその他のプロセスで実行される前に、ユーザーのクエリを変換して曖昧さをなくすためのさまざまなテクニックを紹介します。これらの変換により、AIアプリケーションにおける応答の品質と関連性を向上させることができます。 https://gith...AI知識ベース2年前076.3K
AIエンジニアリング・アカデミー:2.13 RAG-フュージョン:検索機能強化 生成機能強化はじめに RAG-Fusionは、RAG(Retrieval Augmented Generation)をベースに構築された高度な情報検索とテキスト生成の方法論である。このプロジェクトでは、RAG-Fusionを実装し、ユーザーのクエリに対して、より正確で、文脈に関連した、包括的な応答を提供する。 htt...AI知識ベース2年前076.3K
ハイパーパラメーター(ハイパーパラメーター)とは何か、見て理解するための記事機械学習において、ハイパーパラメータとは、データから学習するのではなく、モデルの学習を開始する前に手動でプリセットされる設定オプションのことである。中心的な役割は、アルゴリズムの動作ルールを設定するように、学習プロセス自体を制御することである。例えば、学習...AIアンサー1年前076.2K
正則化(レギュラー化)とは何か、見て理解するための記事正則化は、モデルのオーバーフィッティングを防ぐための、機械学習や統計学における中核的な手法である。正則化は、モデルの複雑さに関連するペナルティ項を目的関数に追加することで、フィッティングの度合いを制御する。一般的な正則化にはL1正則化とL2正則化があり、L1正則化はスパース解を生成し、...AIアンサー1年前076K
LinkedInのための10のChatGPTヒント - HR & Recruiting ChatGPTプロンプトワード1.「{業界}分野の{求職者}のために、そのユニークな{スキル}と{価値提案}を強調する魅力的なLinkedInのヘッドラインを作成する」。 2.「{職種}のポジションを目指す{求職者}のために、プロフェッショナルなLinkedInプロフィールを作成し、強力な...AIユーティリティ・コマンド2年前075.8K
長文ベクトルモデルは4Kトークンを超えるか?2025年2月に発表されたNoLiMAは、長文の理解度を評価するための大規模言語モデル(LLM)手法である。キーワードマッチングに依存する従来のNIAH(Needle-in-a-Haystack)テストとは異なり、最も...AI知識ベース2年前075.6K
10 面接用ChatGPTプロンプト指示 - 人事・採用ChatGPTプロンプトワード1. "候補者のスキルと資質を評価することに重点を置いた、{[ポジション]}のためのトップ面接質問を作成してください。これらの{[主要要件]}を含めてください。" 2. "これらの必須の{[スキル]}と{[資質...]}を強調する{[役割]}のための魅力的で洞察力のある面接質問を作成します。AIユーティリティ・コマンド2年前075.6K
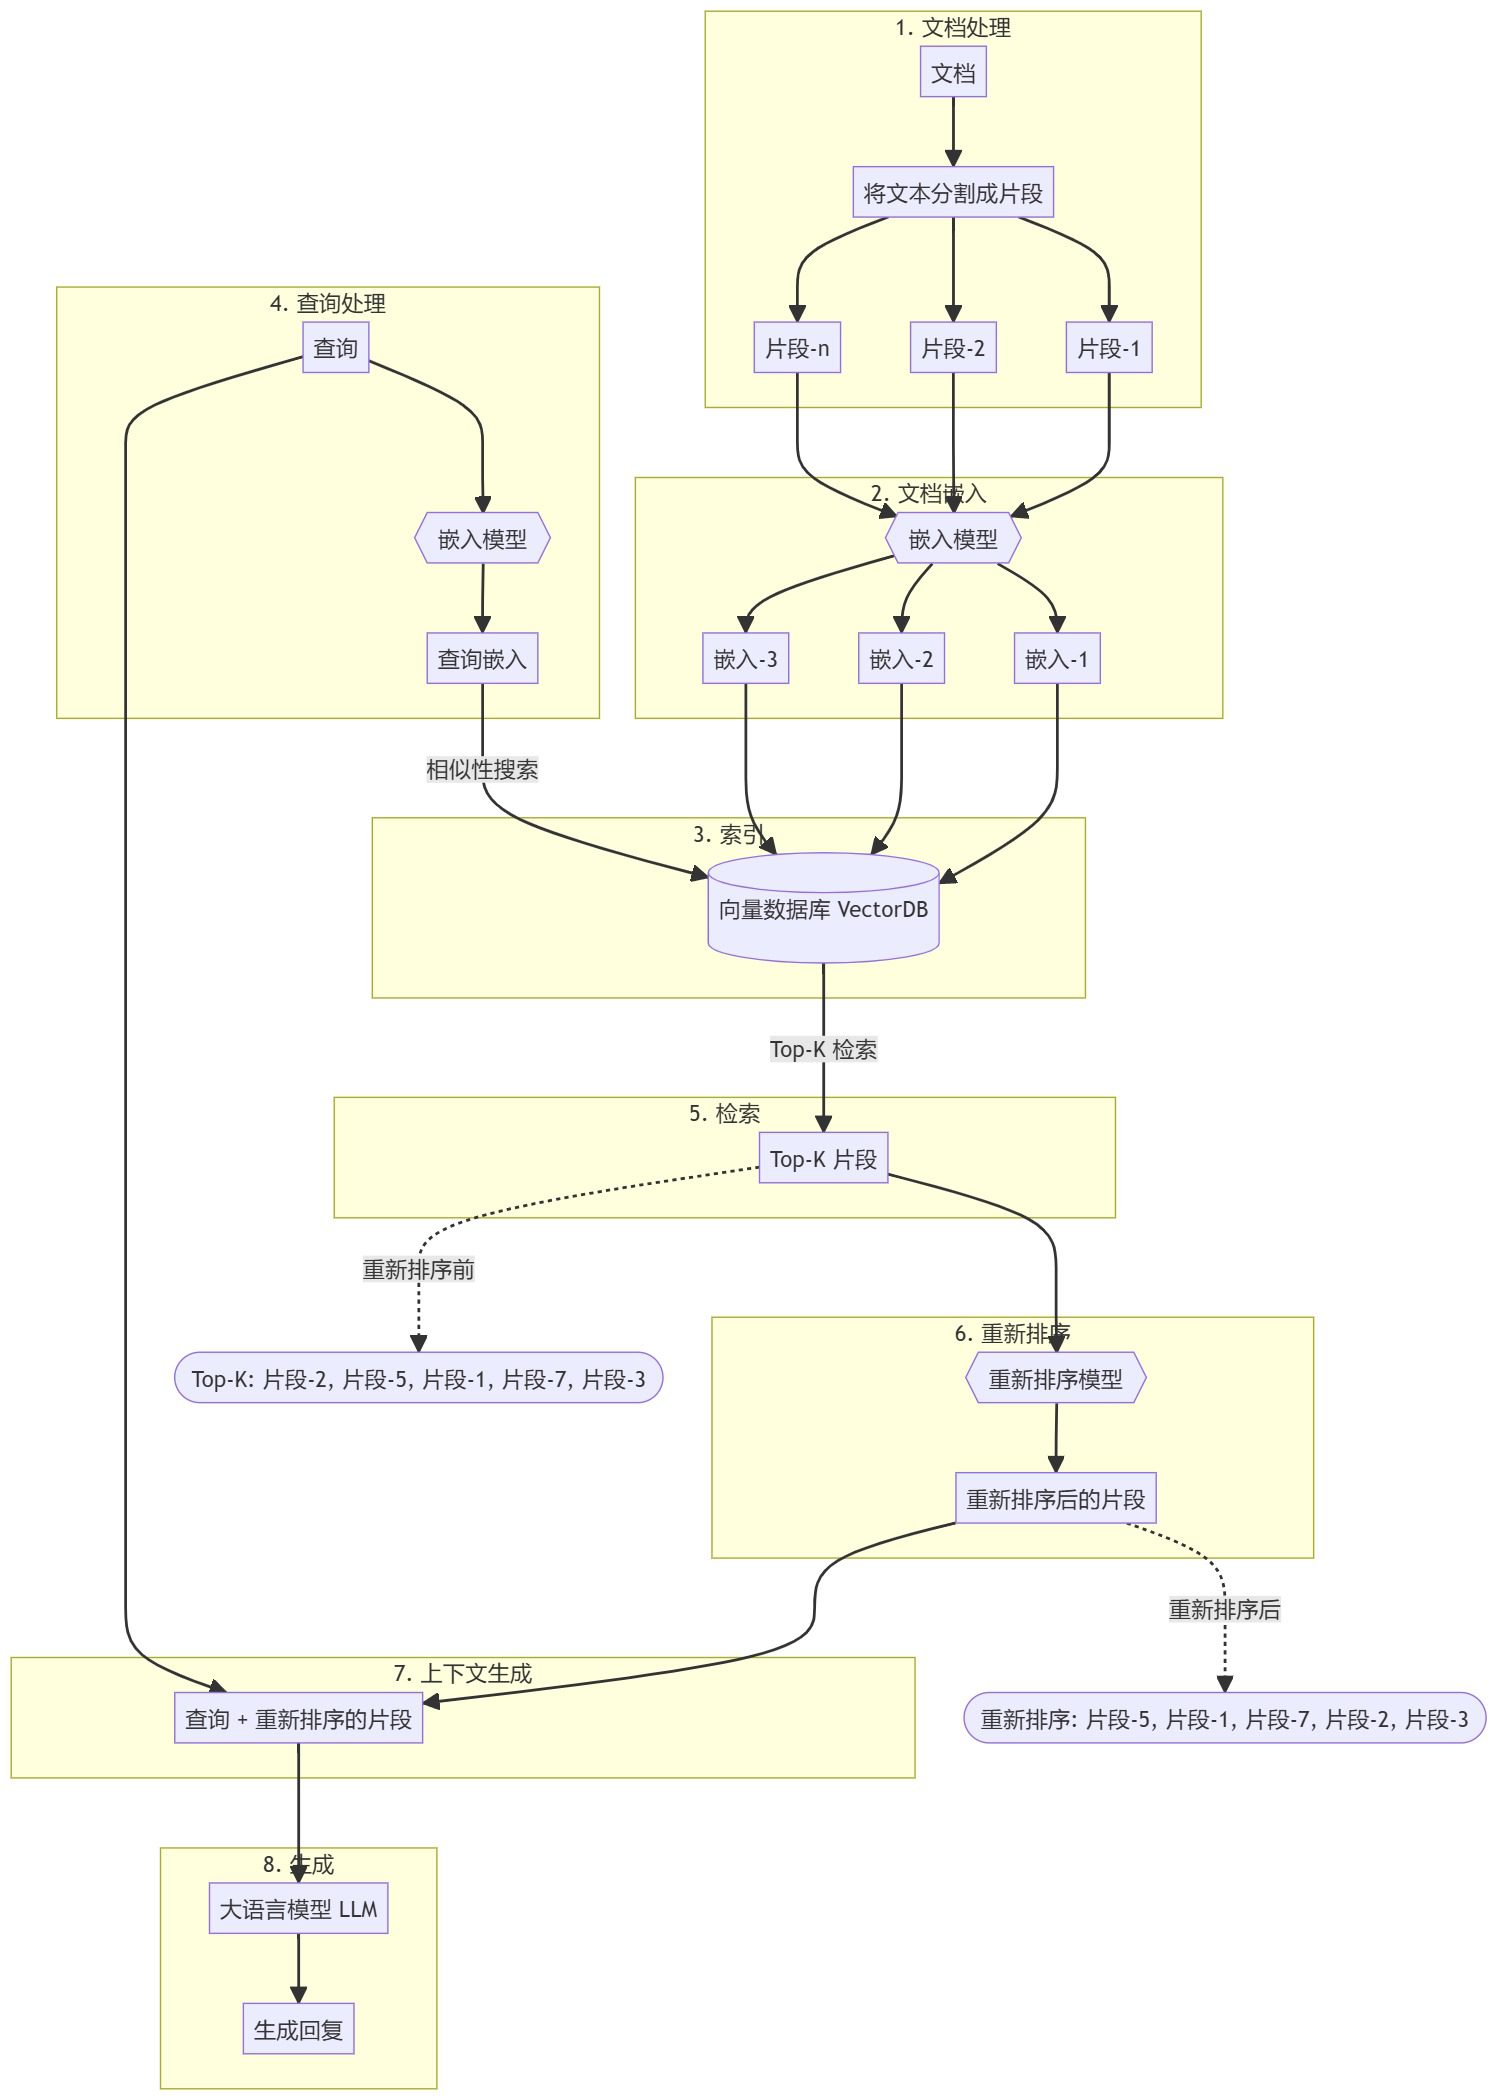
AIエンジニアリング・アカデミー:2.7 ReRanker RAG(並び替え)並べ替えモデルは、ユーザの質問に対する意味的な一致度に基づいて候補文書のリストを並べ替えることで、意味的ランキングの結果を改善する。 よく使われるbge-reranker-v2-m3やcohereAI知識ベース2年前075.4K
ナイーブ・ベイズとは何か?ナイーブベイズ・アルゴリズムは、ベイズの定理に基づく教師あり学習アルゴリズムである。「ナイーブベイズはベイズの定理に基づいており、特徴は互いに条件付きで独立であると仮定している。この仮定を単純化することで、計算の複雑さが大幅に軽減され、実用的なアプリケーションにおいて効率的なアルゴリズムとなる。AIアンサー12ヶ月前075.3K
自己PRのためのChatGPTプロンプト10選 - ライティングChatGPTプロンプトワード1.自己PR文では、"{特定の専攻分野または進路}"に対するあなたの情熱を強調しましょう。その情熱の原動力は何か、またその情熱があなたの学問的な道のりやキャリア目標をどのように形成してきたかを説明してください。" 2. "あなたが克服した大きな挑戦に焦点を当てた自己PRを書き、...AIユーティリティ・コマンド2年前075.3K
製品概要 Smart Home Security Systems - Ultimate Marketing Copy ChatGPT Prompts製品名] 革新的なスマートホームセキュリティシステム [はじめに] スマートホームセキュリティシステムの簡単な紹介、その特徴と利点 [パートI] タイトル: 主な特徴 説明: 動体検知、カメラの画質など、スマートホームセキュリティシステムの主な特徴を列挙する。AIユーティリティ・コマンド2年前074.5K
人間性ヒント工学コース - 第9章 練習問題:複雑なヒントをプログラミングする練習問題 この練習問題では、コードを読み取り、適切な場合にはガイド付きの修正を提供することができるプログラミング支援およびティーチングロボット用のプロンプトを作成します。前の複雑なプロンプトの例の説明と例に一致するプロンプト要素を、下の黄色のボックスのそれぞれに記入してください。記入が終わったら、...AI知識ベース2年前074.5K
AI UXデザイン学習ガイド本ガイドは、AI UXデザインの研究に関心のある読者に簡潔な入門書を提供することを目的としています。このガイドでは、AIエンジニアの役割、AIのバリューチェーン、AIアプリケーションの成功事例を取り上げ、AI UXデザインの基本原則のいくつかを探ります。 原文:h...AI知識ベース2年前074.4K
コンバージョン率最適化(CRO) - 究極のマーケティングコピー ChatGPTプロンプト- ウェブサイトのユーザーエクスペリエンスを最適化し、サインアップ、ダウンロード、購入などの主要アクションのコンバージョン率を向上させるCRO戦略を策定できますか? - 改善点や最適化の機会を特定するために、ユーザーリサーチやユーザビリティテストを実施するにはどのような方法がありますか? - A/Bテストとその...AIユーティリティ・コマンド2年前074.3K
Generative Adversarial Network(GAN)とは?Generative Adversarial Network(GAN)は、2014年にIan Goodfellowらによって提案されたディープラーニングモデルである。このフレームワークは、2つのニューラルネットワークを互いに学習させることで生成モデルを実装する...AIアンサー1年前074.1K
シンプルなコピーライティング - 究極のマーケティング・コピー ChatGPTプロンプト- "理想的な顧客ペルソナ "に直接語りかけ、[ウェブサイト/製品]で[望ましい行動]を取るよう促す、説得力のある[文章タイプ]を書いてください" - "独自の強みと... "を強調することで、潜在的な反対意見に対処する[テキストタイプ]が必要です。AIユーティリティ・コマンド2年前074K
事前学習済みモデル(Pre-trained Model)とは何か、読んで理解するための記事事前学習済みモデル(PTM)は、人工知能における基本的かつ強力な手法であり、大規模なデータセットで事前学習された機械学習モデルを表す。モデルは大量の情報を処理し、データから一般的なパターンや特徴を学習することで、幅広い知識ベースを形成する。AIアンサー1年前074K
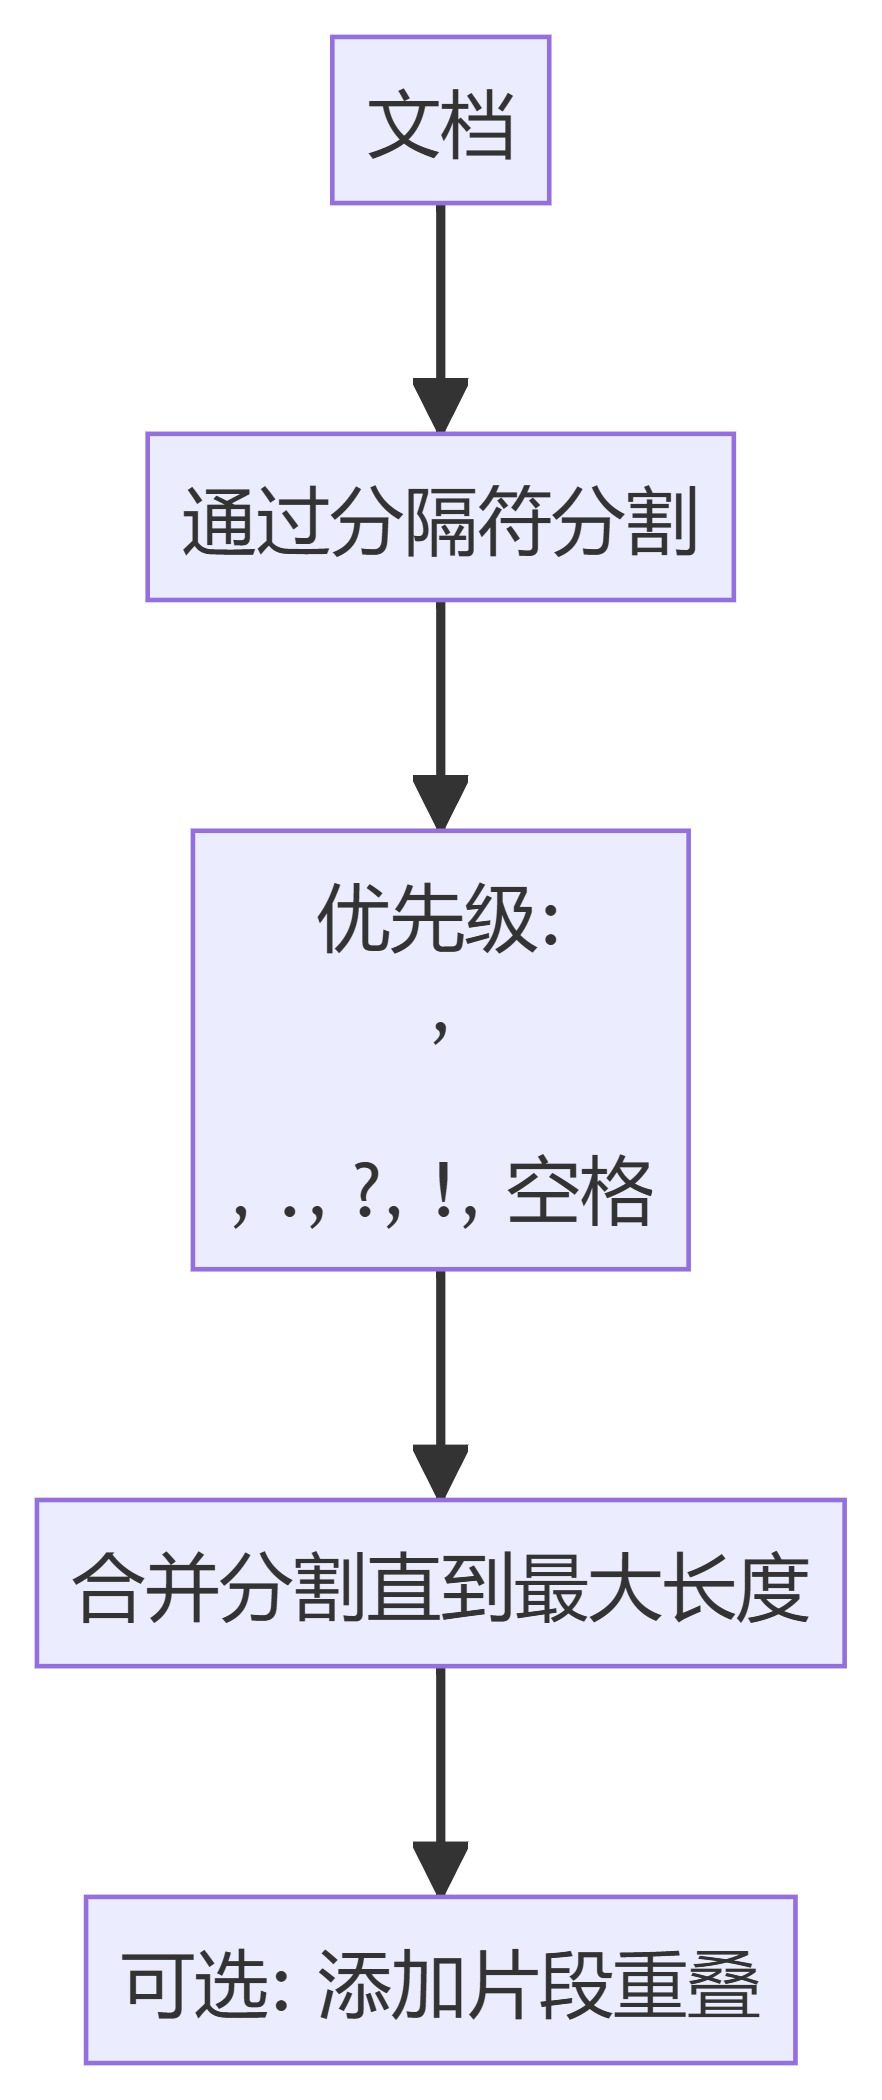
AI工学アカデミー:2.4 検索拡張世代(RAG)システムのためのデータチャンキング技術はじめに データ・チャンキングは、検索拡張世代(RAG)システムにおける重要なステップである。効率的な索引付け、検索、処理のために、大きな文書を管理しやすい小さな断片に分割します。このREADMEでは、RAGパイプラインで利用可能な様々なチャンキング手法の概要を説明します。 https...AI知識ベース2年前073.9K
販売予測とエンパワーメント - 究極のマーケティング・コピー ChatGPTプロンプト「販売データを分析し、次の四半期/年間の予測を提供してもらえますか? "在庫管理や価格戦略を改善するために、販売予測をどのように活用できますか?" 「販売データと市場動向に基づいて、[商品/サービス]の売上を伸ばすための提案をしてもらえますか? 「当社の...AIユーティリティ・コマンド2年前073.7K
人間工学講座 第5章:書式付き出力とクロード式Course Claudeは様々な方法で出力をフォーマットすることができます。 必要なのは、そうするように要求することだけです! 1つの方法は、XMLタグを使用して応答を他の余計なテキストから分離することです。プロンプトをよりわかりやすく簡単にするためにXMLタグを使用できることを学びました...AI知識ベース2年前073.4K
質的調査のためのChatGPT10のヒント - 製品管理ChatGPTプロンプトワード1. "質的研究の概要を説明し、{研究分野}への適用に焦点を当て、この研究アプローチで収集される主要な方法論とデータの種類について論じる。" 2. "テーマ}を研究する際の質的研究の強みと限界について論じ、量的研究手法と比較した場合の優位性を強調し、...AIユーティリティ・コマンド2年前073.1K
人間工学コース - 第2章: 明確でわかりやすい説明教訓 **クロードは明確で直接的な指示に最もよく反応する。 クロードを、入社したばかりの新入社員と同じだと考えてください。** クロードは、あなたが文字通り指示したこと以外に、何をすべきかという背景情報を持っていません。初めて人間に尋ねるようなものだ。AI知識ベース2年前072.7K
AIエンジニアリング・アカデミー:2.18Vision RAG ビジョン機能備考:https://colab.research.google.com/github/run-llama/llama_index/blob/main/docs/docs/examples/multi...AI知識ベース2年前072.7K
ファインチューニングとは何か?モデルの微調整(Fine-tuning)は、機械学習における転移学習の具体的な実装である。中核となるプロセスは事前学習モデルに基づいており、大規模なデータセットを用いて一般的なパターンを学習し、広範な特徴抽出能力を開発する。ファインチューニングの段階では、次にタスクに特化したデータセットを導入し、...AIアンサー1年前072.6K
人間工学講座 第6章 一歩一歩考えるLesson 突然起こされて、すぐに答えなければならない複雑な質問をいくつかされたら、あなたはどう思うだろうか?おそらく、答える前に考える時間があった場合ほどうまくはいかないだろう。 クロードも同じだ。 クロードに考える時間を徐々に与えることで、...AI知識ベース2年前072K
10 求人リスト用ChatGPTプロンプト指示 - 人事・採用ChatGPTプロンプトワード1."{[企業名]}の{[職種名]}ポジションのために、必要な{[資格]}、{[職務]}、{[福利厚生]}を強調した魅力的な求人情報を書く" 2.「{[業界]}における{[職種名]}職務のための...魅力的な求人情報をデザインする。AIユーティリティ・コマンド2年前071.6K
人間性即興工学講座 - 第8章:幻想を避けるレッスン 悪いニュース:クロードはときどき「幻覚」を見たり、真実でない、あるいは理不尽な発言をしたりする。 良い知らせは、幻覚の発生を抑えるのに役立つテクニックがあるということです。 以下では、そのテクニックのいくつかを紹介する。AI知識ベース2年前071.5K
人間性プロンプト・エンジニアリングコース - 第9章 練習問題:金融サービスのための複雑なプロンプト例 財務のプロンプトは、法律のプロンプトと同様の理由で非常に複雑になることがあります。以下は、Claude が税務情報を分析し、質問に答えるために使用される、財務使用シナリオの練習です。法律サービスの例と同様に、いくつかの要素の順序を調整しています...AI知識ベース2年前071.4K
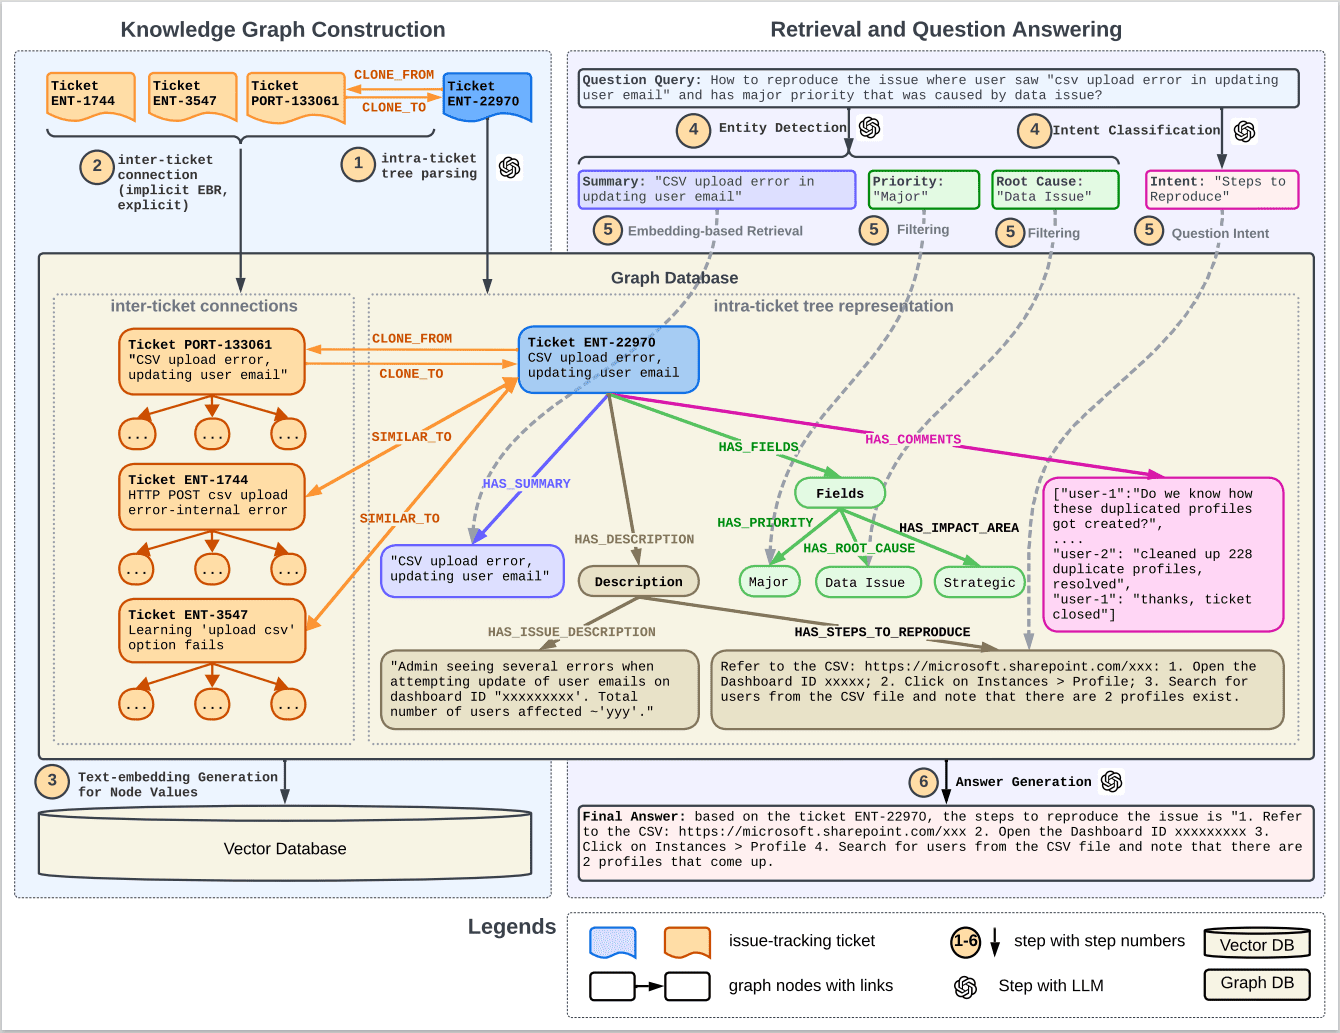
接客クイズのための知識グラフ検索機能強化の生成論文アドレス:https://arxiv.org/abs/2404.17723 知識マッピングは、的を絞った方法でしか実体関係を抽出できない。このような安定的に抽出可能な実体関係は、構造化データに近いものとして理解できる。 図1は、...を組み合わせた知識グラフを示している。AI知識ベース3年前071.3K
クロスバリデーション(交差検証)とは何か?クロスバリデーションは、機械学習におけるモデルの汎化能力を評価するための中核的な手法である。基本的な考え方は、元のデータを訓練セットとテストセットに分割し、訓練と検証を異なるデータ部分集合でローテーションすることで、より信頼性の高い性能推定値を得ることである。このアプローチでは、...AIアンサー1年前071.2K
人間性ヒント工学講座 - 第7章:サンプルガイド(少ないサンプルヒント)レッスン どのように動作してほしいか(または動作してほしくないか)の例をクロードに与えることは、次のことに非常に効果的です: 正しい答えを得ること 正しい形式で答えを得ること このタイプのヒンティングは「サンプルレスヒンティング」とも呼ばれます。また、「ゼロサンプル」、「nサンプル」...といった場合もあります。AI知識ベース2年前071.1K
サポートベクターマシン(サポートベクターマシン)とは何か、読んで理解するための記事サポートベクターマシン(SVM)は、統計的学習理論に基づく教師あり学習アルゴリズムで、主に分類や回帰分析に用いられる。中心的な目的は、異なるカテゴリのデータ点を分離し、2つのデータ点の差を最大化する最適な決定超平面を見つけることである。AIアンサー10ヶ月前070.3K
損失関数(ロス・ファンクション)とは何か、読んで理解するための記事損失関数(LF)は機械学習の中核をなす概念であり、モデルの予測誤差を定量化するという重要な役割を担っている。この関数は、モデルの予測値と真の値との差の程度を数学的に測定し、モデルの最適化のための明確な方向性を提供する。AIアンサー1年前069.8K
DeepSearch/DeepResearchにおける最適なテキストセグメントの選択とURLの再配置Jinaの前回の定番記事「DeepSearch/DeepResearchの設計と実装」を読んだ方は、回答の質を劇的に向上させることができる詳細についてもっと深く掘り下げたいと思うかもしれない。今回は、「長いウェブページから最適なテキストを抽出する」という2つの詳細に焦点を当てる。AI知識ベース2年前068.7K
ランダムフォレスト(無作為の森)とは何か、読んで理解するための記事ランダムフォレスト(Random Forest)は、複数の決定木を構築し、それらの予測値を組み合わせることで機械学習タスクを実行する統合学習アルゴリズムである。このアルゴリズムは、ブートストラップ集計の考えに基づいており、元のデータセットから複数のサンプルのサブセットをランダムに抽出し、各ツリーに対してプットバックを行う...AIアンサー1年前068.7K
デシジョンツリー(決定木)とは何か?決定木(DT)は、人間の意思決定プロセスをシミュレートするツリー型の予測モデルであり、一連のルールによってデータを分類または予測する。各内部ノードは特徴テストを表し、枝はテスト結果に対応し、葉ノードは最終決定を格納する。このアルゴリズムは分割統治戦略を用いる...AIアンサー1年前068.6K
畳み込みニューラルネットワーク(CNN)とは何か?畳み込みニューラルネットワーク(CNN)は、格子構造を持つデータを処理するために特別に設計された人工ニューラルネットワークであり、画像や映像解析の分野で優れている。AIアンサー12ヶ月前068.6K
ビッグ・ランゲージ・モデリングにおけるキュー・エンジニアリングの必要性以下は、ヒント・エンジニアリングの基本的な考え方と、それがラージ・ランゲージ・モデル(LLM)のパフォーマンスをどのように向上させるかについての紹介である。 LLMのインターフェース:ラージ・ランゲージ・モデルがこれほど注目されている重要な理由の一つは、そのテキスト・トゥ・テキスト・インターフェースが最小限の操作体験を可能にすることである。これまでは、ディープラーニングを使ってあらゆる...AI知識ベース3年前067.5K
ロジスティック回帰(ロジスティック回帰)とは何か、読んで理解するための記事ロジスティック回帰は、バイナリ分類問題を解くのに使われる統計的学習手法である。中心的な目的は、入力特徴に基づいてサンプルが特定のカテゴリに属する確率を予測することである。このモデルは、S字関数を用いて固有値を線形結合することにより、線形出力を0と1の間にマッピングする...AIアンサー1年前066.1K
評価指標とは何か?評価メトリクス(Evaluation Metrics)とは、機械学習モデルの性能を測定するための定量的な基準の体系である。人体の健康状態を総合的に評価する多次元健康診断レポートのようなものである。分類タスクでは、精度はモデルの判断の全体的な正しさを反映し、精度(Pr...AIアンサー10ヶ月前065.3K
ランダム・サーチ(無作為検索)とは何か、見て理解するための記事ランダムサーチ(RS)はハイパラメトリック最適化手法の一つで、パラメータ空間内の候補点をランダムにサンプリングすることで最適なコンフィギュレーションを見つける。AIアンサー11ヶ月前065.3K
グリッドサーチ(Grid Search)とは何か、理解するための記事グリッドサーチは、機械学習における最適なハイパーパラメータの組み合わせを系統的に見つけるための自動化された手法である。この手法は、各ハイパーパラメータの候補値の範囲を事前に定義し、可能なパラメータの組み合わせをすべて洗い出し、モデルを1つずつ訓練して性能を評価し、最終的に最も性能の良いハイパーパラメータを選択する。AIアンサー11ヶ月前064.5K
データ補強(Data Augmentation)とは何か、見て理解するための記事データ補強(DA)とは、新しいデータを人為的に作成することで、トレーニングデータセットを補強する技術的アプローチである。AIアンサー11ヶ月前063.7K
K-Meansクラスタリング(K-Means Clustering)とは何か?K-Meansクラスタリング(K-Means Clustering)は、古典的な教師なし機械学習アルゴリズムである。主にデータ集合をK個の不連続なクラスターに分割するために使用される。このアルゴリズムの目的は、各データ点が最も近いクラスタ中心に対応するクラスタに属するように、n個のデータ点をK個のクラスタに割り当てることである。AIアンサー12ヶ月前063.6K
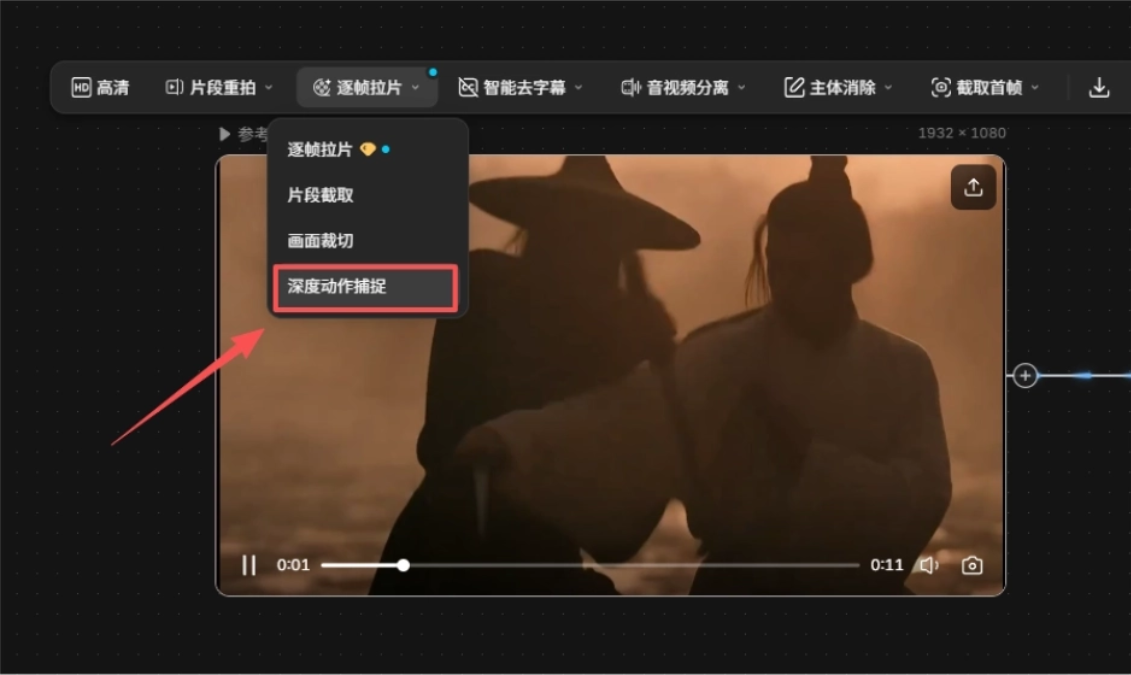
什么是深度动作捕捉?实测 LibTV,一键提取深度动态信息最近那种 AI 换角视频很容易刷到。虽然角色变了,但动作熟悉,成片很容易让人看完。LibTV 这次上线的深度动作捕捉,完美解决了这个问题。 我们上传参考视频,LibTV 会一键提取视频中的深度动态信息...AIハンズオンチュートリアル最新のAIリソース2ヶ月前044K
如何做出专业级 AI 短漫剧?- 商汤 Seko 给普通创作者机会AI 剧漫剧的观众越来越多,普通创作者却越来越难赚到钱了。 这并不是你的错觉,DataEye 预估显示,2025 年国内漫剧用户规模约 1.2 亿,到 2026 年上半年,用户规模已突破 6 亿,规模...AIハンズオンチュートリアル最新のAIリソース2ヶ月前038.8K
15 款 AI 漫剧制作工具 - 从想法到成片,无需专业技能想自己做漫剧,却不知道从哪一步开始?这篇文章帮你把活儿干完。我们实测盘点了目前市面上15款AI漫剧制作工具,从剧本生成、智能分镜、角色一致性,到成片渲染、配音配乐,每一款的核心功能、接入模型和适用人群...AIハンズオンチュートリアル1ヶ月前032.5K




 日本語
 简体中文
 English
 한국어
 Русский
 Español