Hy-SimulMT - 腾讯混元推出的实时同声传译大模型
Últimos recursos sobre IAPublicado hace 6 horas Círculo de intercambio de inteligencia artificial 2.1K 00

Hy-SimulMT是什么
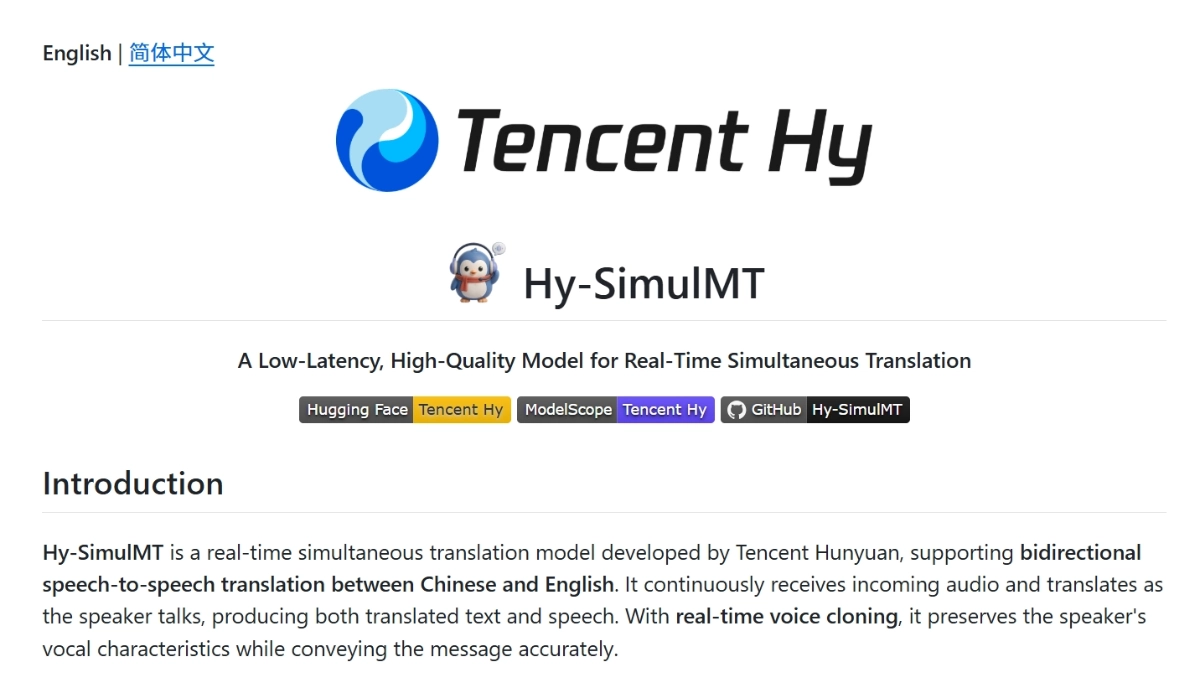
Hy-SimulMT是腾讯混元推出的同声传译大模型,专攻中英双向的实时互译。Hy-SimulMT采用30B参数稀疏MoE架构,能边听边译,响应时延约3秒,快于人类译员的4–5秒;翻译时可实时克隆说话人音色,多人对话能区分不同声线。模型在RealSI评测中做到延迟与质量双优,达到专业译员水平,且支持私有化部署与微调。
Hy-SimulMT的功能特色
- 中英双向语音同传:音频可持续流入,模型边听边译、同步输出译文,无需等说话人讲完。
- 实时音色克隆:译文可保留说话人本人的音色语气,多人对话时能区分还原不同声音。
- 文本语音双输出:除翻译语音外还能输出文本,Interleave 版可额外给出源语识别结果。
- 3秒级低延迟:实测同传延迟约3秒,快于人类专业译员4–5秒的水平。
- 先开口后修补:增量理解、尽早开口,后续信息补全后自动修正先前译语,模拟人类译员习惯。
- 稀疏MoE大模型:30B参数、每次仅激活3B,兼顾翻译质量与推理成本,适合实时在线场景。
- 模块化TTS设计:语音合成与音色克隆由独立组件承担,可灵活接入第三方TTS服务。
Hy-SimulMT的核心优势
- 延迟开源最低:StreamLAAL约3秒,比CATTI一、二级译员的4.5–4.7秒更快,是同类开源同传模型中响应最快的。
- 速度与质量兼得:在RealSI长音频评测中同时拿到最低延迟和最高GEMBA分数,超过5个商用API中的4个。
- 比肩人类专家:与6位CATTI持证同传专家的盲测中,综合得分和响应速度均不落下风,部分领域甚至更高。
- 音色还原自然:翻译语音能高度保留说话人原声,多人场景下听者可分辨谁在发言,沟通体验更接近原声交流。
Hy-SimulMT官网是什么
- Repositorio GitHub:https://github.com/Tencent-Hunyuan/Hy-SimulMT
- Biblioteca de modelos HuggingFace:https://huggingface.co/collections/tencent/hy-simulmt
Hy-SimulMT的使用步骤
- Obtener código::
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT.gitEntre en el catálogo de proyectos. - Servicios de implantación: Acceso
SimulInfer/目录,执行bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave完成一键安装。 - 接入TTS:如需语音输出和音色克隆,在
config.toml中填写TTS服务配置;只做文本翻译可跳过。 - 网页体验:终端出现
Ready: http://127.0.0.1:8080/后,浏览器打开该地址,选好翻译方向后上传音频或直接对着麦克风说话,点「Stop and finish」结束。 - llamada de interfaz: a través de
curl -N http://127.0.0.1:8080/translate/stream -F direction=en-zh -F file=@audio.wav上传文件,或使用仓库自带的simulinfer-client客户端获取结果。
Hy-SimulMT的适用人群
- 国际会议与活动工作者:外宾接待、志愿者服务、现场沟通等场景需要低成本实时翻译支持的人员。
- 跨国商务人士:频繁参加中英双语会议、谈判的职场人,可各用母语发言和聆听。
- 演讲者与培训师:学术讲座、企业内训、公开课等长时间单人发言场景,可将其作为辅助理解工具。
- 媒体内容从业者:采访、播客、纪录片等多人对谈场景,需要区分不同说话人音色并完成实时译制。
- 涉外服务人员:机场、酒店、展会、餐厅等窗口岗位,用于与外国游客的基础面对面交流。
Hy-SimulMT的常见问题
Q1:Hy-SimulMT 支持哪些语言?
A1:目前主打中英双向互译(语音进、语音出),其他语种暂无官方支持。
Q2:翻译延迟是多少?实测体感如何?
A2:官方StreamLAAL指标约3秒,快于人类译员4–5秒。但该指标不等同于"听到第一句译文的等待时间",实际体感受句长、语速和TTS配置影响,可能略长。
Q3:免费吗?可以商用吗?
A3:模型采用Apache-2.0协议开源,允许商用和二次开发;普通用户可通过腾讯Hy翻译App免费体验。
Q4:一定要自己配置TTS才能用吗?
A4:不是。模型本体完成识别+翻译并输出文本,不配TTS可直接用纯文本翻译;需要语音输出和音色克隆时才需配置TTS服务。
Q5:需要什么硬件配置?
A5:30B-A3B稀疏MoE架构虽每次只激活约3B参数,但加载完整模型仍需较大显存,建议部署前先查阅仓库的硬件要求说明,也可选用FP8或GGUF量化版本降低资源占用。
© declaración de copyright
Derechos de autor del artículo Círculo de intercambio de inteligencia artificial Todos, por favor no reproducir sin permiso.
Artículos relacionados
Sin comentarios...
 Español
 简体中文
 English
 日本語
 한국어
 Русский